
一、从 create_agent 说起
前几篇我们把 Agent 的概念、原理、与工具调用的边界都讲清了。这一篇回到最实操的问题:Agent 到底怎么创建、怎么调用?
LangChain 1.x 给出的答案是一个统一入口:create_agent。在 1.0 之前,构建 Agent 有 create_react_agent、AgentExecutor 等多套 API;1.0 之后全部收敛到 create_agent 一个函数——它返回的本身就是一个具备执行能力的实体,内部基于 LangGraph 构建了执行图(CompiledStateGraph)。
对 Java 工程师,可以把它类比成一条构建链:create_agent 相当于 Builder 的 build(),产出物不是配置对象,而是一个可直接运行的执行引擎。
本文覆盖三块:创建(静态/动态两种方式)、调用(invoke/ainvoke/stream 三种方式)、输出处理(消息解析与流式模式选择)。
二、创建之前:最简环境
先准备好两样东西。
第一,依赖安装。 Python 3.10+ 环境,装三个包即可:
pip install langchain langchain-deepseek python-dotenv
第二,模型初始化。 在项目根目录放 .env 文件管理密钥,用 init_chat_model 初始化:
from langchain.chat_models import init_chat_model
from env_utils import DEEPSEEK_API_KEY, DEEPSEEK_BASE_URL

deepseek_llm = init_chat_model(
    model="deepseek-chat",
    model_provider="deepseek",
    api_key=DEEPSEEK_API_KEY,
    base_url=DEEPSEEK_BASE_URL,
)
init_chat_model 是 LangChain 推荐的模型初始化方式——按 provider 字符串路由到具体实现,换模型只改参数,不动代码。
三、创建方式一:静态模型,最简单也最常用
静态模型在 Agent 创建时一次性配置,整个执行过程保持不变。一个最小可用例子:
from langchain.agents import create_agent
from langchain.tools import tool
from langgraph.graph.state import CompiledStateGraph

@tool
def get_weather(city: str) -> str:
    """获取指定城市的天气信息。"""
    return f"{city}的天气为晴朗,25°C。"

agent: CompiledStateGraph = create_agent(deepseek_llm, tools=[get_weather])

resp = agent.invoke({
   "messages": [{
   "role": "user", "content": "查询北京的天气"}]})
四个要点:
- 工具用 @tool 装饰器定义,docstring 就是工具描述——模型靠这段文字决定要不要用这个工具,务必写清楚;
- create_agent 的核心参数是 model(大脑)和 tools(手脚),还支持 system_prompt(系统指令)、middleware(中间件)等;
- 返回值类型是 CompiledStateGraph——一个编译好的执行图,不是配置对象;
- invoke 的输入是固定格式:
{"messages": [{"role": "...", "content": "..."}]},messages 是基于消息的 LangChain Agent 的标准输入。
四、创建方式二:动态模型,按对话状态换大脑
静态模型的问题:简单对话用大模型浪费钱,复杂推理用小模型效果差。动态模型允许运行时按对话状态选择模型——通过中间件实现。
场景:对话消息数少于 3 条时用基础模型(便宜),达到 3 条后切换高级模型(更强)。
from langchain.agents.middleware import wrap_model_call, ModelRequest, ModelResponse

# 基础模型与高级模型各初始化一份
basic_model = init_chat_model(model="deepseek-chat", ...)
advanced_model = init_chat_model(model="qwen-plus", ...)

@wrap_model_call
def dynamic_model_selection(request: ModelRequest, handler) -> ModelResponse:
    """根据对话消息数动态选择模型"""
    message_count = len(request.state["messages"])
    if message_count >= 3:
        model = advanced_model   # 复杂对话用强模型
    else:
        model = basic_model      # 简单对话用便宜模型
    return handler(request.override(model=model))

agent = create_agent(
    model=basic_model,            # 默认模型
    tools=[get_weather],
    middleware=[dynamic_model_selection],  # 挂载中间件
)
三个关键机制:
@wrap_model_call标记的方法会在每次调用模型前触发——注意是推理循环的每一步,不是整个 Agent 生命周期一次;request.state["messages"]拿到当前对话状态,request.override(model=...)把替换后的模型传回主流程;- 这就是"模型路由"的实现雏形:按消息数、按 token 用量、按问题分类路由,都是同一个模式——改 if 条件的事。
五、调用方式一:invoke,同步阻塞拿全量结果
invoke 是最基本的同步调用,阻塞直到返回最终结果。两个进阶技巧。
技巧一:在消息里内嵌 system 角色约束行为。 不用 system_prompt 参数,直接在 messages 列表开头加一条 system 消息:
resp = agent.invoke({

    "messages": [
        {
   "role": "system", "content": "你是天气查询助手,只回答天气相关的问题,其他问题直接回答:我不清楚这问题答案。"},
        {
   "role": "user", "content": "100加上50等于多少?"}
    ]
})
print(resp["messages"][-1].content)  # 输出:我不清楚这问题答案。
技巧二:用 pretty_print 格式化输出。 invoke 返回的 dict 里是完整消息链,直接 print 会打出大段元数据。用消息对象自带的 pretty_print() 更清爽:
for msg in resp["messages"]:
    msg.pretty_print()
每条消息会以 System/Human/AI/Tool + 内容 的格式分行打印,调试时一目了然。
六、调用方式二:ainvoke,异步不阻塞
当 Agent 要调用外部工具(查网络、访问数据库)时,同步 invoke 会干等 I/O 返回。ainvoke 基于 Python asyncio:等待外部 I/O 时把 CPU 交还给事件循环,去执行其他就绪任务。
适用场景:旅行规划 Agent 同时查航班、酒店、天气;批量处理多个用户请求的客服系统。经典三工具旅行助手示例:
import asyncio

async def async_query():
    agent = create_agent(
        model=deepseek_llm,
        tools=[get_weather, get_transport_info, get_scenic_spots],
        system_prompt="你是专业的旅行规划助手。",
    )
    response = await agent.ainvoke({
   "messages": [
        {
   "role": "user", "content": "查询北京的天气,推荐历史景点"},
        {
   "role": "user", "content": "我要从北京到上海,查上海天气并推荐现代景点"},
    ]})
    return response

response = asyncio.run(async_query())
print(response['messages'][-1].content)
对 Java 工程师:这套机制等价于 CompletableFuture + 事件循环——ainvoke 是返回 CompletableFuture 的异步方法,await 相当于 thenCompose 链中的 join。高并发场景下 ainvoke 的吞吐优势非常明显。
七、调用方式三:stream,流式渐进输出
LLM 生成完整响应可能要 10–20 秒,用户期望即时反馈。stream 让结果渐进式出现——打字机效果的实现基础:
for chunk in agent.stream(
    {
   "messages": [{
   "role": "user", "content": "查询客户 CUST123456 的完整信息和可用优惠"}]}
):
    for step, data in chunk.items():
        if step == "model":
            last = data["messages"][-1]
            if last.content:
                print(f"AI回复: {last.content}")
            if last.tool_calls:
                print(f"AI决定调用工具: {[tc['name'] for tc in last.tool_calls]}")
        elif step == "tools":
            result = data["messages"][-1]
            print(f"执行工具: {result.name},返回: {result.content}")
stream 返回的每个 chunk 是一个 dict,key 为 model(模型调用)或 tools(工具执行),两者流式交叉输出——模型决定调工具、工具返回、模型再决策,全程实时可见。
八、七种流式模式:按场景选
stream 的 stream_mode 参数支持七种模式,各自解决不同的观测需求:
| 模式 | 输出内容 | 适用场景 |
|---|---|---|
| values | 每步执行后的完整状态 | 每步都要全量状态、状态持久化 |
| updates(默认) | 每步增量变化 | 监控执行进度:调了什么工具、结果如何 |
| messages | 流式 Token + 元数据 | ChatGPT 式打字机效果、实时交互 |
| tasks | 当前任务信息与错误 | 监控任务生命周期 |
| debug | tasks + 步骤/时间戳/类型 | 调试任务执行全过程 |
| checkpoints | 检查点创建时输出状态 | 状态持久化、故障恢复、分布式跟踪 |
| custom | 工具内自定义发送的数据 | 业务进度(如"已处理 10/100 条")、自定义日志 |
选择逻辑一句话:做实时对话选 messages,观察决策过程选 updates,调试选 debug/tasks,业务埋点选 custom。
模式还可以组合。同时指定 stream_mode=["tasks", "updates"],一个循环里既能看任务执行又能看每步更新——遍历时用 (stream_mode, chunk) 二元组接住即可。
九、全景图:创建与调用的完整决策路径
把全篇内容收进一张图。
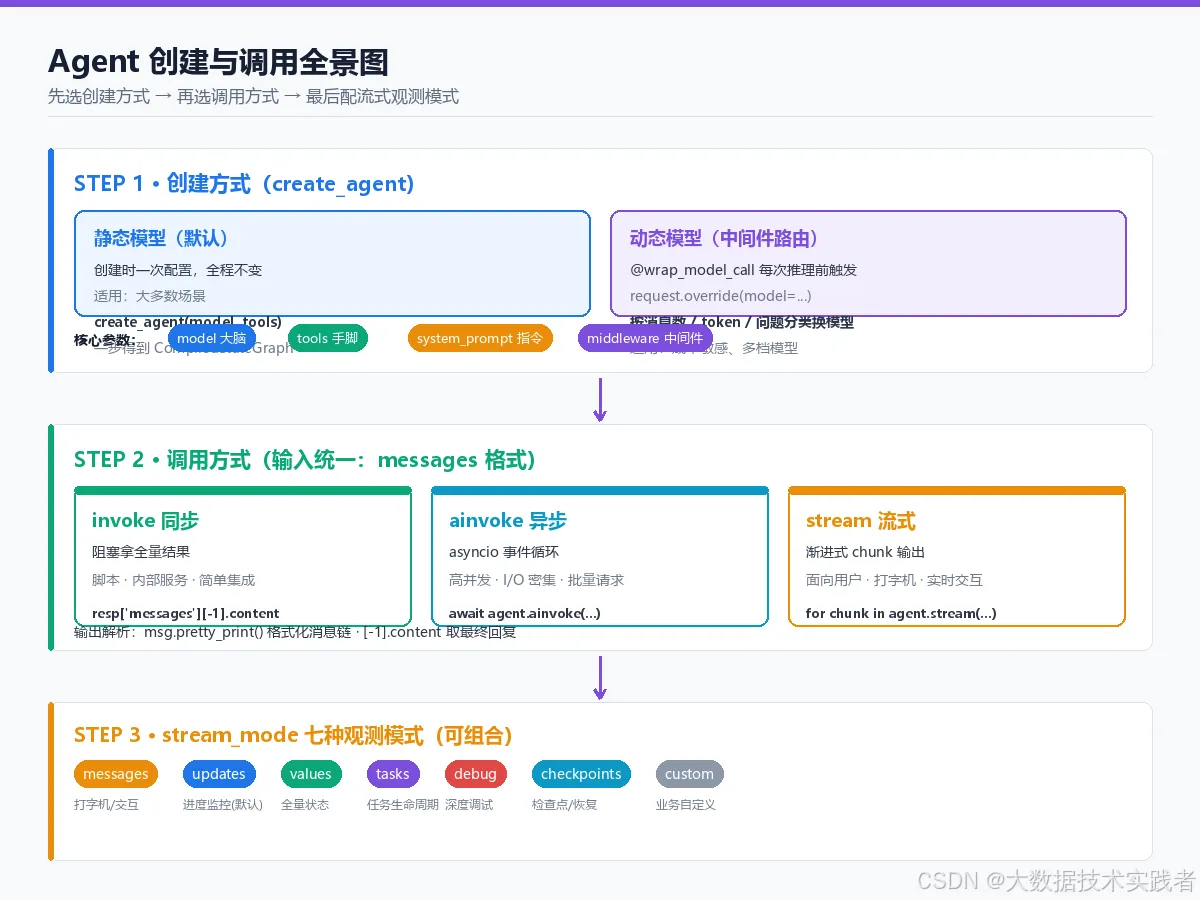
从图上看,路径非常清晰:先选创建方式(简单场景静态模型一步到位;成本敏感、多档模型场景用中间件上动态路由),再选调用方式(脚本/内部服务用 invoke;高并发 I/O 密集用 ainvoke;面向用户交互用 stream),最后按观测需求配流式模式(交互体验 messages / 进度监控 updates / 深度调试 debug)。
十、小结
- 创建:create_agent(model, tools) 一步得到 CompiledStateGraph;进阶用 @wrap_model_call 中间件实现动态模型路由;
- 调用:invoke 同步拿全量、ainvoke 异步提吞吐、stream 流式做交互,输入统一是 messages 格式;
- 观测:七种流式模式按需选、可组合,updates 是默认兜底,messages 是交互首选。
下一篇我们拆 Agent 的进阶配置:system_prompt 与动态提示词如何塑造 Agent 的"人格"。
技术说明
本文代码基于 LangChain 1.2 + Python 3.13 环境验证,模型以 deepseek-chat 为例;API 细节以官方文档(docs.langchain.com)为准。
*:七种流式模式按需选、可组合,updates 是默认兜底,messages 是交互首选。
