9.2 起 ILM 执行
ReadOnly动作时会把indexing_complete设为true。这是一个内部标记的自动化——以前要单独配,现在ReadOnly一并做了。如果你不知道indexing_complete是什么,这篇正好把它讲清楚。
说明
实测环境:本地起的 Elasticsearch 9.4.2 单节点实例(官方 tar 包直接跑,堆内存 512MB,安全与机器学习关闭),curl 连本地 9200 端口。本文「实测」小节的命令和输出都出自这个实例。
来源和边界先交代:本文的依据出自 v9.4.2 标签下的官方文件(9.2.0.yml、LifecycleSettings.java、ilm-readonly.md),文中引用的原文均来自这些文件。示例取自官方示例;哪些是文档写明、哪些是我的推断,正文里逐处标注。
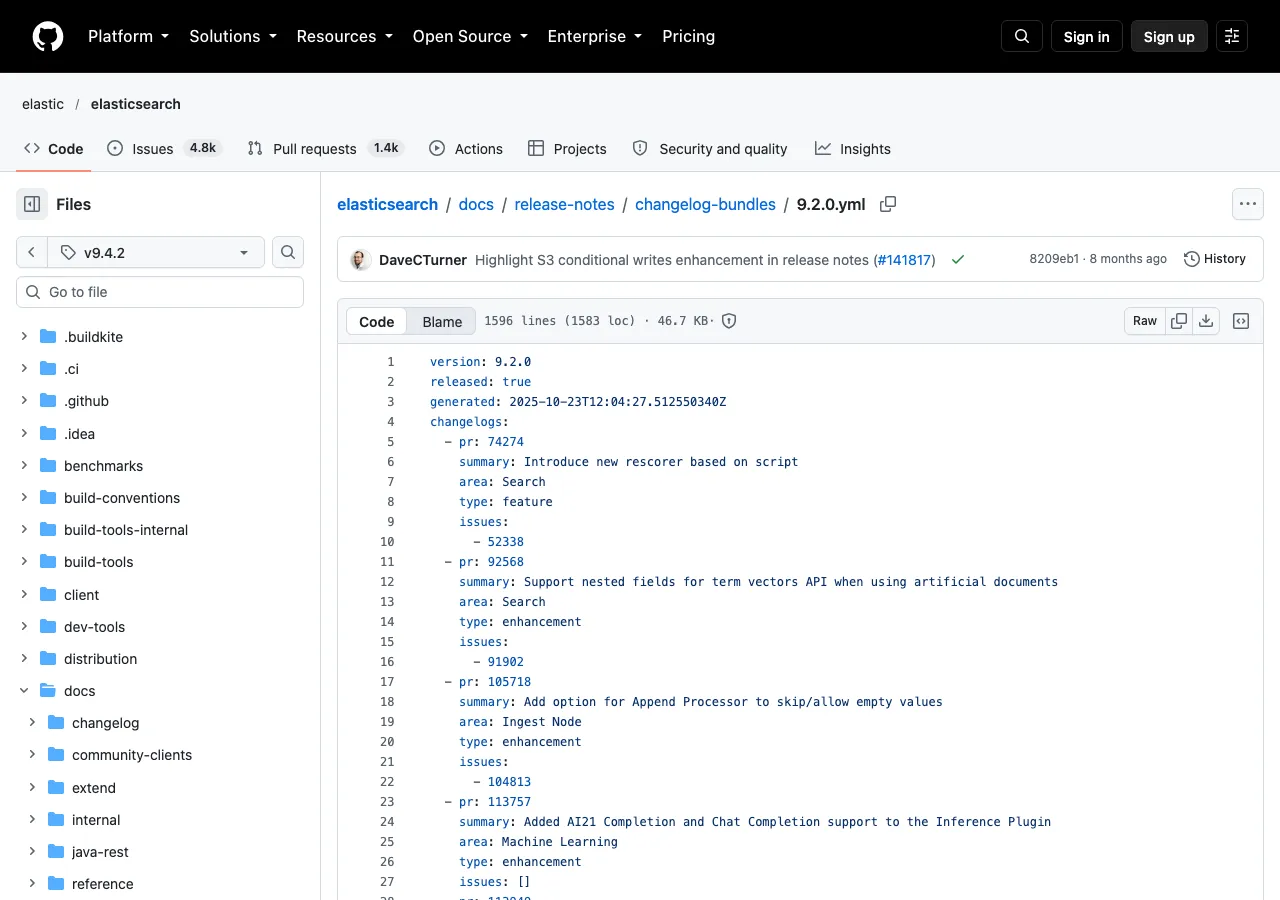
图 1:官方文件 9.2.0.yml(v9.4.2 标签)。来源:GitHub elastic/elasticsearch v9.4.2 9.2.0.yml
官方条目
9.2 的 changelog 标为 enhancement(9.2.0.yml 第 153 行 @ v9.4.2),PR 129945:
Enhancement: ILM sets `indexing_complete` to true from `ReadOnly` action
只有一行 summary。下面的内容来自源码和官方文档。
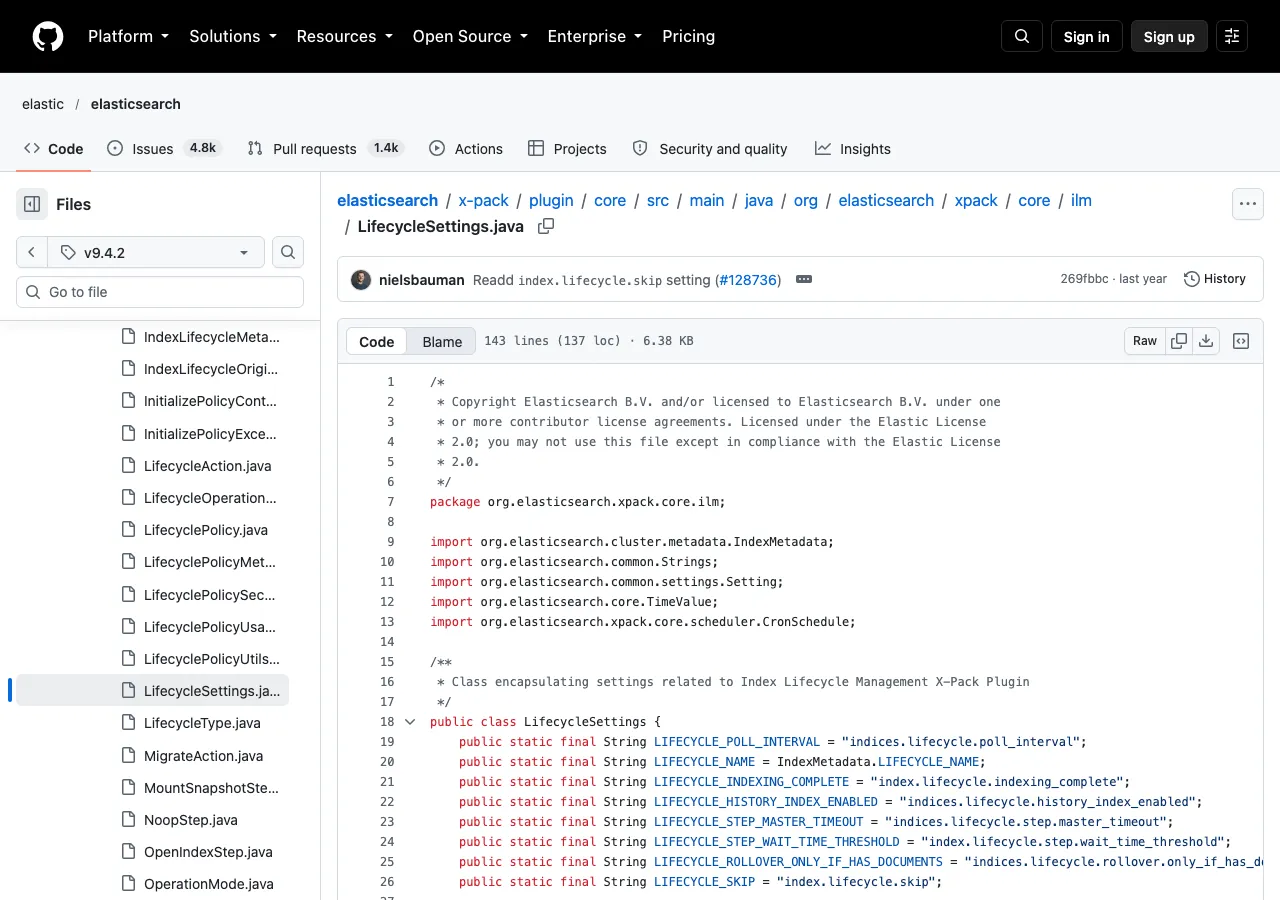
图 2:官方文件 LifecycleSettings.java(v9.4.2 标签)。来源:GitHub elastic/elasticsearch v9.4.2 LifecycleSettings.java
先说 indexing_complete 是什么
它是 ILM 的一个内部标记。定义和设置名都能在源码里找到(LifecycleSettings.java 第 21 行、第 50 行,源码 @ v9.4.2):
public static final String LIFECYCLE_INDEXING_COMPLETE = "index.lifecycle.indexing_complete";
...
public static final Setting<Boolean> LIFECYCLE_INDEXING_COMPLETE_SETTING = Setting.boolSetting(
完整的设置名是 index.lifecycle.indexing_complete,布尔值。
它的含义是:这个索引(或者说这个数据流里由它代表的这一段)不再接收新写入了。
图 3:官方文件 ilm-readonly.md(v9.4.2 标签)。来源:GitHub elastic/elasticsearch v9.4.2 ilm-readonly.md
为什么需要这个标记
要理解它,得先说数据流(data stream)的写入机制。
数据流由多个后备索引(backing index)组成。写入永远只进当前该(最新的后备索引),由数据流的 rollover 机制切换。
ILM 管理的是这些后备索引的生命周期:热的、温的、冷的、删掉。
问题来了:ILM 怎么知道某个后备索引已经"写完了"?
- 如果它还可能被写入,就不能对它做某些操作(比如冻结、缩减、迁移到冷层);
- 只有确认不再写入了,后续动作才安全。
indexing_complete 就是 ILM 用来记这件事的标记——它把"是否还能写入"这个判断固化成一个可读的状态。
以前怎么设置的
按对 ILM 工作方式的理解(官方没有在这条条目里解释),以前这个标记主要由 rollover 动作设置:
- 执行 rollover 时,数据流切换到新的后备索引;
- 老的该后备索引不再接收写入;
- 于是把它的
indexing_complete标为true。
这条链路只在"经过 rollover"时才成立。
那不经 rollover 的呢
这就是本篇改动要解决的问题。
有些 ILM 策略里没有 rollover——比如:
- 索引不是数据流的一部分(就是普通索引);
- 或者策略设计上就不打算 rollover,只是到了某个时间点把它设为只读。
这类情况下,ReadOnly 之后索引确实不再写入了,但 indexing_complete 没被标记。
后果是什么?ILM 后续的动作可能认为"这个索引还可能被写入",从而不做某些操作,或者行为不符合预期。
(说明:具体哪些后续动作会受影响,未逐个核实。上面的描述基于该标记语义推断。)
改动做了什么
改动本身很简单:ILM 执行 ReadOnly 动作时,会把 indexing_complete 一并设为 true。
逻辑上讲得通:ReadOnly 就是把索引设成只读(给索引加写入块)。既然已经只读了,那"不再写入"就是确定的事实——把标记补上是顺理成章的。
判断这是个一致性修复:让标记反映真实状态,而不是只有经过特定路径才被设置。
为什么这算 enhancement 而不是 bug
changelog 标的是 enhancement,不是 bug。
这个区分值得说一下,因为它反映了改动的性质:
- bug = 某个功能没按它声明的方式工作;
- enhancement = 补上一个此前缺失的行为。
这里选了后者,推测原因是:ReadOnly 原本就没承诺过要设置这个标记。所以"没设"是"以前没想到",不是违约。补上算增强。
(说明:这是对分类的理解,官方没解释为什么标 enhancement。)
对使用者的影响
多数人不会感知到,也不需要做任何操作。理由:
- 它是内部标记,不是你日常要配的东西;
- 改动只是"让它在更多情况下被正确设置",不改变 ILM 的宏观行为;
- 不需要你做任何操作——升级后自动生效。
可能需要注意的情况:
- 如果 ILM 策略依赖"indexing_complete 未设置"来做判断(比如自定义逻辑读这个设置),升级后行为会变;
- 如果你在排查 ILM 为什么不执行某个动作,现在可以多看一眼这个标记。
第一点很少见——依赖一个内部标记的"未设置"状态来判断,本身就是脆弱的做法。
数据流、rollover、ILM 三者怎么串起来
上面提到了数据流和 rollover,但没系统串过。这里补一段,因为不理解这三者的关系,就看不懂这个标记为什么存在。
数据流是对外看到的名字。你往 logs-nginx 写数据,实际写的是它背后的某个后备索引(名字类似 .ds-logs-nginx-2024.01.01-000001)。
rollover 是切换动作:当前后备索引达到某个条件(大小、文档数、时间),就新建一个后备索引接替写入,老的封存。
ILM 是管理这些后备索引的策略引擎:按索引"年龄"或其它条件,把它们一步步往下挪(热 → 温 → 冷 → 删除)。
串起来的关键:ILM 处理的单位是后备索引,而"这个后备索引是否还在接收写入"取决于它是不是当前写入目标。
- rollover 之后,老索引确定不再是写入目标 → 可以标记完成;
ReadOnly之后,索引被加了写入块,即使它理论上是当前目标也写不进去了 → 同样可以确定。
所以我的判断是:这两种动作都能得出"不再写入"的结论,只是路径不同——排查时要看动作本身,不能只认 rollover。
判断:这类"同一事实有两条推导路径"的情况,最容易出遗漏。 一开始实现时只想到主路径(rollover),辅路径(ReadOnly)被漏掉,等到有人遇到才补上。看 changelog 时,这类"补齐遗漏"的条目不少——它们通常都是 enhancement 而非 bug,理由就是前面说的:没人承诺过那条路径会设置它。
怎么查看
设置是普通的索引设置,读得到:
curl -s 'localhost:9200/my-index/_settings?pretty' | grep -i "indexing_complete"
注意:它只在被设置过之后才出现。没执行过 rollover 或 ReadOnly 的索引会读不到这项——这是正常的,不是配置丢了。
(说明:上面这条命令按 ES 的 API 写法构造,未实际执行。)
排查 ILM 时的一个实用做法
上面提了"打出完整设置来看",这里说具体一点,因为ILM 不按预期执行是个高频问题,而这个标记能提供线索。
ILM 提供了解释接口(名字是 explain,具体路径以你版本的文档为准)。它会告诉你:
- 索引当前处于哪个阶段;
- 正在等待什么;
- 下一步要做什么。
排查顺序建议这样:
- 先看 explain 的输出——它会直接说明卡在哪;
- 再看索引的完整设置——重点看
index.lifecycle.*系列,包括本篇的indexing_complete; - 最后对照策略定义——确认策略本身写得对。
第 2 步经常被跳过,但很多"策略看着没问题却不执行"的情况,原因就在这些运行时设置里。策略是意图,设置是实际状态,两者不一致时看后者。
(说明:explain 接口的准确名称和参数未核对,只确认 ILM 有这类能力。用时以你版本的文档为准。)
还有一条判断:ILM 的复杂性不在于策略怎么写,而在于它的执行依赖一堆运行时状态。所以排查 ILM 问题时,读状态比读策略更有用。
和别的数据流/ILM 改动放一起看
9.x 在数据流和 ILM 上做了不少改动,前面写过几篇:
| 篇 | 改动 | 层面 |
|---|---|---|
| logs-- 默认走 LogsDB | logsdb 成为日志数据流默认 | 索引模式 |
| S3 的 x-purpose 参数 | S3 purpose 查询参数 | 快照存储 |
| 本篇 | ReadOnly 设置 indexing_complete |
生命周期状态标记 |
| time_series 里的 nested | TSDB 支持 nested | 映射能力 |
本篇属于"内部状态一致性"这一类——不改变你能做什么,只让系统的内部记录更准确。
这类改动在 changelog 里最不起眼(一行 summary,且术语偏内部),但它们是系统可靠性的基础。标记不准会导致后续判断出错,而这类错误往往表现为"ILM 没按预期工作",排查起来很绕——因为问题不在你写的策略里,而在系统记下的状态里。
这条改动怎么看
这条改动很小,写它主要不是为了"要做什么"——多数情况下什么都不用做。
价值在于理解 ILM 的两个概念:
一,indexing_complete 是 ILM 判断"这个索引还能不能写"的依据。 知道有这个标记存在,排查 ILM 行为时多一个着手点。
二,ReadOnly 现在会自动设置它。 所以如果你看到某个索引的 ILM 卡住了,先确认这个标记的状态是否符合预期——它可能是问题的线索,也可能正是你疑惑的答案。
一个实操建议:排查 ILM 问题时,把索引的完整设置打出来看一遍,而不是只看策略定义。ILM 的实际行为受这些内部标记影响,策略写得对不代表执行符合预期——前者是意图,后者是实际状态。
在 9.4.2 上跑一遍
建索引时直接把该标记写成 true,一篇文档都还没写过:
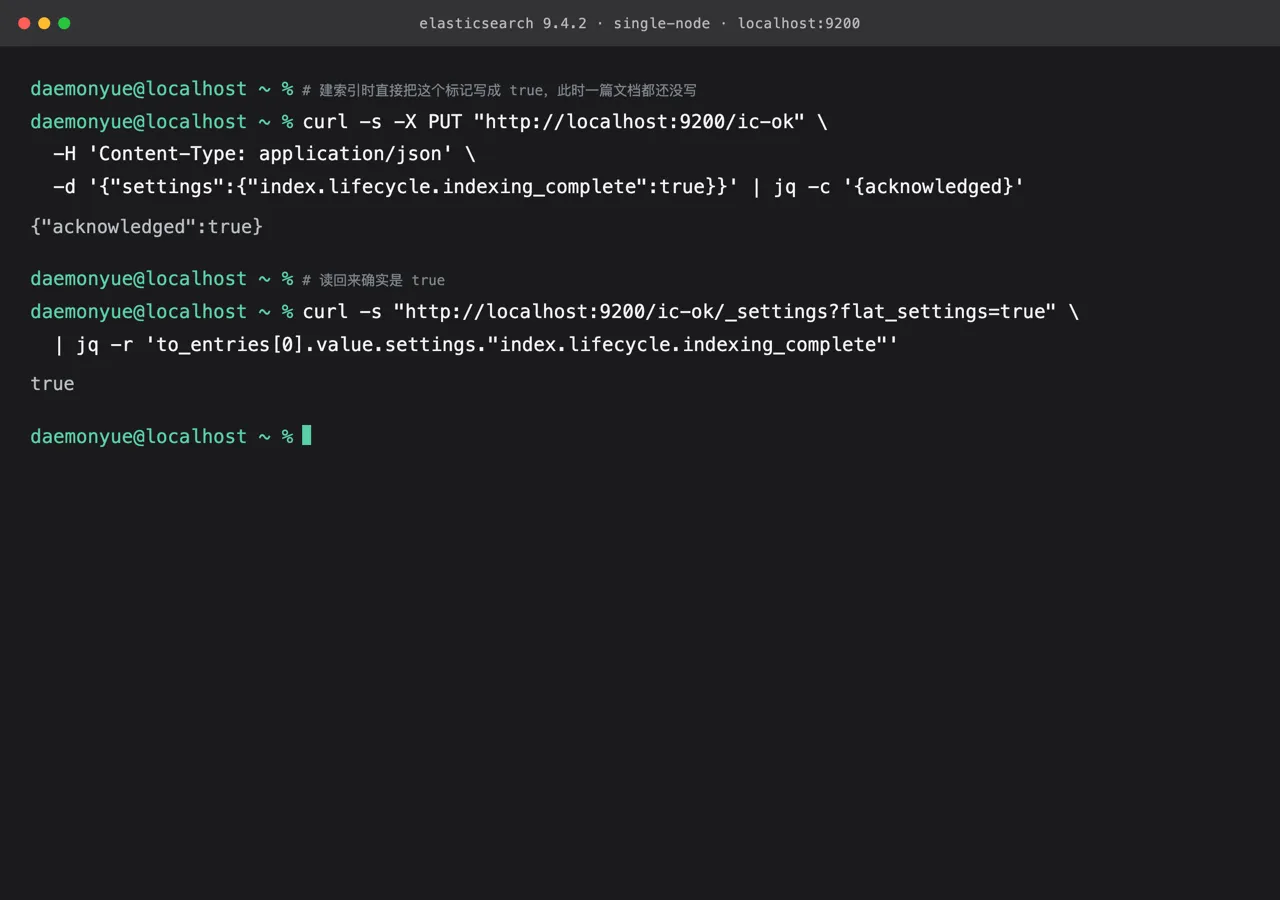
图 4:本地 9.4.2 单节点实例上的实测输出。上:建索引;下:读回设置
curl -s -X PUT "http://localhost:9200/ic-ok" \
  -H 'Content-Type: application/json' \
  -d '{"settings":{"index.lifecycle.indexing_complete":true}}' | jq -c '{acknowledged}'

curl -s "http://localhost:9200/ic-ok/_settings?flat_settings=true" \
  | jq -r 'to_entries[0].value.settings."index.lifecycle.indexing_complete"'
建索引返回 {"acknowledged":true};读回来是 true。
关键在于:这个索引一篇文档都没有,却已经被标记为"写入完成"。它是一个可写的普通索引设置,不是 ES 根据实际写入情况算出来的状态。所以 ILM 判断"这个索引还写不写"的时候读的只是一个标记位。
结论是:别拿 index.lifecycle.indexing_complete 当"数据已经写完了"的证据。它只说明 ILM 这边认为可以往下走了。要确认数据完整性,得看写入端自己的水位或者文档数——尤其是那些手动干预过 ILM 的索引,这个标记很可能和实际情况不一致。
写在最后
很小的改动:ReadOnly 动作多设一个内部标记。
一,index.lifecycle.indexing_complete 是 ILM 的内部标记,表示"这个索引不再接收写入"。它是普通的索引设置,可以直接读到——但只在被设置过之后才出现。
二,9.2 起 ReadOnly 会自动设置它,以前主要靠 rollover 触发。不经 rollover 的策略(比如普通索引、或策略里没配 rollover)以前可能缺失这个标记。我的建议是查"索引还写不写"时别只看这一个标记。
三,多数人不用做任何事。 它不影响 ILM 的宏观行为,也不需要配置——知道它存在,是为了排查时多一个着手点。
另外诚实标注三处:"不经 rollover 时标记缺失会导致什么具体问题"未逐个核实(基于标记语义推断);"为什么标为 enhancement 而非 bug"是理解;查看命令未执行。
参考
- changelog 9.2.0:ILM sets
indexing_completeto true fromReadOnlyaction(第 153 行)@ v9.4.2 LifecycleSettings.java:设置名(第 21 行)与定义(第 50 行)@ v9.4.2- ILM readonly 动作文档 @ v9.4.2
- PR 129945
本文对照 Elasticsearch
v9.4.2标签的 changelog、ILM 文档与源码核对,引文与代码逐字取自原文。"以前主要由 rollover 设置该标记"、"不经 rollover 时缺失标记的后果"均基于标记语义推断,官方未在该条目中解释;"为何标为 enhancement 而非 bug"是理解;图 4 的建索引与查看命令已在本地 9.4.2 单节点实例上执行(实测显示空索引也能被标成已完成写入);