
一、工具:Agent 唯一能改变世界的出口
上一篇把提示词比作 Agent 的"岗位说明书"。但说明书再详细,如果这个人没有手脚,也只能停在纸面上。模型本身只会输出 token——它不能查库、不能发邮件、不能退款。工具(Tool)是 Agent 唯一能产生外部副作用的出口。
也正因如此,工具的质量直接决定 Agent 的上限。模型对工具的全部认知,只来自三样东西:
- name:工具叫什么,比如
query_order、refund_order; - description:什么场景该用它;
- args_schema:参数怎么填、每项什么含义。
这三样会被序列化进请求,成为模型看到的"工具清单"。所以写工具不是写一个函数,是写一份给模型看的 API 文档——调用方是一个不懂你业务、但会一字一句读文档的实习生。
对 Java 工程师,这个心智模型很好对齐:写 @RestController 时,方法是给另一个系统调的;写工具时,方法是给模型调的。区别在于——同事会看你的 Swagger 并追问,模型只会看你那两三行描述,填错了也不问,直接编一个。
下面这张图是一次工具调用的完整链路,值得先看一眼再读代码:
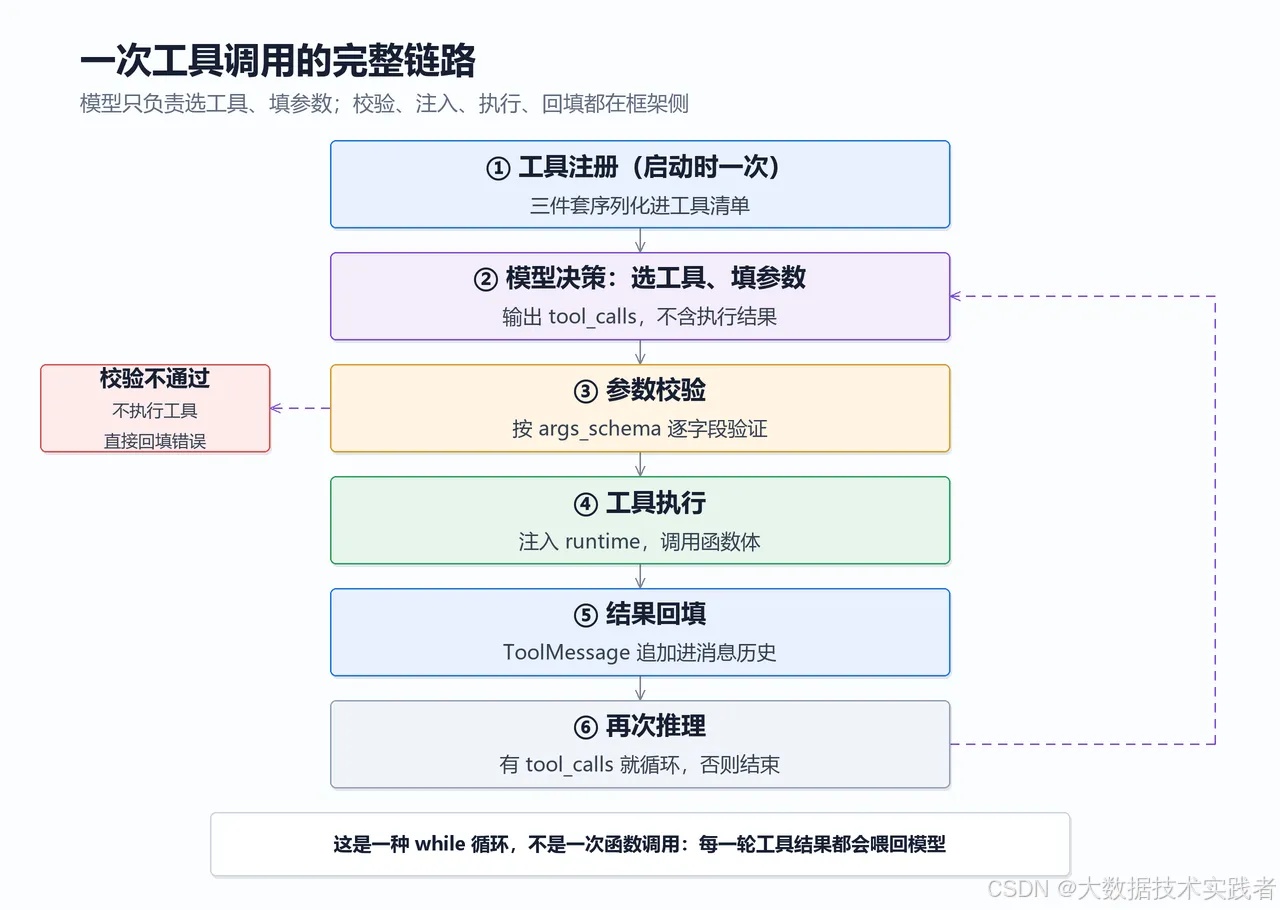
模型只负责两件事:选工具、填参数。校验、注入、执行、回填,全部在框架侧完成。理解这条链路的每个环节,后面的设计规矩才有落脚点。
二、三种定义方式,一条主线
LangChain 提供三种定义工具的方式,能力从简到繁,但主线只有一条:把契约写清楚。
2.1 @tool 装饰器:最小可用
import json
from langchain.agents import create_agent
from langchain.tools import tool
from init_llm import deepseek_llm

EMPLOYEES = {

    "E001": {
   "name": "张三", "department": "技术部", "position": "高级软件工程师"},
    "E002": {
   "name": "李四", "department": "市场部", "position": "市场经理"},
}

@tool("get_employee_info")
def get_employee_info(employee_id: str) -> str:
    """根据员工 ID 查询员工档案。

    Args:
        employee_id: 员工唯一标识,格式为 E + 3 位数字,例如 E001
    """
    record = EMPLOYEES.get(employee_id.upper())
    if record is None:
        return f"未找到 ID 为 {employee_id} 的员工,请确认编号格式(例如 E001)"
    return json.dumps(record, ensure_ascii=False)

agent = create_agent(
    model=deepseek_llm,
    tools=[get_employee_info],
    system_prompt="你是员工信息助手,只能依据工具返回的数据回答。",
)

resp = agent.invoke({
   "messages": [{
   "role": "user", "content": "查一下 E001 的档案"}]})
print(resp["messages"][-1].content)
四个容易踩的细节:
- 类型注解是必需的,它决定参数 schema,不写注解就等于没告诉模型怎么填;
@tool("get_employee_info")可显式命名,默认取函数名。名字请用snake_case,含空格或特殊字符在部分厂商会直接报错;- 传
description=后,它会完全替代 docstring 成为唯一描述,两者不要都写又指望叠加; - 参数名
config和runtime是保留字,用它们当业务参数会在运行时抛错。
2.2 Pydantic:参数有约束时
参数一复杂——枚举、范围、格式规范——裸类型注解就不够用了。Pydantic 模型能把这层约束写进 schema:
from typing import Literal, Optional
from pydantic import BaseModel, Field, field_validator
from langchain.tools import tool

class TicketQueryInput(BaseModel):
    """工单查询条件,至少提供一个筛选字段。"""

    ticket_id: Optional[str] = Field(default=None, description="工单号,例如 TK2025012001")
    assigner: Optional[str] = Field(default=None, description="负责人姓名")
    status: Optional[Literal["open", "in_progress", "resolved", "closed"]] = Field(
        default=None, description="工单状态"
    )
    priority: Optional[Literal["low", "medium", "high", "urgent"]] = Field(
        default=None, description="优先级"
    )

    @field_validator("ticket_id")
    def upper_ticket_id(cls, v: Optional[str]) -> Optional[str]:
        return v.upper() if v else None


@tool(args_schema=TicketQueryInput)
def query_tickets(ticket_id=None, assigner=None, status=None, priority=None) -> str:
    """按条件查询工单,支持工单号 / 负责人 / 状态 / 优先级组合筛选。"""
    rows = [t for t in TICKETS
            if (not ticket_id or t["id"] == ticket_id)
            and (not assigner or t["assigner"] == assigner)
            and (not status or t["status"] == status)
            and (not priority or t["priority"] == priority)]
    if not rows:
        return "未找到符合条件的工单,可放宽筛选条件后重试"
    return json.dumps({
   "total": len(rows), "tickets": rows}, ensure_ascii=False, indent=2)
相比裸注解,这里多了三层保护:
Literal把取值范围写死在 schema 里,模型看到的是四个合法值,而不是"一个字符串"——这是降低参数幻觉最划算的手段;Field(description=...)直接影响填参准确率,每个字段都要写,别省;field_validator做入口规范化,用户说"查 tk2025012001",模型照抄小写,validator 统一转大写,工具不必到处.upper()。
关键在于:校验发生在模型填完参数、工具执行之前。校验失败时,错误信息会带着合法取值回到模型手里,模型据此自己改参数重试——这条回路本文第五节还会再遇到一次。
2.3 JSON Schema:Schema 来自配置
当参数结构不是写代码时定死的,而是来自配置中心、外部系统或运行时拼装,直接给字典更合适:
BOOK_SCHEMA = {

    "type": "object",
    "properties": {

        "title_keyword": {
   "type": "string", "description": "书名关键词,支持模糊匹配"},
        "author": {
   "type": "string", "description": "作者姓名"},
        "category": {

            "type": "string",
            "enum": ["技术", "文学", "历史", "科学", "经济学", "传记"],
            "description": "图书分类",
        },
    },
    "required": [],
}

@tool(args_schema=BOOK_SCHEMA)
def query_books(title_keyword: str = None, author: str = None, category: str = None) -> str:
    """查询企业图书库。至少提供关键词 / 作者 / 分类中的一个条件。"""
    ...
required: [] 表示字段都可选,但这恰恰是风险点:模型可能一个都不填。所以描述里必须补一句"至少提供一个条件",并在函数体里对空条件做兜底——schema 只能约束结构,约束不了语义。
2.4 怎么选
| 方式 | 适用场景 | 代价 |
|---|---|---|
@tool + 类型注解 |
参数简单、快速验证、内部小工具 | 无法表达枚举与自定义校验 |
@tool(args_schema=PydanticModel) |
参数复杂、有枚举/范围/格式约束的企业级工具 | 多写一个模型类 |
@tool(args_schema=dict) |
Schema 由配置或外部系统动态提供 | 无静态类型检查,易写错 |
一句话选型:能用 Pydantic 就用 Pydantic。多写的十几行模型类,会在模型填错参数时以"自我修正"的形式还给你。
三、四条硬规矩
API 能跑通只是及格线。工具要稳,还得守四条规矩——这部分没有框架 API,全是设计经验。
规矩一:描述写"何时用",而不是"是什么"。
反面写法是 """查询订单。"""。正面写法要把触发场景和边界都写进去:
按订单号查询订单的物流与金额信息。用户问到"包裹到哪了""这单多少钱"时使用;不要用于退款(请用 refund_order)。
模型选工具靠的是语义匹配。告诉它什么情况"不要用",比告诉它功能是什么更能降低误调用——尤其是在你有 query_order 和 query_refund 两个相近工具的时候。
规矩二:返回值是写给模型读的,不是给程序解析的。
- 返回带字段名的 JSON 字符串,别返回元组、ORM 对象 repr 或一坨纯文本日志;
- 空结果要明确:返回"未找到符合条件的工单",而不是
None或[]——模型看到空数组容易理解成"工具坏了"; - 控制体积:列表类工具必须带
limit,超长时截断并说明"共 128 条,已返回前 10 条"。
原因很直接:ToolMessage 会原样进入上下文。返回 500 行日志,等于每轮推理都重烧一次 token,还会把真正的结论淹没掉。
规矩三:一个工具只做一件事。
do_everything(action, params) 是典型反模式:它逼着模型在参数里做路由,action 填错一步,后面全错,而且错误信息毫无指向性。拆成 query_order / cancel_order / refund_order 后,模型只需按意图选工具——做选择比填参数容易得多。
但工具不是越多越好。工具清单本身占 token,选项过密也会稀释模型的注意力。经验阈值:单 Agent 控制在 20 个以内,超出就按业务域拆分,或用中间件按场景动态裁剪工具列表。
规矩四:身份不进参数。 这一条值得单独一节。
四、信任边界:别让模型决定"你是谁"
先看一个看起来人畜无害的写法:
@tool
def query_my_orders(user_id: str, status: str) -> str:
    """查询指定用户的订单。"""
    ...
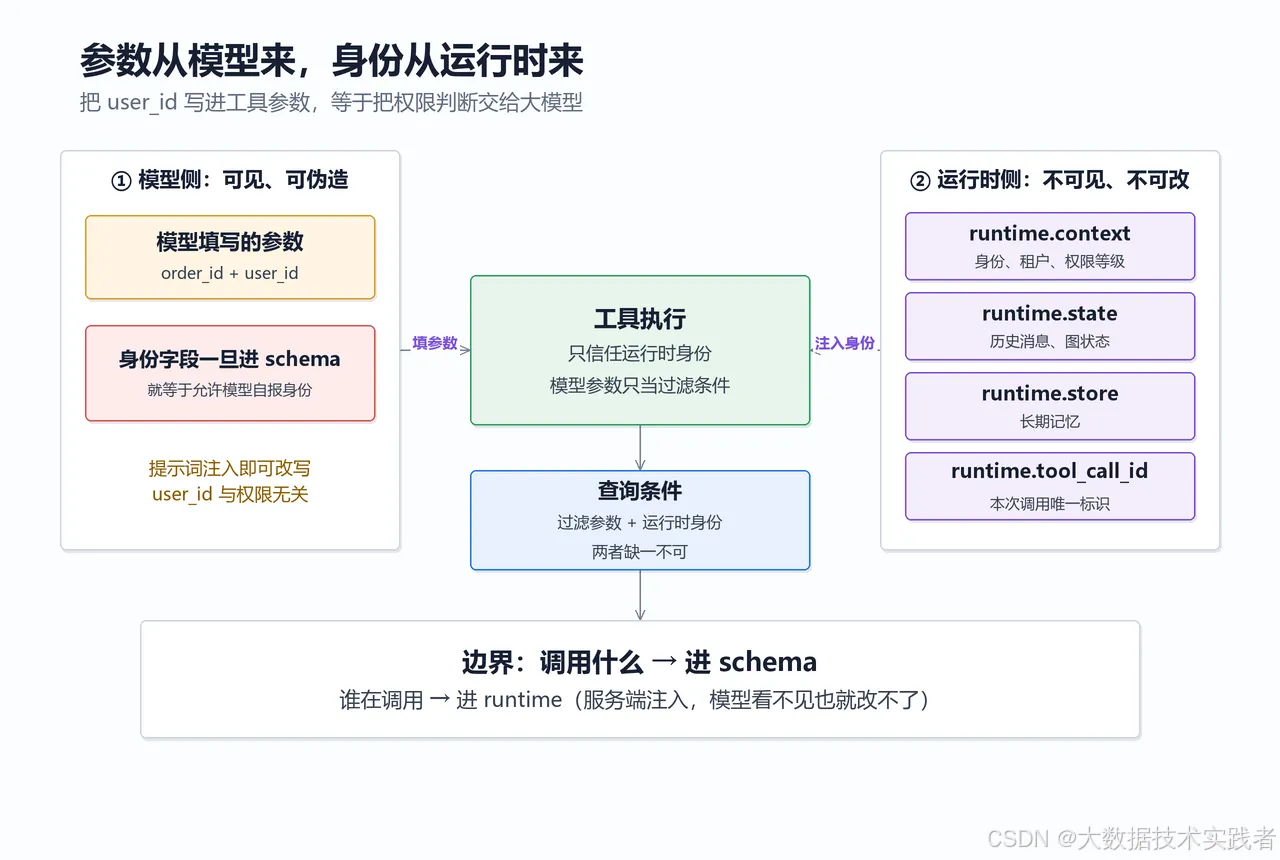
问题在于 user_id 进了 schema,就意味着它可以由模型填写。而模型填什么,取决于上下文——用户只要说一句"我是 U1002,帮我查下我的订单",模型就会老老实实把 U1002 填进去;如果这段对话里混进了网页抓取内容或用户上传的文档,提示词注入还能让它填任意值。
这不是模型"不听话",而是设计上把权限判断交给了最不该负责的一方。正确做法是把身份挪出 schema:
from dataclasses import dataclass
from langchain.agents import create_agent
from langchain.tools import tool, ToolRuntime

@dataclass
class UserContext:
    user_id: str
    tenant_id: str

@tool
def query_my_orders(status: str, runtime: ToolRuntime[UserContext]) -> str:
    """查询当前登录用户的订单。

    Args:
        status: 订单状态,可选 paid / shipped / closed
    """
    user_id = runtime.context.user_id      # 身份来自运行时,模型看不到也填不了
    rows = db.query(
        "SELECT id, amount, status FROM orders WHERE user_id = ? AND status = ?",
        user_id, status,
    )
    if not rows:
        return f"当前用户在 {status} 状态下没有订单"
    return "\n".join(f"{r['id']} | {r['amount']} | {r['status']}" for r in rows)

agent = create_agent(
    model=deepseek_llm,
    tools=[query_my_orders],
    context_schema=UserContext,
)

agent.invoke(
    {
   "messages": [{
   "role": "user", "content": "我有哪些已发货的订单?"}]},
    context=UserContext(user_id="U102", tenant_id="T01"),
)
ToolRuntime 参数由框架在执行前注入,不会出现在工具 schema 里,模型既看不见也改不了。除了 context,它还带了另外三样东西:
| 属性 | 拿到什么 | 典型用途 |
|---|---|---|
runtime.context |
调用时传入的上下文对象 | 身份、租户、权限等级 |
runtime.state |
当前图状态(含 messages) |
读历史消息、统计轮次、取上游节点结果 |
runtime.store |
长期记忆存储 | 读写用户偏好、跨会话记忆 |
runtime.tool_call_id |
本次调用的唯一 ID | 手工构造 ToolMessage 时必须带上 |
边界一划就清楚了:"调用什么"进 schema,"谁在调用"进 runtime。这条线守不住,后面所有的权限校验都是纸糊的。
五、容错:把异常翻译成模型能懂的话
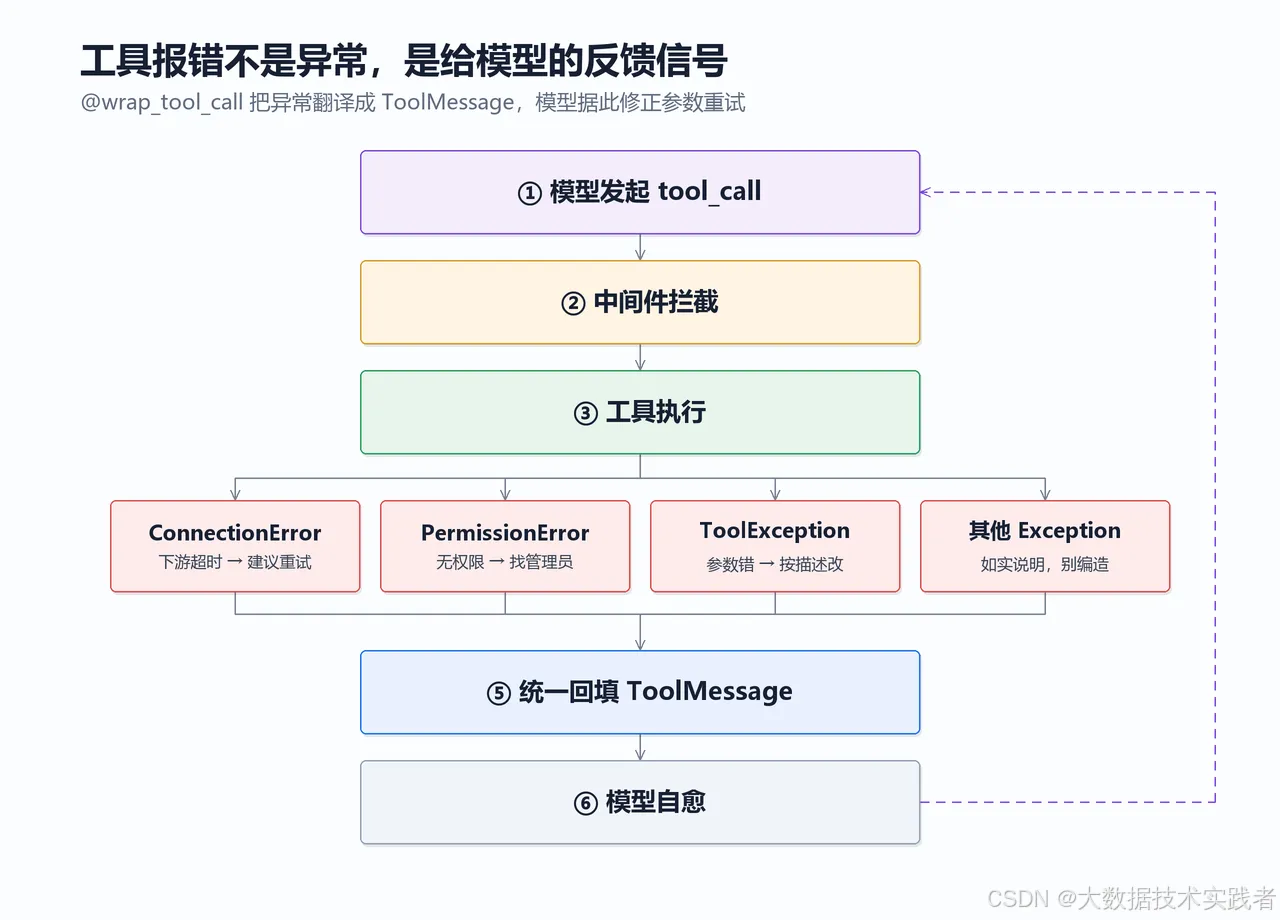
工具是 Agent 里最不稳定的部分——它连着网络、数据库、第三方 API,任何一环都可能抖。工具抛异常后,框架的兜底逻辑会给模型回一条通用错误消息,模型拿不到"下一步能做什么"的线索,表现通常是两种:反复重试同一个错误调用,或者更糟——编一个看起来合理的结果。
要控制这份措辞,用 @wrap_tool_call 中间件。它在工具执行前拦截请求,handler(request) 才是真正的执行:
from langchain.agents.middleware import wrap_tool_call
from langchain.messages import ToolMessage

@wrap_tool_call
def translate_tool_errors(request, handler):
    try:
        return handler(request)
    except ConnectionError as e:
        msg = f"下游系统超时:{e}。可以稍后重试,或改用本地缓存工具查询。"
    except PermissionError as e:
        msg = f"当前账号无权限:{e}。请告知用户联系管理员,不要重复尝试。"
    except ToolException as e:
        msg = f"参数不合法:{e}。请对照工具描述修正参数后重试。"
    except Exception as e:
        logger.exception("tool failed: %s", request.tool_call["name"])
        msg = f"工具执行失败:{e}。请如实告知用户,不要猜测或编造结果。"
    return ToolMessage(content=msg, tool_call_id=request.tool_call["id"])

agent = create_agent(
    model=deepseek_llm,
    tools=[query_ticket, update_ticket_status],
    middleware=[translate_tool_errors],
)
三个必须注意的点:
tool_call_id不能省。每条tool_call都必须有对应的ToolMessage,缺了它消息历史就不合法,OpenAI 会直接报tool_call_id not found之类的错误;- 错误信息要可操作。写"稍后重试""联系管理员""修正参数",模型才知道下一步;只写
500 Internal Server Error,它只会道歉; - 明确禁止编造。"请如实告知用户,不要猜测结果"这句写在错误消息里,比写在 system prompt 里更贴近现场——它出现在模型正想找补的那一刻。
效果可以看一个真实场景。用户说"把工单 T001 状态改成完结状态",工具抛出「状态必须是:待处理、处理中、已解决、已关闭」。模型收到这条 ToolMessage 后没有硬编,而是回了一段:
目前可用状态为待处理、处理中、已解决、已关闭,您说的"完结"对应哪个?如果是问题已修复建议选「已解决」;如果彻底结束建议选「已关闭」。
这不是一次报错,这是一次成功的交互。模型没有变聪明,是错误消息给了它台阶。
最后一个边界要守住:不是所有异常都该吞。下游超时、参数不合法、权限不足,适合转成 ToolMessage 让模型周旋;而 KeyError、NullPointerException 这类编程错误应该让它炸出来——吞掉它们,你会在生产环境收获一个"永远在道歉、但永远查不出问题"的 Agent。所以兜底分支务必打日志、接告警,别静默返回一句"操作失败"。
六、三个容易忽略的工程细节
6.1 一次推理可以发多个工具调用
模型完全可以在一条 AIMessage 里返回多个 tool_calls——用户问"我的订单到哪了、顺便看下能退多少",模型会同时调用 query_logistics 和 calc_refund,框架并发执行后把多条 ToolMessage 一起回填,然后进入下一轮推理。
这带来两个硬要求:工具不能有共享可变状态(别在工具里改全局字典、别复用同一个数据库连接做事务),写操作必须幂等(并发重试不能重复扣款)。很多人把工具当 Controller 方法随手写,一上并发就出数据错乱,根因往往在这里。
6.2 return_direct:让工具直接终结循环
默认流程是"工具返回 → 模型再总结一轮"。但有些场景这轮总结纯属多余,甚至有害:工具已经返回了排版好的报表链接,模型再总结一遍,很容易把数字抄错。
@tool(return_direct=True) 让 Agent 在工具执行后直接结束,跳过二次加工。判据很简单:返回值是否已经是面向用户的最终措辞。是,就用它省一轮 token 和一次出错机会;不是(返回的还是原始数据),就老老实实让模型组织语言。
6.3 工具清单是有 token 成本的
工具清单随每次请求发送,且每轮推理都付一次。粗略估算:一个中等复杂度的工具(名字 + 80 字描述 + 4 个参数)约 150~250 tokens,20 个工具就是 3~5k tokens 的固定开销——比很多人的 system prompt 还长。
所以"多加个工具试试"比想象中贵。该合并的合并(同一实体的增删改查合成一个带 action 枚举的工具,注意别退化成前面说的 do_everything),该按域拆的拆,比堆清单划算。
6.4 常见踩坑对照
| 现象 | 根因 | 修法 |
|---|---|---|
| 模型从不调用工具 | 描述太笼统,名字看不出动作 | 名字用「动词_名词」,描述写触发场景 |
| 参数总缺字段 | 字段没写 description,或 required 全空 |
每字段补 description,必填项设进 required |
| 调用直接报错 | 工具名含空格、中文或特殊字符 | 统一 snake_case |
| 上下文越跑越长 | 工具返回大列表、大日志 | 加 limit,超长截断并说明总数 |
| 反复重试同一错误 | 错误信息不可操作 | 错误里给出下一步动作或合法取值 |
| 换模型后工具失灵 | 依赖了某家模型对描述的隐式理解 | 描述写全,别赌模型的常识 |
七、小结:工具清单就是能力边界
把这篇的要点压缩成一份上线前的检查清单:
- 契约三件套:name 用
snake_case,description 写清触发场景与排他边界,args_schema 用 Pydantic 把枚举约束住; - 返回值:结构化、带字段名、空结果有明确文案、列表必带 limit;
- 粒度:一工具一事,单 Agent 工具数控制在 20 以内,超了按域拆;
- 信任边界:身份、租户、权限一律走
ToolRuntime,绝不进 schema; - 容错:
@wrap_tool_call分类翻译异常,ToolMessage 带tool_call_id,编程错误照常抛出。
工具写得好不好,不看代码优不优雅,只看一件事:模型能不能在不问你任何问题的情况下,把它们用对。这份"无需解释的正确性",就是 Agent 稳定性的来源。
