
把 Store 传给 create_agent 之后,工具里却取到空值;工具明明写了记忆,模型下一轮还是答不上来;更麻烦的是模型自作主张,把 A 用户的偏好写进了 B 用户的命名空间。这几类问题都不在 Store 本身,而在工具这一侧的写法。
长期记忆的主力入口就是工具。LangChain 官方把读写示例放在工具里,Notion 笔记的长期记忆章节也把「工具中实现读写」单独列成一节。原因不难理解,模型能自己判断这一轮要不要查、要不要记,应用侧不必预先猜测。灵活是有代价的,参数怎么注入、身份从哪来、工具返回什么、写失败怎么办,每一处都有规矩。
本篇只讲这一条路径,从 ToolRuntime 的注入机制开始,给一套带参数校验的读写工具,再处理 Command、写入策略、异常兜底与生产装配,最后用两个实验验证结果。
一、工具拿不到 Store,多半是签名没写对
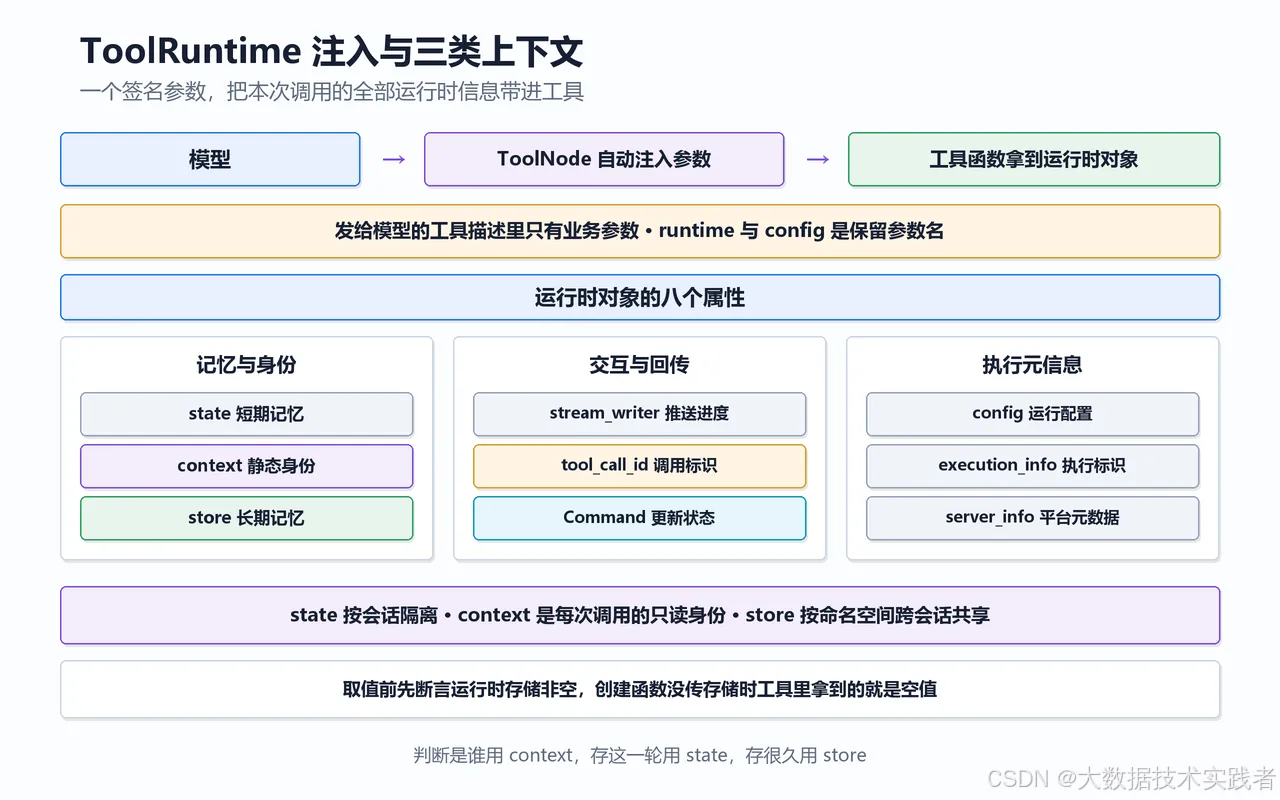
工具函数里想访问运行时信息,写法只有一个,在签名里声明 runtime: ToolRuntime。类型注解不能省,它同时定义了工具的输入结构。调用时由 ToolNode 自动注入,这个参数不会出现在发给模型的工具描述里,模型看不见它,也不需要为它填值。
from dataclasses import dataclass
from langchain.tools import ToolRuntime, tool

@dataclass
class Context:
    user_id: str
    tenant_id: str

@tool
def load_profile(runtime: ToolRuntime[Context]) -> str:
    """读取当前用户的档案。"""
    assert runtime.store is not None
    item = runtime.store.get(("users",), runtime.context.user_id)
    return str(item.value) if item else "暂无档案"
这里有三条容易忽略的规则。
第一,runtime 和 config 是保留参数名,不能拿它们当普通业务参数,否则运行时报错。第二,runtime.store 的类型允许为 None,忘了给 create_agent 传 store,工具里拿到的就是空值,所以取值前先断言,报错信息也比后续一串属性错误好定位。第三,官方已把 InjectedState、InjectedStore、get_runtime()、InjectedToolCallId 列为迁移前的旧写法,新代码统一收口到 ToolRuntime 一个对象,不必再记四套接口。
二、ToolRuntime 的八个属性,先分清三类上下文
ToolRuntime 像一只工具箱,把本次调用相关的运行时信息都装了进来。官方文档给出的属性如下。
| 属性 | 含义 | 典型用途 |
|---|---|---|
state |
短期记忆,当前会话内的可变数据 | 读消息列表,取本会话的订单号 |
context |
调用时传入的静态配置,不随对话变化 | 用户 id、租户 id、环境标识 |
store |
长期记忆,跨会话存活的 JSON 文档库 | 读写用户偏好、档案、经验 |
stream_writer |
流式写入器 | 工具执行中推送进度 |
tool_call_id |
本次工具调用的唯一标识 | 构造 ToolMessage 或 Command |
config |
本次执行的 RunnableConfig | 读取回调、标签、元数据 |
execution_info |
执行标识与重试信息 | 取 thread_id、run_id、尝试次数 |
server_info |
平台侧元数据 | 取 assistant_id、graph_id、登录用户 |
execution_info 与 server_info 需要 langgraph 1.1.5 以上版本,本地开发时 server_info 为 None,stream_writer 也要求工具运行在 LangGraph 的执行上下文里。
最容易混的是前三个。state 按 thread_id 隔离,会话结束就不管了;context 是每次 invoke 传进来的只读身份,本身不持久化;store 按 namespace 归档,任何 thread 都能取。工具里写偏好用 store,写「这一轮刚查过的订单号」用 state,判断「当前是谁」用 context,三者别互相替代。
泛型可以补上类型提示。官方示例给出 ToolRuntime[UserContext] 与 ToolRuntime[None, CustomState] 两种写法,前者约束 context,后者第二个参数约束自定义 state,不需要约束的那一位写 None。合起来就是第一位管 context,第二位管 state。
from langchain.agents import AgentState
from langchain.tools import ToolRuntime, tool

class SessionState(AgentState):
    current_order_id: str

@tool
def who_am_i(runtime: ToolRuntime[Context]) -> str:
    """返回当前调用的身份信息。"""
    return f"tenant={runtime.context.tenant_id}, user={runtime.context.user_id}"

@tool
def current_order(runtime: ToolRuntime[None, SessionState]) -> str:
    """返回本会话正在处理的订单号。"""
    return runtime.state.get("current_order_id", "无")
三、读写工具对,身份和写入内容都要约束住
把读写拆成两个工具是常见做法。写工具最怕模型自由发挥,类别填错、字段缺失、把整段对话塞进 value。用 Pydantic 模型配 args_schema,把类别限定成枚举,脏数据在参数校验阶段就被挡住,进不了 Store。官方示例也用 TypedDict 定义结构,写入时 dict(user_info) 转成字典,思路一致。
import uuid
from typing import Literal
from pydantic import BaseModel, Field
from langchain.tools import ToolRuntime, tool

class PreferenceInput(BaseModel):
    category: Literal["color", "food", "lang"] = Field(
        description="偏好类别,只能是 color、food、lang")
    value: str = Field(description="具体偏好内容,如蓝色、意大利面")

@tool(args_schema=PreferenceInput)
def save_preference(category: str, value: str,
                    runtime: ToolRuntime[Context]) -> str:
    """把一条用户偏好写入长期记忆,仅在用户明确表达偏好时调用。"""
    assert runtime.store is not None
    ns = (runtime.context.tenant_id, runtime.context.user_id, "preferences")
    runtime.store.put(ns, str(uuid.uuid4()),
                      {
   "category": category, "value": value})
    return "偏好已保存"

@tool
def load_preferences(runtime: ToolRuntime[Context]) -> str:
    """列出当前用户已保存的全部偏好。"""
    assert runtime.store is not None
    ns = (runtime.context.tenant_id, runtime.context.user_id, "preferences")
    items = runtime.store.search(ns, limit=50)
    if not items:
        return "暂无偏好记录"
    lines = [f"{it.value['category']} - {it.value['value']}" for it in items]
    return ";".join(["已保存的偏好"] + lines)
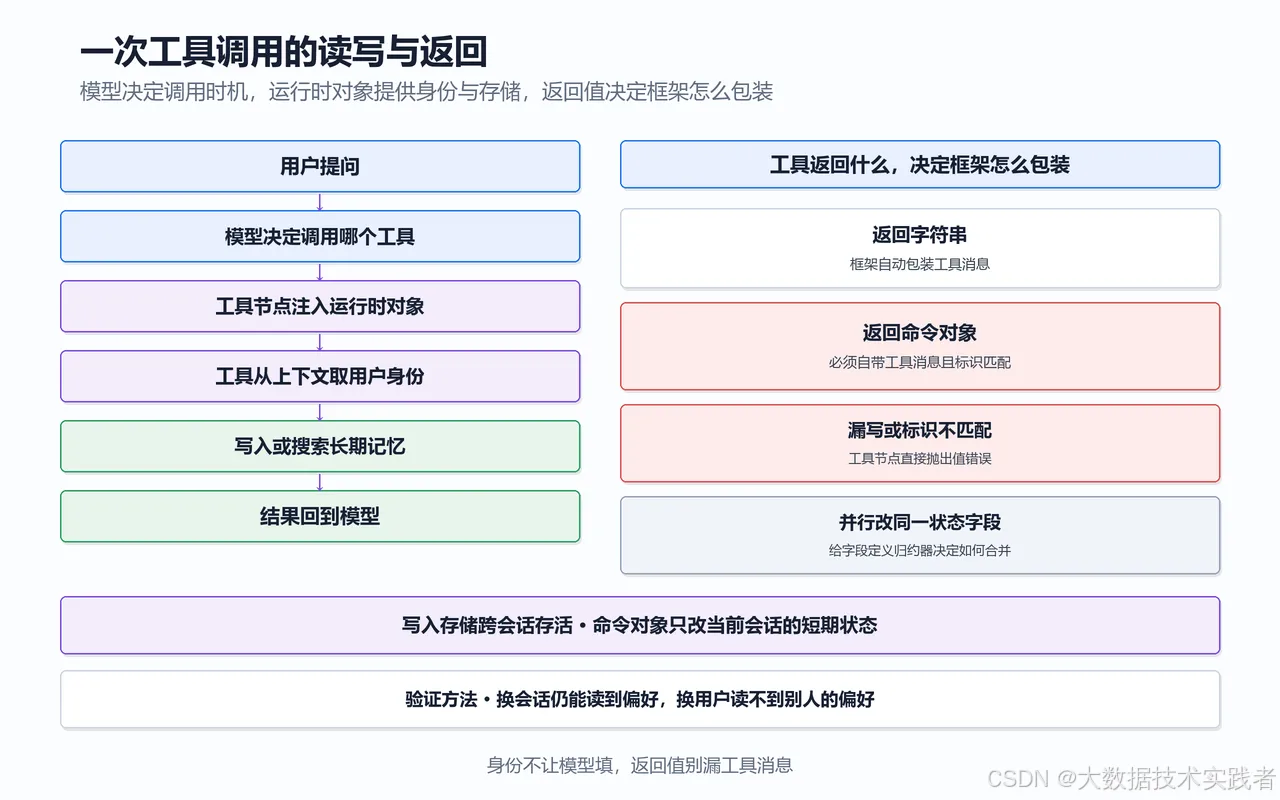
四个细节决定这套工具能不能用住。用户 id 和租户 id 从 runtime.context 取,绝不让模型填,模型猜错身份就会串数据。namespace 前段带上这两个值,写入用完整命名空间,因为 search 传短前缀会连带返回所有子命名空间的条目。docstring 写明「仅在用户明确表达偏好时调用」,模型靠工具描述判断调用时机,描述含糊就会出现每轮乱写或该写不写。search 的 limit 默认只有 10,超出部分静默截断,这里显式给 50。
put 的三个参数分别是命名空间元组、字符串 key 和字典 value,value 必须是字典,不能直接塞字符串。
四、返回 Command 时,ToolMessage 不能省
工具在读写长期记忆之外,还常要更新本会话状态。比如查订单时把订单号记进 state,供后续轮次复用。这时工具要返回 Command,而不是字符串。
from langchain.messages import ToolMessage
from langgraph.types import Command
from langchain.tools import ToolRuntime, tool

@tool
def bind_order(order_id: str,
               runtime: ToolRuntime[Context, SessionState]) -> Command:
    """记录本轮查询的订单号,并同步写入长期记忆。"""
    assert runtime.store is not None
    ctx = runtime.context
    runtime.store.put((ctx.tenant_id, ctx.user_id, "orders"), order_id,
                      {
   "last_action": "queried"})
    return Command(update={

        "current_order_id": order_id,
        "messages": [ToolMessage(
            content=f"订单 {order_id} 已记录",
            tool_call_id=runtime.tool_call_id,
        )],
    })
红线只有一条,消息历史里每一次工具调用都必须有对应的 ToolMessage。工具返回普通字符串时框架会自动包装,返回 Command 时不会自动包装,漏写或 tool_call_id 不匹配,ToolNode 会直接抛 ValueError。用 runtime.tool_call_id 取本次调用标识,别自己生成。
另一处是并发。模型可能在同一批次里并行调用多个工具,若它们都改同一个 state 字段,要给字段定义 reducer 决定如何合并,否则后写覆盖先写。
from typing import Annotated
import operator

class SessionState(AgentState):
    viewed_order_ids: Annotated[list[str], operator.add]
还要注意两个容器不是一回事。store.put 写的是跨会话的长期记忆,Command.update 改的是当前 thread 的短期状态,换一个 thread_id 后者就断了,前者仍在。
五、写入策略,key 决定后面好不好维护
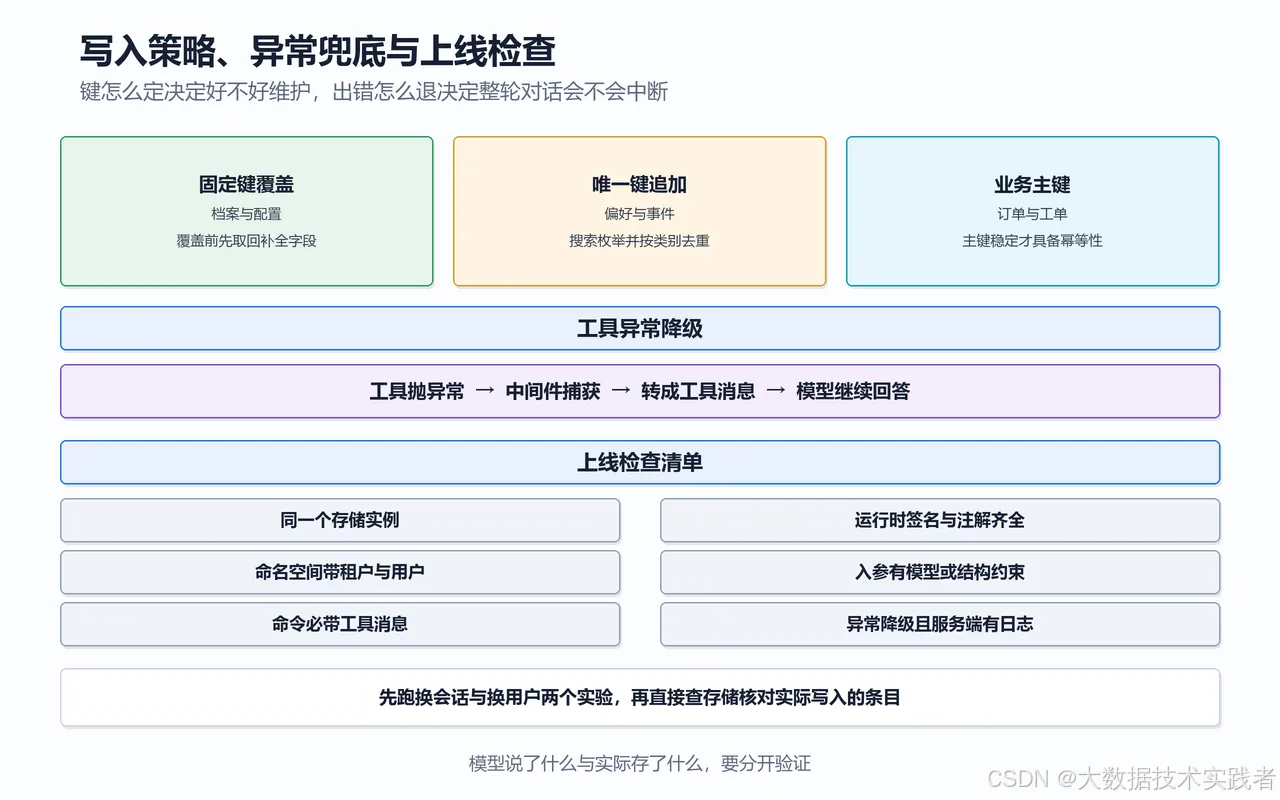
namespace 定作用域,key 定更新语义。同一个 namespace 里对同一个 key 再次 put,是整份文档覆盖,不是按字段合并。只改一个字段却只传了那一个字段,其余字段会丢。
| key 策略 | 写法 | 适合 | 注意 |
|---|---|---|---|
| 固定 key 覆盖 | put(ns, "profile", value) |
用户档案、配置 | 覆盖前先 get,把原字段补全再写 |
| 唯一 key 追加 | put(ns, str(uuid.uuid4()), value) |
偏好流、事件记录 | 需要 search 枚举,并做去重 |
| 业务主键 | put(ns, order_id, value) |
订单、工单等实体 | 主键稳定才具备幂等性 |
追加写最容易出现重复条目,用户每提一次偏好就写一条,几轮下来 Store 里全是同义记录。工具内部可以先按类别清理再写,把去重放在写入口,比事后跑清洗脚本省事。
def remember_once(store, ns, category, value):
    """同一类别只保留最新一条,避免每轮重复写入。"""
    for it in store.search(ns, limit=100):
        if it.value.get("category") == category:
            store.delete(ns, it.key)
    store.put(ns, f"{category}_latest",
              {
   "category": category, "value": value})
这段逻辑放在工具内部,也可以挪到会话结束后的后台任务里。判断新旧用 Item 的 updated_at,写错的记忆用 delete(namespace, key) 清掉,注意 delete 同样要传完整的命名空间。
六、工具异常要转成 ToolMessage
数据库抖动、连接超时、value 序列化失败,工具里抛出的异常会中断整轮 Agent 循环。记忆读写属于辅助能力,它失败时更合理的做法是降级,让模型知道这件事然后继续回答。用 @wrap_tool_call 中间件包一层即可。
from collections.abc import Callable
from langchain.agents.middleware import wrap_tool_call
from langchain.messages import ToolMessage
from langchain.tools.tool_node import ToolCallRequest

@wrap_tool_call
def handle_tool_errors(
    request: ToolCallRequest,
    handler: Callable[[ToolCallRequest], ToolMessage],
) -> ToolMessage:
    """把工具异常转成模型能理解的提示,避免整轮对话中断。"""
    try:
        return handler(request)
    except Exception as e:
        return ToolMessage(
            content=f"记忆读写暂时不可用,请稍后重试。({e})",
            tool_call_id=request.tool_call["id"],
        )
中间件里取调用标识用 request.tool_call["id"],工具内部用 runtime.tool_call_id,两处别混。也不要静默吞掉异常,返回给模型的提示要能说明发生了什么,同时在服务端记日志,否则线上只会看到「记忆时灵时不灵」。
七、生产装配与两个验证实验
InMemoryStore 方便调试,进程重启数据就没了。生产换成数据库后端,首次部署跑一次 setup() 建表。常驻服务在进程启动时初始化一次并复用同一个实例,脚本类任务可以用 with 包起来自动关连接。
from langchain.agents import create_agent
from langgraph.checkpoint.memory import InMemorySaver
from langgraph.store.postgres import PostgresStore

DB_URI = "postgresql://postgres:postgres@localhost:5432/postgres?sslmode=disable"

store = PostgresStore.from_conn_string(DB_URI)
store.setup()

agent = create_agent(
    "claude-sonnet-4-6",
    tools=[save_preference, load_preferences, bind_order],
    store=store,
    checkpointer=InMemorySaver(),
    state_schema=SessionState,
    context_schema=Context,
    middleware=[handle_tool_errors],
)
context_schema 建议用 dataclass 或字典。本地案例中把 Pydantic 模型对象直接传给 invoke 的 context 参数,部分版本会触发 Pydantic 序列化警告,官方示例用的是 dataclass,照它来更省心。除 PostgresStore 外,官方还列了 MongoDBStore、RedisStore 等后端,接口一致。
装配完做两个实验,比翻日志直观。以下代码与上面的装配处在同一个作用域内。
ctx = Context(user_id="u_123", tenant_id="t_42")
cfg_a = {
   "configurable": {
   "thread_id": "session-a"}}
cfg_b = {
   "configurable": {
   "thread_id": "session-b"}}

agent.invoke(
    {
   "messages": [{
   "role": "user", "content": "记住我喜欢蓝色"}]},
    config=cfg_a, context=ctx,
)

r1 = agent.invoke(
    {
   "messages": [{
   "role": "user", "content": "我有哪些偏好"}]},
    config=cfg_b, context=ctx,
)
print("换会话", r1["messages"][-1].content)

other = Context(user_id="u_999", tenant_id="t_42")
r2 = agent.invoke(
    {
   "messages": [{
   "role": "user", "content": "我有哪些偏好"}]},
    config=cfg_a, context=other,
)
print("换用户", r2["messages"][-1].content)

print(store.search(("t_42", "u_123", "preferences"), limit=50))
第一个实验里 session-b 的短期记忆是空的,偏好仍应被读出来,说明 store 装配正确。第二个实验换成另一个用户,不应读到 u_123 的偏好,说明 namespace 隔离生效。最后一行直接查 Store,用来核对写入位置与条目数,把「模型说了什么」和「实际存了什么」分开验证。
| 现象 | 优先检查 |
|---|---|
| 工具里断言失败 | create_agent 没传 store,或传了另一个实例 |
| 模型从不调用读写工具 | docstring 过于含糊,或工具没注册进 tools |
| 写入脏数据、类别乱填 | 没用 args_schema 或 TypedDict 约束入参 |
| Command 抛 ValueError | 漏了 ToolMessage,或 tool_call_id 不匹配 |
| 换用户读到别人偏好 | namespace 前段没带 tenant_id 与 user_id |
| 写入成功但读不到 | search 传了短前缀,或 limit 小于实际条目数 |
八、上线检查清单
把工具侧的细节逐项过一遍,能挡掉大部分记忆类线上问题。
- store 是同一个实例,工具、中间件、Agent 三处指向一致。
runtime签名与类型注解齐全,runtime和config没被当成业务参数。- 用户身份只从 context 取,namespace 前段带 tenant_id 和 user_id。
- 写入参数有 Pydantic 或 TypedDict 约束,docstring 写清调用时机。
- 返回 Command 必带 ToolMessage 且 tool_call_id 匹配,并行改 state 定义了 reducer。
- key 策略明确,覆盖写前先 get 补全字段,追加写有去重。
- 工具异常经 wrap_tool_call 降级,不中断整轮回答,服务端有日志。
- 生产换成数据库 Store 并跑过 setup(),换 thread 与换 user 两个实验都通过。
工具读写的价值在于把判断交给模型,代价是每次调用都要多付出一轮开销,还要防住模型写错、写重、写串。把注入、约束、返回、去重、兜底这五处规矩立住,长期记忆才算从示例走到可用。下一篇会进入记忆综合案例,把短期状态、长期偏好、消息摘要和工具容错放进同一个客服助手里看它们怎么配合。
