 论文:Google Earth AI Geospatial Reasoning Agent: Capabilities and a Systematic Evaluation
作者:Noam Slonim 等 37 人(Google Research / Google Geo / Spatial Bytes)
提交:2026 年 10 月 11 日 · arXiv:2610.15750 [cs.AI]
篇幅:39 页,4 图,11 表
一、当大模型开始“回答关于地球的问题”,评估本身成了难题
过去两年,地理空间 AI 经历了一次静默但深刻的转向。早期的系统本质上是“模型 + 数据”,把卫星影像、气象预报、人口统计分别训练成独立的预测器,再靠人工把它们拼在一起。而大语言模型的出现,让一种新的架构成为可能:一个语言模型作为编排者,按需调用一整套地理空间工具,用自然语言直接回答“某地洪水风险如何”“在哪里建太阳能电站最合适”这类问题。 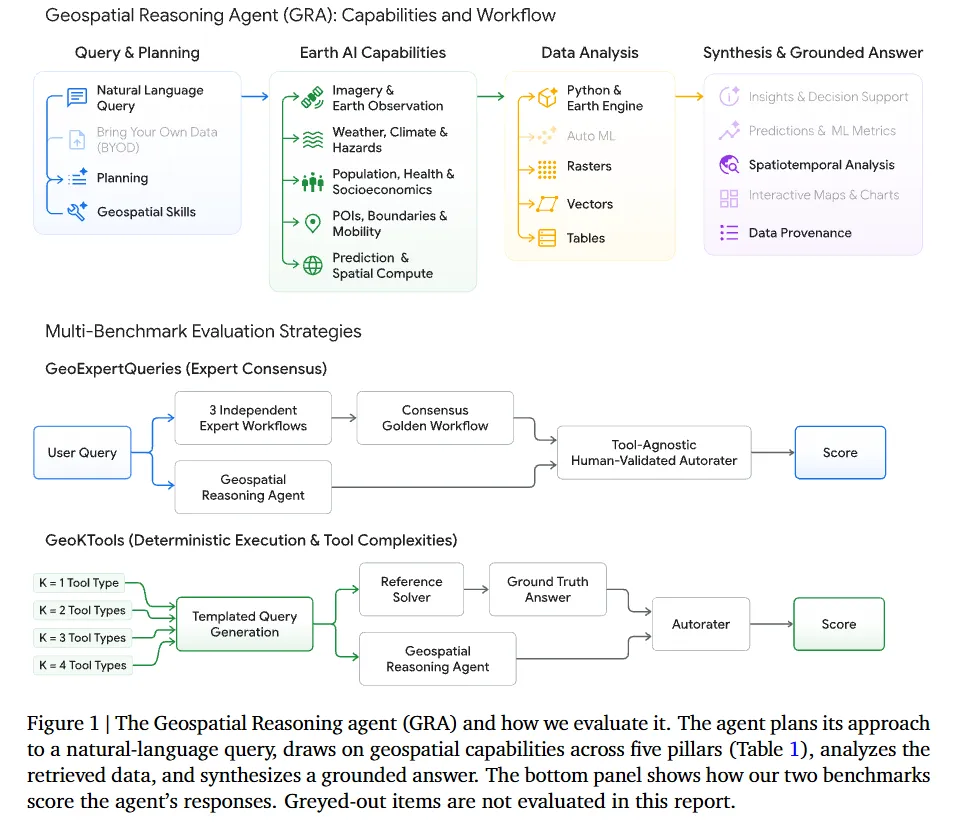
Google Earth AI 的地理空间推理智能体(Geospatial Reasoning Agent,GRA)就是这一路线的代表。它由 Gemini 驱动,背后是 Google 独有的地理空间资产:遥感基础模型 RSFM、人口动态基础模型 PDFM、AlphaEarth Foundations、WeatherNext 集合预报、业务化洪水预报、Google Maps 数据、Earth Engine 行星级目录、Data Commons 社会经济统计,等等。一个用户不需要知道哪颗卫星在什么时候拍过哪块地,只需要把问题说清楚,GRA 负责找到数据、组合图层、执行计算,返回一个分析结论,而不是一堆原始数据。 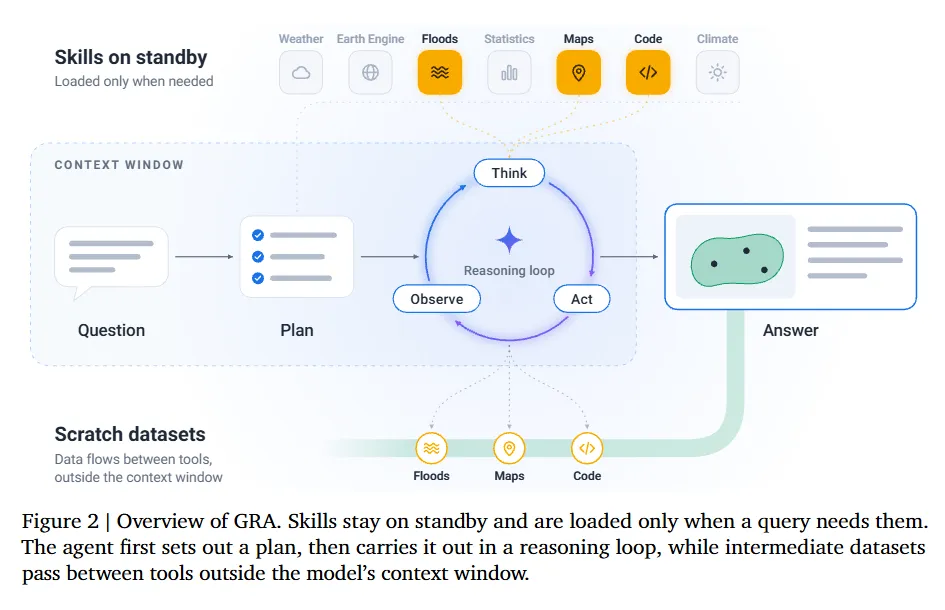
然而,恰恰因为这类系统“看起来太自然”,评估它们变得异常困难。论文开篇就列出了四重障碍:
- 没有唯一正确答案。 洪水风险评估可以基于官方洪水区划图,也可以基于高分辨率模拟,两者可能同样合理。
- 多条有效工作流并存。 用什么数据源、划什么时空边界、选什么分析方法,都会导向不同但都站得住脚的结论。
- 数据发现本身是任务的一部分。 查询里通常不包含所需数据,智能体必须在大规模异构目录中“找数据”。如果系统 A 能访问某个目录而系统 B 不能,B 表现差可能只是“看不到”,而非“想不明白”。
- 真实基准在漂移。 卫星档案会被重新处理,参考数据集会被修订,行政边界会重划。一个基准构建时正确的答案,运行时可能已经不再正确。
换句话说,评估地理空间智能体,不能只评“最终答案对不对”,还必须评“过程是否合理”“工具是否被有效利用”“规划是否到位” 。这篇论文的核心贡献,正是为这件事建立了一套可操作、可复现的框架。
二、GRA 的设计哲学:技能按需加载,规划先于行动
要理解论文的评估逻辑,需要先理解 GRA 的两个关键设计选择。
第一,能力被封装为“模块化技能”(modular skills)。 GRA 并没有把所有工具的完整定义一次性塞进模型的上下文。相反,每个技能的详细描述在需要之前是隐藏的,只有技能被加载后才进入工作记忆。这样做有两个直接好处:上下文窗口只花在当前查询真正需要的工具上;新增能力不会让已有能力“变得更难用”。与此同时,大型空间数据集(比如覆盖一个国家的遥感影像)不进入上下文,而是作为“草稿数据集”(scratch datasets)在工具之间按引用传递。
第二,前置规划(upfront planning)先于任何数据调用。 在调用任何一个地理空间工具之前,GRA 会先对文档化的能力及其局限进行推理,列出一份检索和处理计划,然后再按计划执行。执行过程中允许根据工具输出偏离计划,但偏离是有护栏的:遇到死路时知道何时停止重试,理想测量不可得时知道用代理数据集替代。
这两个设计合在一起,构成了 GRA 与“ReAct 式”反应型智能体的根本区别。反应型智能体每一步只根据上一步的观察决定下一步动作;GRA 则先想清楚再动手,边执行边调整。论文的评估设计,本质上就是要量化这两个设计各自值多少。
三、两个新基准:一个测“开放世界的合理性”,一个测“工具编排的可控性”
为了在“开放”和“可控”之间取得平衡,论文构建了两个内部基准,并公开了开发集。
GeoExpertQueries:用专家共识工作流来评“过程”
GeoExpertQueries 包含 101 道开放式分析题,其中 76 道作为测试集留出。题目不是凭空构造的,而是扎根于真实从业者的用例,并由地理空间领域专家在危机韧性、公共卫生、选址分析等场景中反复打磨。
每道题配有一个 “黄金工作流”(golden workflow) :由三位独立专家(且对 GRA 的工具集不知情)分别给出自己的工作流,再取共识。评分不要求智能体严格复现某一条工具调用序列。论文使用了一个经过人工验证的、工具无关的自动评分器(tool-agnostic autorater) ,它评估的是分析是否合理、数据来源是否恰当、推理步骤是否站得住脚,而不是“你有没有按专家写的步骤走”。这让评估对不同的技术路线保持开放。
GeoKTools:用可控工具数量来测“编排能力”
GeoKTools 走的是另一条路。它包含 305 道模板化查询,其中 220 道留出测试,来自 92 个专家撰写的模板,覆盖 24 种工具类型。每一道查询都有一个确定性的参考答案求解器,而所需工具类型的数量被系统性地从 1 变化到 4 。这意味着研究者可以精确地观察:当任务从“用一个工具”变成“协调四种工具”时,系统的表现如何退化或保持。
此外,论文还使用了两项外部基准:CBGB 和 UnivEARTH,二者都要求模型为 Google Earth Engine 编写可执行的地理空间代码,并对比数值或“是/否”输出。其中一个值得注意的发现是,UnivEARTH 已经饱和——在这个基准上,各个配置(甚至没有任何 Earth Engine 访问权限的独立 LLM)得分都接近天花板,说明它已经不再具有区分能力。
四、四配置实验:分离“工具”与“规划”的贡献
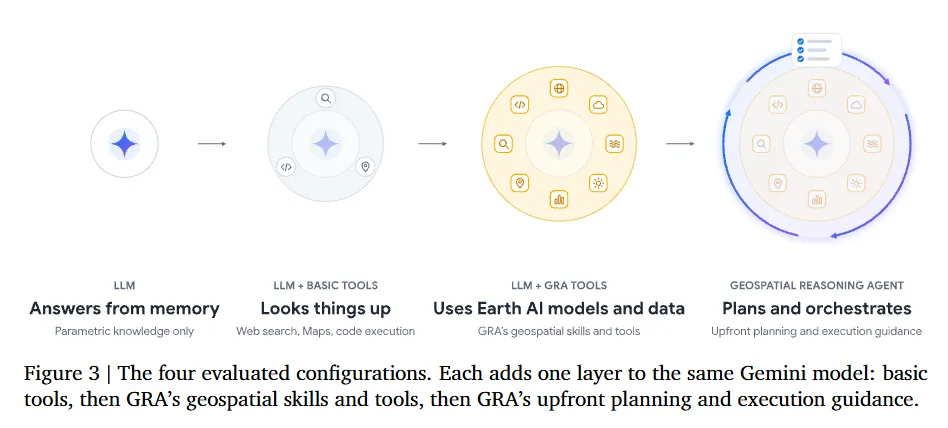
这是论文方法论上最关键的一步。作者没有只比较“GRA vs 普通 LLM”,而是构建了四层递进的配置,全部运行在同一个 Gemini 模型之上:
| 配置 | 模型 | 工具 | GRA 技能/工具 | 前置规划 + 执行指导 |
|---|---|---|---|---|
| ① 独立 LLM | Gemini 3.1 Pro 或 3.8 Flash | 无 | 无 | 无 |
| ② LLM + 基础工具 | 同上 | 搜索、地图、离线代码执行 | 无 | 无 |
| ③ LLM + GRA 技能/工具 | 同上 | 同上 | 有,但反应式调用 | 无 |
| ④ 完整 GRA | 同上 | 同上 | 有 | 有 |
这个设计的精妙之处在于:它把“领域工具做了什么”和“编排层做了什么”拆开了。配置 ③ 拥有和完整 GRA 完全相同的工具和技能,但缺少前置规划与执行指导。两者之间的差距,就是规划本身的价值。
关键数字
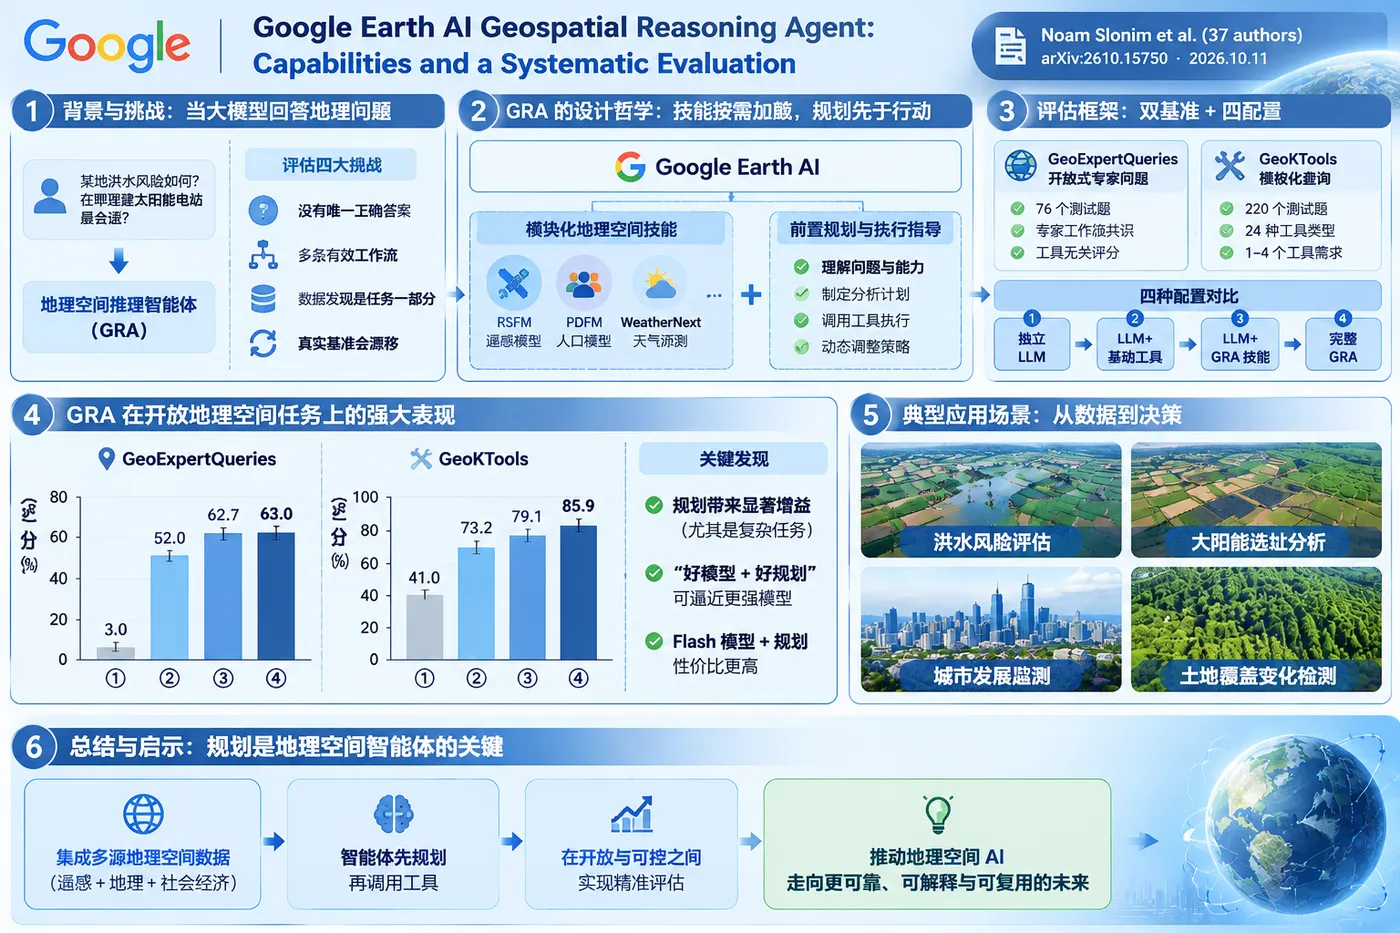
在 GeoKTools 上,完整 GRA 的得分为 85.9,而最强的基线(独立 LLM,没有任何工具)仅为 41 。在 GeoExpertQueries 上,完整 GRA 使用 Gemini 3.8 Flash 达到 62.7,而独立 LLM 在同一基准上仅约 3 分——从 3 到 52 的第一步跃升,主要来自 GRA 的地理空间技能和工具;从前置规划与执行指导中,又进一步从 52 提升到 63(约 62.7 的精确值)。在 CBGB 上,完整 GRA 得分超过 80,而两个基线均未超过 20 。
这些数字传达的核心信息是清晰的:对于模板化查询,一个强模型加上基础工具就能恢复相当一部分答案;但对于开放式专家级问题,基础工具只能满足工作流要求的一小部分,而 GRA 的领域技能和工具带来了最大的单步提升。在前者之上,前置规划对最难的问题进一步加码,且对 Flash 模型的增益尤为显著。
一个值得注意的反直觉发现
规划层的最大受益者不是最强的模型,而是较小的 Flash 模型。在 Gemini 3.8 Flash 上加入完整 GRA 的规划与执行指导后,其 GeoExpertQueries 得分从 52 升至 63,足以匹配甚至超过 Gemini 3.1 Pro 在同等配置下的表现,而推理成本更低。论文由此得出的结论带有工程上的务实意味:如果编排层设计得当,“好模型 + 好规划”可以在开放地理空间任务上逼近“更好的模型 + 无规划”,代价却小得多。
五、这项工作的真正分量:不只是发布了 GRA,而是发布了“怎么评”
回顾整篇论文,GRA 本身固然重要——它展示了 Google 在地理空间 AI 上把基础模型、行星级数据和智能体编排缝合在一起的能力。但论文更持久的贡献,可能在于它把一个此前难以系统回答的问题变成了可操作的实验问题:在一个真实世界问题天然多解、数据发现即任务、基准会漂移的领域里,怎样严谨地衡量一个智能体“到底哪里有用”。
论文公开了两个新基准的开发集、自动评分器的提示词、GeoKTools 每个模板的参考求解器规范。这意味着后续研究者可以在这个框架上比较不同的编排策略、不同的工具集、不同的模型,而不必各自从头定义“什么算好”。在此之前,地理空间智能体的评估往往停留在“展示几个成功案例”的阶段;这篇论文把它推进到了分层归因的阶段:不是笼统地说“智能体比 LLM 好”,而是说清楚好在哪一层、对哪类问题、在哪个模型上。
对于正在构建或使用地理空间 AI 系统的人来说,最实际的启示或许是:不要低估“规划”作为一等工程对象的地位。 当工具的数量和异质性达到一定程度,模型本身的通用推理能力只能带你走完第一段路;真正决定系统在开放问题上能走多远的,是它是否在动手之前就知道自己要去哪里,以及在路走不通时是否知道如何体面地绕开。GRA 的实验数据表明,这一层设计对较小、较便宜的模型尤其关键——而这恰恰是大多数真实部署中会面对的成本约束。