
Entropic Distribution Matching in Supervised Fine-tuning of LLMs: Less Overfitting and Better Diversity
LLMs监督微调中的熵分布匹配:更少过拟合与更优多样性
论文
摘要
大语言模型依赖监督微调(SFT)来专门化于下游任务。交叉熵(CE)损失是 SFT 中事实上的首选,但由于其对数据分布进行激进的更新,常常导致过拟合和输出多样性受限。本文旨在通过引入最大熵原理来解决这些问题,该原理偏好分布更平坦但仍能有效捕捉数据的模型。具体而言,我们提出了一种名为 GEM 的新分布匹配方法,它求解带有熵正则项的逆向 Kullback-Leibler 散度最小化问题。对于 Llama-3-8B 模型的 SFT,GEM 在若干方面优于 CE。首先,当应用于 UltraFeedback 数据集以开发通用指令遵循能力时,GEM 表现出更少的过拟合,这体现为更低的困惑度以及在 IFEval 基准上更好的性能。此外,GEM 增强了输出多样性,从而在使用 best-of-$n$ 采样时,即使没有领域特定数据,也能在数学推理和代码生成任务上带来最多 7 个点的性能提升。其次,当使用用于数学推理和代码生成的领域特定数据集进行微调时,与 CE 相比,GEM 也表现出更少的过拟合以及最多 10 个点的提升。
1.引言
大型语言模型(LLMs)[38, 53, 52] 是强大的生成模型,在各个领域的专门任务中表现出色。通常,LLMs 首先经历预训练阶段 [42, 7],在该阶段中,它们从大规模文本语料库(如书籍、科学论文和代码)中学习预测下一个 token。尽管进行了如此广泛的预训练,LLMs 仍常常难以遵循指令并回答用户的有效地查询,因为此类场景在预训练期间并不常见。为了提升它们在这些任务中的表现,采用了指令微调 [44, 60, 10],也称为监督微调(SFT)[39, 3]。该过程涉及使用高质量的标注数据(即提示-响应对),并且通常利用带有交叉熵(CE)损失的监督学习来最大化标注数据的似然。随后,这些模型可能进一步与人类偏好对齐,以确保其输出符合人类价值观 [39, 3]。SFT 引出从预训练中获得的知识,以回答各种下游问题,并进一步为未来发展铺平道路,使其成为后训练流程的关键部分 [68, 54, 34, 65]。我们期望模型通过提供准确答案来实现良好的泛化,并希望这些答案也具有多样性。虽然泛化的重要性显而易见,但我们同样强调生成多样性的重要意义。在创意写作中,多样性会激发新想法 [12];在闲聊对话中,用户通常喜欢有多种输出选项以契合其偏好 [30]。许多现代 AI 界面,例如 ChatGPT 和 Claude AI,通过加入重新生成按钮等功能来满足这一需求。此外,当在 LLM 中应用先进生成算法来处理复杂任务时,生成多样性至关重要 [50]。例如,常用于数学推理 [50] 和代码生成 [8] 的 best-of-$n$ 采样,受益于从多样化的生成选项集中选择最优响应。然而,在 SFT 中使用 CE 损失训练的模型常常受到过拟合(例如,见 [16, 17])和生成多样性不足(例如,见 [40, 37])的困扰。理论上,优化 CE 损失对应于最小化数据分布与 LLM 的生成分布之间的前向 Kullback–Leibler(KL)散度。1 这种分布匹配过程会激进地提高观测数据的似然,而这些观测数据往往仅呈现真实分布的狭窄覆盖,真实分布具有我们希望 LLM 学习的多样化结果。然而,CE 损失并未意识到这一点,优化后的模型会偏向低熵分布,导致输出多样性降低。一个具体示例见图 1(详情见附录 E)。先前研究 [41, 14] 将低熵预测分布与较差的泛化联系起来,表明这些问题相互关联。尽管从业者常将权重衰减正则化与 CE 损失一起使用 [39, 3],但这并未完全解决这些问题,因此需要更具原则性的方法。我们的贡献。我们将 LLM 的微调表述为一个分布匹配问题 1它被称为“前向” KL,因为该损失是在数据分布上定义的。我们稍后将讨论反向 KL 方法,其中损失是在生成模型的分布上定义的。并提出两条原则。第一条原则倡导生成分布匹配方法,以鼓励模型既从真实标签监督中学习,也从自身生成的错误中学习。这与 CE 损失中所用的对监督的被动模仿形成对比。第二条原则是,模型应为观测数据分配更高概率,同时防止过度记忆2,尤其是在处理有限数据时。为实现这些原则,我们研究带有熵正则化的反向 KL 散度最小化的表述。然而,该表述在技术上具有挑战性,并可能需要类似于 GAN 中使用的对抗训练技术 [18]。我们的主要技术贡献是开发了一种新的训练算法,称为 GEM(Generative Entropy-regularized Matching of distributions),它解决了上述挑战,并且与 CE 损失一样易于处理。通过遵循所提出的原则,GEM 倾向于更平坦的分布,从而有效捕获数据;示例见图 1。我们通过使用两类数据集微调 Llama-3-8B 预训练模型3 来证明我们模型的有效性。首先,我们使用 UltraFeedback 数据集 [13] 微调模型,以培养通用的指令遵循能力。我们的结果表明,GEM 实现了比 CE 更低的评估困惑度,并在 IFEval 基准 [69] 上取得更好的性能,表明过拟合减少。我们还通过评估模型在创意任务(如诗歌和故事写作 [36])中生成多样化内容的能力来评估输出多样性。我们的发现表明,GEM 显著增强了输出多样性。当利用诸如多数投票(MV)和 Best-Of-$N$(BON)等先进生成策略时,这种改善的多样性转化为数学推理(GSM8K [11])和代码生成任务(HumanEval [8] 和 MBPP [2])中的性能提升。在这些任务中,GEM 实现了最高 7 分的性能提升。在第二个实验中,我们分别在领域特定数据集上微调模型,以获得数学推理(MetaMathQA 数据集 [66])和代码生成(MagicCoder-OSS-Instruct 数据集 [62])的专门能力。在这种设置下,当使用 MV 和 BON 时,GEM 可以比 CE 高出最多 10 分,进一步证明其有效性。总体而言,这些结果表明,与 CE 相比,GEM 可以缓解过拟合并提高输出多样性。
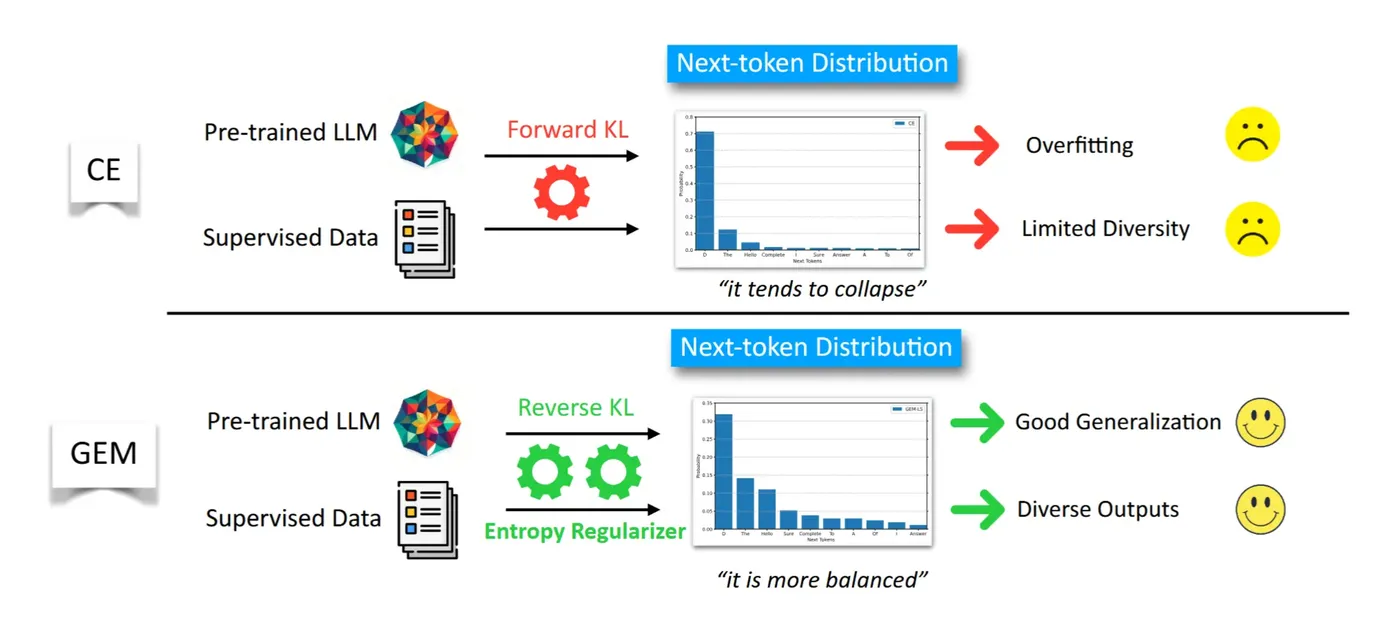
图 1:标准 CE 与所提出的 GEM 方法在 LLMs 的 SFT 中的差异示意图。
2.相关工作
监督微调。SFT 是后训练流程的第一阶段,并对后续发展起着重要作用。如引言所述,在 SFT 阶段使用 CE 损失往往会导致过拟合和输出多样性降低。为解决这一问题,有一系列研究致力于扩大 SFT 数据规模(例如,参见 [66, 62, 67]),这些方法虽然有效,但增加了计算负担。我们的工作旨在开发能够更有效地利用监督数据以缓解过拟合并增强输出多样性的训练方法。尽管近期如 [9, 29] 等研究尝试通过自我对弈等技术改进经 CE 训练的模型,但我们旨在解决 CE 损失的局限性,并设计能够直接改进预训练模型的方法。 我们还基于先前研究强调输出多样性的重要性。经 SFT 训练的模型通常通过基于人类反馈的强化学习(RLHF)进一步优化,以更好地与人类价值观对齐 [39, 3]。Xiao 等人 [64] 研究了 SFT 模型对 RLHF 中偏好学习的影响,表明如果 SFT 模型发生崩溃(即,以近乎确定的概率偏向某些输出),则可能进一步导致对齐中的偏好崩溃。他们的发现凸显了在 SFT 阶段解决崩溃问题的必要性。此外,经 SFT 训练的模型常被用作自我改进的合成数据生成器(参见,例如,[1, 15])。在此背景下,保持输出多样性至关重要。它有助于找到更好的解,并缓解模式崩溃问题 [19, 49]。对于专门应用,Wang 等人 [59] 在数学推理中通过多数投票强调了输出多样性的益处。近期研究 [6, 50] 探索了使用验证器增强对多个生成响应的搜索,表明扩大测试时计算规模是有效的。与这些聚焦于推理时技术的研究不同,本文改进 SFT 训练方法以促进多样性。 熵正则化。Dubey 等人 [14] 研究了最大熵在视觉细粒度分类任务中的应用,其中的挑战在于区分非常相似的对象类别。尽管其目标与我们的不同,但他们的见解仍然有价值。他们提出,达到零 CE 损失对于高准确率并非必要。相反,他们认为,条件概率分布只要其 $\mathrm{argmax}$ 对应于正确类别,对许多应用而言就足够了。这一概念促使我们使用熵正则化,它允许为观测数据之外的替代选项分配概率。在我们的工作之前,Pereyra 等人 [41] 也在神经网络训练的背景下探索了熵正则化。他们的方法与本文所研究的带熵正则化的 CE 非常相似,并且他们发现惩罚高置信度输出可以提高泛化能力。需要注意的是,Pereyra 等人 [41] 关注的是图像分类任务,而我们关注的是文本生成,其中数据本质上具有序列性,因而更具挑战性。在 LLMs 背景下,Hu 等人 [23] 也通过使用 GFlowNet [4] 探索了最大熵正则化,但其方法需要奖励函数而非监督数据。
3 预备知识
大语言模型(LLMs)。LLMs 拥有大规模词汇表,记为 $[K]={1,2,\ldots,K}$,并通过将文本切分为一系列词元 $(x_1,\ldots,x_T)$ 来处理文本,其中每个词元 $x_i\in[K]$,且 $T$ 表示序列长度。令 $f$ 为语言模型建模的生成分布。记号 $f(\cdot\mid x1,\ldots,x{t-1})$ 指定了在上下文 $(x1,\ldots,x{t-1})$ 条件下 $[K]$ 上的类别分布。通常,$f$ 由神经网络(通常是 Transformer [57])参数化,其参数为 $\theta$。对于时间步 $t$ 的第 $i$ 个词元,其预测概率由下式给出:
$$f_\theta(i\mid x_1,\ldots,x_{t-1}) = \operatorname{softmax}(z_t) = \frac{\exp(z_t[i])}{\sum_{i'}\exp(z_t[i'])}.$$
其中 $z_t\in\mathbb{R}^K$ 是给定输入 $(x1,\ldots,x{t-1})$ 时神经网络输出的 logit,且 $z_t[i]$ 是 $z_t$ 的第 $i$ 个元素。该自回归过程将词元序列的联合概率指定为
$$f_\theta(x_1,\ldots,x_T)=\prod_{t=1}^{T}f_\theta(x_t\mid x_1,\ldots,x_{t-1}).$$
LLMs 经过预训练以预测序列中的下一个词元,从而从海量数据中学习复杂的条件概率分布。在实际应用中,LLMs 的任务是针对给定提示 $x$ 生成响应 $y$。然而,这些问答场景通常不同于教科书式的预训练数据,使得预训练 LLMs 难以有效生成遵循人类指令的响应。监督微调。为解决上述问题,引入了监督微调(SFT)。该过程涉及使用包含高质量提示-响应对 ${(x_i,yi)}{i=1}^N$ 的监督数据集进行示范。CE 损失是用于此目的的事实上的训练目标:
$$\min_\theta \sum_{i=1}^N -\log f_\theta(y_i\mid x_i).$$
理论上,这对应于最小化数据分布 $p$ 与生成分布 $f\theta$ 之间的前向 KL 散度:
$$\min_\theta D_{\mathrm{KL}}(p, f_\theta) \iff \max_\theta \mathbb{E}_{x\sim \rho(\cdot)}\mathbb{E}_{y\sim p(\cdot\mid x)}[\log f_\theta(y\mid x)],$$
其中 $\rho$ 是提示分布,通常在 SFT 阶段不被建模。因此,分布 $\rho$ 可被视为常数,并且在上下文清楚时我们将其省略。在实践中,许多问题可能对应多个有效答案,并且几乎不可能收集一个涵盖所有可能性的全面高质量数据集。因此,经验数据往往规模有限,并且通常呈现出比期望更窄的分布。在此类情况下,CE 损失函数会激进地最大化可用经验数据的似然,调整生成分布 $f\theta$ 使其与之紧密对齐。然而,如前所述,这种方法可能导致生成多样性较差和过拟合。
4 熵分布匹配
本文探讨基于原理的方法,以解决现有使用 CE 损失的 SFT 的局限性,尤其是在处理有限数据时。我们提出两条核心原则:第一条关注分布匹配的方法论,第二条为从有限数据中学习提供指导。
我们的第一条原则倡导采用生成式方法进行分布匹配。该方法鼓励模型从其自身生成的数据和错误中学习,而不仅仅是模仿监督示范。与使模型被动模仿训练数据标签的传统 CE 损失不同,生成式方法通过自生成反馈进行主动学习。这一原则根植于认知科学 [47, 20],其表明儿童通过探索和实验更有效地学习,并根据期望与现实之间的差异调整其理解。类似地,关于生成对抗网络(GANs)[18, 24] 的研究通过展示模型如何能够通过迭代改进学习生成逼真数据,支持了这一观点。总之,我们提出:
原则 1:分布匹配方法应当是“生成式的”,即模型既从真值监督中学习,也从其自身生成的错误中学习。
我们的第二条原则应对过拟合挑战。我们从神经科学中汲取灵感,特别是避免过度记忆和实现平衡学习的概念。在神经科学中,突触可塑性,尤其是稳态可塑性,强调了在学习过程中保持平衡的重要性 [56, 55]。过度增强某些神经连接可能导致僵化、适应不良的行为,类似于对观测到的 token 分配过高概率会导致模型中的过度记忆,从而限制其适应和泛化能力。基于这些见解,尤其是在有限数据下,我们提出:
原则 2:模型应当对观测数据分配较高概率,同时防止过度记忆。
4.1 提出的公式:带熵正则化的反向 KL
为实现上述两条原则,我们提出研究带最大熵正则化的反向 KL 散度最小化公式。目标定义如下:
$$ \max_f \underbrace{\mathbb{E}_x \mathbb{E}_{y\sim f(\cdot|x)} [\log p(y|x)] - \mathbb{E}_{y\sim f(\cdot|x)}[\log f(y|x)]}_{=-D_{\mathrm{KL}}(f,p)} + \gamma \cdot \underbrace{\mathbb{E}_{y\sim f(\cdot|x)}[\log f(y|x)]}_{H(f)}. \tag{1} $$
该公式中的第一项对应于目标分布 $p$ 与模型分布 $f$ 之间的反向 KL 散度。这一项通过鼓励模型从其生成的数据样本中学习来支持原则 1。第二项,熵正则化,通过防止过度记忆来与原则 2 一致,因为它确保标注数据的概率不会变得过高。此外,它还带来另一个好处:输出多样性可以得到提升。在这种情况下,贪心采样能够可靠地输出训练数据中的知识。我们还注意到,将熵正则化加入 CE 损失支持原则 2,但不支持原则 1;其局限性在附录 C 中讨论,并且我们将在第 5 节中表明它不如所提出的方法。
尽管式 (1) 中定义的目标看起来很有前景,但在实践中它带来了重大挑战。主要挑战在于,我们只能获得来自分布 $p$ 的经验数据,而无法获得其完整概率密度函数,这使得反向 KL 项无法直接计算。此外,计算反向 KL 在模型生成分布上的期望并不容易。本文贡献了一种新算法来应对这些挑战。
4.2 提出的算法:GEM
在本节中,我们提出一种实用算法,用于求解带熵正则化的反向 KL 优化问题。如前所述,关键在于获得对数概率密度函数 $\log p$ 的估计。我们首先处理 $y$ 不是序列的情形。我们先概述一个概念上简单但技术上复杂的解决方案。基于该方案,我们随后借助新技术引入一种更易处理的解决方案。
初步方案。受 GANs [18, 25] 启发,人们可能提出以下用于估计分布 $p$ 的公式:
$$ \min_q \max_r \mathbb{E}_x \mathbb{E}_{y_{\text{real}}\sim p(\cdot|x)} \mathbb{E}_{y_{\text{gene}}\sim q(\cdot|x)} \left[ h(r(x, y_{\text{real}})) - r(x, y_{\text{gene}}) \right]. \tag{2} $$
这里,为清晰起见,我们使用下标 real 表示监督数据,使用下标 gene 表示模型生成数据。此外,$h$ 是一个单调递增函数(例如线性函数),稍后将予以讨论,而 $r : X \times Y \to \mathbb{R}$ 充当判别器,其设计目标是最大化从数据分布 $p$ 中抽取的样本与从对手分布 $q$ 中抽取的样本之间的差距。对手 $q$ 的目标是最小化该差距。当 $h$ 为线性函数时,它简化为奖励最大化问题 $\maxq \mathbb{E}{y{\text{gene}}\sim q(\cdot|x)}[r(x, y{\text{gene}})]$,这一事实将在后文使用。
就其理论基础而言,Jolicoeur-Martineau [25] 证明了内层最大化问题是在分布 $p$ 与 $q$ 之间寻找一个散度函数,因此外层最小化问题就是降低该散度。因此,求解得到的 $q$ 可作为 $p$ 的良好估计。如果我们能够求解问题 (2),就可以在式 (1) 中代入 $\log p = \log q$。尽管这提供了一种概念上可行的解决方案,但它也带来了若干挑战。特别地,式 (1) 和式 (2) 中的优化问题涉及三个变量:$r$、$q$ 和 $f$,这些变量难以求解:
• 变量 $q$ 和 $r$ 在式 (2) 中被引入以进行对抗训练;
• 在 $q$ 求解之后,分布 $f$ 还需要在式 (1) 中进一步求解。
需要注意的是,当处理序列数据时,优化奖励函数 $r$ 和分布 $q$ 可能尤其具有挑战性,通常需要强化学习(Reinforcement Learning, RL)算法(参见,例如,[22])。我们实现上述方案的初步尝试并不成功。下面我们引入一种新的易处理解决方案。
提出的解决方案。在高层次上,我们的方法通过求解单阶段优化问题简化了流程,消除了在求解 $f$ 之前先估计分布 $p$ 的需要。我们的方法涉及两项关键技术: • 重参数化:我们使用生成分布 $f$ 对判别器进行重参数化。具体而言,我们将 $r$ 定义为实值函数,并将其参数化为 $\log f(y|x)$,确保其保持为实值。 • 直接熵正则化:我们直接为分布 $q$ 引入熵正则化,推导出 $q$ 的闭式解。该技术具有两个优点。首先,它建立了 $q$ 与 $f$ 之间的联系,消除了单独求解问题 (1) 的需要。其次,由于 $q$ 具有闭式解,因此不需要显式训练。具体而言,我们的形式化如下:
$$ \max_f L_q(f) \triangleq \mathbb{E}_{x}\mathbb{E}_{y_{\text{real}}\sim p(\cdot|x)}\mathbb{E}_{y_{\text{gene}}\sim q(\cdot|x)} h(\log f(y_{\text{real}}|x) - \log f(y_{\text{gene}}|x)) \tag{3} $$
$$ \text{s.t. } q = \arg\max_{\pi} \mathbb{E}_{x}\mathbb{E}_{y\sim \pi(\cdot|x)}[\log f(y|x)] + \frac{1}{\beta}\cdot H(\pi(\cdot|x)) = \operatorname{softmax}\left(\frac{1}{\beta} * \log f\right). \tag{4} $$
在此形式化中,我们优化 $f$,就像我们在优化奖励函数 $r$ 一样。同时,我们使用由 $\log f(y|x)$ 给出的奖励来优化 $q$,并纳入熵正则化。幸运的是,这产生了一个闭式解,因此我们无需维护或显式训练 $q$。我们只需优化方程 (3) 中的分布 $f$。注意,尽管通常 $q$ 依赖于 $f$,但在计算 $f$ 的梯度时,我们不通过 $q$ 计算梯度。这类似于 RL 中使用的目标网络 [35, 32]。我们对该形式化有以下理论依据。
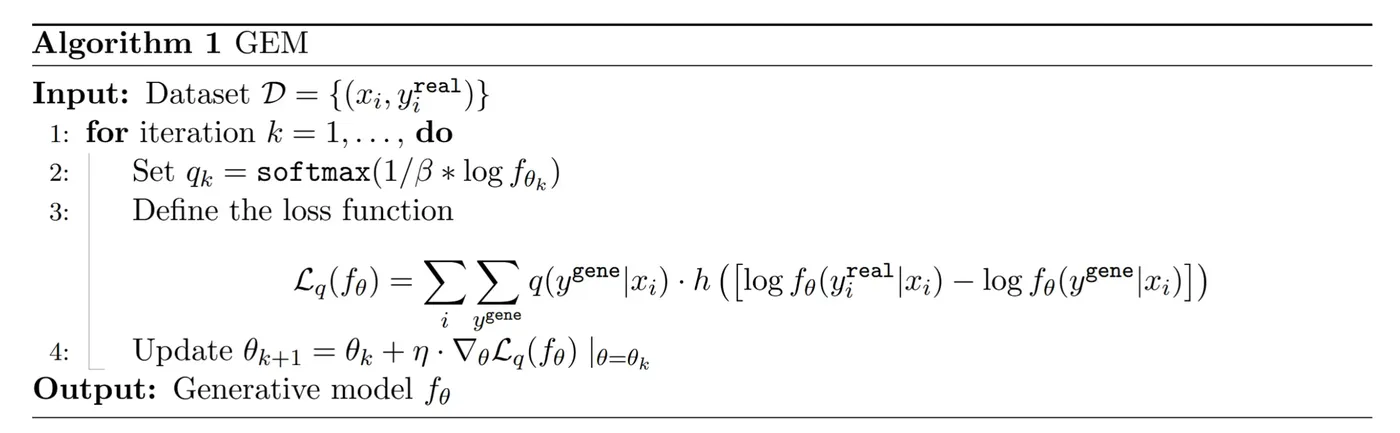
命题 1。假设 $h$ 是线性函数。对于任意分布 $p$,$Lq(f)$ 具有唯一驻点,并且该驻点(其中 $\beta = 1/(\gamma + 1) > 0$)对应于问题 (1) 的最优解。
命题 1 意味着,求解方程 (3) 和 (4) 中提出的问题,提供了方程 (1) 中带熵正则化的反向 KL 的最优解。在实践中,我们可以使用 transformer 参数化 $f$,并通过梯度上升优化参数。我们在算法 1 中概述了这样的训练过程,将这种方法称为 GEM,其代表分布的生成式与熵正则化匹配(Generative and Entropy-regularized Matching of distributions)。注意,精确期望 $\mathbb{E}{y{\text{gene}}\sim q(\cdot|x)}[\cdot]$ 被计算,是因为我们在此假设 $y{\text{gene}}$ 是非序列的(我们稍后将处理序列情形)。具体而言,在这种情况下,生成分布是类别分布且具有有限支撑,使得该期望易于计算。这不同于连续优化中的GANs [18],其中生成器通过抽取若干样本来使用非精确随机梯度。我们还注意到,命题 1 依赖于 $\beta > 0$,这意味着所提出的表述无法解决纯反向 KL 最小化问题。直观理解与示例。我们通过在简单模型上解释 GEM 的训练机制来提供对其的直观理解:对于固定的 $x \in X$,我们建模 $f_\theta(y|x) = \mathrm{softmax}(\theta_x)$,其中 $\thetax \in \mathbb{R}^K$。考虑 $h$ 为命题 1 中描述的线性函数。对于配对样本 $(y{\mathrm{real}}, y{\mathrm{gene}}) = (i, j)$,该样本的梯度为:
$$ \nabla_\theta L_q(f_\theta)[i,j] = \begin{cases} w_{ij} e_{ij} & \text{若 } i \ne j \\ 0 & \text{否则} \end{cases} $$
这里,$w{ij} = p(y{\mathrm{real}}|x)q(y{\mathrm{gene}}|x)$ 取值于 $[0, 1]$,且 $e_{ij}$ 是这样一个向量:其第 $i$ 个元素为 $1$,第 $j$ 个元素为 $-1$,其余元素为 $0$。因此,该配对数据的梯度给出了将 logit $\thetax$ 从第 $j$ 个位置移动到第 $i$ 个位置的方向,其幅度由权重 $w{ij}$ 决定。考虑一个数值示例,其中 $\thetax = [2, 1]$,$K = 2$,得到 $f = [0.73, 0.27]$。对于 $\beta = 0.7$,有 $q = [0.81, 0.19]$,与 $f$ 相比更尖锐。给定数据分布 $p = [0.9, 0.1]$,GEM 的梯度为 $[0.1, -0.1]$,导致相对 logit 变化为 $0.2$。相比之下,此情形下 CE 的梯度为 $[0.17, -0.11]$,导致相对 logit 变化为 $0.28$,是前者的 $1.4$ 倍。因此,GEM 的概率变化比 CE 更温和,并且由于所诱导的熵正则化,GEM 最终会收敛到更平坦的分布 $[0.82, 0.18]$。在上述分析中,我们看到分布 $q$ 决定了概率输运的权重。一般而言,对于 $0 < \beta < 1$,从 $f$ 偏移而来的收窄分布 $q$ 在概率输运中优先考虑 $f$ 中的高概率区域,而 $f$ 中的低概率区域贡献较少。这与 CE 形成对比:CE 会将未标注 token 的概率推向已标注 token,从而可能导致过拟合。我们还观察到,$h$ 也决定了概率被转移的程度。具体而言,对于一般函数 $h$,有 $w{ij} = p(y{\mathrm{real}}|x)q(y{\mathrm{gene}}|x)h'$。对于所研究的线性函数,$h'$ 始终等于 $1$。$h$ 的另一种可能选择是 log-sigmoid 函数 $h(u) = \log \mathrm{sigmoid}(u) = u - \log(1 + \exp(u))$,这已在先前研究 [25, 51, 43, 9] 中得到研究。该函数提供了一种加权效应。由于 $h' = \mathrm{sigmoid}(\log f(y{\mathrm{gene}}|x) - \log f(y{\mathrm{real}}|x)) \in (0, 1)$,当 $y{\mathrm{real}}$ 尚未在概率分布中占主导时,它会产生较大的权重;当 $y{\mathrm{real}}$ 已经占主导时,则会产生较小的权重。稍后,我们将在实验中研究该函数。
序列数据的扩展。在上述部分,我们推导了 $y$ 为非序列情形下的算法。我们注意到,序列情形下的优化可能非常困难。稍微滥用记号,令 $y = (y_1,\ldots,yT) \triangleq y{1:T}$。我们可以将公式 (3) 和 (4) 中的表述扩展到如下:⁴
$$ \max_f \mathbb{E}_x \mathbb{E}_{y^{real}_{1:T}\sim p(\cdot|x)} \mathbb{E}_{y^{gene}_{1:T}\sim q(\cdot|x)} \left[ h\log f(y^{real}_{1:T}|x) - \log f(y^{gene}_{1:T}|x) \right] $$
$$ \text{s.t. } q = \arg\max_{\pi} \mathbb{E}_x \left( \mathbb{E}_{y_{1:T}\sim \pi(\cdot|x)} [\log f(y_{1:T}|x)] + \frac{1}{\beta} \cdot H(\pi(\cdot|x)) \right) $$
这里,我们遇到一个挑战:作为级联类别分布,$y{1:T}$ 的联合分布相当复杂。这导致期望 $\mathbb{E}{y^{gene}_{1:T}}[\cdot]$ 无法像之前那样容易计算。
尽管蒙特卡洛估计——即通过抽取样本来近似梯度——看起来可能是一种可行的解决方案,但我们在实验中发现它并不奏效。我们认为主要原因是样本空间巨大,⁵ 并且预训练分布 $f$ 与我们旨在学习的数据分布 $p$ 相差很大。⁶ 因此,当我们使用随机采样来估计梯度时,它并不能提供有效的反馈。
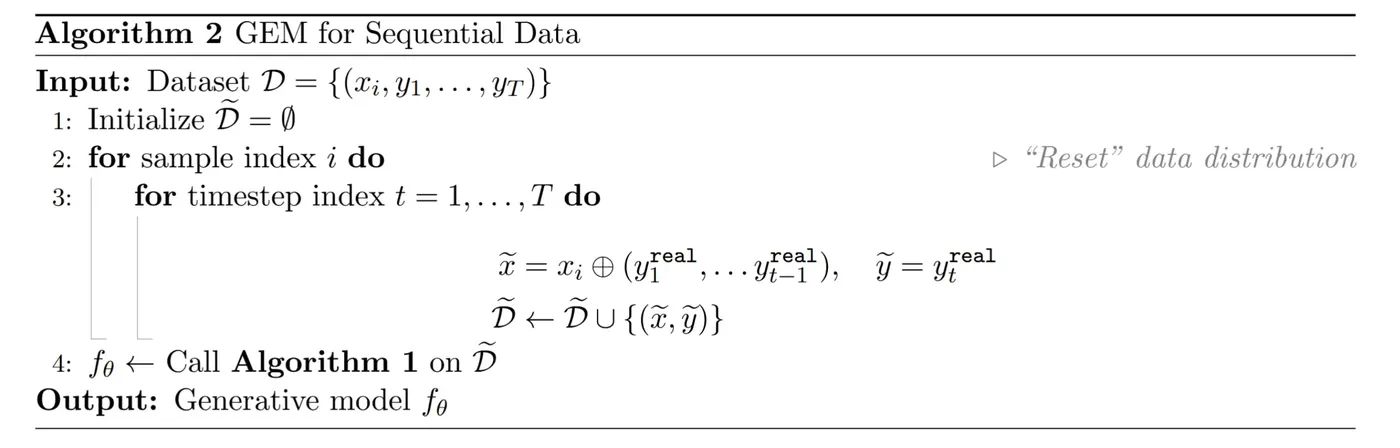
为应对上述挑战,我们提出将多阶段序列优化问题分解为多个单阶段优化问题,并分别高效求解。具体而言,我们将分布匹配限制在如下情形:直到时间步 $t$ 的前缀样本均抽取自数据分布 $p$,并像之前一样求解第 $t$ 个时间步的优化问题。其数学表述如下:
$$ \max_f\mathcal{L}_q^{\mathbf{seq}}(f)=\mathbb{E}_x\left\{\sum_{t=1}^T\mathbb{E}_{y_{1:t-1}^{\mathbf{real}}\sim p(\cdot|x)}\mathbb{E}_{y_t^{\mathbf{real}}\sim p(\cdot|x,y_{1:t-1}^{\mathbf{real}})}\mathbb{E}_{y_t^{\mathbf{gene}}\sim q(\cdot|x,y_{1:t-1}^{\mathbf{real}})}\left[\Delta\right]\right\} \tag{5} $$
其中
$$\Delta=\begin{bmatrix}h\left(\log f(y_t^{\mathrm{real}}|x,y_{1:t-1}^{\mathrm{real}})-\log f(y_t^{\mathrm{gene}}|x,y_{1:t-1}^{\mathrm{real}})\right)\end{bmatrix},$$
该表述的主要优势在于,对于每个子问题,我们仍然可以获得精确的条件分布,因此梯度估计是准确的。同样的思想也适用于分布 $q$ 的训练:
$$q=\operatorname*{argmax}_\pi\mathbb{E}_x\left\{\sum_{t=1}^T\mathbb{E}_{y_{1:t-1}^{\mathrm{real}}\sim p(\cdot|x)}\mathbb{E}_{y_t\sim\pi(\cdot|x,y_{1:t-1}^{\mathrm{real}})}[\log f(y_t|x,y_{1:t-1}^{\mathrm{real}})]+1/\beta\cdot\mathcal{H}(\pi(\cdot|x,y_{1:t-1}^{\mathrm{real}}))\right\}.$$
也就是说,当用于公式 (5) 时,我们仍有闭式解 $q(\cdot|x, y^{real}{1:t-1}) = \operatorname{softmax}\left(\frac{1}{\beta} \cdot \log f(\cdot|x, y^{real}{1:t-1})\right)$。我们在算法 2 中概述所提出的过程,其 PyTorch 代码在附录 A 中提供以供参考。我们承认,我们的技术受到 [45] 在模仿学习中引入的数据分布“重置”技巧的启发;在该技巧中,教师首先展示少量示范动作,然后要求学生完成完整轨迹中的其余动作。⁴一般来说,提示 $x$ 也可以是序列,但由于它作为条件分布的输入,这不会影响我们的讨论和公式表述。⁵对于 Llama-3-8B 模型,其词表大小为 128k。对于序列长度为 2048 的典型情况,样本大小为 $128000^{2048}$。⁶具体而言,预训练模型无法正确生成 EOS(句末)标记,导致即使长度无限,序列也重复且信息量较少。但监督数据具有 EOS 标记和有限长度。为绕过这一挑战,文献 [9, 29] 提出的方法依赖于已使用 CE 进行 SFT 训练的模型。如前所述,这些方法无法直接用于预训练模型。
5 实验
在本节中,我们展示微调 Llama-3-8B 模型(具体而言,其预训练版本)的实验结果。下面简要概述我们的实验设置,更多细节见附录 D。
5.1 通用目的微调
设置。在本节中,我们开发一个能够针对各种提示遵循指令的 LLM。为此,我们使用 UltraFeedback 数据集 [13],具体是由 HuggingfaceH4 团队7 过滤后的版本。该数据集包含来自 Evol-Instruct 和 UltraChat 等指令数据集的提示,以及由 GPT-4 和 Llama-2-7B/13B/70B-Chat 等模型生成的响应。更多信息见 [13]。
每个数据点包含两个响应:一个被选为偏好选项,另一个被选为拒绝选项,选择由 GPT-4 完成。在我们的研究中,我们使用偏好响应进行 SFT,这是先前研究 [39, 3] 普遍采用的做法。遵循 [66, 34, 13],我们将学习率设为 $2 \times 10^{-5}$,采用余弦学习率衰减调度,并使用宏批量大小 128。最大序列长度(涵盖提示和响应)设为 2,048 个 token。模型训练三个 epoch。
我们实现所提出的 GEM 方法,其中 $\beta = 0.7$。如前所述,GEM 有两种变体:GEM-LS(使用 log-sigmoid 的 GEM)和 GE-Linear,二者取决于函数 $h$ 的选择。我们的主要基线是标准 CE 损失。此外,我们探索了一种加入 0.1 权重衰减的变体,这在先前研究中已被普遍使用 [39, 3]。我们将此方法称为 CE + WD。我们还实现了一种称为 CE + Entropy 的方法,它在 CE 损失中加入 0.1 的熵正则化项。该方法符合所提出的原则 2,但不符合原则 1(更多讨论见附录 C)。
指令遵循。我们首先考察模型在指令遵循方面习得的能力。我们遵循 [69] 中的 IFEval 基准,该基准包含来自 25 类可验证指令的 500 个提示,例如撰写超过 400 个单词。根据我们使用严格判断还是宽松判断,以及我们是在提示空间还是指令空间中衡量准确率,存在四种评估标准:提示级严格准确率、指令级严格准确率、提示级宽松准确率和指令级宽松准确率。对于所有指标,数值越高表示性能越好。
我们使用贪心解码评估训练后的模型,结果见表 1。我们观察到,与基于正则化的方法(如权重衰减和熵正则化)相比,CE 表现不佳,这表明 CE 存在过拟合。在四项标准的平均值上,与 CE 相比,GEM-LS 提高了 1.1 分(相对提升 2.5%)和 1.4 分(相对提升 3.2%)。我们在评估困惑度中也观察到这种过拟合:GEM-LS 和 GEM-Linear 达到比 CE(3.48)更低的困惑度(约为 3.16);见附录 E。需要注意的是,这种过拟合并非由过度优化造成,因为 CE 在三个训练 epoch 中性能持续提高(第 1 个 epoch 为 36.15,第 2 个 epoch 为 41.45,第 3 个 epoch 为 43.70)。
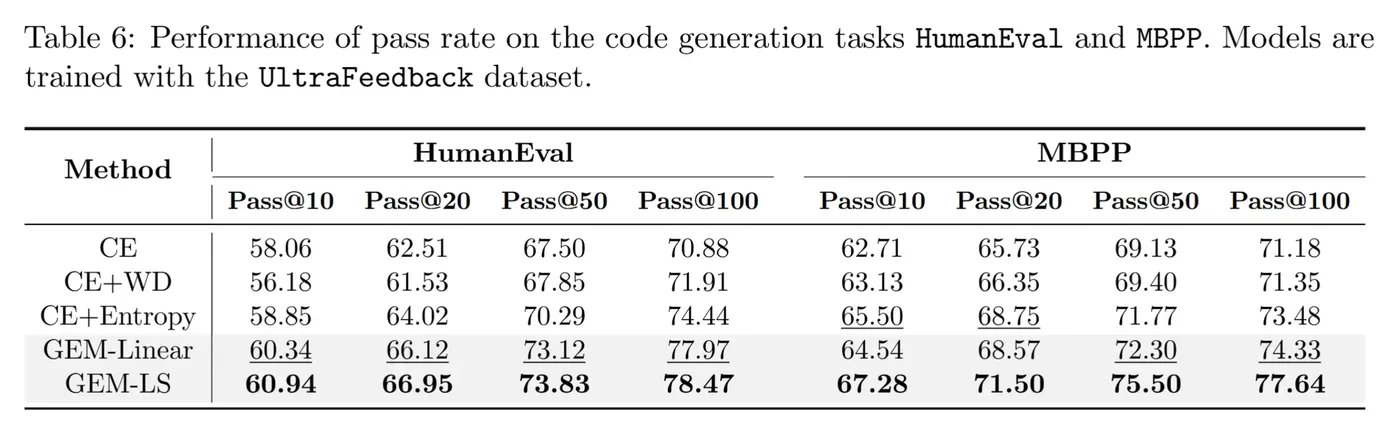
创造性写作。我们继续在两个创造性写作任务中评估模型输出的多样性:诗歌写作和故事写作。对于诗歌,我们使用来自 poetry8 数据集的提示,该数据集在Huggingface 网站,其中包含 573 首关于爱情、自然和神话等主题的诗歌。对于故事,我们基于 ROC 故事数据集 [36] 设计了 500 条提示。在两种情况下,我们提示模型写一首或一篇标题为“$[X]$”的诗或故事,且不超过 200 词,其中 $[X]$ 是来自相应数据集的标题。遵循 [26],我们使用三项标准来评估多样性:1)N-gram 多样性:单个响应中不同 n-gram 的比例(响应内多样性);2)Self-BLEU 多样性:Self-BLEU 分数,将多个生成响应中的一个响应作为参考(响应间多样性);3)Sentence-BERT 多样性:嵌入空间中响应对之间的余弦不相似度。所有标准的取值范围均为 $0$ 到 $100$(其中 Sentence-BERT 多样性通过乘以 $100$ 进行缩放),值越高表示多样性越大。为了计算这些指标,我们要求训练后的模型使用解码配置 $\mathrm{temperature}=1$、$\mathrm{top}\ k=50$ 和 $\mathrm{top}\ p=0.9$ 生成 $16$ 个样本。评估结果如表 2 所示。在这项任务中,我们注意到权重衰减并未提升生成多样性,尽管在之前的示例中它已被证明能有效缓解过拟合。另一方面,为支持原则 2 而实现的熵正则化带来了输出多样性的益处。聊天、数学推理和代码生成。在本部分中,我们表明,提升生成多样性带来的益处不仅限于创意写作任务。具体而言,在确保质量的前提下,当使用诸如 Best-Of-N (BON) 或 Majority-Voting (MV) [59] 等先进生成方法来寻找更优解时,多样化生成具有优势。这与近期在扩展测试时计算规模 [6, 50] 和自蒸馏 [48] 方面的进展一致。具体而言,我们在下文中的聊天、数学推理和代码生成中开展三项实验,以通过 GEM 所改进的生成多样性来验证其优越性。在本部分中,我们使用配置 $\mathrm{temperature}=0.6$、$\mathrm{top}\ k=50$,以及 top $p=0.9$。此处选择较低的温度以提升响应质量(Llama 模型中的默认值为 0.6)。总体性能展示在图2中,详细结果见附录E。具体设置和分析如下。对于聊天,我们评估模型生成人类偏好响应的能力。我们提示训练后的模型回答来自 AlpacaEval 数据集 [31] 的 805 个问题。对于每个问题,模型生成 32 个响应,然后使用奖励模型选择最佳响应。我们采用奖励模型 FsfairX-LLaMA3-RM-v0.19,该模型在 RewardBench [27] 上表现出顶尖性能,使其成为该任务的可靠选择。由于奖励值本身没有任何意义,我们选择胜率作为指标。特别地,我们通过 Bradley–Terry 模型估计相对于 GPT-4 生成响应的胜率。从图2中,我们观察到,与 CE 相比,GEM-LS 在胜率上可实现约 3 个百分点的提升。对于数学推理,我们在 GSM8K [11] 基准上评估性能,该基准包含 1,319 个测试问题。我们使用思维链提示 [61] 引导 LLMs 为每个问题生成 32 个响应。我们使用多数投票(Majority-Voting, MV)[59] 和 Best-Of-N(BON)方法评估答案准确率。与 CE 相比,GEM-LS 在 MV 下最高提升 4.8 个百分点(相对提升 7.7%),在 BON 下提升 2.5 个百分点(相对提升 2.8%)。BON@32 的强劲性能表明,尽管模型可能知道如何解决这些问题,但在生成时对这些解并不确定。这与先前研究 [28] 一致,该研究发现,即使 7B 语言模型也能通过采样多个响应展现出强大的数学推理能力。对于代码生成,我们考虑两个基准:HumanEval [8] 和 MBPP [2]。在这些场景中,训练后的模型被要求生成 Python 代码,并由执行器判断其正确性。常用的评估指标是多样本下的通过率。我们要求训练后的模型生成 200 个样本,以估计 pass@100。生成配置与聊天任务相同。我们发现,权重衰减相较于 CE 未显示出显著提升,而 GEM-LS 在 HumanEval 上对于 pass@100 相较于 CE 可实现最高 7.6 个百分点(相对提升 10.7%)的提升,在 MBPP 上可实现 6.4 个百分点(相对提升 9.0%)的提升。
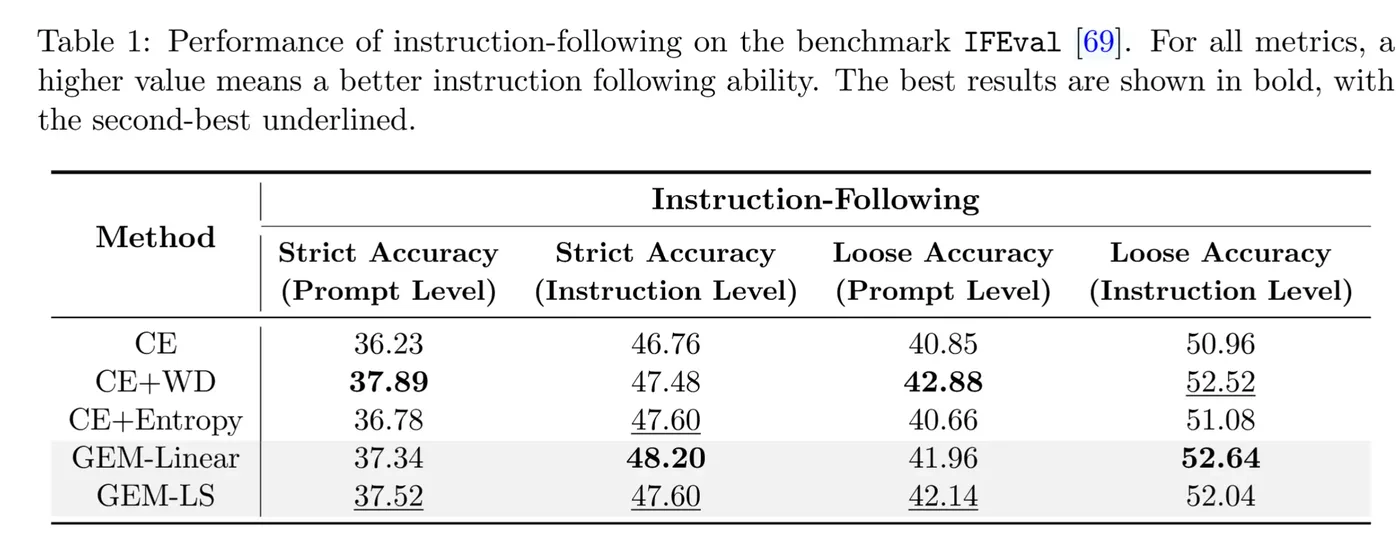
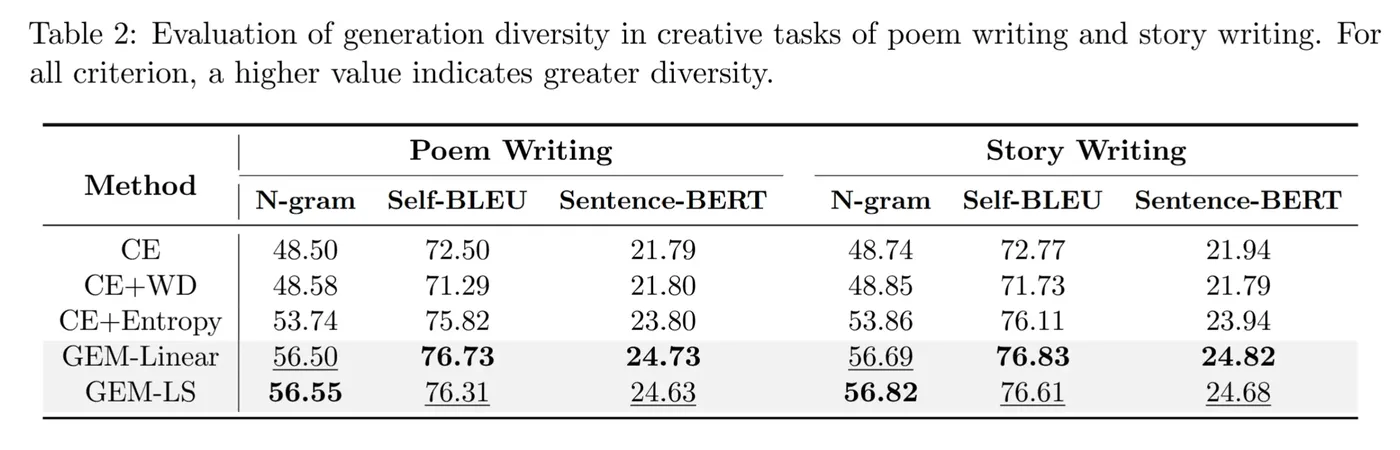
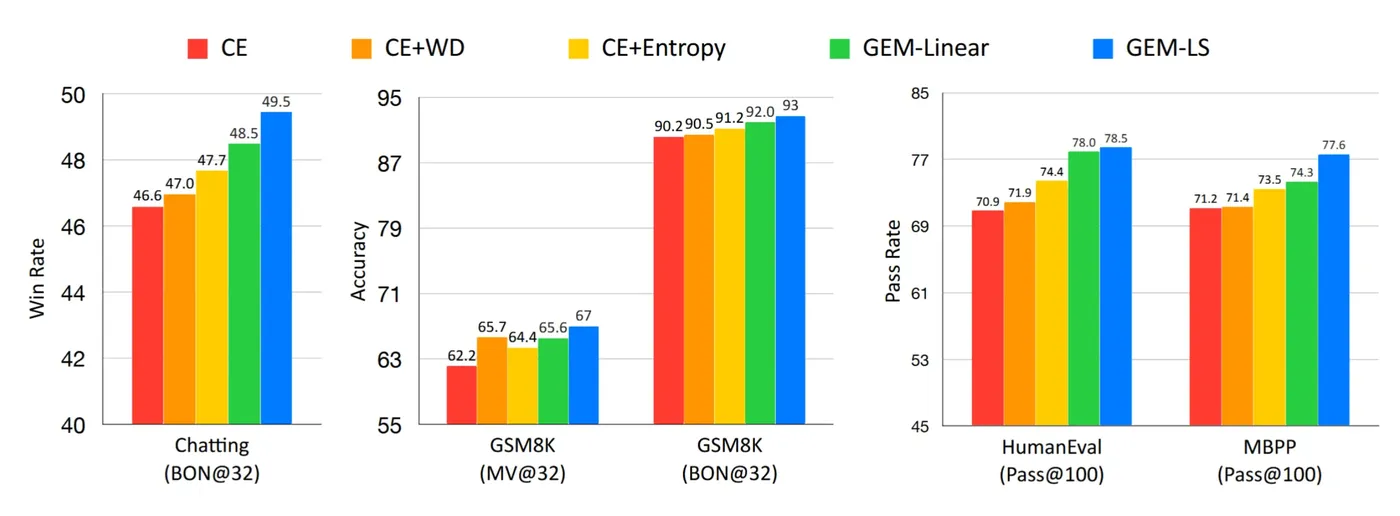
图2:在聊天(左)、数学推理(中)和代码生成(右)任务中使用诸如 best-of-$n$ 和多数投票等高级生成策略的性能。
5.2 领域特定微调
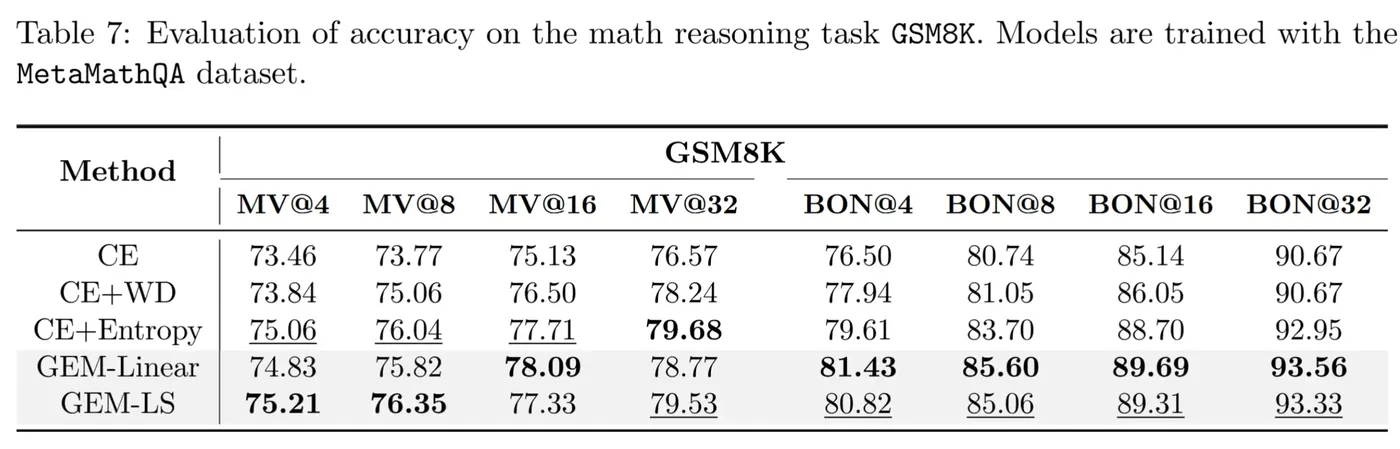
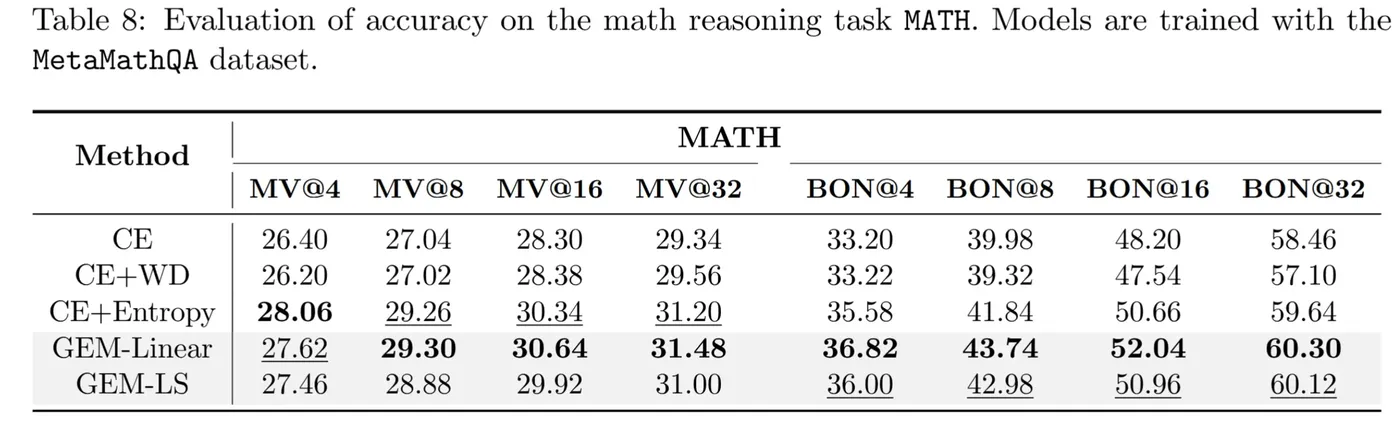
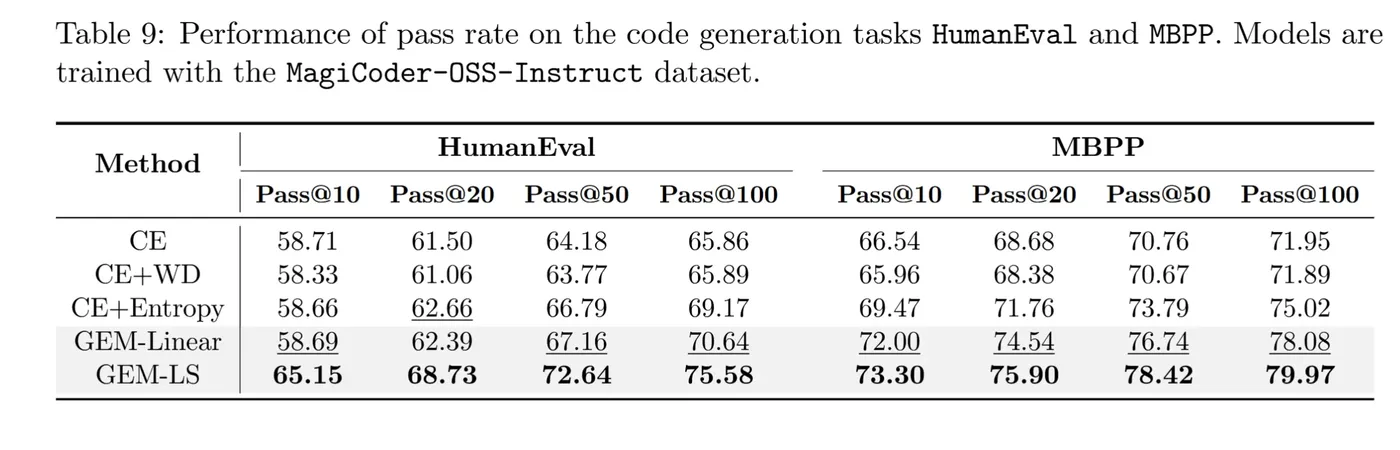
在本节中,我们使用领域特定数据集进行实验。对于数学推理,我们使用数据集 MetaMathQA [66]。对于代码生成,我们使用数据集 Magicoder-OSS-Instruct[62]。实验设置,包括训练细节和超参数,与之前相同,具体内容见附录。数学推理。我们给出两个基准的最终答案准确率:GSM8K,此前已被研究;以及更具挑战性的 MATH [21]$^{10}$,如图3所示。遵循之前的设置,我们使用对32个样本进行多数投票(MV@32)和对32个样本进行 Best-Of-N(BON@32)来评估性能。贪心解码性能也一并报告。我们的结果表明,在 GSM8K 和 MATH 上,多数投票和贪心解码均有显著提升。我们观察到,权重衰减正则化在 GSM8K 上表现良好,但在 MATH 上未显示出明显提升。相比之下,GEM-LS 在 GSM8K 上分别比 CE 高出 1.2 个百分点(相对提升 1.7%)、2.9 个百分点(相对提升 3.8%)和 2.6 个百分点(相对提升 2.9%),分别对应贪心解码、MV@32 和 BON@32。在 MATH 基准上,GEM-LS 在相同方法上分别提升 1.9 个百分点(相对提升 8.0%)、1.7 个百分点(相对提升 5.8%)和 1.6 个百分点(相对提升 2.7%)。贪心解码中的这些提升表明,熵正则化方法有效缓解了过拟合,而 MV 和 BON 中的提升则表明生成多样性有所增加。代码生成。遵循之前的设置,我们在图4中报告了两个关键基准 HumanEval 和 MBPP 上在 ${1, 10, 100}$ 上的通过率。我们发现,与之前相比,HumanEval 上的 Pass@100 性能有所下降,而所有方法在 MBPP 上的 Pass@100 性能均有提升。我们观察到,权重衰减(WD)未能取得一致的提升,而熵正则化则能取得一致提升。值得注意的是,GEM-LS 显著提升了相对于 CE 的性能:在 HumanEval 上,Pass@1 提升 4.6 个百分点(相对提升 11.7%),Pass@10 提升 6.5 个百分点(相对提升 11.1%),Pass@100 提升 9.7 个百分点(相对提升 14.7%)。在 MBPP 上,GEM-LS 在 Pass@1 上获得 3.4 个百分点(相对提升 6.3%)的增益,在 Pass@10 上获得 6.8 个百分点(相对提升 10.2%)的增益,在 Pass@100 上获得 8.0 个百分点(相对提升 11.1%)的增益。这些结果表明,关于过拟合和生成多样性的结论与之前类似。$^{10}$MATH 未在使用 UltraFeedback 数据集微调的模型中研究,因为模型在该任务上表现较差。
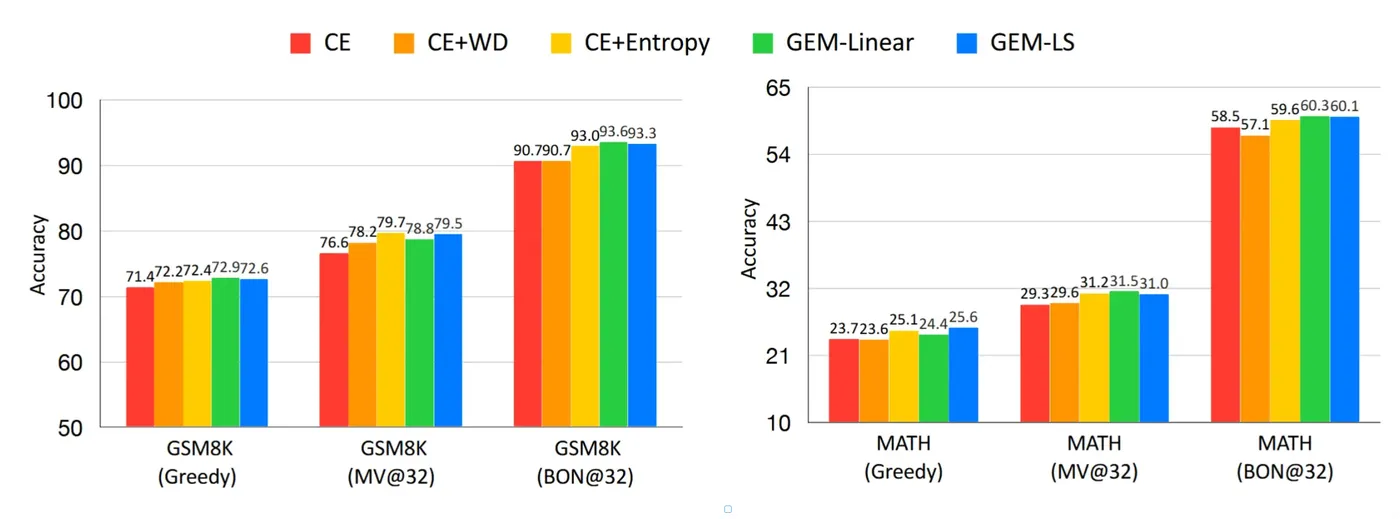
图3:使用MetaMathQA数据集微调Llama-3-8B时,在GSM8K(左)和MATH(右)上的性能。
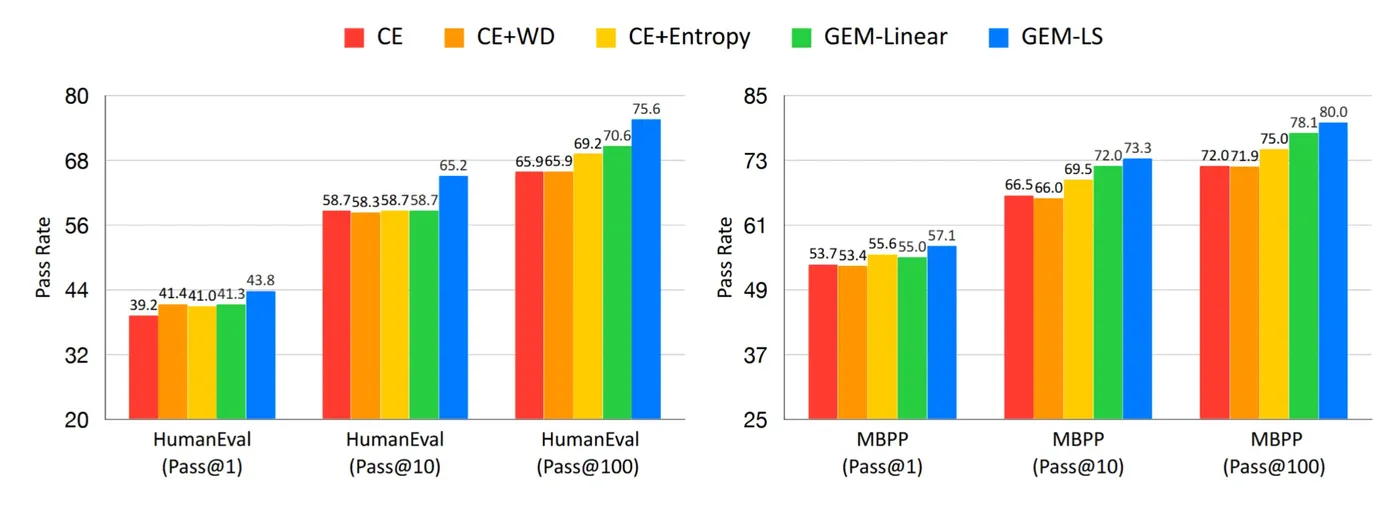
图 4:使用 MagiCoder-OSS-Instruct 数据集微调 Llama-3-8B 时,在 HumanEval(左)和 MBPP(右)上的性能。
6 结论
在本文中,我们提出了一种用于 LLMs 的 SFT 的替代方法,以应对过拟合和生成多样性受限的挑战,这些问题通常由 CE 损失的激进更新和有限数据所导致。我们证明了将生成分布匹配与熵正则化相结合的有效性。我们注意到,当使用 best-of-$n$ 采样等先进生成方法时,改进的多样性也会提升下游任务中的性能。总体而言,我们的结果表明,所提出的方法非常适合生成模型。
本文关注后训练流程的初始阶段,并认识到,使用我们提出的方法训练的模型可以在后续阶段得到进一步优化。值得注意的是,我们的方法所实现的增强多样性在若干情境中可能具有优势:它支持扩展测试时计算 [6, 50],改进 RL 方法中的探索 [46, 33],解决偏好坍缩问题 [64],通过 best-of-$n$ 技术进行蒸馏以促进自我改进 [48],并有助于缓解合成数据生成中的模式坍缩 [49, 5, 63]。我们认为我们的方法在这些领域具有显著潜力,并计划在未来的工作中探索这些主题。
A GEM 的实现
1 def gem_loss(logits, labels, beta=0.7, ignore_index=-100, h="linear"):
2
3 shift_logits = logits[..., :-1, :].contiguous()
4 shift_labels = labels[..., 1:].contiguous()
5
6 mask = shift_labels != ignore_index
7 shift_logits = shift_logits[mask]
8 shift_labels = shift_labels[mask]
9
10 with torch.no_grad():
11 logits_on_labels = torch.gather(
12 shift_logits, dim=-1, index=shift_labels.unsqueeze(-1)
13 ).squeeze(-1)
14
15 logits_diff = shift_logits - logits_on_labels.unsqueeze(-1)
16 if h == "linear":
17 weights = torch.ones_like(logits_diff)
18 elif h == "log_sigmoid":
19 weights = F.sigmoid(0.01 * logits_diff)
20 else:
21 raise ValueError(h)
22
23 gene_log_probs = F.log_softmax(shift_logits, dim=-1)
24 q_probs = torch.exp(
25 F.log_softmax(shift_logits / beta, dim=-1)
26 ).detach()
27
28 real_log_probs = torch.gather(
29 gene_log_probs, dim=-1, index=shift_labels.unsqueeze(-1)
30 ).squeeze(-1)
31
32 loss = -torch.sum(
33 q_probs * weights * (real_log_probs.unsqueeze(-1) - gene_log_probs), dim=-1
34 ).mean()
35
36 return loss
代码清单 1:GEM 的 PyTorch 代码
关于上述实现,我们有两点说明。第一,我们在 log-sigmoid 函数中使用系数 $0.01$ 对输入进行缩放。这确保该函数的行为几乎呈线性。第二,该实现所需的 GPU 内存和计算时间与 CE 损失几乎相同。
B 证明
命题1的证明。当 $h$ 是线性函数时,我们有
$$\begin{aligned}\mathcal{L}_q(f)&=\mathbb{E}_x\mathbb{E}_{y^{\mathrm{rea}1}\thicksim p(\cdot|x)}\mathbb{E}_{y^\mathrm{gene}{\thicksim q(\cdot|x)}}\left[\log f(y^{\mathrm{real}}|x)-\log f(y^{\mathrm{gene}}|x)\right]\\&=\mathbb{E}_x\mathbb{E}_{y^{\mathrm{rea}1}\sim p(\cdot|x)}\mathbb{E}_{y^\mathrm{gene}{\sim q(\cdot|x)}}\left[\log f(y^{\mathrm{real}}|x)\right]-\mathbb{E}_x\mathbb{E}_{y^\mathrm{real}{\sim p(\cdot|x)}}\\&=\mathbb{E}_x\mathbb{E}_{y^{\mathrm{real}}\thicksim p(\cdot|x)}\left[\log f(y^{\mathrm{real}}|x)\right]-\mathbb{E}_x\mathbb{E}_{y^{\mathrm{gene}}\thicksim q(\cdot|x)}\left[\log f(y^{\mathrm{gene}}|x)\right]\end{aligned}$$
对于任意 $x \in \mathcal{X}$,我们有
$$ \frac{\partial L}{\partial f} = \frac{p - q}{f} \tag{6} $$
为计算 $L$ 的驻点,我们要求 $p = q$。由于 $q = \mathrm{softmax}(1/\beta \cdot \log f)$,上述等式要求 $f = \mathrm{softmax}(\beta \cdot \log p)$。如命题2所分析,对于 $\beta = 1/(\gamma + 1)$,这对应于带熵正则化的反向 KL 最小化的最优解。
命题2. 对于公式(1)中的熵正则化 KL 最小化问题,在函数空间中,我们有最优解:
$$ f^\star(y|x) = \frac{1}{Z_x} p(y|x)^{1/(\gamma+1)} $$
其中 $Zx$ 是归一化常数 $\sum{y'} p(y'|x)^{1/(\gamma+1)}$。该证明基于约束优化的最优性条件。其证明可见于先前文献(例如,见 [58, 附录 A])。我们指出,上述闭式解无法在实践中应用,因为我们无法访问数据分布 $p$ 的密度函数。
C 讨论
我们在本节讨论带熵正则化的前向 KL 的表述:
$$ \max_f \underbrace{\mathbb{E}_x \mathbb{E}_{y\sim p(\cdot|x)}[\log f(y|x)]}_{=-D_{\mathrm{KL}}(p,f)+\text{常数}} + \gamma \cdot \underbrace{\mathbb{E}_{y\sim f(\cdot|x)}[-\log f(y|x)]}_{=H(f)} \tag{7} $$
该表述支持所提出的原则2,但不支持原则1。我们发现,当最大化熵时,该表述会导致尾部概率的不当增加,如图5所示。在大语言模型(LLM)背景下,这种增加通常转化为词表中的无意义 token,从而导致不理想的生成输出(如果未使用诸如 top-$k$ 和 top-$p$ 采样之类的额外策略)。表3提供了一个具体例子。核心问题在于,对于低概率 token,熵正则化项的梯度可能占主导。具体而言,前向 KL 的梯度计算为 $-p/f$,其中除法是逐元素的,而熵的梯度为 $-(1 + \log f)$。因此,对于在 $f$ 和 $p$ 中均为低概率的 token,前向 KL 给出的梯度远小于熵正则化项给出的梯度,从而不成比例地增加尾部概率。相反,所提出的带熵正则化的反向 KL 表述不存在此问题。这是因为在我们的表述中,优化是在生成分布 $f$ 上定义的,从而即使对于低概率 token 也能确保梯度平衡(参见公式(6))。
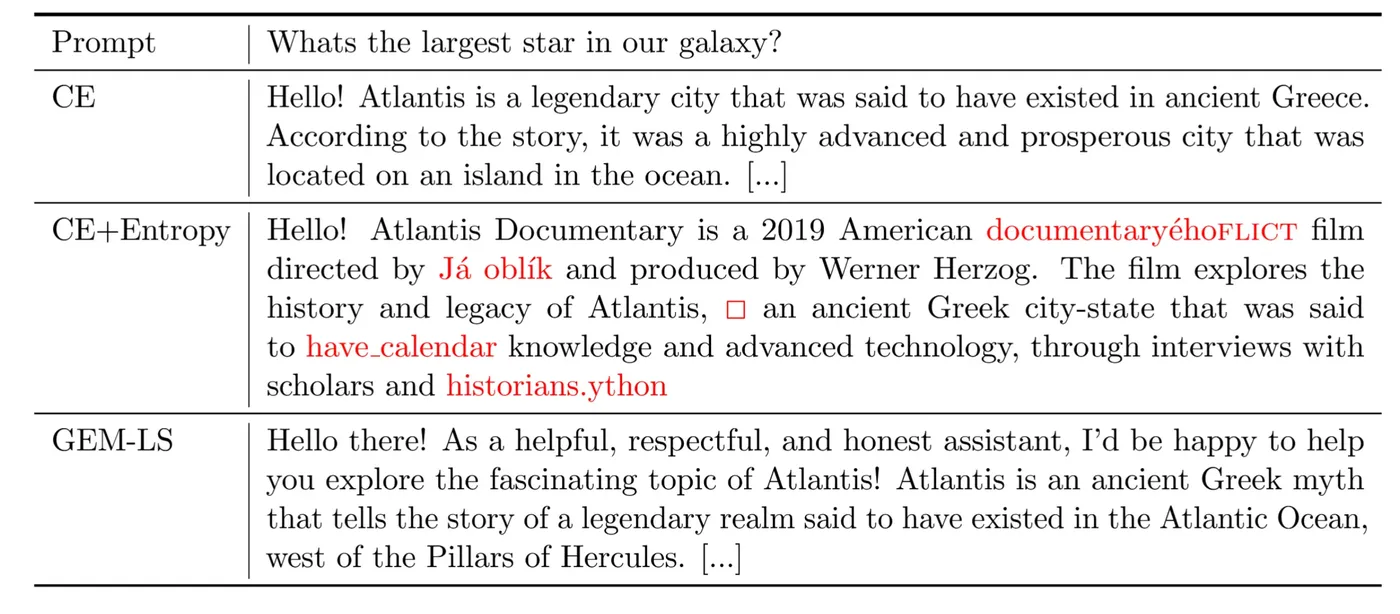
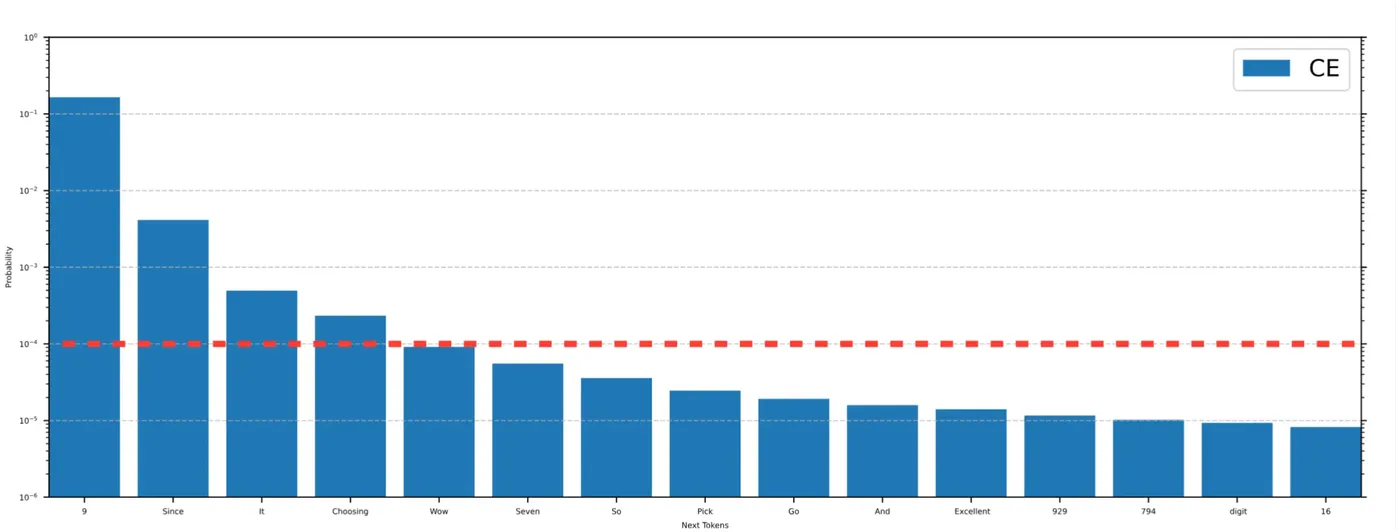
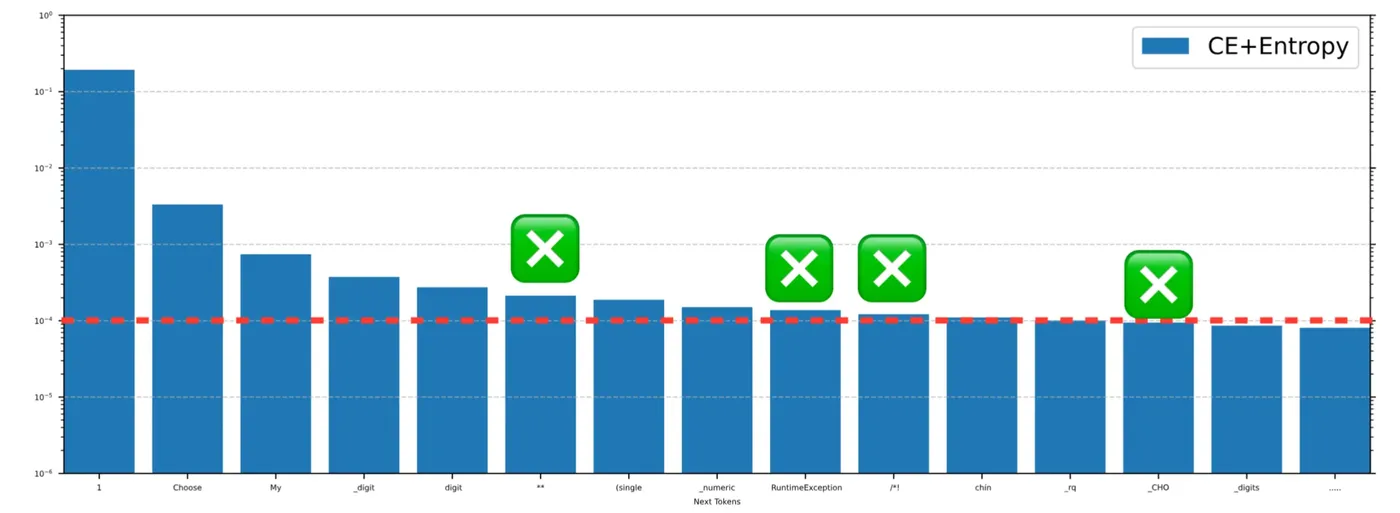
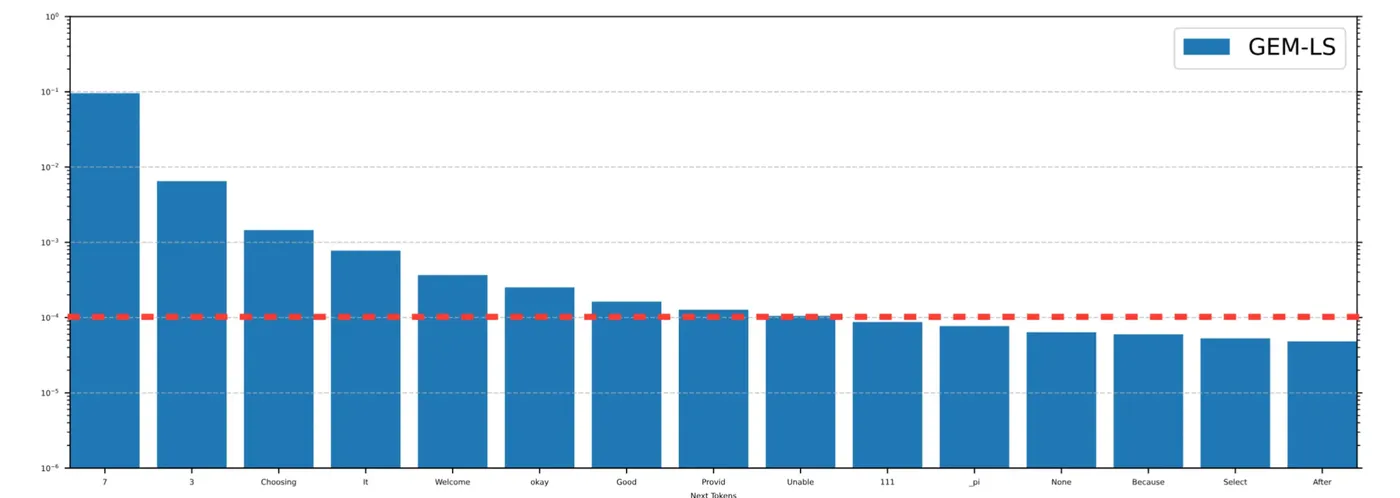
图5:使用 UltraFeedback 数据集训练的模型的下一词元概率分布,从上到下依次为:CE、CE+Entropy、GEM-LS。提示词为“给我一个一位数”。为了清晰可视化,展示了排名前300的概率,子采样率为20。红色虚线表示 $10^{-4}$ 的概率阈值。该图表明,CE+Entropy 模型具有更长的尾部,并对一些无意义词元分配了更高的概率,这些词元以叉号标出。
D 实验细节
所有实验均在 A800-80GB GPU 上使用 DeepSpeed 分布式训练框架进行,采用 ZeRO-2 和梯度检查点,且不进行卸载。为保证可复现性,我们使用带有确定性反向传播的 flash-attention-2。实验基于预训练的 Llama3-8B 模型,使用 Adam 作为优化器,全局批大小为 128。遵循 [66, 34, 13],学习率设置为 $2e-5$,预热比例为 0.03,并使用余弦学习率衰减。训练共进行 3 个 epoch。所有监督数据集均使用 Llama-3-8B-Instruct 的分词器格式化为聊天格式。当评估需要生成响应时,我们使用 vLLM 加速推理。
D.1 UltraFeedback
我们使用由 HuggingfaceH4 团队过滤的数据集,其可在 https://huggingface.co/datasets/HuggingFaceH4/ultrafeedback_binarized 获取。该数据集包含 61,135 个训练样本和 1,000 个测试样本。在训练中,我们将最大序列长度设置为 2,048,丢弃更长的序列并填充较短的序列。为达到 128 的全局批大小,我们使用每设备批大小为 4、梯度累积步数为 4,以及 4 块 GPU。训练大约耗时 24 GPU 小时。对于 CE 方法,我们已针对权重衰减和熵正则化调优超参数,从 ${0.1, 0.01, 0.001}$ 中选择取值。在两种情况下,0.1 均提供了最佳的整体结果。
评估指标(包括困惑度和熵)基于这 1,000 个测试样本。对于熵计算,我们计算条件熵,其期望可以精确计算,并在序列上取平均。对于指令遵循评估,我们使用来自 [69] 的 IFEval 基准。我们采用贪婪解码,最大生成长度为 1,024 个 token。
对于诗歌创作中的多样性评估,我们使用源自 Huggingface 网站上的诗歌数据集的提示,该数据集包含 573 首诗,主题涵盖爱情、自然和神话等,作者包括 William Shakespeare 等诗人。我们使用诸如“写一首题为‘$[X]$’的诗,不超过 200 词”之类的问题提示训练后的模型,其中 $[X]$ 是来自数据集的一个标题。对于故事写作,我们基于 ROC Story 数据集(2017 winter)[36] 创建 500 个提示,要求模型“写一个题为‘$[X]$’的故事,不超过 200 词”,其中 $[X]$ 是来自数据集的一个标题。最大生成 token 数设置为 512。评估脚本遵循 [26] 先前工作的方法,使用 https://github.com/facebookresearch/rlfh-gen-div 提供的脚本。对于每个问题,使用生成配置 temperature=1.0、top k=50、top p=0.9 生成 16 个样本。
对于聊天评估,我们使用 AlpacaEval 数据集中的 805 个测试问题,并采用奖励模型 FsfairX-LLaMA3-RM-v0.1。最大生成序列长度设置为 2048。对于每个问题,使用配置 temperature=0.6、top k=50、top p=0.9 生成 32 个样本。为计算胜率,我们使用 Bradley-Terry 模型:
$$P(y \succ y' \mid x) = \frac{\exp(r(x, y))}{\exp(r(x, y)) + \exp(r(x, y'))}.$$
我们使用 GPT-4 生成的响应作为计算胜率的基线,具体为 gpt4 1106 preview11 版本。
对于 GSM8K 上的数学推理任务,我们使用以下提示:
你的任务是回答下面的问题。在回答之前给出逐步推理,当你准备回答时,请使用格式“The answer is: ...”。问题:{question} 从生成的回答中抽取答案遵循先前工作 [66] 的方法,所用脚本可在 https://github.com/meta-math/MetaMath/blob/main/eval_ gsm8k.py 获得。对于每个问题,使用配置 temperature$=0.6$、top $k=50$、top $p=0.9$ 生成 32 个回答。报告的准确率基于 1,319 个测试问题。 对于 HumanEval 和 MBPP 上的代码生成任务,HumanEval 有 164 个测试问题,MBPP 有 378 个测试问题。我们使用来自 [62] 的提示: 你是一个极其智能的编码助手,能够始终针对用户指令提供准确且可靠的回答。@@ Instruction {instruction} 对于每个问题,使用配置 temperature$=0.6$、top $k=50$、top $p=0.9$ 生成 200 个回答,以估计通过率。
评估脚本来自 https://github. com/ise-uiuc/magicoder/blob/main/experiments/text2code.py。
D.2 MagiCoder
我们使用 MagiCoder-OSS-Instruct 数据集 [62],其中包含 74,197 个训练样本和 1,000 个测试样本(从原始训练集中随机选取)。训练的最大序列长度为 1,024。为了实现全局批量大小 128,我们使用每设备批量大小 8、梯度累积步数 2 和 8 个 GPU。训练大约需要 24 个 GPU 小时。评估方法与之前所述相同。
D.3 MetaMathQA
我们使用 MetaMathQA 数据集 [66]。为了使代码生成任务可控,我们选取 79,000 个样本用于训练和 1,000 个样本用于评估。训练的最大序列长度设置为 1,024。为了实现全局批量大小 128,我们使用每设备批量大小 8、梯度累积步数 2 和 8 个 GPU。训练大约需要 24 个 GPU 小时。评估方法如前所述。对于 MATH 任务,提示与 GSM8K 任务相同。
E 附加结果
E.1 通用目的微调
下一词元预测分布。我们使用三个简单提示为训练后的 LLM 展示与 CE 方法相关的分布坍缩问题:1)“用单个字母补全这个序列:A, B, C, ”;2)“给我一个一位数字”;3)“告诉我一种水果”。所有提示都被设计为答案仅含 1 个词元,以便可视化。12 这些分布 12对于第一个提示,虽然“D”是最可能的答案,但由于模式 A, B, C, A, B, C, . . .,“A”也可能是一个有效回答。如图6所示。我们看到经GEM训练的模型产生更平坦的分布,表明其支持多个可能答案。困惑度与熵。对于训练后的模型,我们还考察了两个统计量:在Ultrafeedback数据集的1,000个评估样本上输出分布的困惑度和熵。结果报告在图7中。以CE作为基线,我们得到若干观察。第一,权重衰减并未显著改变这些统计量。第二,直接引入熵正则化会显著提高困惑度和熵。值得注意的是,这一提高主要源于相对较大的尾部概率。第三,GEM通常降低困惑度,同时提高熵。附带说明,评估困惑度的降低并不直接转化为LLM领域更好的性能(例如参见[68]),但它确实意味着经GEM训练的模型倾向于以高概率偏好有依据的答案,从而增强多样性。聊天、数学推理与代码生成。我们在表4至表6中提供详细结果。我们观察到,即使生成样本更少,GEM也表现出更好的性能。
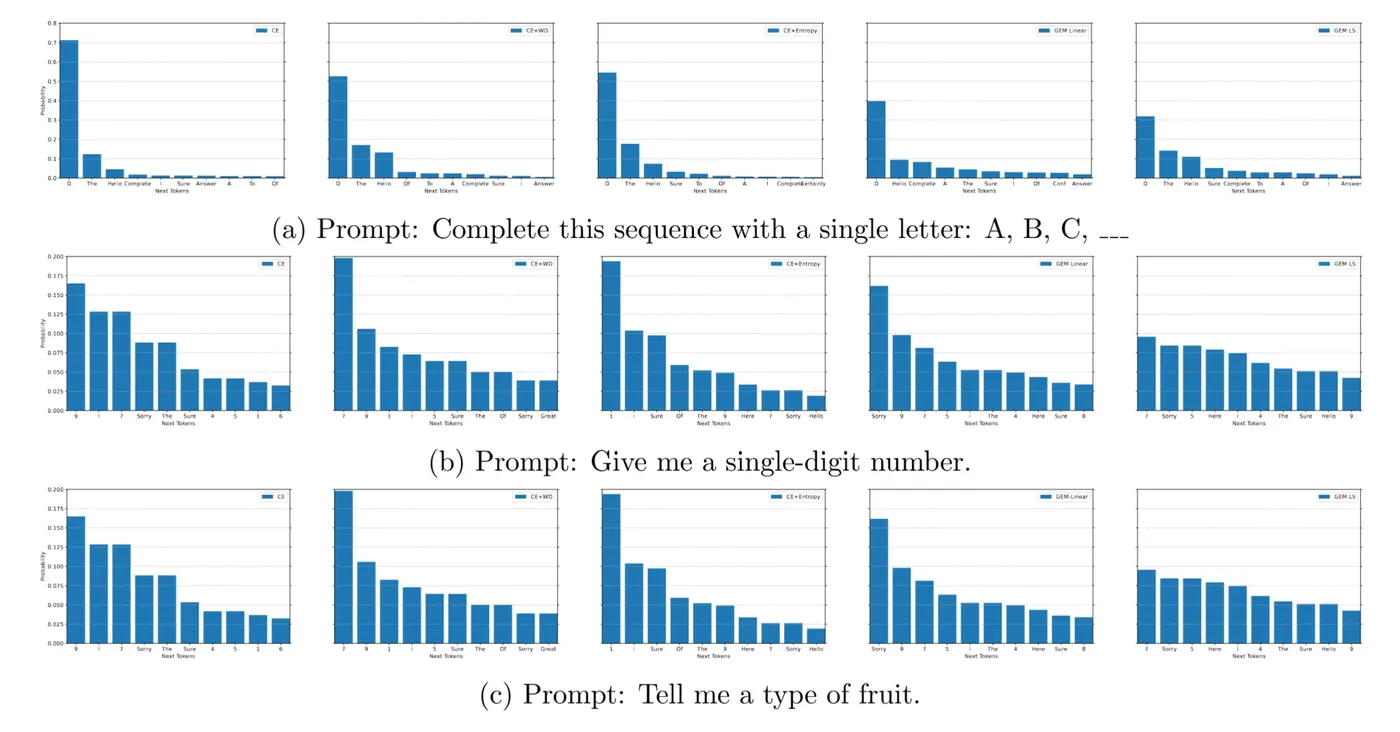
图 6:使用 UltraFeedback 数据集训练的模型中下一词元概率的分布,从左至右依次为:CE、CE+WD、CE+Entropy、GEM-Linear 和 GEM-LS。为清晰起见,仅可视化了前 10 个概率。这些示例凸显了 CE 中生成多样性受限的问题。
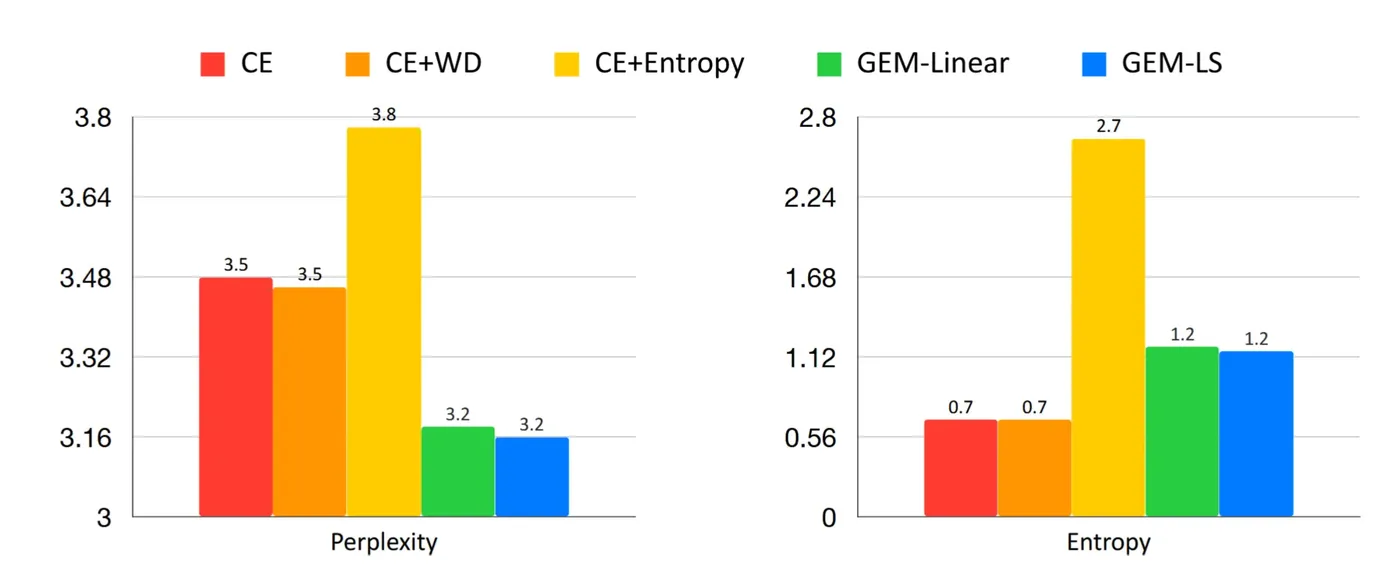
图 7:评估困惑度与熵。模型使用 UltraFeedback 数据集进行训练。
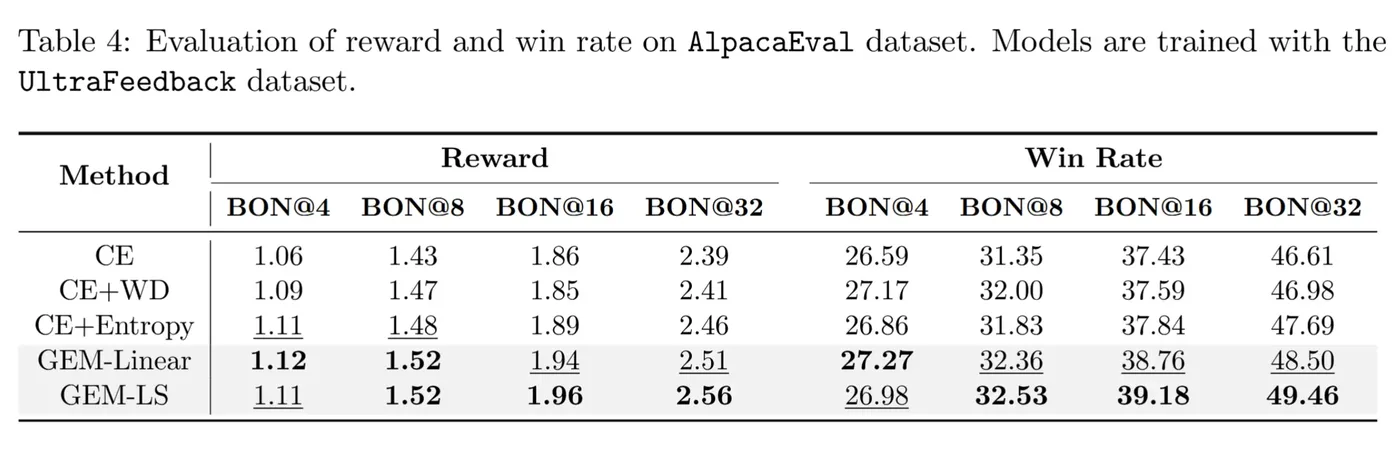
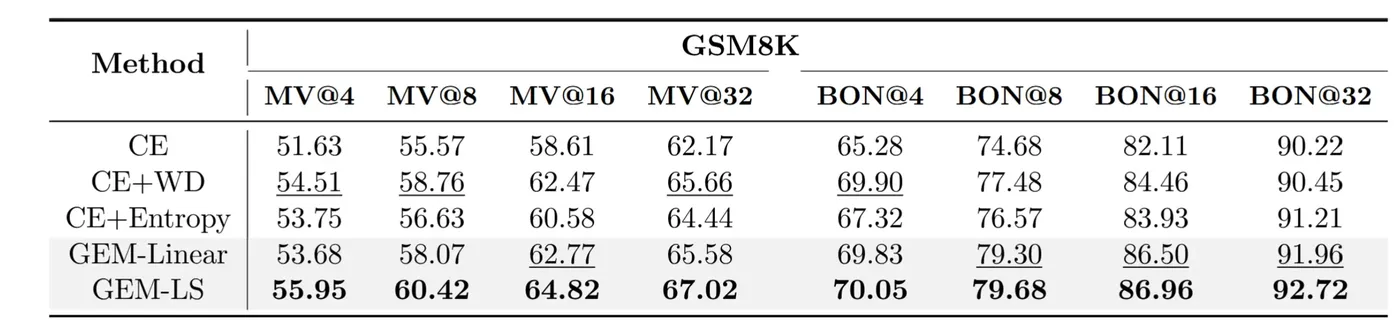
E.2 领域特定微调
我们在表7至表9中提供了详细结果。结果表明,即使生成的样本更少,GEM 也优于 CE。
引用文献
[1] Bo Adler, Niket Agarwal, Ashwath Aithal, Dong H Anh, Pallab Bhattacharya, Annika Brundyn, Jared Casper, Bryan Catanzaro, Sharon Clay, Jonathan Cohen, et al. Nemotron-4 340b technical report. arXiv preprint arXiv:2406.11704, 2024.
[2] Jacob Austin, Augustus Odena, Maxwell Nye, Maarten Bosma, Henryk Michalewski, David Dohan, Ellen Jiang, Carrie Cai, Michael Terry, Quoc Le, et al. Program synthesis with large language models. arXiv preprint arXiv:2108.07732, 2021.
[3] Yuntao Bai, Andy Jones, Kamal Ndousse, Amanda Askell, Anna Chen, Nova DasSarma, Dawn Drain, Stanislav Fort, Deep Ganguli, Tom Henighan, et al. Training a helpful and harmless assistant with reinforcement learning from human feedback. arXiv preprint arXiv:2204.05862, 2022.
[4] Emmanuel Bengio, Moksh Jain, Maksym Korablyov, Doina Precup, and Yoshua Bengio. Flow network based generative models for non-iterative diverse candidate generation. Advances in Neural Information Processing Systems, 34:27381–27394, 2021.
[5] Quentin Bertrand, Avishek Joey Bose, Alexandre Duplessis, Marco Jiralerspong, and Gauthier Gidel. On the stability of iterative retraining of generative models on their own data. arXiv preprint arXiv:2310.00429, 2023.
[6] Bradley Brown, Jordan Juravsky, Ryan Ehrlich, Ronald Clark, Quoc V Le, Christopher R ́e, and Azalia Mirhoseini. Large language monkeys: Scaling inference compute with repeated sampling. arXiv preprint arXiv:2407.21787, 2024.
[7] Tom Brown, Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared D Kaplan, Prafulla Dhariwal, Arvind Neelakantan, Pranav Shyam, Girish Sastry, Amanda Askell, et al. Language models are few-shot learners. Advances in Neural Information Processing Systems 33, pages 1877–1901, 2020.
[8] Mark Chen, Jerry Tworek, Heewoo Jun, Qiming Yuan, Henrique Ponde De Oliveira Pinto, Jared Kaplan, Harri Edwards, Yuri Burda, Nicholas Joseph, Greg Brockman, et al. Evaluating large language models trained on code. arXiv preprint arXiv:2107.03374, 2021.
[9] Zixiang Chen, Yihe Deng, Huizhuo Yuan, Kaixuan Ji, and Quanquan Gu. Self-play fine-tuning converts weak language models to strong language models. arXiv preprint arXiv:2401.01335, 2024.
[10] Hyung Won Chung, Le Hou, Shayne Longpre, Barret Zoph, Yi Tay, William Fedus, Yunxuan Li, Xuezhi Wang, Mostafa Dehghani, Siddhartha Brahma, et al. Scaling instruction-finetuned language models. Journal of Machine Learning Research, 25(70):1–53, 2024.
[11] Karl Cobbe, Vineet Kosaraju, Mohammad Bavarian, Mark Chen, Heewoo Jun, Lukasz Kaiser, Matthias Plappert, Jerry Tworek, Jacob Hilton, Reiichiro Nakano, et al. Training verifiers to solve math word problems. arXiv preprint arXiv:2110.14168, 2021.
[12] Simon Colton and Geraint A Wiggins. Computational creativity: The final frontier? In ECAI 2012, pages 21–26. IOS Press, 2012.
[13] Ganqu Cui, Lifan Yuan, Ning Ding, Guanming Yao, Bingxiang He, Wei Zhu, Yuan Ni, Guotong Xie, Ruobing Xie, Yankai Lin, et al. Ultrafeedback: Boosting language models with scaled ai feedback. In Forty-first International Conference on Machine Learning, 2024.
[14] Abhimanyu Dubey, Otkrist Gupta, Ramesh Raskar, and Nikhil Naik. Maximum-entropy fine grained classification. Advances in neural information processing systems, 31, 2018.
[15] Abhimanyu Dubey, Abhinav Jauhri, Abhinav Pandey, Abhishek Kadian, Ahmad Al-Dahle, Aiesha Letman, Akhil Mathur, Alan Schelten, Amy Yang, Angela Fan, et al. The llama 3 herd of models. arXiv preprint arXiv:2407.21783, 2024.
[16] Tingchen Fu, Deng Cai, Lemao Liu, Shuming Shi, and Rui Yan. Disperse-then-merge: Pushing the limits of instruction tuning via alignment tax reduction. arXiv preprint arXiv:2405.13432, 2024.
[17] Zorik Gekhman, Gal Yona, Roee Aharoni, Matan Eyal, Amir Feder, Roi Reichart, and Jonathan Herzig. Does fine-tuning llms on new knowledge encourage hallucinations? arXiv preprint arXiv:2405.05904, 2024.
[18] Ian Goodfellow, Jean Pouget-Abadie, Mehdi Mirza, Bing Xu, David Warde-Farley, Sherjil Ozair, Aaron Courville, and Yoshua Bengio. Generative adversarial nets. Advances in neural information processing systems, 27, 2014.
[19] Yanzhu Guo, Guokan Shang, Michalis Vazirgiannis, and Chloe ́ Clavel. The curious decline of linguistic diversity: Training language models on synthetic text. arXiv preprint arXiv:2311.09807, 2023.
[20] Hyowon Gweon, Hannah Pelton, Jaclyn A Konopka, and Laura E Schulz. Sins of omission: Children selectively explore when teachers are under-informative. Cognition, 132(3):335–341, 2014.
[21] Dan Hendrycks, Collin Burns, Saurav Kadavath, Akul Arora, Steven Basart, Eric Tang, Dawn Song, and Jacob Steinhardt. Measuring mathematical problem solving with the math dataset. arXiv preprint arXiv:2103.03874, 2021.
[22] Jonathan Ho and Stefano Ermon. Generative adversarial imitation learning. In Advances in Neural Information Processing Systems 29, pages 4565–4573, 2016.
[23] Edward J Hu, Moksh Jain, Eric Elmoznino, Younesse Kaddar, Guillaume Lajoie, Yoshua Bengio, and Nikolay Malkin. Amortizing intractable inference in large language models. arXiv preprint arXiv:2310.04363, 2023.
[24] Alexia Jolicoeur-Martineau. The relativistic discriminator: a key element missing from standard gan. arXiv preprint arXiv:1807.00734, 2018.
[25] Alexia Jolicoeur-Martineau. On relativistic f-divergences. In International Conference on Machine Learning, pages 4931–4939. PMLR, 2020.
[26] Robert Kirk, Ishita Mediratta, Christoforos Nalmpantis, Jelena Luketina, Eric Hambro, Edward Grefenstette, and Roberta Raileanu. Understanding the effects of rlhf on llm generalisation and diversity. arXiv preprint arXiv:2310.06452, 2023.
[27] Nathan Lambert, Valentina Pyatkin, Jacob Morrison, LJ Miranda, Bill Yuchen Lin, Khyathi Chandu, Nouha Dziri, Sachin Kumar, Tom Zick, Yejin Choi, et al. Rewardbench: Evaluating reward models for language modeling. arXiv preprint arXiv:2403.13787, 2024.
[28] Chen Li, Weiqi Wang, Jingcheng Hu, Yixuan Wei, Nanning Zheng, Han Hu, Zheng Zhang, and Houwen Peng. Common 7b language models already possess strong math capabilities. arXiv preprint arXiv:2403.04706, 2024.
[29] Jiaxiang Li, Siliang Zeng, Hoi-To Wai, Chenliang Li, Alfredo Garcia, and Mingyi Hong. Getting more juice out of the sft data: Reward learning from human demonstration improves sft for llm alignment. arXiv preprint arXiv:2405.17888, 2024.
[30] Jiwei Li, Michel Galley, Chris Brockett, Jianfeng Gao, and Bill Dolan. A diversity-promoting objective function for neural conversation models. arXiv preprint arXiv:1510.03055, 2015.
[31] Xuechen Li, Tianyi Zhang, Yann Dubois, Rohan Taori, Ishaan Gulrajani, Carlos Guestrin, Percy Liang, and Tatsunori B. Hashimoto. Alpacaeval: An automatic evaluator of instruction-following models. https://github.com/tatsu-lab/alpaca_eval, 2023.
[32] Ziniu Li, Tian Xu, and Yang Yu. A note on target q-learning for solving finite mdps with a generative oracle. arXiv preprint arXiv:2203.11489, 2022.
[33] Ziniu Li, Tian Xu, Yushun Zhang, Yang Yu, Ruoyu Sun, and Zhi-Quan Luo. Remax: A simple, effective, and efficient method for aligning large language models. arXiv preprint arXiv:2310.10505, 2023.
[34] Wei Liu, Weihao Zeng, Keqing He, Yong Jiang, and Junxian He. What makes good data for alignment? a comprehensive study of automatic data selection in instruction tuning. arXiv preprint arXiv:2312.15685, 2023.
[35] Volodymyr Mnih, Koray Kavukcuoglu, David Silver, Andrei A Rusu, Joel Veness, Marc G Bellemare, Alex Graves, Martin Riedmiller, Andreas K Fidjeland, Georg Ostrovski, et al. Human-level control through deep reinforcement learning. Nature, 518(7540):529–533, 2015.
[36] Nasrin Mostafazadeh, Nathanael Chambers, Xiaodong He, Devi Parikh, Dhruv Batra, Lucy Vanderwende, Pushmeet Kohli, and James Allen. A corpus and cloze evaluation for deeper understanding of commonsense stories. In Proceedings of the 2016 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies, pages 839–849, 2016.
[37] Laura O’Mahony, Leo Grinsztajn, Hailey Schoelkopf, and Stella Biderman. Attributing mode collapse in the fine-tuning of large language models. In ICLR 2024 Workshop on Mathematical and Empirical Understanding of Foundation Models, 2024.
[38] OpenAI. Gpt-4 technical report. arXiv preprint arXiv:2303.08774, 2023.
[39] Long Ouyang, Jeffrey Wu, Xu Jiang, Diogo Almeida, Carroll Wainwright, Pamela Mishkin, Chong Zhang, Sandhini Agarwal, Katarina Slama, Alex Ray, et al. Training language models to follow instructions with human feedback. Advances in Neural Information Processing Systems 35, pages 27730–27744, 2022.
[40] Vishakh Padmakumar and He He. Does writing with language models reduce content diversity? arXiv preprint arXiv:2309.05196, 2023.
[41] Gabriel Pereyra, George Tucker, Jan Chorowski, Lukasz Kaiser, and Geoffrey Hinton. Regularizing neural networks by penalizing confident output distributions. arXiv preprint arXiv:1701.06548, 2017.
[42] Alec Radford, Jeffrey Wu, Rewon Child, David Luan, Dario Amodei, Ilya Sutskever, et al. Language models are unsupervised multitask learners. OpenAI blog, 2019.
[43] Rafael Rafailov, Archit Sharma, Eric Mitchell, Stefano Ermon, Christopher D Manning, and Chelsea Finn. Direct preference optimization: Your language model is secretly a reward model. arXiv preprint arXiv:2305.18290, 2023.
[44] Colin Raffel, Noam Shazeer, Adam Roberts, Katherine Lee, Sharan Narang, Michael Matena, Yanqi Zhou, Wei Li, and Peter J Liu. Exploring the limits of transfer learning with a unified text-to-text transformer. Journal of machine learning research, 21(140):1–67, 2020.
[45] Ste ́phane Ross, Geoffrey J. Gordon, and Drew Bagnell. A reduction of imitation learning and structured prediction to no-regret online learning. In Proceedings of the 14th International Conference on Artificial Intelligence and Statistics, pages 627–635, 2011.
[46] John Schulman, Filip Wolski, Prafulla Dhariwal, Alec Radford, and Oleg Klimov. Proximal policy optimization algorithms. arXiv, 1707.06347, 2017.
[47] Laura E Schulz and Elizabeth Baraff Bonawitz. Serious fun: preschoolers engage in more exploratory play when evidence is confounded. Developmental psychology, 43(4):1045, 2007.
[48] Pier Giuseppe Sessa, Robert Dadashi, Le ́onard Hussenot, Johan Ferret, Nino Vieillard, Alexandre Rame ́, Bobak Shariari, Sarah Perrin, Abe Friesen, Geoffrey Cideron, et al. Bond: Aligning llms with best-of-n distillation. arXiv preprint arXiv:2407.14622, 2024.
[49] Ilia Shumailov, Zakhar Shumaylov, Yiren Zhao, Yarin Gal, Nicolas Papernot, and Ross Anderson. The curse of recursion: Training on generated data makes models forget. arXiv preprint arXiv:2305.17493, 2023.
[50] Charlie Snell, Jaehoon Lee, Kelvin Xu, and Aviral Kumar. Scaling llm test-time compute optimally can be more effective than scaling model parameters. arXiv preprint arXiv:2408.03314, 2024.
[51] Ruoyu Sun, Tiantian Fang, and Alexander Schwing. Towards a better global loss landscape of gans. Advances in Neural Information Processing Systems, 33:10186–10198, 2020.
[52] Gemma Team, Thomas Mesnard, Cassidy Hardin, Robert Dadashi, Surya Bhupatiraju, Shreya Pathak, Laurent Sifre, Morgane Rivie`re, Mihir Sanjay Kale, Juliette Love, et al. Gemma: Open models based on gemini research and technology. arXiv preprint arXiv:2403.08295, 2024.
[53] Hugo Touvron, Louis Martin, Kevin Stone, Peter Albert, Amjad Almahairi, Yasmine Babaei, Nikolay Bashlykov, Soumya Batra, Prajjwal Bhargava, Shruti Bhosale, et al. Llama 2: Open foundation and fine-tuned chat models. arXiv preprint arXiv:2307.09288, 2023.
[54] Lewis Tunstall, Edward Beeching, Nathan Lambert, Nazneen Rajani, Kashif Rasul, Younes Belkada, Shengyi Huang, Leandro von Werra, Cle ́mentine Fourrier, Nathan Habib, et al. Zephyr: Direct distillation of lm alignment. arXiv preprint arXiv:2310.16944, 2023.
[55] Gina Turrigiano. Homeostatic synaptic plasticity: local and global mechanisms for stabilizing neuronal function. Cold Spring Harbor perspectives in biology, 4(1):a005736, 2012.
[56] Gina G Turrigiano. The self-tuning neuron: synaptic scaling of excitatory synapses. Cell, 135 (3):422–435, 2008.
[57] Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N. Gomez, Lukasz Kaiser, and Illia Polosukhin. Attention is all you need. In Advances in Neural Information Processing Systems 30, pages 5998–6008, 2017.
[58] Nino Vieillard, Tadashi Kozuno, Bruno Scherrer, Olivier Pietquin, Re ́mi Munos, and Matthieu Geist. Leverage the average: an analysis of kl regularization in reinforcement learning. In Advances in Neural Information Processing Systems 33, pages 12163–12174, 2020.
[59] Xuezhi Wang, Jason Wei, Dale Schuurmans, Quoc V. Le, Ed H. Chi, Sharan Narang, Aakanksha Chowdhery, and Denny Zhou. Self-consistency improves chain of thought reasoning in language models. In Proceedings of the 11st International Conference on Learning Representations, 2023.
[60] Jason Wei, Maarten Bosma, Vincent Y Zhao, Kelvin Guu, Adams Wei Yu, Brian Lester, Nan Du, Andrew M Dai, and Quoc V Le. Finetuned language models are zero-shot learners. arXiv preprint arXiv:2109.01652, 2021.
[61] Jason Wei, Xuezhi Wang, Dale Schuurmans, Maarten Bosma, Fei Xia, Ed Chi, Quoc V Le, Denny Zhou, et al. Chain-of-thought prompting elicits reasoning in large language models. Advances in neural information processing systems, 35:24824–24837, 2022.
[62] Yuxiang Wei, Zhe Wang, Jiawei Liu, Yifeng Ding, and Lingming Zhang. Magicoder: Empowering code generation with oss-instruct. In Forty-first International Conference on Machine Learning, 2024.
[63] Ting Wu, Xuefeng Li, and Pengfei Liu. Progress or regress? self-improvement reversal in post-training. arXiv preprint arXiv:2407.05013, 2024.
[64] Jiancong Xiao, Ziniu Li, Xingyu Xie, Emily Getzen, Cong Fang, Qi Long, and Weijie J Su. On the algorithmic bias of aligning large language models with rlhf: Preference collapse and matching regularization. arXiv preprint arXiv:2405.16455, 2024.
[65] Alex Young, Bei Chen, Chao Li, Chengen Huang, Ge Zhang, Guanwei Zhang, Heng Li, Jiangcheng Zhu, Jianqun Chen, Jing Chang, et al. Yi: Open foundation models by 01. ai. arXiv preprint arXiv:2403.04652, 2024.
[66] Longhui Yu, Weisen Jiang, Han Shi, Jincheng Yu, Zhengying Liu, Yu Zhang, James T Kwok, Zhenguo Li, Adrian Weller, and Weiyang Liu. Metamath: Bootstrap your own mathematical questions for large language models. arXiv preprint arXiv:2309.12284, 2023.
[67] Biao Zhang, Zhongtao Liu, Colin Cherry, and Orhan Firat. When scaling meets llm finetuning: The effect of data, model and finetuning method. arXiv preprint arXiv:2402.17193, 2024.
[68] Chunting Zhou, Pengfei Liu, Puxin Xu, Srini Iyer, Jiao Sun, Yuning Mao, Xuezhe Ma, Avia Efrat, Ping Yu, Lili Yu, Susan Zhang, Gargi Ghosh, Mike Lewis, Luke Zettlemoyer, and Omer Levy. LIMA: less is more for alignment. arXiv preprint arXiv:2305.11206, 2023.
[69] Jeffrey Zhou, Tianjian Lu, Swaroop Mishra, Siddhartha Brahma, Sujoy Basu, Yi Luan, Denny Zhou, and Le Hou. Instruction-following evaluation for large language models. arXiv preprint arXiv:2311.07911, 2023.
