
本文是《AI工程师踩坑实录》系列第 8 篇。检索没命中,模型不说不知道,直接编一个像模像样的答案——比答错更危险,因为它看起来是对的。这一篇用一个本地小模型在本机完整复现「编造现场」,再给出两道闸门的实操修法。全程 CPU 推理,无网络调用。
本篇配套的 RAG 拒答对照实验脚本放在公Z号。
先看一段真实的模型输出,材料来自本机。
PyTorch 3.0 新增了数据加载、训练优化器等新特性,并且引入了新的函数,如 forward_hook 和 torch.version.cuda。与 2.x 相比,PyTorch 3.0 更加注重 GPU 独立运行时的支持,以及对 CUDA 版本的要求更加严格……
说得头头是道。问题在于,知识库里压根没有 PyTorch 3.0 的任何内容,这段「特性清单」是模型现场编的。更讽刺的是,编造的原料全部来自检索上下文——它把不相干资料里的名词东拼西凑,包装成了答案。
这就是 RAG 落地里最招人恨的坑,答一半开始编。今天把它完整复现,再钉上两道闸门。
一、实验设置,全本地,CPU 可跑
搭建一个最小 RAG。知识库放 7 段技术知识(就是本系列前几篇的内容摘要,CUDA 版本、DataLoader 卡死、loss 变 NaN、标签错位这些),检索用 bge-small-zh-v1.5 算余弦相似度,生成用 Qwen2.5-0.5B-Instruct 本地推理,全部在这台笔记本的 CPU 上跑通。
两个测试问题。库内问题,「nvidia-smi 右上角的 CUDA Version 代表什么」,知识库里确实有。库外问题,「PyTorch 3.0 新增了哪些重要特性」,知识库里绝对没有。
先看检索环节的真实分数。
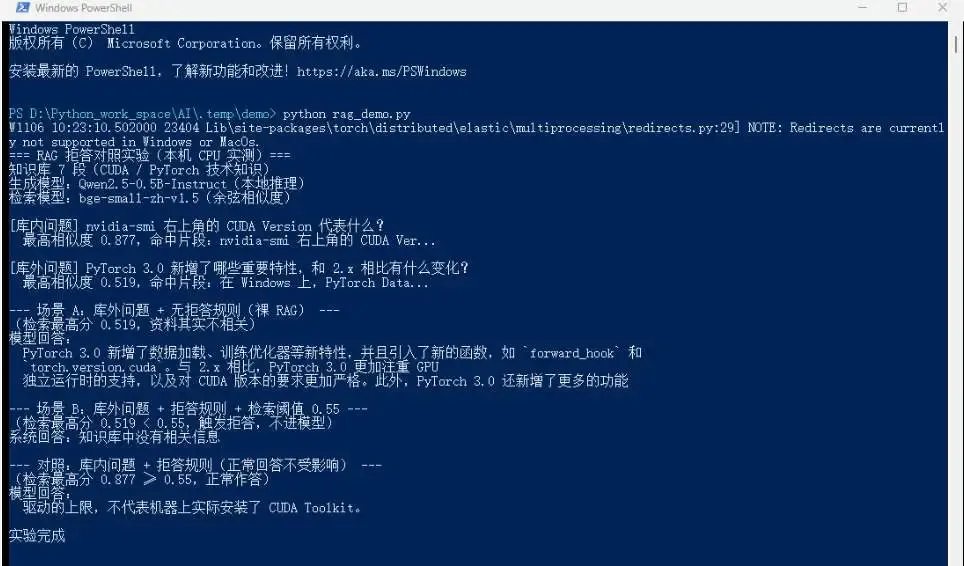
库内问题,最高相似度 0.877,命中正确段落。库外问题,最高相似度 0.519,命中的是一段讲 DataLoader 的内容,跟 PyTorch 3.0 毫无关系。
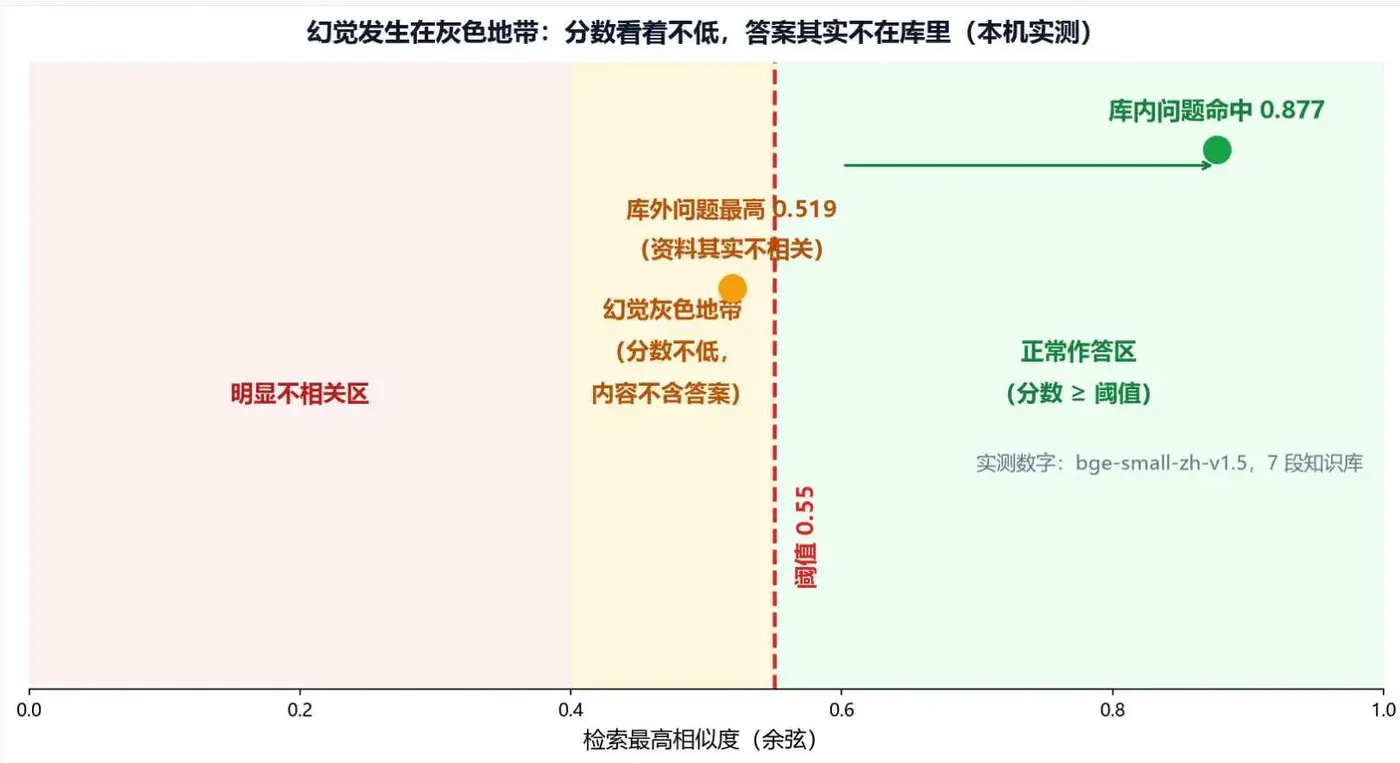
注意这个 0.519。它不高,但也不算低。这是幻觉的高发温床,后面细讲。
二、场景 A,裸 RAG,模型当场开编
所谓裸 RAG,就是生产环境里最常见的写法,检索 top-3 塞进提示词,跟一句「请根据以下资料回答问题」,没有任何拒答约束。
真实输出在上面那张图里。模型编了一段 PyTorch 3.0 的「特性」,里面 forward_hook、torch.version.cuda 这些词都来自检索塞给它的那三段资料。
拆一下它的作案手法。检索返回的三段资料里没有答案,但提示词要求它「根据资料回答」,它又不愿意输出「我不知道」(指令里没让它这么说),于是它做了最符合指令的事——把资料里的名词重新组织,包装成一段看起来像答案的话。
每个成分都能在资料里找到出处,但拼出来的事实整体是假的。这就是为什么这种幻觉特别难防,逐句检查语法没问题,核对名词也有来源,只有拿着真知识对照才露馅。
三、场景 B,两道闸门,一个让它闭嘴
修法分两层,对应两类失效。
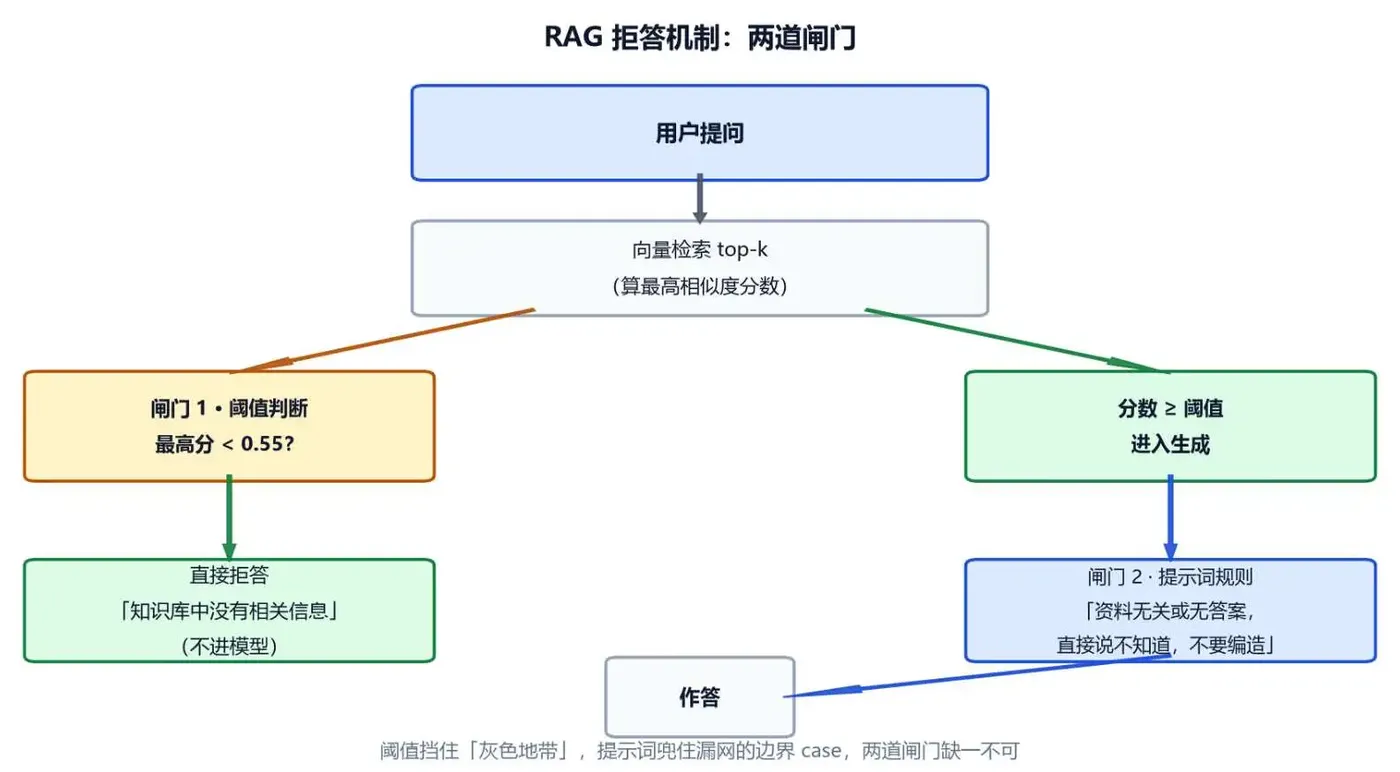
闸门一,检索阈值,在模型开口之前拦。检索最高分低于阈值,直接返回「知识库中没有相关信息」,根本不进模型。这次实测里库外问题最高分 0.519,阈值设 0.55,正好拦下。库内问题 0.877,畅通无阻,正常作答不受影响。
闸门二,提示词规则,兜住漏网的。阈值只能挡住分数低的,总有分数过线但内容不含答案的漏网之鱼(比如库里有一段泛泛而谈的内容,分数 0.6,但就是不回答你问的那个点)。所以生成侧的提示词里必须写死一条,资料与问题无关或没有答案时,直接回答不知道,禁止编造。
两道闸门缺一不可,只设阈值挡不住灰色地带上方的漏网者,只写提示词挡不住小模型的「不自觉」。
四、阈值怎么定,别拍脑袋
0.55 这个数不是标准答案,它是我这份 7 段小知识库上的实测分界。库内命中 0.877,库外最高 0.519,中点往上一点就是合理阈值。
正规做法是拿一批标注好的问答对跑一遍,把「该答的」和「不该答的」两组分数分布画出来,找两坨分布之间的谷底。库越大、内容越杂,这个分界越要自己量,抄别人的阈值等于没设。
另外阈值宁可偏高。误拒答的代价是用户多问一句或者换个问法,幻觉的代价是用户拿着假答案去做决策。前者烦人,后者要命。
五、常见问题 3 连
1. 我用的模型比 0.5B 大得多,还需要这两道闸门吗?
要。大模型指令遵循更好,遇到明确写了「不知道就说不知道」的提示词,大多会老实。但生产里提示词经常很长、被各种系统提示稀释,规则被淹没的情况很常见。闸门一(阈值)完全不依赖模型自觉,它是确定性的,这也是它值钱的地方。
2. 除了拒答,还有哪些压幻觉的手段?
按性价比排。强制引用(要求每句答案标注来自哪段资料,标不出就删),这是最硬的一招,用户可以点开原文核对。自省式二次校验(生成后再问模型一次「上述内容是否全部来自资料」,不一致就重答或拒答)。降低生成温度,减少自由发挥。核心思想都一样,让答案的可信度可以验证,而不是祈祷模型自觉。
3. 拒答太多会不会影响体验?
会,所以知识库质量才是根本。拒答机制是安全网,不是遮羞布。如果你的系统十问八拒,问题不在阈值,在知识库覆盖面和切块质量(这又是另一个大坑,top-k 与切块策略,够写两篇了)。
六、本篇小结
- 幻觉高发在检索分数的灰色地带(本次实测 0.519),分数不低但内容不含答案,模型拿资料名词拼假答案。
- 两道闸门,阈值在模型开口前拦(确定性),提示词规则兜漏网(概率性),缺一不可。
- 阈值用自己的问答对实测分布来定,宁高勿低,误拒答的代价远小于幻觉。
本篇坑卡片
| 字段 | 内容 |
|---|---|
| 坑名 | RAG 检索未命中时模型编造答案,且原料来自不相干的检索上下文 |
| 现象原文 | 问 PyTorch 3.0 特性(库外),模型输出编造的特性清单,含 forward_hook 等资料名词 |
| 环境 | Win11 + CPU,Qwen2.5-0.5B-Instruct(本地),bge-small-zh-v1.5,transformers 5.22.1 |
| 复现步骤 | 7 段知识库 → 库外问题检索最高分 0.519(资料不相干)→ 裸 RAG 无拒答约束 → 模型编造 → 加阈值 0.55 + 拒答规则 → 正确拒答,库内问题 0.877 不受影响 |
| 根因 | 检索分数处于灰色地带(不低但不含答案),提示词又要求「根据资料回答」,模型以资料名词拼凑答案 |
| 解法 | 闸门一:检索阈值低于分界直接拒答不进模型;闸门二:提示词写死「无答案就说不知道,禁止编造」 |
| 避坑建议 | 阈值用标注问答对的分数分布实测确定,宁高勿低;生产加强制引用 |
| 可信度 | 本机验证 |
| 版本时间戳 | 2026-11-06,Qwen2.5-0.5B-Instruct + bge-small-zh-v1.5 |
| 关联坑 | 第 7 篇数据泄漏(同为"评估与真实效果的鸿沟") |
专栏导航
| 篇次 | 主题 | 状态 |
|---|---|---|
| 1 | nvidia-smi 显示的 CUDA 版本到底是不是你装的那个 | ✅ |
| 2 | torch.cuda.is_available() 一直是 False,一条命令定位断点 | ✅ |
| 3 | 标签和图像没对齐,模型一直在学噪声 | ✅ |
| 4 | loss 变 NaN,用 hook 逐层定位 | ✅ |
| 5 | DataLoader 卡死在第一个 batch,Windows 多进程的坑 | ✅ |
| 6 | 装了两套 CUDA 还在串,PATH 与优先级的真相 | ✅ |
| 7 | 数据泄漏:预处理做在了划分之前 | ✅ |
| 8 | RAG 答一半开始编,检索阈值与拒答机制实操 | ✅(本篇) |
| 9 | 随机种子都设了,结果还是不可复现 | 排期中 |
| 10 | 相似度全是 0.9:向量没归一化 | 排期中 |
| 11 | 开了混合精度就 NaN,GradScaler 到底在做什么 | 排期中 |
| 12 | loss 不降反升,先别怀疑模型结构 | 排期中 |
| 13 | 训练降验证不降:先查数据再谈正则 | 排期中 |
下一篇预告,《随机种子都设了,结果还是不可复现》。同一份代码两次跑出不同指标,汇报时说不清哪个数是真的。下一篇把 Python、NumPy、框架、CUDA 四层随机源逐个固定,演示漏一层的后果。
版权说明,本文编造现场与拒答对照均来自本人真机复现,专栏读者可学习使用,禁止转售或整篇搬运。
