
过去两年,大模型行业最常被讨论的是“谁的模型更强”。而到了 2026 年,真正决定一个 AI 产品能不能活下去的,已经从“效果好不好”变成了“每千次调用的成本是多少”。模型能力在快速趋同,Token 账单却在真实地吞噬利润表。这也是为什么阿里云 Token Plan 的这次全面升级值得单独拿出来讲——它不是一次简单的价格调整,而是一次围绕“额度、模型池、计费颗粒度、服务保障”四个维度的结构性重做,核心结论只有一句:加量不加价,最新优惠 5 折起,主力场景调用 Qwen4-Max 综合可省 80%。
一、为什么 Token 成了 2026 年 AI 项目的头号成本项
先说清楚背景,否则“省 80%”听起来像营销话术。
第一,调用量级发生了跃迁。2024 年一个 AI 应用日均调用几千次就算活跃,现在一个稍微像样的客服、写作、代码助手,日均调用是几十万到上百万次,单日 Token 消耗轻松破亿。单价虽然在降,但总量涨得更快,总账单是往上走的。
第二,交互形态变“贵”了。单轮问答早已不是主流,现在是 Agent 多轮规划、RAG 检索增强、思维链推理、长文档整篇投喂。同样一次用户提问,背后可能是 8 到 15 次模型调用、几万 Token 的上下文。有团队做过统计,从 Chatbot 升级到 Agent 架构,Token 消耗普遍涨 5 到 20 倍。
第三,长上下文成为默认配置。以前 8K 上下文够用,现在合同审阅、财报分析、代码仓库理解,动辄 128K、256K 起。上下文越长,单次调用的 Token 基数越大,而且每一轮对话都要把历史上下文重新计费一遍,这是最容易被忽视的成本黑洞。
所以成本优化的重点,已经从“换更便宜的卡”转向“换更合理的 Token 采购方式”。这就是 Token Plan 这类套餐产品存在的意义:把波动的按量付费,变成可预测的预付费额度,再用阶梯和权益把单价压下来。
二、这次升级,具体改了四件事
额度加量。 同一档位的套餐,包含的 Token 总量上调,且不再把输入和输出粗暴地按同一系数折算,长上下文场景的实际可用额度明显变多。对做长文档处理的团队来说,这是最直接的利好。
模型池扩容。 套餐不再只覆盖轻量模型,旗舰级的 Qwen4-Max 正式进入可调用范围。这一点非常关键——过去很多团队的痛点是“套餐额度只能跑小模型,真要上旗舰模型还得单独按量付费”,两套账算起来极其麻烦。现在一个套餐覆盖从轻量到旗舰的完整梯队,做模型路由时不用再考虑计费口径不一致的问题。
计费颗粒度变细。 上下文缓存命中部分单独计价且折扣显著,批量推理(Batch)单独走低价通道,阶梯用量越高单价越低。这三项叠加,是把“名义折扣”变成“实际账单下降”的关键。
服务保障升级。 并发配额、限流阈值、SLA 承诺同步上调,高峰期不再因为配额卡住业务。对生产环境来说,这一条的价值往往高于价格本身。
三、算一笔账:“立省 80%”到底怎么来的
很多文章写“省 80%”却不给推导过程,这里拆开算。假设一个中型 AI 应用,月消耗 1 亿 Token,原方案是按量付费,其中 60% 是带重复上下文的对话调用,30% 是可延迟的批处理任务,10% 是必须实时的旗舰模型调用。
| 优化动作 | 作用对象 | 大致降本幅度 |
|---|---|---|
| 套餐折扣 + 5 折活动 | 全量 Token | 40%–50% |
| 上下文缓存命中 | 重复上下文部分 | 该部分再降 50% 以上 |
| 批量推理通道 | 可延迟任务 | 该部分降 50% 左右 |
| 模型路由(轻量模型分流) | 简单任务 | 该部分降 70% 以上 |
单看每一项都不夸张,但叠加之后,综合账单下降 80% 是完全可实现的——注意,这个 80% 是“综合优化后对比原按量付费原价”,不是“所有调用一律打两折”,理解这一点才不会对账时期望落空。真正把 80% 吃满的团队,共同点是做了三件事:把重复的 system prompt 和文档放进缓存、把离线任务全部挪到批量通道、把分类抽取这类简单活儿交给轻量模型。
四、Qwen4-Max 适合放在哪一环
旗舰模型不是万能药,用错位置就是纯烧钱。基于实际项目经验,Qwen4-Max 的价值集中在四类任务:
复杂推理与规划。 Agent 的任务分解、多步工具调用决策、失败后的自我纠错,这些环节对模型能力极度敏感,换小模型往往导致整条链路崩掉,省下的钱还不够补人工。
长文档深度理解。 合同条款比对、财报跨期分析、技术文档问答,需要模型在超长上下文里保持注意力不衰减。
代码理解与生成。 跨文件重构、Bug 定位、单测补全,这类任务对模型的代码语义把握要求高。
多模态混合输入。 图文混排的票据、报表、界面截图理解。
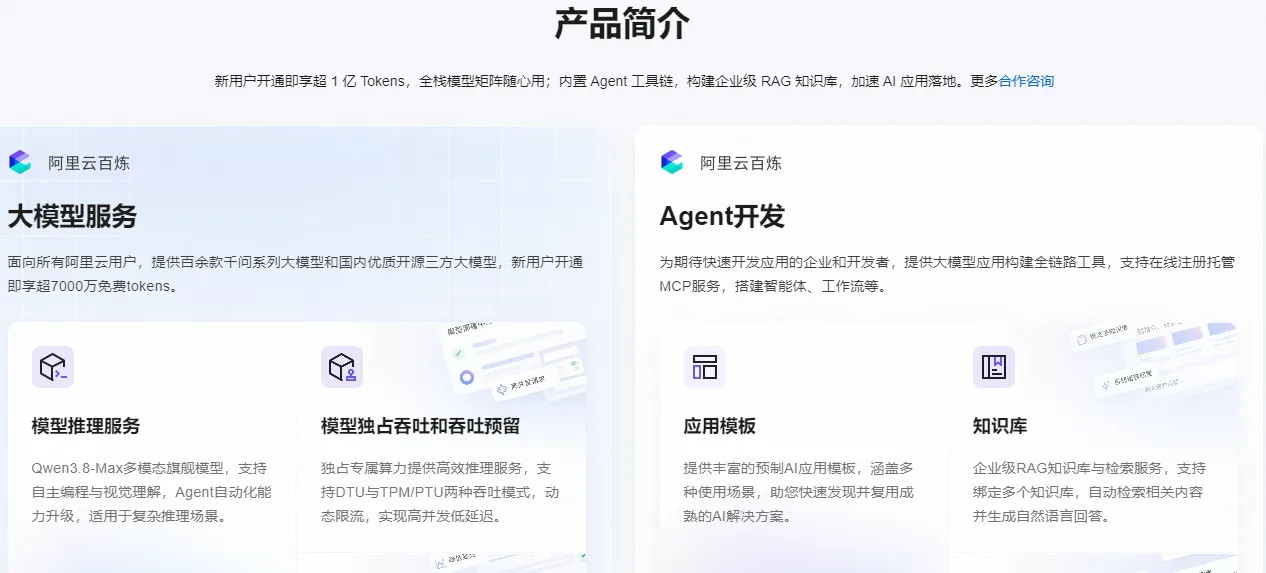
反过来,不建议用旗舰模型的场景也很明确:高频意图分类、情感打标、实体抽取、简单改写润色。这些任务用轻量模型效果差异在 2 个百分点以内,成本差 5 到 10 倍。合理做法是做一层模型路由:先判断任务复杂度,简单的直接走轻量模型,命中不了的再升级到 Qwen4-Max。大模型详情可参考:https://www.aliyun.com/product/bailian
五、5 折起怎么拿,以及三个容易踩的坑
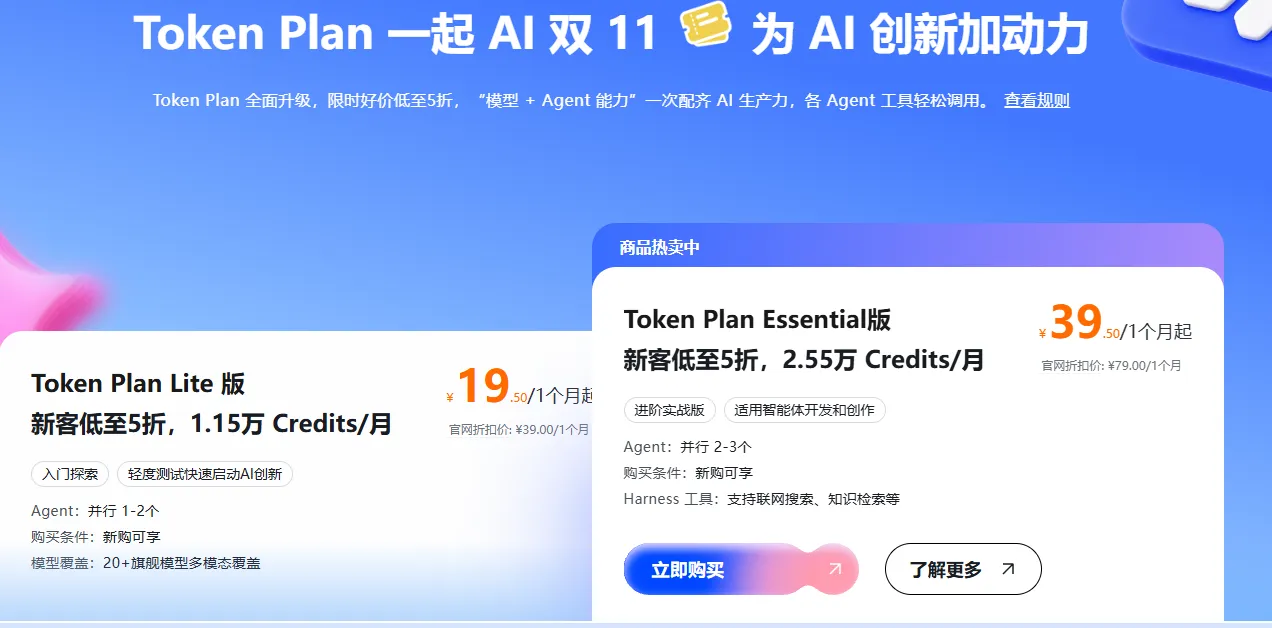
优惠通常分几类:新用户首购、老套餐续费升级、档位跃迁、以及限时的活动折扣。实操上建议按这个顺序确认:先看自己当前档位是否已包含 Qwen4-Max 的调用权益;再比较“升一档”与“买两个低档”的单价差异,通常升档更划算;最后确认活动折扣能否与阶梯价叠加。
三个坑要提前避开:
一是活动有效期与额度有效期不是一回事。折扣可能只在本月有效,但买到的额度有效期更长,别把两件事混为一谈,续费节奏要按额度消耗速度排,不是按折扣周期排。
二是缓存命中率不会自动变高。上下文缓存要求请求前缀稳定,如果你的 prompt 里塞了时间戳、随机 ID、每次变化的用户昵称,缓存永远命中不了。把可变内容全部后置,是提升命中率最有效的一招。
三是批量通道有延迟。Batch 便宜是因为它异步排队,适合夜间跑的数据标注、离线摘要、历史数据回刷,千万别把用户在等的实时请求丢进去。更多Token Plan活动详情可参考:https://www.aliyun.com/benefit/scene/tokenplan
六、接入实操:三十分钟跑通
Token Plan 的接口保持 OpenAI 兼容,迁移成本极低:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_DASHSCOPE_API_KEY",
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
)

resp = client.chat.completions.create(
    model="qwen4-max",
    messages=[
        # 稳定前缀放最前面,才能吃到上下文缓存折扣
        {
   "role": "system", "content": "你是一名严谨的合同审阅助手,按风险等级输出条款清单。"},
        {
   "role": "user", "content": doc_text},
    ],
    extra_body={
   "enable_cache": True},
)
print(resp.usage)
上线后第一件事不是看效果,是看 usage 字段:prompt_tokens、completion_tokens、缓存命中量各占多少。把这三个数字做成日报,两周之内你就能定位到 80% 的钱花在哪几个接口上。
控制台额度与用量看板截图(替换为原文配图):
七、成本治理清单
按投入产出比排序,前三条通常能解决大部分问题:
- 稳定前缀 + 开启缓存,把 system prompt、知识库文档、few-shot 示例全部前置固定,缓存命中率做到 60% 以上,账单立刻可见下降。
- 上模型路由,按任务复杂度分流,简单任务绝不碰旗舰模型。
- 离线任务全部迁到批量通道,尤其适合数据回刷和批量打标。
- 压缩上下文,多轮对话做摘要滚动,历史轮次不全量回传;能用检索解决的不用整篇投喂。
- 设预算熔断,按接口设日额度上限,异常调用自动降级,避免一次代码 bug 烧掉一个月预算。
八、几个高频问题
额度用不完会清零吗? 按套餐规则执行,购买前务必确认有效期和结转政策,建议按“近三个月平均消耗 × 1.2”选档,不要一次囤太多。
能同时调用多个模型吗? 可以,套餐额度在模型池内通用,这正是做模型路由的前提。
已有按量付费的账单怎么办? 通常可以切换为套餐计费,切换时点建议选在账单周期开始时,避免跨期折算的麻烦。
团队多人共用怎么管? 用子账号 + 配额分配,按项目而不是按人头切额度,便于归因成本。
模型能力决定你的产品上限,Token 成本决定你的产品能不能规模化。这次 Token Plan 的升级,本质上是在把“用得起旗舰模型”从一句口号变成可执行的账本——额度加量、模型池扩容、计费颗粒度变细、服务保障上调,再加上 5 折起的限时优惠,对于正在从 Demo 走向生产的团队来说,是一个值得重新算一次账的时间点。
小结:到 2026 年,决定一个 AI 产品能否活下来并规模化的,已经不是模型效果,而是每千次调用的成本。Token Plan 这次升级给出的不是一张价格表,而是一套可执行的成本治理方法:用套餐锁定额度、用缓存吃掉重复上下文、用批量通道消化离线任务、用模型路由分流简单请求。
