
多平台开店是电商经营的常态:天猫、京东、拼多多、抖音、快手各一个店,订单、推广花费、客服会话、评价数据分散在各平台后台。运营想看个整体情况,得挨个登录、导出、拼 Excel。店铺两三个的时候还能忍,开到五家以上,数据滞后就成了常态——推广烧到一半才发现 ROI 不对,补货靠拍脑袋,跨店比价全凭印象。
数据入仓这件事,拆开看就是三个要求:采得全、采得稳、数据别出门。围绕这三个要求,"本地采集 + 云端汇聚"是代运营团队和中小商家圈子里跑了多年的成熟路线,方案本身不新,坑基本都被踩过一遍。本文把架构设计、执行层选型要点、云侧落地配置和踩坑经验完整过一遍。
一、为什么是本地采集 + 云端汇聚
不少团队的第一反应是:写个云端脚本定时采集不就行了?做过的人知道这条路走不远,原因有三:
平台风控不认机房 IP。电商后台对异地、云服务器 IP 登录非常敏感,容易触发验证码、滑块,账号还有被限制权限的风险。
账号环境跟人不跟云。多店铺普遍用指纹浏览器做多账号环境隔离,采集动作必须跑在对应环境对应的设备上。
数据安全有红线。订单明细带买家联系方式,经营数据是商业机密,先本地留存、脱敏后再上云,是对合规的基本交代。
所以架构分成两侧:采集与执行放本地,存储与分析放云端。本地贴近数据源干活,云端负责算得动、存得下、看得清。
二、整体架构:四层拆解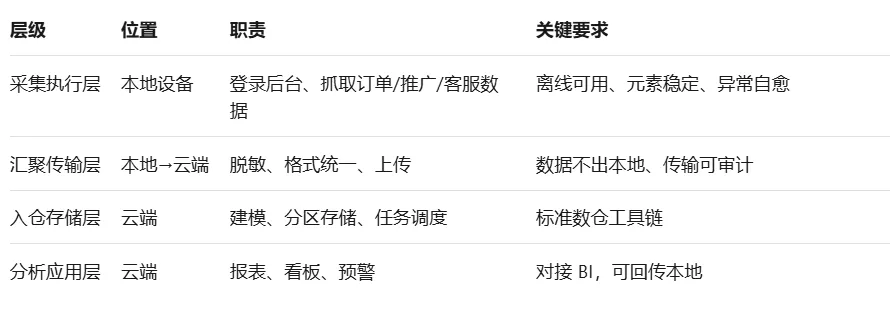
云侧选型很常规,下文第五节给出可照抄的配置。真正的差异和难点全在采集执行层。
三、采集执行层:RPA 底座的选型硬指标
手写采集脚本跑 demo 很快,运维很痛:页面改版一批选择器失效,风控弹窗当场卡死,报错堆栈甩给运营没人看得懂。更稳的做法是以 RPA 作为执行底座——让流程像人一样点按钮、翻页面、填表单、读表格。选型时建议逐条核对以下指标:
全离线、内网部署:流程与数据全部保存在本地设备,不同步到服务端,断外网照跑。这条决定经营数据会不会离开你的门。
Web 元素 AI 自愈:后台页面隔三差五改版,元素定位失效是常态。优先选失效时能自动修复路径、流程不中断的,而不是半夜报警等人改代码。
AI 生成脚本一键转流程:大模型生成的逻辑能直接变成可运行流程,基础指令不够时自动封装新指令,每条指令带注释,逻辑一目了然。
大模型接入与识图能力:AI 能力支持对接文心一言、豆包、DeepSeek、Kimi 等主流大模型,并带图片识图与 OCR——截图发过去,页面表格和字段直接读懂。
打包导出 EXE:接收方不装客户端双击即用;EXE 支持授权管理、加密分享、单独设置 API 触发与定时执行;支持在线推送更新,本地应用打开自动检测新版本,免去人肉分发。
报错可自助修复:AI 一键诊断错误原因、给修复建议,能自动调试到跑通。运营团队没有专职开发,这条省掉大量沟通成本。
成本透明:AI 能力由用户自行对接各平台大模型 API,用多少充多少,账单自己看得见。
分工上有个朴素的共识:AI 负责思考,自动化负责稳定落地。大模型擅长理解需求、生成逻辑、诊断错误,但让它长期直接驾驶浏览器,会遇到 token 持续消耗成本高、生成元素不稳定、桌面软件操作困难、内网离线用不了几个硬伤。两者叠用,才同时便宜和稳。
3.1 多账号环境:指纹浏览器是标配
多店铺意味着多浏览器环境。市面主流指纹浏览器基本都能被 RPA 工具对接,流程内直接唤起指定环境、指定账号采集。把"环境编号"参数化,一套流程复用所有店铺,新开店只加一行配置。
3.2 触发方式:定时 + API 双通道
定时执行:每日凌晨拉昨日订单与花费,早上九点前数据已在仓里。
API 触发:大促期间手动点一下,或上游系统(ERP 出库完成)发请求立刻增量补采。
3.3 稳定性细节:元素、视觉与异常处理
元素获取支持本地智能生成,多条候选路径里挑稳定的;也能自然语言描述直接生成 XPath,不用啃语法。
遇上企业微信、微信、QQ、千牛这类消息内容,走视觉颜色识别路线也能取,不依赖元素节点。
流程里用变量批量管理店铺参数,JSON 自动提字段、列表自动提取,长流程按业务拆成子流程复用。
四、AI 协同层:让流程自己会"长"
搭建阶段:截图加一句话描述需求——"把这张图里近七天的花费和成交额采集下来存 Excel",工具智能分析页面元素结构后自动生成流程,覆盖浏览器自动化、Windows 软件自动化、视觉颜色操作三条路线。
交付阶段:流程不一定要给运营看指令列表。截图发给 AI 就能生成对应操作界面,复杂界面用 HTML 组件拼装,按钮点击、数据展示、数据关联都通过对话完成——运营面对熟悉的界面,后台跑标准化流程。
运维阶段:报错 AI 诊断加一键修复;页面改版导致的元素失效自动修复,多数改版无感通过。
外部协同阶段:在钉钉、飞书、企业微信、个人微信里发指令控制流程执行,执行完回调通知结果;支持 MCP 服务,可接入 Workbuddy、Codex、Claude、Trae、豆包工作流等智能体工具,让其他 AI 反向驱动流程搭建。
五、云侧落地示例:可照抄的配置
以国内主流云厂商的对象存储 + 数据仓库 + 调度组合为例(各家云均有对应产品,思路一致)。
OSS 存储规范:原始文件与脱敏文件分桶,按店铺、数据域、日期分区:
oss://bucket-raw/店铺编码/orders/dt=2026-11-13/part-001.csv
oss://bucket-clean/店铺编码/orders/dt=2026-11-13/part-001.csv
数仓分层:
ODS 贴源层:原样入仓,字段与源文件一致;
DWD 清洗层:统一币种、时区,脱敏处理,例如 buyer_phone → phone_mask(保留前三后四);
DWS 汇总层:店铺 × 日期粒度聚合订单量、GMV、推广花费,供报表直读。
调度依赖:调度工具上按"采集完成 → ODS → DWD → DWS → 报表"挂依赖,任一环失败告警到飞书或钉钉群,本地采集侧同步收到回调。大促期间把 DWD 调度频率提到小时级,平时日级即可。
六、数据安全与合规
落到操作层面四句话:
采集在本地跑,流程、凭据、产出数据全部留在本地设备;
上传云端前先脱敏,联系方式打码、地址只到市级;
传输走加密通道,对象存储开启服务端加密和访问白名单;
权限按角色收口,运营看报表,分析师取明细。
另外采集频率按业务实际需要设定,不做超出经营需要的获取,既稳账号,也符合平台规则。
七、成本与适用性
门槛没有想象中高:选免费版无使用时长限制、无流程数量限制的 RPA 产品,前期零成本验证;分发给多人跑时 EXE 打包授权按需开通,多设备使用不需要多开会员。个人开发者、个人工作室接数据代运营需求,中小企业搭经营数据中台,都是这套架构的典型用户。AI 侧按自家业务量充值对应平台 API,费用全程自控。
八、常见问题
Q1:纯内网环境能跑吗?
能。离线部署后执行全在本地闭环;若分析在上云,配置"本地暂存 + 联网后增量上传"。
Q2:后台改版流程会大面积失效吗?
带元素 AI 自愈能力的工具,多数改版无感通过;过不去的,AI 诊断会标出失效步骤,人工确认一次即可。
Q3:非技术人员能维护吗?
可以。流程自然语言生成、注释齐全、报错 AI 给修复建议;新增店铺只是复制配置改几个变量。
Q4:AI 大模型波动怎么办?
职责切清楚:AI 只做生成、诊断、修复这类"思考型"工作,执行由本地自动化稳定承担。AI 不可用时不影响已上线流程的定时执行——这是"AI 思考 + 自动化落地"组合相比纯 AI 脚本的明显优势。
Q5:数据会不会被工具厂商看到?
选流程数据全本地保存、无任何服务端同步的工具,配合脱敏与加密传输,链路自己可控。
这套方案没有黑科技:本地 RPA 贴近数据源稳定采集,云端数仓汇聚分析,AI 把搭建和维护成本压下来。选型时别只对比功能清单,把"改版要不要人盯、报错谁来修、数据出不出门、账单看不看得懂"这四个问题挨个问一遍,比看十页宣传材料管用。
