本文是命理类紫微斗数小程序后端开发的实战分享。紫微排盘涉及大量干支换算、星曜宫位推演,属于典型 CPU 密集型计算接口,直接实时运算、查库很容易出现响应慢、数据库压力高、小程序弱网超时等问题。本文从业务痛点出发,分享一套小程序本地缓存 + 服务端内存缓存 + Redis 分布式缓存的三层缓存架构,包含缓存 Key 设计、过期策略、缓存异常防护方案和上线优化效果,适合小程序后端开发者、做接口性能调优的同学参考。
一、背景与业务痛点
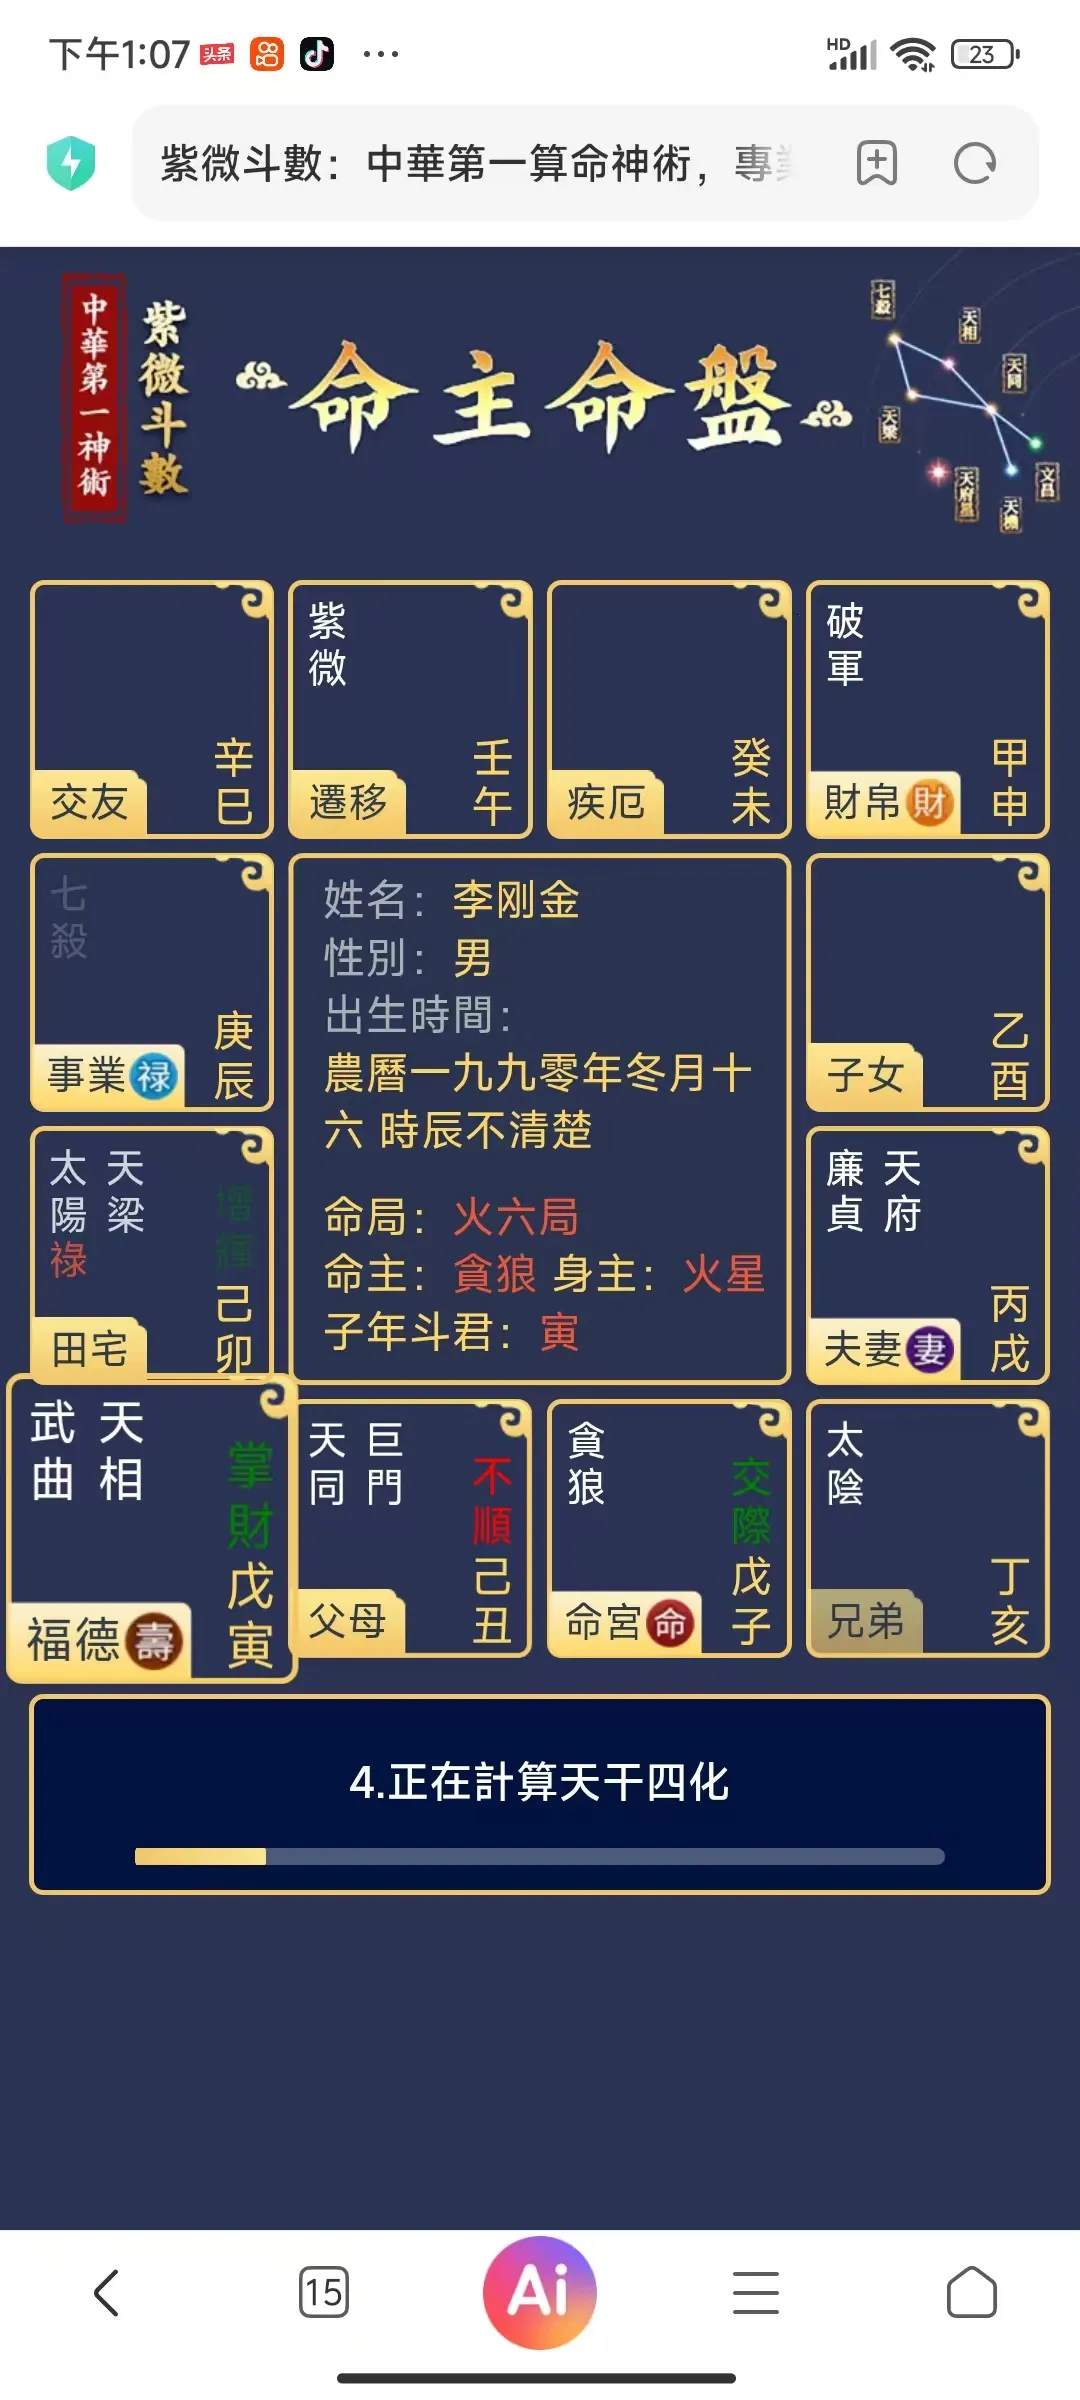
近期在开发紫微斗数排盘小程序,核心接口接收用户出生年月日时、时区、性别,完成整套排盘逻辑。 完整排盘流程要做天干地支校正、命宫身宫定位、安星、四化判断、宫位关系推演,规则判断非常多。刚上线的时候遇到不少麻烦。
同一组生辰参数,经常被重复请求,每一次都要完整跑一遍排盘算法,还要读取星曜基础数据,接口响应经常在 600ms 以上。高峰期大量用户查询同一个生辰,重复计算持续消耗服务 CPU,数据库连接容易被打满。再加上小程序端弱网环境多,用户加载慢就会反复提交,进一步放大请求流量。
这个业务有一个很适合缓存的特点:入参固定、排盘规则不变的情况下,返回结果是固定的,具备幂等性。但风险也很明显,如果后续排盘算法更新,旧缓存数据要能可控失效,不能一直返回脏数据。
最开始只简单接入 Redis 缓存,上线后踩了缓存击穿、Key 设计不合理、客户端没有缓存复用的坑,后面迭代出这套三层缓存方案,优化效果比较明显。
二、整体缓存架构设计
整体链路自上而下:小程序本地 Storage 缓存优先拦截请求,没有命中再走到服务端 Caffeine 本地内存缓存,本地缓存没找到再查询 Redis 分布式缓存。如果三层全部未命中,才执行排盘计算、读取基础字典数据,计算完成之后,把结果回写到各级缓存里。
小程序端缓存主要作用是减少不必要的网络请求,弱网的时候优先展示已有结果,过期时间设置 7 天。服务端 Caffeine 内存缓存用来承接高频热点请求,省去 Redis 网络 IO 开销,过期时间 30 分钟。Redis 作为分布式缓存,多服务实例共享,支撑集群流量,基础过期时间 24 小时。 星曜、庙旺落陷、四化对照表这类静态字典数据单独缓存,有效期更长,修改配置的时候手动清理缓存即可。
三、缓存 Key 规范设计
缓存乱掉,大多是 Key 没有统一规范。我这边统一的 Key 结构:业务前缀:版本号:业务类型:参数md5摘要
zwds 是业务标识,方便后续在 Redis 里批量筛选管理;v1 是排盘规则版本号,后续调整排盘逻辑,直接升级版本号,旧缓存自然失效,不用手动批量删 key;pan 区分排盘主业务和流年、字典等其他缓存;最后把所有入参拼接后做 md5,不直接存放明文生辰,兼顾长度和隐私。
避坑提醒:不要直接把出生时间明文放在缓存 Key 里,一方面 key 会过长,另一方面存在隐私暴露的问题。
四、核心代码思路(Java 后端)
4.1 后端缓存主流程
String rawParams = birth + timezone + gender + version;
String cacheKey = "zwds:" + version + ":pan:" + DigestUtils.md5Hex(rawParams);
// 优先读取本地内存缓存
PanResult localCache = caffeineCache.getIfPresent(cacheKey);
if(localCache != null){
    return localCache;
}
// 本地缓存未命中,查询Redis
String redisJson = redisTemplate.opsForValue().get(cacheKey);
if(redisJson != null){
    PanResult redisResult = JSON.parseObject(redisJson, PanResult.class);
    caffeineCache.put(cacheKey, redisResult);
    return redisResult;
}
// 缓存全部失效,执行排盘计算并回写
PanResult result = ziweiService.calcPan(birth, timezone, gender);
redisTemplate.opsForValue().set(cacheKey, JSON.toJSONString(result), 24, TimeUnit.HOURS);
caffeineCache.put(cacheKey, result);
return result;
4.2 小程序端缓存逻辑
// 小程序侧,生成和后端一致的key,读取本地缓存
const cacheKey = "zwds_pan_" + md5(rawParams);
const cacheData = wx.getStorageSync(cacheKey);
if(cacheData && cacheData.expireTime > Date.now()){
    // 缓存有效,直接渲染页面
    renderPan(cacheData.data);
} else {
    // 发起接口请求,成功后写入storage
    requestPan().then(res=>{
        wx.setStorageSync(cacheKey, {
            data: res,
            expireTime: Date.now() + 7 * 24 * 3600 * 1000
        })
        renderPan(res);
    })
}
小程序本地存储容量有限,额外加了简单的 LRU 清理逻辑,缓存条数超过阈值,自动删掉长时间没有访问的数据,避免占用存储空间。
五、缓存异常防护:击穿、穿透、雪崩
命理小程序很容易出现热点生辰,大量用户同时查询同一个时间,很容易触发缓存击穿。针对热点 key,我采用互斥锁方案,缓存过期瞬间只放行一个请求去计算更新,其余请求等待缓存返回;同时热点 key 增加永不过期兜底策略,后台异步刷新。
缓存穿透问题,处理方式是就算查询的生辰参数不存在、计算结果为空,也写入短时间缓存,避免恶意随机参数持续穿透到计算层。
缓存雪崩的解决办法,是给 TTL 增加随机偏移,在基础过期时间上增加几十分钟随机值,不让大量缓存同一时间集体失效。 如果需要改动排盘规则,优先升级版本号,新请求自动使用全新 key,旧缓存慢慢自然淘汰;紧急清理场景,后台提供接口按前缀批量删除缓存。
六、优化前后效果
优化之前没有缓存,接口平均响应 750ms 左右,长尾 P99 接近 1.3 秒,数据库压力跟着访问量持续上涨,小程序弱网下请求超时率偏高。 上线三层缓存之后,缓存命中场景下平均响应可以控制在 100ms 以内,长尾延迟大幅下降,数据库和计算逻辑的请求量下降八成以上,小程序弱网超时问题改善非常明显。
这套优化最大的收益,就是把重复的 CPU 密集计算拦截在缓存层,只有缓存失效的时候,才会真正执行一次完整排盘。
七、踩坑复盘
最开始上线的时候没有设计版本号,线上调整排盘规则之后,老缓存一直返回旧结果,收到不少用户反馈。小程序缓存没有做淘汰策略,本地缓存越积越多,占用空间。 早期也没有做空值缓存,有人刷随机生辰参数,持续打穿缓存,跑到排盘计算逻辑里。Caffeine 初始化参数配置不合适,热点 key 频繁被淘汰,额外增加很多 Redis 请求。并发请求同一个生辰的时候,没有做请求合并,同一时间多次重复计算,浪费资源。
八、总结与后续方向
紫微斗数这类计算型小程序接口,缓存带来的收益远大于普通 CRUD 业务。核心思路不是盲目堆砌缓存,而是识别幂等、稳定的计算结果,分层拦截流量:客户端挡住大部分重复请求,进程内存减少 Redis 网络开销,Redis 挡住计算和数据库。
后续还可以继续优化:增加相同入参并发请求合并,同一个生辰并发进来只计算一次;针对高频生辰提前做缓存预热;增加监控,持续统计缓存命中率、热点 key 和慢请求。
这套方案通用性很强,八字、择吉这类测算小程序,只要输入确定、输出稳定,都可以直接参考这套分层缓存思路。
性能优化不一定一上来就搭建复杂架构,先判断业务数据能不能缓存,识别热点,控制好缓存失效逻辑,低成本就能拿到很可观的性能提升,也是小程序后端开发里性价比很高的优化手段。