记忆 MCP 最容易让人误判的,不是它没工作,而是它「看起来工作了」。 我曾在同一个会话里让 agent 记住一个测试值,再问它,得到的回答完全正确。但这一步其实什么也证明不了:模型完全可以直接复述我刚才说过的话。
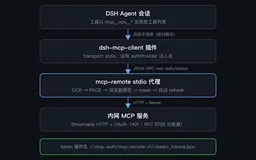
环境:DeepSeek Harness Desktop(通过 Cordis overlay 加载 MCP)、macOS。示例来自官方记忆 MCP 指南,全部依赖第三方服务器。DSH 只负责启动 stdio 子进程或连接 Streamable HTTP 服务、发现工具,并以 mcp__<serverName>__<tool> 的形式暴露工具。
先说清责任边界:存储和提供方特有行为由提供方负责。 DSH 不下载服务器、不初始化数据库、不选 embedding、不建账号、不迁移数据,也不监管独立的 HTTP 服务。HTTP 服务必须提前运行;stdio 子进程则随插件生命周期启动和停止。下面按发现顺序记录我实际踩到的六个坑。
坑一:三个示例默认都关闭
随附的三个组合默认一个也没启用。要使用哪个示例,就传入对应的 overlay:
dsh web --patch "$PWD/apps/cli/config/examples/mcp-memory/mcp-reference-memory.cordis.yml"
先安装固定版本的服务器:
npm install --global @modelcontextprotocol/server-memory@2026.7.4
三个示例的传输方式和默认存储位置各不相同,选择前先确认:
| 示例 | 前置条件 | 默认存储位置 |
|---|---|---|
| Memorix | stdio;Node 22.18+ 和 memorix@1.3.0 |
~/.memorix/data,按 DSH 工作目录识别 Git 项目 |
| MCP Reference Memory | stdio;@modelcontextprotocol/server-memory@2026.7.4 |
$HOME/.dsh-mcp-reference-memory.jsonl,本地知识图谱 |
| Engram | stdio;Go 1.25.10+ 和 v1.20.0 安装方式,或匹配的二进制 |
~/.engram,按 DSH 工作目录识别 Git 项目 |
还有几处容易想当然:Memorix 提供本地启发式模式,不需要模型或 embedding 服务;Reference Memory 存储实体、关系和观察,搜索只对名称、类型和观察做大小写不敏感的子串匹配,没有语义检索、没有 embedding、没有自动摘要、没有冲突解决,也没有遗忘策略;Engram 自己负责存储和项目选择。以上都是文档中对应固定版本的行为,不能推广到其他版本或服务器。
坑二:工具发现是异步的
客户端通过异步方式发现工具。服务启动后立刻发送提示词,很可能早于工具注册完成,于是看到的是「工具不存在」,而不是「服务没起来」。这两种情况的排查方向完全不同:
- 工具一直没出现:检查 overlay 是否生效、服务器是否安装、插件配置是否正确;
- 工具出现了但调用失败:查看服务器自己的输出,确认子进程是否崩溃或正在重连;
- 搜索成功但没有结果:对照写入时实际使用的文件、目录或项目标识。
因此,第一步永远是等 mcp__... 工具出现,再判断记忆是否生效。
坑三:同会话回答正确,是假阳性
这是我花时间最多的一步。正确的验证方式是两个会话、同一存储范围:
- 会话 A:让 agent 记住一个唯一且不敏感的测试值,确认它调用了写入工具并返回成功;
- 在同一运行中的 Host 新建会话 B,不复制会话 A 的对话;
- 在会话 B 要求查询该值,确认它调用了搜索或召回工具,并核对结果;
- 在会话 B 继续问一个需要用到该值的问题,看回答。
这样才能区分「持久召回」和「模型复述当前对话里已有的信息」。新建会话只改变对话历史,不需要重启 Host。
也要留意验证的适用范围:即使这样验证通过,也只证明这个值在当前存储范围下的测试结果,不保证所有后续请求都会使用记忆。指南中的可选模型指令只是行为提示(用户要求记住时写入、历史可能相关时搜索),并不强制调用。
坑四:存储范围会悄悄漂移
两个会话的测试要有效,前提是存储范围不变。如果提供方按工作目录识别项目,而你在两次测试之间换了目录,访问的就不再是同一个库。结果看起来像「写入丢了」,实际是查错了地方。
排查前先记录三项:使用哪个提供方、配置从哪一层生效、数据实际落在哪里。存储位置可以这样覆盖:
| 提供方 | 覆盖方式 |
|---|---|
| Reference Memory | MEMORY_FILE_PATH |
| Memorix | MEMORIX_DATA_DIR |
| Engram | ENGRAM_DATA_DIR、ENGRAM_PROJECT |
改完位置或项目标识后,先用新的测试值重新走一遍写入和读取,再迁移真正的工作流。
坑五:关掉连接 ≠ 删掉数据
这两件事很容易混淆。关闭连接,只是移除 DSH 这一侧的 client:
- 只在命令行传入 overlay:下次启动时省略它即可;
- 已合并进持久 patch:从对应层移除那一条
insert,按需重新加载或重启,其余 patch 保留。
持久位置有两个:profile 级 $DSH_HOME/profiles/<name>/cordis.patch.yml 和机器级 $DSH_HOME/cordis.patch.yml。编辑前先查看已有内容,把目标插入合并进去,不要覆盖整个文件;以后关闭时也只删除那一条。
但数据仍由提供方保存。指南把存储完全交给提供方,没有定义通用删除流程:删除前要查提供方文档,也要检查备份和其他使用同一存储的客户端。一个 DSH profile 停用 overlay,不代表同机其他进程读不到那份存储。
坑六:stdio 桥会剥掉环境变量
stdio 桥在启动子进程前,会移除名称通常表示凭据的环境变量,以及所有 DSH_* 变量。但其他环境变量仍然继承,这不能作为安全保证。
上游密钥应通过配置项 config.env 传入,不要明文写进 YAML:
config:
  env:
    UPSTREAM_API_KEY: ...   # 由环境或密钥管理注入,不写死在文件里
环境过滤可以减少意外泄漏,但不能证明任意服务器代码是安全的。需要检查服务实际接收和持久化了什么。
失败与恢复:崩溃之后会发生什么
MCP 子进程崩溃后,指南描述的处理方式是退避重连并重新同步工具:故障期间调用会失败;重试预算耗尽后,工具会被注销,直到重新加载或重启。
因此,排查「工具消失了」时要区分两种情况:一是插件配置或安装有问题(工具从一开始就不该出现);二是子进程崩溃且重试预算耗尽(工具先出现,后来才消失)。查看服务器输出和崩溃日志,可以区分这两种情况。
我用的验证清单
- 传入 overlay 了吗?服务器安装的是文档中那个固定版本吗?
mcp__...工具出现了吗?(没出现就先别往下走)- 会话 A 写入成功了吗?核对工具返回值,不要只看模型的自然语言回复。
- 会话 B 是新会话,且没有复制前面的对话吗?
- 两次测试的存储范围(文件、目录、项目标识)一致吗?
- 召回失败时,先区分「工具没出现 / 调用失败 / 搜索无结果」这三种情况,再修改配置。
- 数据位置或项目标识改动后,用新的测试值重新跑一遍写入和召回。
- 分开处理关连接和删数据;删除前查提供方文档和备份。
安全边界(这段不能省)
- 示例不代表背书,也不是安全认证。服务、依赖、存储和数据处理方式都要自行评估。
- 首次测试只用唯一且无害的值,不要把真实密钥、私人信息或第三方数据放进测试提示词。
- 工具出现或一次测试成功,都不能证明敏感数据适合存进去;要查第三方的保留和访问策略。
- 团队共享机器上要注意文件权限和同机其他客户端。
- 升级服务器或更换提供方后,安装要求、数据位置和身份选择都要重新确认,再重跑写入和新会话召回。
- 三个提供方的存储方式和检索能力各不相同,一个提供方的结论不能套用到另一个上。
真正决定这套东西能不能用的,不是「它能不能记住」,而是你是否说清楚了存储范围、删除路径和访问权限。记忆一旦写进第三方存储,就从「对话里的一句话」变成了「一份需要治理的数据」。
相关阅读
本文由 DSH Plugin 社区(dsh-plugin.com)维护者撰写,首发于阿里云开发者社区。
文中引用的插件与 MCP 文档收录于:https://dsh-plugin.com/zh/blog