title: 营销链路六道断点
把「金币抵扣」和「秒杀」接进商城后,我把营销链路拆成了六道关
一套多商户商城的高并发营销复盘——真正的难点不是把玩法做出来,是让每一分钱在任何时刻都有同一个答案。
双十一零点前二十分钟,运营在群里甩来一句话:“金币抵扣能不能和店铺满减叠加?叠完再打会员价?”
这句话听着像是在做加法——多上一个玩法。真正落到代码里,它全是减法:每一个叠加位都必须有唯一确定的答案,而且这个答案在任何时刻、任何一个节点重算,都得一模一样。
我们这套多商户商城(下面叫 GMall)跑了三年,玩法是一年年长出来的:先有满减,再上单品券,去年加了金币抵扣,今年加秒杀。每加一个,支付前就多一层 if、多一次四舍五入、多一场“这个字段到底按哪个金额算”的争论。
零点过后四十分钟,客诉群进来 37 条消息,全是一句话:“结算页 89,支付页 125,你们到底按哪个收钱?”
那一晚之后,我把营销链路整个拆开重做了一遍。下面六道关按修复顺序排,不按重要性——因为第一道不过,后面五道根本测不出来。
| 六道关 | |
|---|---|
| 01 | 优惠不是加法,是一次「基数固化」的求值 |
| 02 | 库存:预扣不是扣减,是占用 |
| 03 | 幂等:别建“去重表”,建状态机 |
| 04 | 削峰:漏斗不是限流,是把请求换成令牌 |
| 05 | 分布式锁,多数人锁错了对象 |
| 06 | 金币不是“余额字段”,是复式流水 |
01 优惠不是加法,是一次「基数固化」的求值
现场。 同一笔订单,商品原价 199 元;店铺满减“满 199 减 30”;单品券 20 元;金币余额 60 元,规则原文写的是“单笔最多抵扣当前应付金额的 30%”。
运营的理解是:能叠加,就都给我叠上。代码的理解是:谁先执行谁占便宜。
| 执行顺序 | 计算过程 | 实付 |
|---|---|---|
| 顺序甲 | 券先:199−20=179,未达门槛,满减不触发;金币封顶 179×30%=53.70 | 125.30 |
| 顺序乙 | 满减先:199−30=169,再减券 20=149;金币封顶 149×30%=44.70 | 104.30 |
同一单,差 21.00 元。这 21 元不是谁多赚了,是两种实现都自认为正确。
很多人第一反应是“顺序影响结果,因为加减法有结合律问题”——这个判断是错的。纯加减、纯比例运算在数学上完全可交换,你把 199 减 30 再减 20,和先减 20 再减 30,结果必然是 149。
真正的差异来自两处基数依赖:
- 满减的门槛用“当前应付”判定。券先把金额打到 179,门槛直接掉了。
- 金币的封顶用“当前应付”算比例。金额每少一块,封顶就跟着缩一截。
只要规则里有任何一个判断依赖“变动中的中间金额”,顺序就从实现细节升级成了业务规则。而这恰恰是最危险的地方:业务规则本该写在需求文档里,却被写进了代码的书写顺序。
做法只有一个:把每一处基数写成显式声明,而不是让它隐式地去取“当前值”。
规则节点只允许四个维度:类型、作用域、基数、互斥组。基数只有三个合法值——原价、单品优惠后、订单优惠后。门槛判定、封顶计算,全部读自己声明的那个基数,一律不许读中间变量。
type Rule struct {

    ID    string
    Kind  RuleKind   // 规则类型
    Scope Scope      // SKU/ORDER
    Base  BaseKind   // 基数声明 ← 关键
    Group string     // 互斥组
    Cap   CapRule    // 封顶规则
}

// 每轮都从声明的基数重取,不在中间量上判断
func (e *Eng) Run(
    o *Ord, rs []R) int64 {

    var tr []T
    pay := o.Origin
    for _, r := range byPriority(rs) {

        base := pickBase(r.Base, o, pay)
        if !r.Match(base, o) {

            continue
        }
        amt := r.Amount(base) // 封顶同基数
        if amt > pay {

            amt = pay
        }
        pay -= amt
        add := T{
   r.ID, base, amt, pay}
        tr = append(tr, add)
    }
    return pay
}
金额一律用 int64 存分,四舍五入只在最后一步做一次。这一条单独拿出来讲,是因为“分”能消除 99% 的“差一分钱”客诉——而差一分钱的客诉,和差二十块的客诉,处理成本是一样的。
改完之后,门槛与封顶都钉死在原价 199:199−30−20=149,封顶 199×30%=59.70,60 元金币抵掉 59.70,实付 89.30。把六个节点怎么排列组合,结果恒为 89.30。
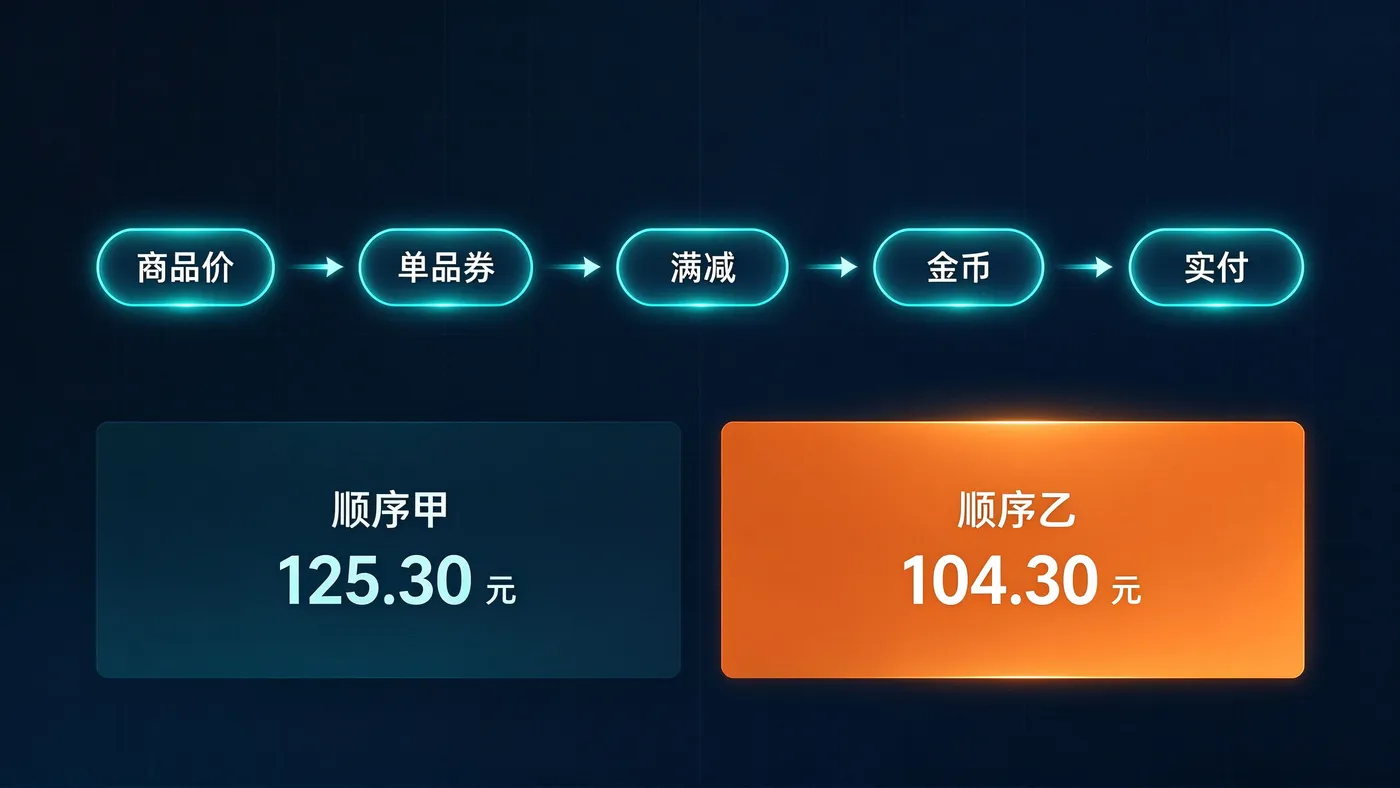
图注:顺序甲 125.30 与顺序乙 104.30 的 21 元差额,根因不是“排序”,而是门槛与封顶两处基数依赖被中间金额带着跑。
代价: 每个节点都要落一条 trace,一单 3~8 条明细。库表多了一张,写入多了一次,换来的是任何一单都能逐条回放——后来做“下单前试算”“客诉自助查询”,全是吃这套明细的剩饭。
02 库存:预扣不是扣减,是占用
现场。 一场 800 件的秒杀,最后卖出 812 件。多出来的 12 单,是退款扯皮、差评和一次平台投诉。
查下来不是“两个用户同时抢到最后一件”这么简单——是支付超时的库存没回收、缓存与库的差额没人管、以及预扣和释放用了两套不同的判断逻辑。
先说三种实现方案,这是我们同一台机器上压出来的实测结果:
| 方案 | 一致性 | 实测吞吐 | 主要代价 |
|---|---|---|---|
数据库行锁 SELECT … FOR UPDATE |
强一致 | ≈1.2k QPS,热点行 P99 1.2s | 连接池被打满,一个 SKU 就能卡死整个下单入口 |
乐观锁 version / CAS |
不超卖 | ≈3k QPS,重试率 38% | 重试风暴、CPU 空转,用户侧表现为“点了没反应” |
| Redis Lua 预扣 + 异步落库 | 最终一致 | ≈10w QPS | 缓存与库的差额必须有人兜底,否则就是那 12 单 |
预扣的本质不是“扣减”,是**“占用”**。库存不是一个数字,是三个状态。
available 可售、locked 已占用未支付、sold 已成交。
- 下单:available−1、locked+1,一次 Lua 原子完成
- 支付回调:locked−1、sold+1
- 超时未支付:locked−1、available+1
-- KEYS[1] avail / KEYS[2] locked
-- ARGV[1] 本次占用数量
local a = redis.call('GET', KEYS[1])
a = tonumber(a or '-1')
if a < tonumber(ARGV[1]) then
    return -1            -- 不足,不占用
end
redis.call('DECRBY', KEYS[1], ARGV[1])
redis.call('INCRBY', KEYS[2], ARGV[1])
return 1
这里有个细节值得单独说:脚本里没有“先 get 再 set”。判断和扣减必须在同一次 Lua 执行里,否则你等于把数据库的行锁原封不动搬到了 Redis,只是换了个更贵的地方排队。
预扣方案上线第一周,就撞上两件事:
- 释放路径最容易漏。 延迟消息丢了一条,locked 就永远挂在那儿,库存“假死”。所以必须有一条兜底巡检:locked 超过 15 分钟、且查不到对应支付单的,批量回补——回补本身也走同一套幂等状态机,不许裸写。
- 单 key 热点。 800 件库存放在一个 key 上,10 万 QPS 全砸进同一个 slot。后来拆成 8 个分片,请求随机选片扣减,展示时跨片聚合——这才是“削峰”真正生效的地方,而不是在网关加个限流就算完。
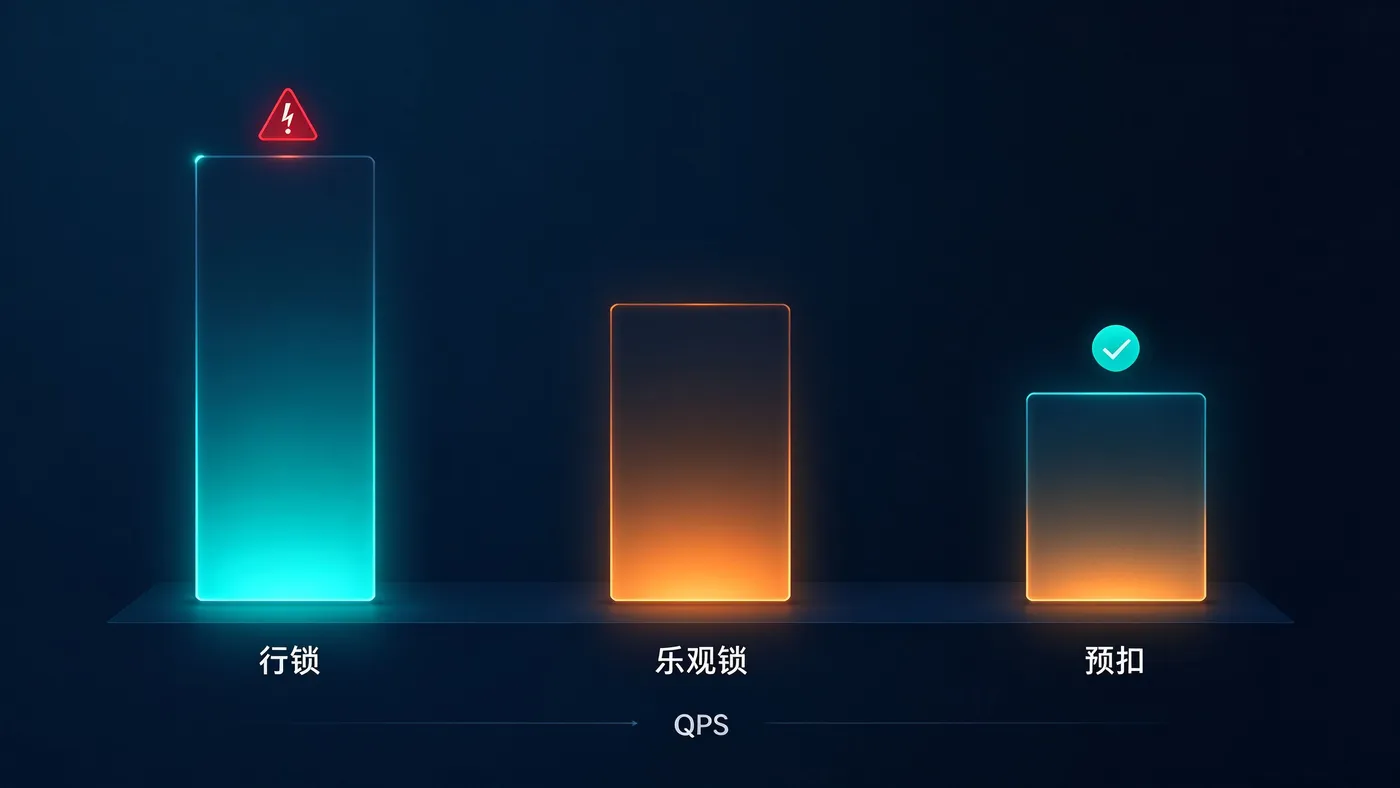
图注:三种方案不是“先进与落后”的关系:行锁赢在简单可控,乐观锁赢在不阻塞,预扣赢在吞吐,代价是把一致性挪到了对账环节。
代价: 最终一致意味着你必须接受“存在短暂差额”这个事实,然后把差额变成可观测指标(预扣数 vs 落库数,每分钟比对一次),而不是假装它不存在。
03 幂等:别建“去重表”,建状态机
现场。 支付网关回调重试了三次,同一个 out_trade_no 进来三次,用户手里多了三张券。
翻代码,第一行写的是“先查有没有,没有就插入”——看起来天衣无缝。
“先查再插”错在哪?查和写不是一个原子操作。两个并发请求同时到,两条 SELECT 都查不到,然后两条 INSERT 都往下走。你以为是“防重”,实际只是“降低概率”。
那就加唯一索引?唯一索引能兜住“重复插入”,兜不住“重复执行”。券已经发出去了,订单状态还没落库;重试再来一次,记录不冲突——因为券在另一张表。这类“部分成功”才是最贵的 bug:它不报错,它只是多发一张券。
幂等不是“防止重复的数据”,是判断**“这次执行有没有权力改变状态”**。
做法是把动作做成状态机的一次迁移,用条件更新抢执行权:
UPDATE t_order SET status = 'PAID'
 WHERE order_no = ? AND status = 'INIT';

-- rows = 1  抢到执行权,继续发券
-- rows = 0  已被执行过,返回成功
这里有一个反直觉的点:**重复请求要返回“成功”,不是“已处理”也不该是“失败”。**因为调用方看到失败就会继续重试,重试会继续打进来,链路永远断不掉。返回成功,这次重复才算真正被消化掉了。
幂等键的选择同样有讲究:用业务唯一键 + 动作类型,不要用“随机 UUID + 时间窗”。前者天然收敛——同一笔业务永远算出同一个键;后者要靠时间去猜,窗口一大就重,窗口一小就漏。
CREATE TABLE order_action (
  id BIGINT PRIMARY KEY AUTO_INCREMENT,
  biz_no VARCHAR(64) NOT NULL,
  action VARCHAR(32) NOT NULL,   -- COUPON/GOLD
  from_status VARCHAR(16) NOT NULL,
  to_status VARCHAR(16) NOT NULL,
  created_at DATETIME NOT NULL,
  UNIQUE (biz_no, action)
);
状态机的条件更新 + 动作表的唯一索引,是两层护栏:前者保证“同一时刻只有一个执行者”,后者保证“同一动作一辈子只留一条痕”。只有一层的时候,我们都出过事。
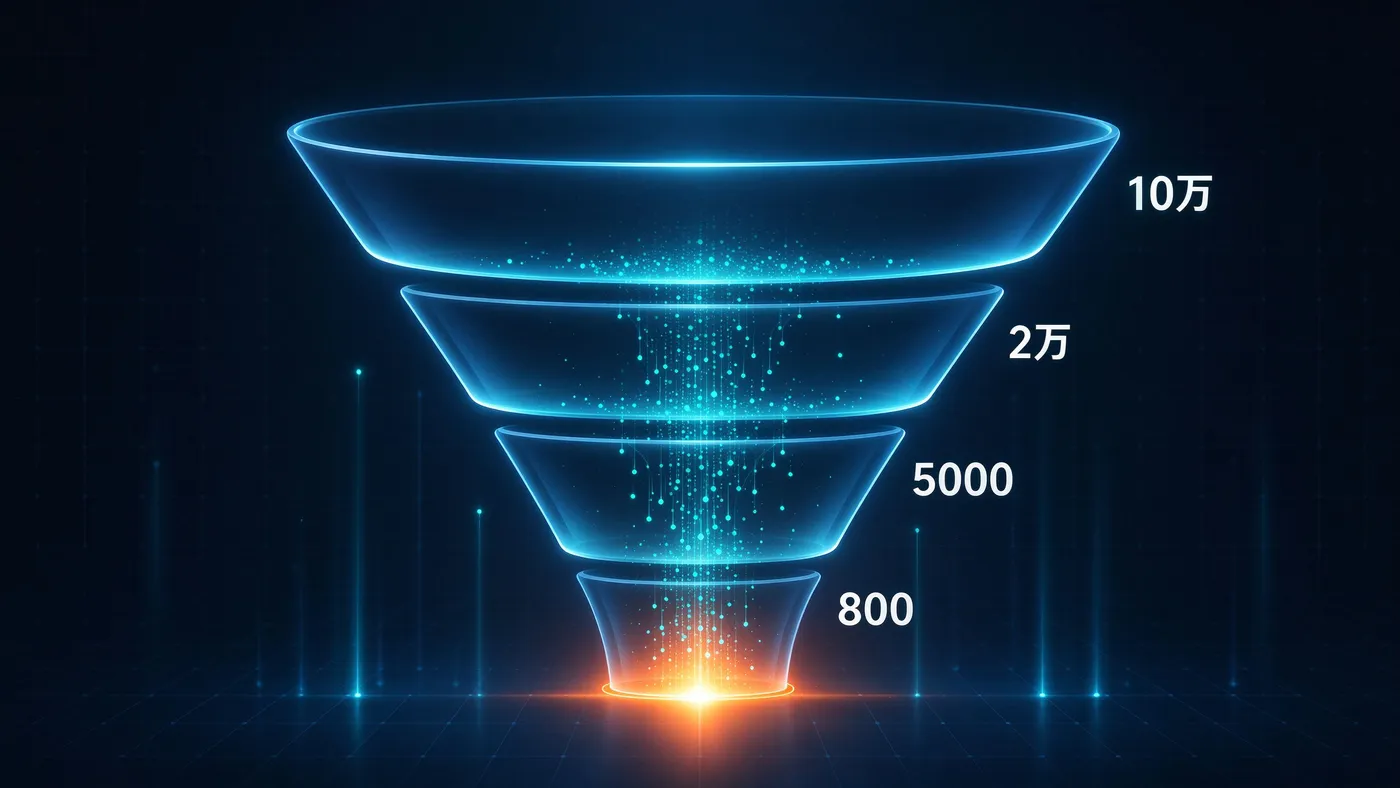
图注:重复请求不是“错误”,是“一次不成立的迁移”。状态机把重复变成了无操作,而不是变成异常——这是它能扛住回调重试的原因。
代价: 状态机一旦设计错,比没设计更难改——因为存量数据的状态分布是乱的。所以状态要少、迁移要单向、每个迁移都要能在代码里被 grep 到。
04 削峰:漏斗不是限流,是把请求换成令牌
现场。 秒杀开场第 3 秒,网关 429 冲到 40%,前端只有一个转圈,用户不知道自己在排队、还是在被拒绝。
我们最后做的是一条四层漏斗,每层的职责完全不同,不是同一种“限流”换个位置重刷:
| 层 | 量级 | 手段 | 真实作用 |
|---|---|---|---|
| 前端 | 10 万 → 约 3 万 | 按钮置灰、本地时间校验、单次提交锁 | 砍掉“自己都不知道自己在抢”的重复点击,成本几乎为零 |
| 网关 | 3 万 → 2 万 | 按实例维度下发令牌桶 | 过载保护;全局桶会让所有实例去抢同一个 key,自己先成瓶颈 |
| 排队 | 2 万 → 5000 | 发票:Redis 队号 + 前端轮询 | 把“并发请求”变成“可预期延迟”,同时留下票根便于定位 |
| 落单 | 5000 → 800 | 消费端按数据库写入能力定速 | 这个数是压出来的,不是拍的——它是整条链路唯一的地板 |
限流是“拒绝”,排队是“延迟”。用户看到“第 3821 位,预计 8 秒”,比看到一个 502 好太多。
排队还白送了一个能力:每个请求都有票根。出问题的时候,能精确说清是谁、在第几步断的、断在哪一层。这个可观测性,比省下来的那点机器钱值钱。
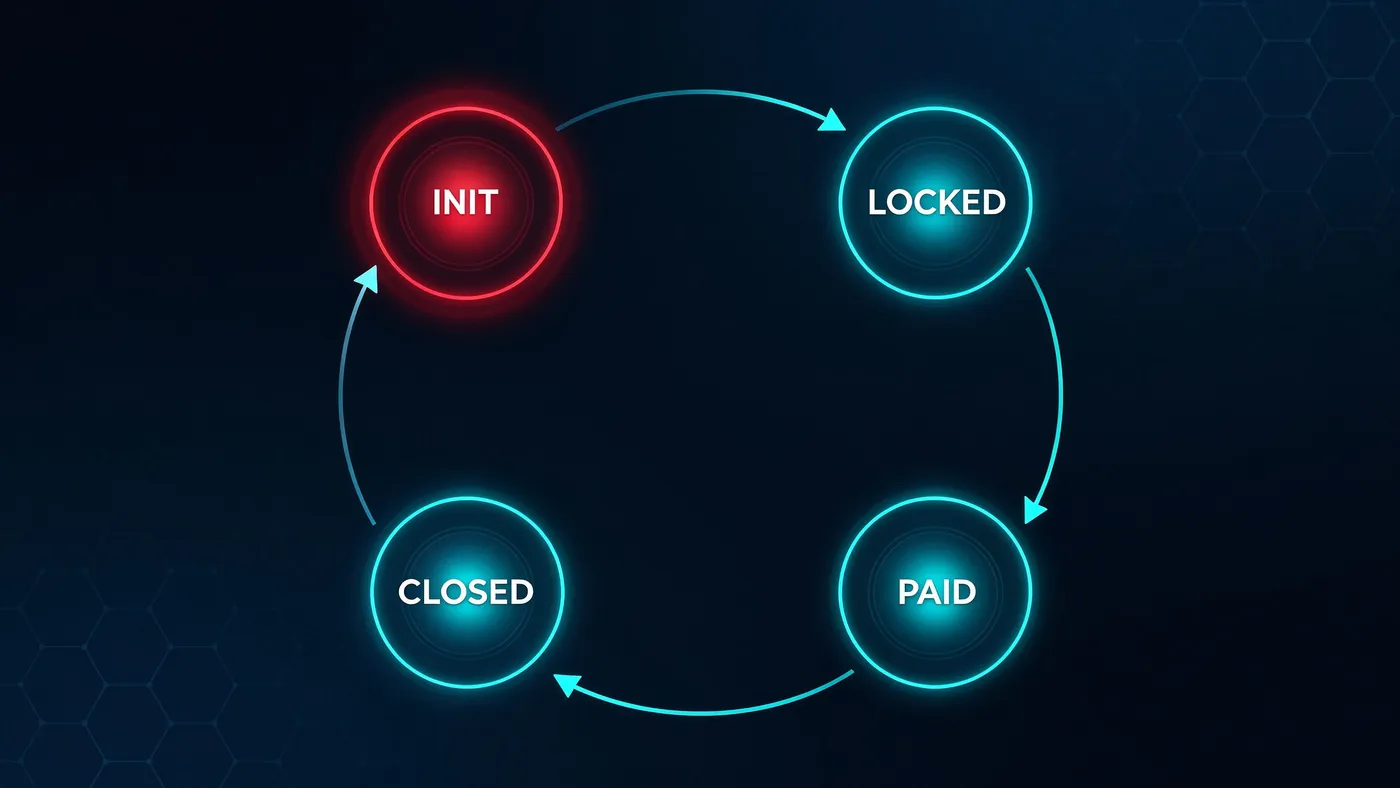
图注:四层漏斗的关键不是把数字压小,而是每一层都以“下一层真实能承受的量”为设计目标。
代价也很实在:**排队是有状态的。**Redis 挂了,整条链路一起废。所以必须留降级路径——Redis 不可用时直接放开名额,靠库存预扣兜底。宁可让用户抢失败一次,也不能让整个下单入口 502。
还有 MQ 积压这个老问题。积压的时候不要第一反应就扩消费者,先分优先级:下单 > 发券 > 发通知。发券可以迟到十分钟,下单不行。拆成两条 topic 物理隔离,积压时只扩下单那条,其余照常慢跑。
代价: 四层漏斗意味着四套配置、四个监控、四种失败模式。压测时必须逐层单独压——一起压出来的数字,永远说不清是哪一层先塌的。
05 分布式锁,多数人锁错了对象
现场。 最初锁的是 sku_id。结果同一个 SKU 的不同用户互相阻塞,吞吐被打穿;还出现了“等锁超时 → 判失败 → 用户重复提交 → 重复进入排队”的连环。
锁的粒度不是“资源”,是**“状态变更的最小不可分单元”**。这两个东西经常长得不一样:
- 锁 sku_1001:保护的是“这份库存”,所有买它的人都要排队。
- 锁 order_202611110001:保护的是“这一单的状态迁移”,只有同一单的并发被串起来。
绝大多数业务要的是后者。前者本来就该交给原子操作解决,而不是交给一把锁。
优先级从高到低:条件更新 > 原子操作 > 悲观锁 > 分布式锁。能不用锁就不用。
Redlock 的争议必须正视:主从异步复制下,主节点写入锁之后挂掉、从节点还没同步就升主,两个客户端会同时持锁。所以凡是“资金、券、库存最终数量”这种必须互斥的场景,Redis 锁只能用来减少冲突,不能用来提供保证。最后一关永远是数据库的唯一约束或条件更新。
判断一把锁靠不靠谱,只问三个问题:粒度多大、持有多久、失效之后谁收拾残局。第三问最容易被跳过,而它恰恰是最脏的一种失败——业务没跑完锁就过期了,两个执行者同时在改同一份数据,日志里什么线索都没有。
代价: 锁内要短到可预期,否则就得加“续期 + 业务侧状态校验”双保险。而这两样一加,锁的复杂度就接近去重表了——于是又回到那句话:先想清楚这地方到底需不需要锁。
06 金币不是“余额字段”,是复式流水
现场。 用户说少了 200 金币,客服查了四十分钟,查不到是哪一笔。因为余额是 UPDATE 覆盖写的,历史已经被覆盖掉了——系统“记得现在有多少”,但“说不清怎么变成这么多的”。
任何余额都必须是派生值,真相只存在于 append-only 的流水里。这不是财务洁癖,是排障能力:余额字段能回答“多少”,流水才能回答“为什么”。
- 每一笔业务写两条分录:用户侧(−)与平台池侧(+),借贷相等
- 余额 = 流水汇总,或者“定期快照 + 快照后增量”,而不是独立维护的数字
- 每条流水必须带 source(活动 ID / 订单号),从结构上杜绝“无源金币”
CREATE TABLE gold_entry (
  id BIGINT PRIMARY KEY AUTO_INCREMENT,
  account_id BIGINT NOT NULL,
  direction TINYINT NOT NULL,   -- 1 / -1
  amount BIGINT NOT NULL,       -- 分,恒正
  biz_no VARCHAR(64) NOT NULL,
  source VARCHAR(64) NOT NULL,  -- 活动/订单
  created_at DATETIME NOT NULL,
  UNIQUE (biz_no, account_id, direction)
);
对账按三步走,第三步才是真正天天在用的:
- **算差:**流水汇总 vs 快照余额,diff 不为 0 才往下走
- **定位:**用 biz_no 命中唯一索引,找到那一笔是缺了还是重了
- **分级:**可重放的(补一条分录)自动修;不可重放的(历史被覆盖写毁掉的)进人工队列
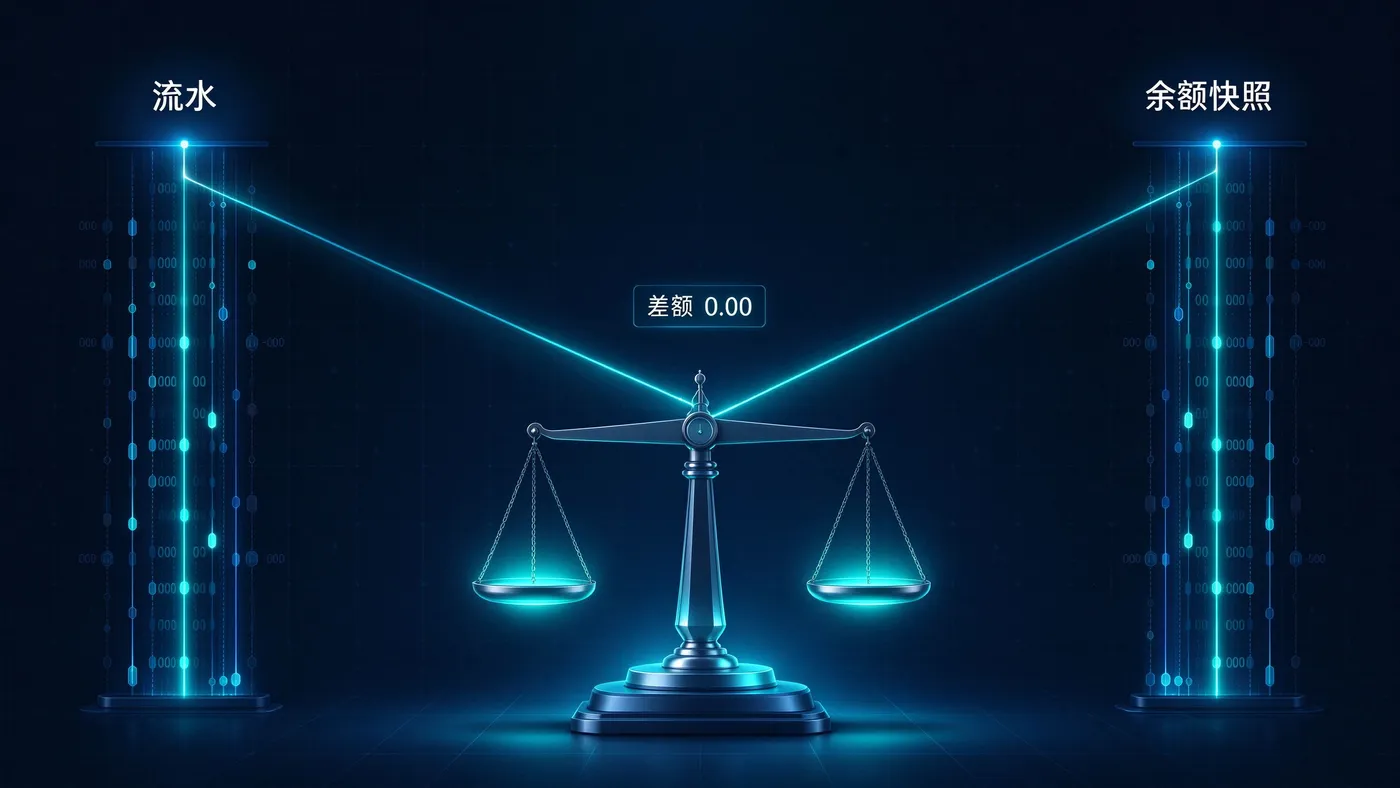
图注:天平的两端不是“流水”和“余额”,是“流水汇总”和“快照”。差额为 0 只说明这一刻对上了,不代表结构是对的。
实测:日流水 12 万条,日终对账 3 分钟跑完,上线三个月累计发现 7 笔差异,全部可重放修复。这个数字不大,但它证明了一件事——
账本的价值不是“不出错”,是**“出错时能说清是哪一笔”**。
代价: 流水表只增不改,一年就是几千万行。必须有按月分表或冷热分离,否则对账脚本自己会变成新的性能问题。
六道关做完,营销链路从“加一个玩法改一处 if”,变成了“加一个玩法配一条规则、加一条监控、加一条对账”。真正的收益不在吞吐,也不在那些 QPS 数字上,而在于可解释:任意一单,三秒内能回答“这个价格是怎么来的”。
营销玩法本身从来不难,一个满减、一张券、一次金币抵扣,谁都能写。难的是当它和并发、资金、合规同时压下来的时候,你还能对每一分钱给出同一个答案。
系统被信任,不是因为跑得快,而是因为每次都给同一个答案。
你被哪一类客诉追过?“同一单两个价格”,还是“库存卖超了”?
评论区说说你的场景,我按类型整理一份排查清单——从第一层界面到最后一层对账,每一层该看什么指标、该查哪张表。
#高并发营销 #秒杀 #库存一致性 #幂等设计 #分布式锁 #复式记账 #电商架构