服务器出事先知道:云监控告警配置清单,15分钟配完
一、前言
服务器出事最坏的情况不是宕机,而是宕机了你不知道:用户在群里骂了半天,你才发现网站打不开;磁盘满了三天,日志一直写不进去,业务悄悄丢数据。大部分个人开发者和小团队都没有专职运维,云监控的告警就是你的 24 小时值班员。这篇是一份 15 分钟能配完的告警清单,都是性价比最高的几项。
二、必配的五个告警
- CPU 使用率:连续 5 分钟超过 85% 告警。突然拉高通常是流量异常、程序死循环或被植入挖矿程序的信号;
- 内存使用率:超过 90% 告警。Linux 的内存缓存机制导致常态占用偏高,阈值别设太低,重点看持续增长不回落;
- 磁盘使用率:超过 85% 告警。磁盘满是最常见的"无声故障"——日志写不进、数据库崩、服务假死,全在这一步;
- 公网带宽/流量:设置带宽峰值告警。异常流量可能意味着被刷、被爬或带宽配额打满导致网站变慢;
- 站点拨测:云监控支持从外部探测你的 URL,站点 HTTP 响应异常立即告警。这一条最直接——前面都是机器指标,这条是"用户视角网站是否活着"。
三、告警通知怎么配才有效
配了规则但没人收到通知,等于没配。三个要点:
- 通知渠道选最快的:云监控支持短信、邮件、钉钉机器人、微信等。个人开发者建议钉钉/企业微信群机器人——免费、即时、可群内协作认领;
- 静默期要设置:同一告警 5 分钟内不重复发,防止故障期间被几百条短信轰炸,反而麻木;
- 分级通知:磁盘 85% 是提醒(群通知即可),站点不可访问是致命(必须能叫醒你,加短信或电话渠道)。
四、进阶:日志服务的三件小事
指标告警覆盖不了"应用内部"的问题,日志侧建议做三件事:
- 错误日志关键字告警:如 OOM、Exception、connection refused 等关键字触发通知;
- 采集 Nginx 访问日志:5xx 状态码比例突增告警,比等用户投诉早半小时;
- 保留期规划:日志保留 7~30 天足够排查用,太长只会涨存储费。
五、常见问题
Q:免费版云监控够用吗?
A:基础指标与短信/邮件告警免费额度内基本够个人和小团队用,日志分析与高级功能按量付费。
Q:告警太多变"狼来了"怎么办?
A:按历史数据调整阈值——比如 CPU 峰值常态 60%,就设 80% 而不是 70%。告警规则要随业务长大不断校准。
Q:深夜告警怎么办?
A:低危告警进群第二天处理;致命告警(站点不可达、磁盘满)值得被叫醒——这正是告警存在的意义。
六、总结
监控告警是云上性价比最高的保险:15 分钟配置,换的是故障从"用户告知"变成"你先知道"。五个必配指标(CPU、内存、磁盘、带宽、拨测)加一条靠谱的通知链路,今天就能配完。记住一个原则:告警不是为了收到消息,而是为了驱动动作——每条告警背后应该有对应的处理预案。
活动直达地址:阿里云千问AI双11主会场|云监控|云服务器 ECS
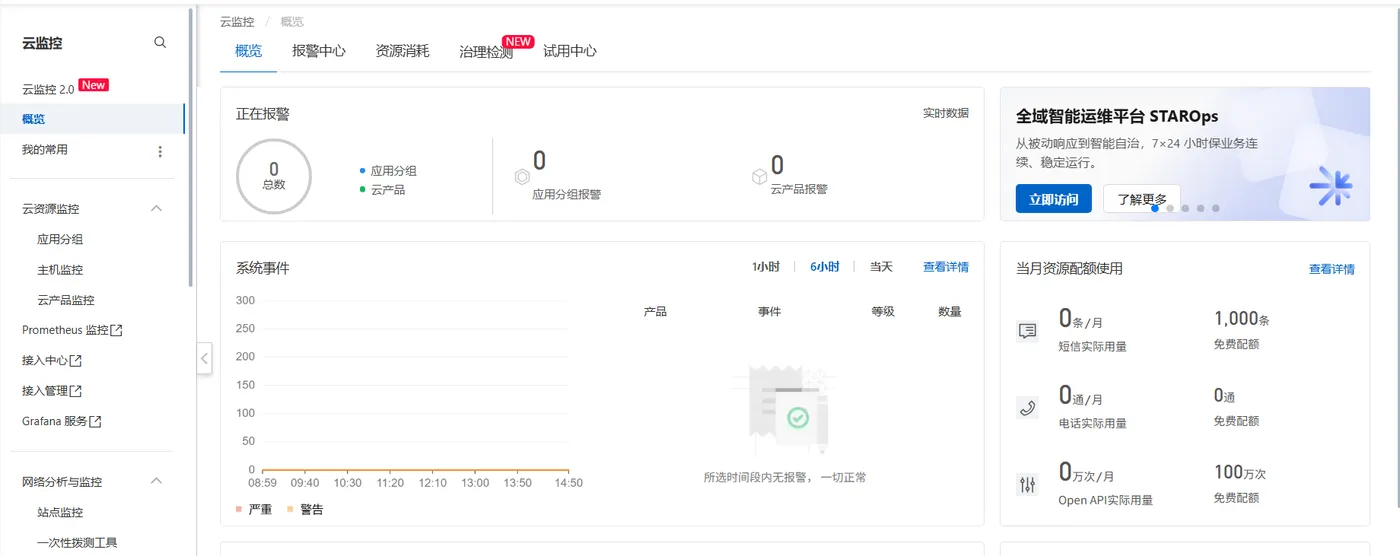
打开链接后登录阿里云账号,在云监控控制台配置告警规则与通知方式,功能与计费以产品页实时展示为准。