本文是《AI工程师踩坑实录》系列第 5 篇。训练启动后完全不动、CPU 占用归零、日志停在最后一条打印,一点报错都没有——这一篇把这个「沉默卡死」完整复现给你看,根因在 Windows 和 Linux 启动子进程的方式差异上。所有截图来自本机真实运行。
本篇配套的三个复现脚本(卡死版、修复版、机制演示版)放在了公Z号。
先描述一下这个坑的现场,看你是否眼熟。
训练脚本启动,进度条出来一格,然后就没有然后了。CPU 占用是 0,显卡安安静静,日志停在最后一条 print,你等了十分钟,它还在第一步装死。
没有任何报错。Ctrl+C 想中断,它还未必理你。
这种情况十有八九落在 DataLoader 的多进程加载上,而且 Windows 用户中招率远高于 Linux。今天把它在本机完整复现一遍,根因、修法、防御姿势一次讲清。
一、先看崩溃现场
一个最小复现脚本,模块顶层直接创建 DataLoader,开 2 个 worker,然后迭代。注意,代码里没有 if name == "main"。
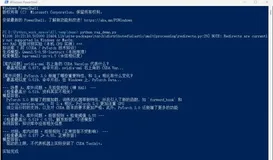
跑起来之后发生了什么。第一,开头的打印语句出现了三遍(主进程一遍,两个 worker 各一遍,这个现象后面细讲)。第二,进程卡住大约二十五秒。第三,崩了,报错原文贴出来。
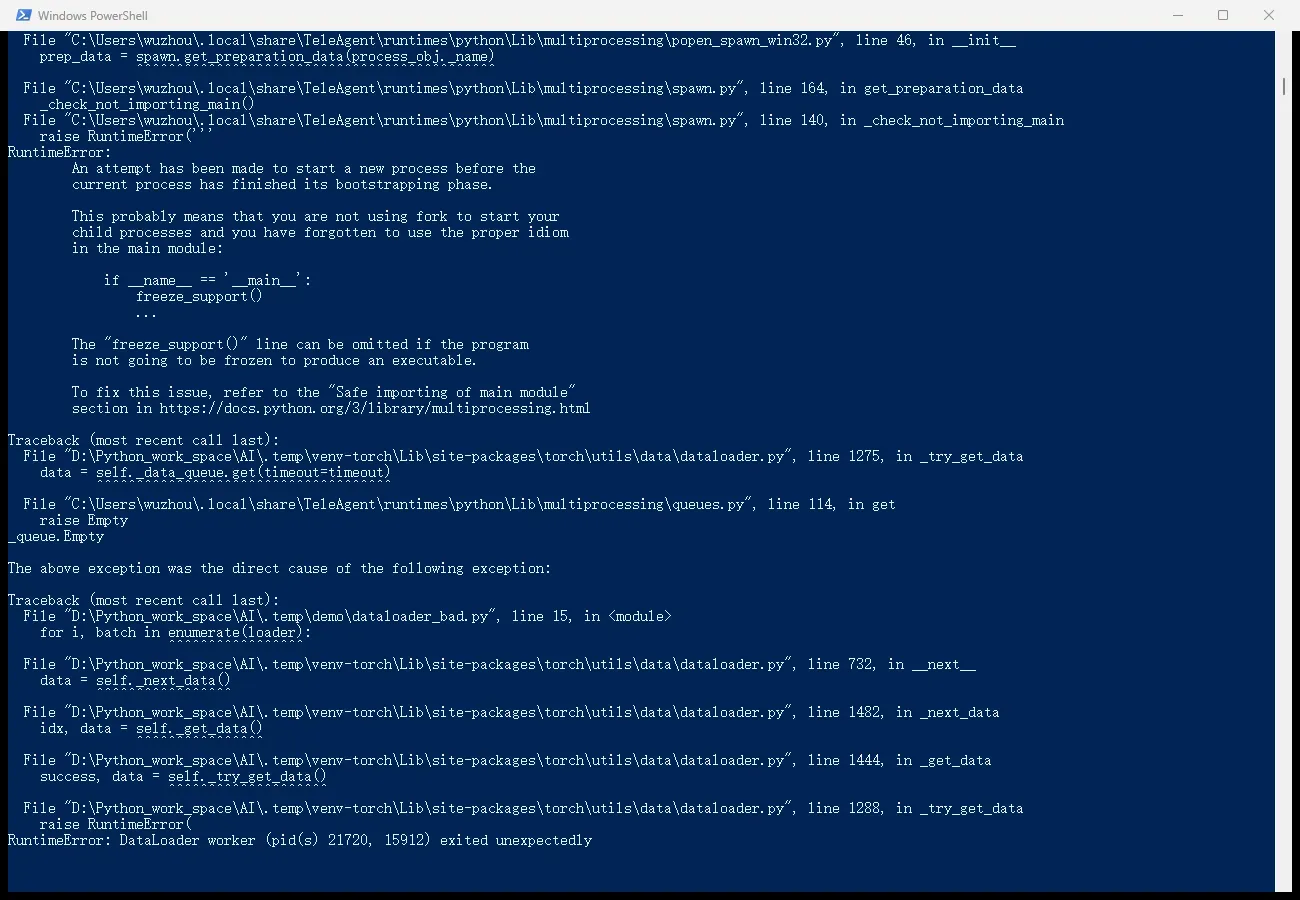
两层报错。底层是 Python 官方的提示,翻译过来是,你试图在当前进程还没完成引导阶段时启动新进程,你可能忘了在主模块里使用正确的写法,正确的写法就写在报错里,if name == 'main'。上层是 PyTorch 的 RuntimeError,DataLoader worker exited unexpectedly。
报错自己把答案写出来了,这是这个坑温柔的地方。坑人的地方在于,卡住的那几十秒里它一言不发,很多人在等待阶段就断定「是显卡没跑起来」,然后掉头去查 CUDA 环境,一路查到怀疑人生。
二、根因:Windows 生孩子的方式和 Linux 不一样
要讲清楚根因,得先说两个操作系统的差异。
Linux 创建子进程用 fork,爹进程把自己复制一份,复制出来的孩子直接接着干活,不重新执行你的代码文件。
Windows 不支持 fork,用的是 spawn。spawn 是重新启动一个全新的 Python 解释器,然后把它当成你的模块重新 import 一遍。
重点来了。import 一遍,意味着你模块顶层的所有代码会被再执行一遍。
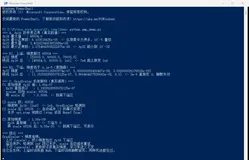
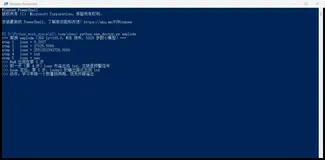
我在本机用一个十行的脚本把这个机制直接演示出来。顶层放一个 print,然后用多进程启动一个子进程。
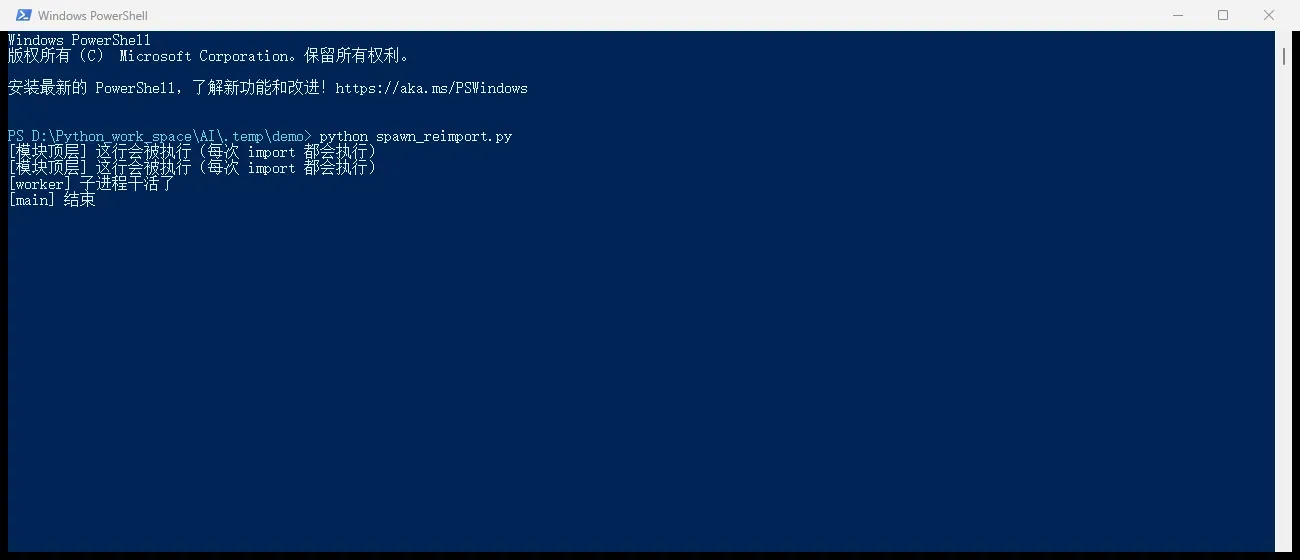
看输出,「这行会被执行」打印了两次。主进程一次,子进程 import 模块时又一次。这就是 spawn 的行为。
现在把这个机制套回 DataLoader。你在模块顶层创建 DataLoader 并开 worker,worker 进程 spawn 启动,import 你的主模块,顶层的 DataLoader 创建代码又执行了一遍,又要开 worker,又要 import……子子孙孙无穷匮也。Python 官方检测到了这种危险递归,直接把 worker 拦下来崩掉,这就是你看到的崩溃。而在拦截生效之前的那段时间,就是卡死。
Linux 上同一份代码为什么跑得好好的?fork 不重新 import 模块,顶层代码只执行一次,递归根本不会发生。同一份代码,换个操作系统就变坑,这是它迷惑性的来源。
三、修复,一个结构搞定所有平台
把「要被子进程执行的入口」放进 guard 里,模块顶层只留函数和常量定义。
def main():
    loader = DataLoader(ds, batch_size=16, num_workers=2)
    for batch in loader:
        ...

if __name__ == "__main__":
    main()
原理一句话。spawn 的子进程 import 你的模块时,name 不是 "main",guard 里的代码不会执行,递归链条被掐断。fork 的 Linux 下这个 guard 无任何副作用,一份代码全平台通用。
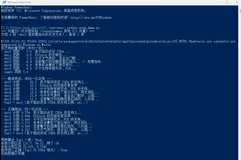
修复后的真实输出。
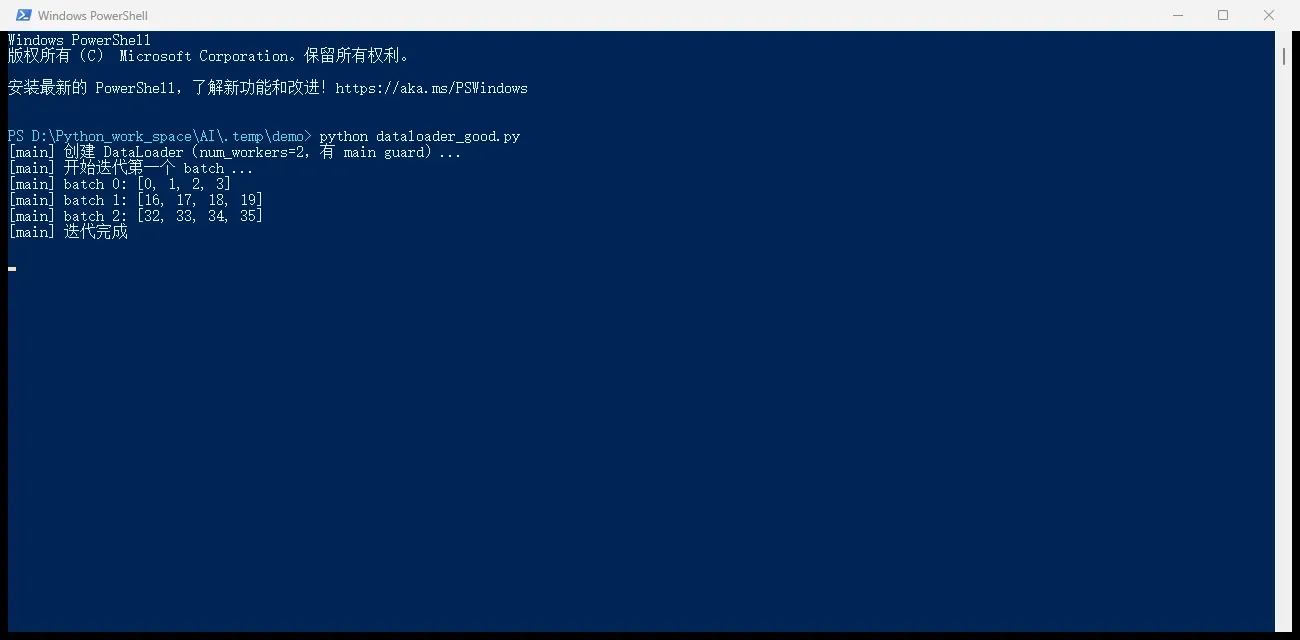
打印只出现一遍,三个 batch 顺序出来,迭代正常完成。同一份数据、同一个 DataLoader、同样的 num_workers=2,区别只有那两行结构。
四、三问定位法,遇到卡死先过一遍
把这个坑的排查浓缩成三个问题,按顺序问自己。
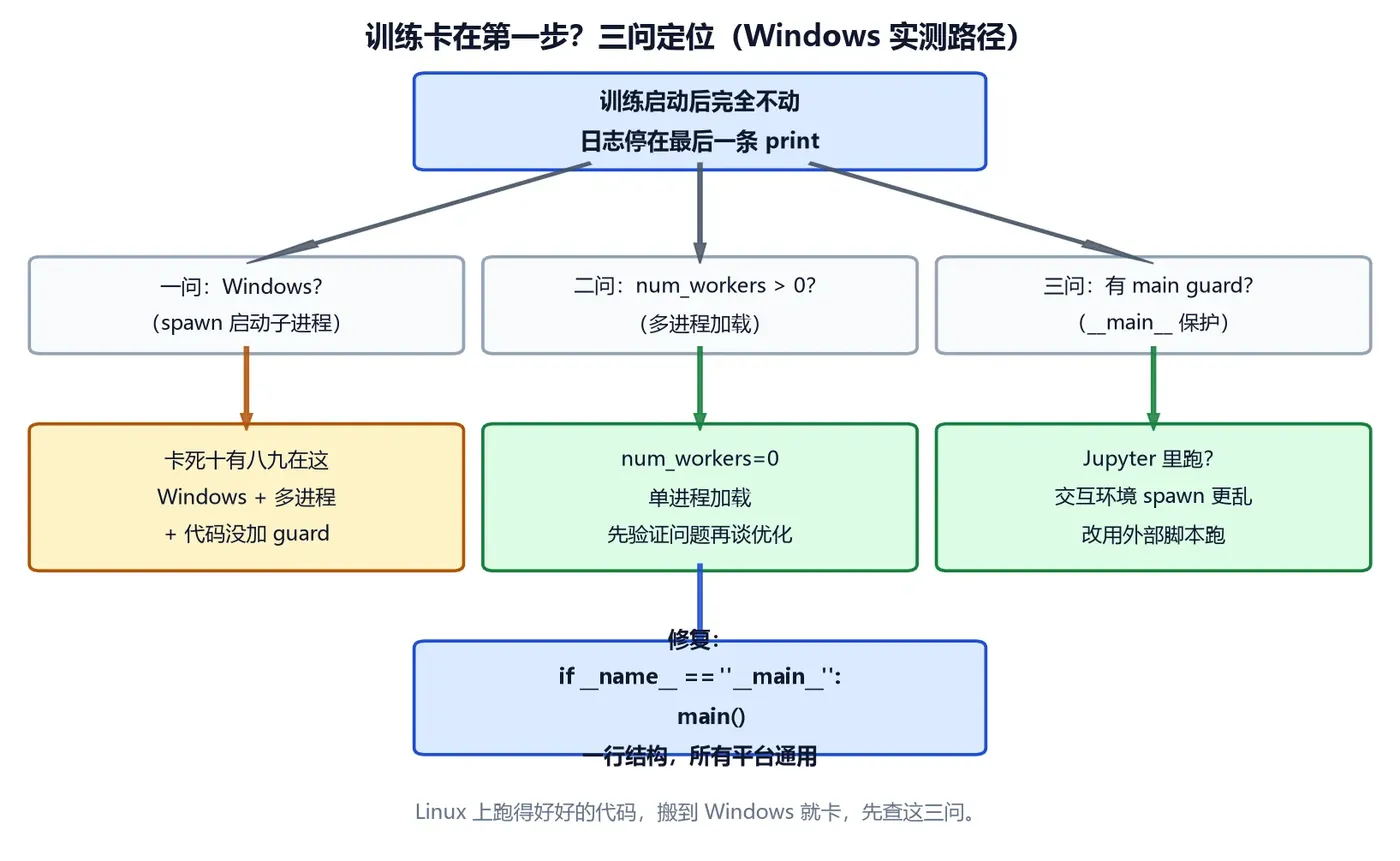
一问,是不是 Windows?spawn 的地盘。二问,num_workers 是不是大于 0?多进程才会触发。三问,入口有没有 main guard?三问全是,卡死原因基本锁定。
另外两个实用招。卡死时先把 num_workers 设成 0 跑一遍,能跑通就坐实了多进程问题,这是最快的验证法。在 Jupyter 里跑的,建议改用外部脚本,交互式环境里 spawn 的行为更乱,还叠加了 IPython 自身的进程管理。
五、常见问题 3 连
1. num_workers 到底该设多少?
经验公式是 CPU 逻辑核数的一半到一倍,6 核 12 线程的本子设 4 到 8 都合理。但注意 num_workers 是拿内存换速度,每个 worker 都要复制一份数据集对象,大图像数据集上开太狠会先撞内存墙。从 2 开始往上加,看吞吐增量再定。
2. 加了 guard 还是卡,还有什么可能?
按我实际遇到的概率排。数据集对象里嵌了不可序列化的东西(数据库连接、图窗口),spawn 传不过去。dataset 的 getitem 里写了加锁操作或者打开了太多文件句柄。还有 persistent_workers 配合迭代器重用时状态没复位。这类问题的共性是 num_workers=0 都能跑,一开多进程就死,可以据此快速二分。
3. Linux 服务器上永远不会遇到这个问题吗?
guard 这关不会卡,但 fork 也有自己的坑,比如 fork 后线程锁状态被复制导致死锁,CUDA 多进程在 fork 模式下会直接报错。所以业界共识是无论哪个平台,训练脚本一律写 guard,顺手的事,能免掉一大类环境差异坑。
六、本篇小结
- Windows 用 spawn 造子进程,会重新 import 你的模块,顶层代码被再执行一遍,这是卡死根因。
- 报错信息里写着答案,if name == "main",Linux 上写它无副作用,一份代码全平台通用。
- 快速验证法,num_workers 设 0 能跑通,就坐实了多进程问题。
本篇坑卡片
| 字段 | 内容 |
|---|---|
| 坑名 | Windows 下 DataLoader 开多进程且无 main guard,卡死后崩溃 |
| 报错原文 | RuntimeError: DataLoader worker (pid(s) ...) exited unexpectedly(前置 Python 官方 bootstrapping 提示) |
| 环境 | Win11,Python 3.12,torch 2.9.1+cu126,num_workers=2 |
| 复现步骤 | 模块顶层创建 DataLoader(num_workers=2) → 迭代 → 开头打印出现 3 遍 → 卡约 25 秒 → worker 崩溃 |
| 根因 | spawn 启动 worker 时重新 import 主模块,顶层代码二次执行递归开 worker,被 Python 拦截 |
| 解法 | 入口放进 if name == "main" 保护;快速验证用 num_workers=0 |
| 避坑建议 | 训练脚本无论平台一律写 guard;Jupyter 里改用外部脚本跑多进程 |
| 可信度 | 本机验证 |
| 版本时间戳 | 2026-11-05,torch 2.9.1+cu126 |
| 关联坑 | 第 2 篇断点定位(同为"无报错型"故障) |
专栏导航
| 篇次 | 主题 | 状态 |
|---|---|---|
| 1 | nvidia-smi 显示的 CUDA 版本到底是不是你装的那个 | ✅ |
| 2 | torch.cuda.is_available() 一直是 False,一条命令定位断点 | ✅ |
| 3 | 标签和图像没对齐,模型一直在学噪声 | ✅ |
| 4 | loss 变 NaN,用 hook 逐层定位 | ✅ |
| 5 | DataLoader 卡死在第一个 batch,Windows 多进程的坑 | ✅(本篇) |
| 6 | 装了两套 CUDA 还在串,PATH 与优先级的真相 | 排期中 |
| 7 | 数据泄漏:预处理做在了划分之前 | 排期中 |
| 8 | RAG 答一半开始编,检索阈值与拒答机制实操 | 排期中 |
| 9 | 随机种子都设了,结果还是不可复现 | 排期中 |
| 10 | 相似度全是 0.9:向量没归一化 | 排期中 |
| 11 | 开了混合精度就 NaN,GradScaler 到底在做什么 | 排期中 |
| 12 | loss 不降反升,先别怀疑模型结构 | 排期中 |
| 13 | 训练降验证不降:先查数据再谈正则 | 排期中 |
下一篇预告,《装了两套 CUDA 还在串,PATH 与动态库优先级》。装了 11.8 又装 12.x,切了环境 nvcc 还是指向旧的那个。下一篇用两个真实的 nvcc 版本演示「谁在生效」由什么决定,一张图看懂 PATH 的优先级。
版权说明,本文崩溃现场与机制演示均来自本人真机复现,专栏读者可学习使用,禁止转售或整篇搬运。