摘要: 多个团队同时做 A/B 测试,既要避免分流冲突,也要防止把短期点击上涨误判为业务增量。本文讨论实验分层与互斥、指标选择、样本量与早停偏差,以及灰度放量时应关注的风险。
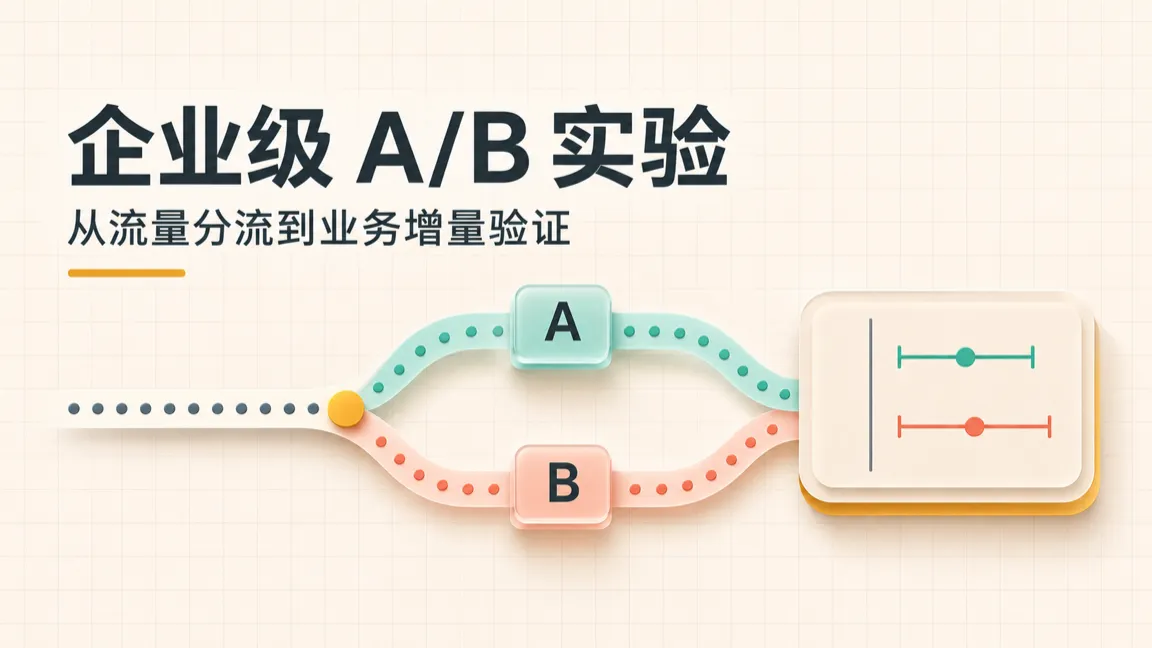
在很多互联网与数字化企业的技术演进过程中,A/B 测试(A/B Testing)往往起源于前端工程中的轻量分流脚本。当业务规模较小时,通过简单的配置下发或代码层 if-else 分支,团队即可完成基本的页面对比。
然而,随着业务复杂度的提升与多业务线并发探索的常态化,基于单点脚本的分流模式迅速暴露出系统性瓶颈:
- 流量碎片化与碰撞失真:多团队各自切分流量,导致可用流量池迅速耗尽;若缺乏场景隔离机制,交叉作用在同一用户身上的多个改版策略会引发严重的因果混淆;
- 指标体系孤立:分流组件往往只记录点击、曝光等前端浅层事件,无法直接计算核心转化漏斗、多日留存与交易结算等深度指标,导致实验归因与企业真实业务大盘脱节;
- 统计检验不严谨:缺乏样本量估算与周期治理,团队频繁根据短期微弱波动过早做出全量决策,引入大量假阳性偏差(Type I Error);
- 缺乏发布级风控:缺乏细粒度小流量灰度与异常回退能力,改版风险直接暴露给线上用户。
构建一套具备高可用性、高并发能力与统计严谨性的企业级 A/B 实验平台,需要从架构设计上解决分流、数据、统计与发布四个维度的核心问题。
一、分流引擎架构:场景分层与互斥隔离设计
企业级 A/B 实验平台的首要技术挑战,是在有限的用户流量池中,支持多个业务团队同时开展互不干扰的独立实验。
1. 随机分流与基线检查
按选定的用户或设备标识进行哈希分流。随机化使各组在期望上可比,实际运行仍需检查样本分配比例、关键基线和曝光记录。
2. 按场景分层与互斥管理
在实际业务链路中,不同团队的改版诉求往往存在逻辑重叠:
- 互斥组隔离(Mutual Exclusion):若两个实验作用于同一页面或同一交互流且逻辑相悖(如针对结算页面的两种不同交互流),系统必须将二者配置在同一互斥组内,确保同一用户在同一实验周期内仅命中其中一种方案,防止逻辑穿帮与归因污染;
- 多业务场景分层管理:对于彼此解耦的业务模块(如首页顶部 Banner 与底部详情推荐),系统支持按页面、模块划分实验层级,实现跨场景流量的高效复用,使多个独立团队能够并行推进策略探索。

在 GrowingIO 的技术与产品实践中,平台支持按页面、模块、组件等场景配置实验分层,并结合互斥组规则避免策略冲突,让团队集中配置实验流量与规则。
二、指标闭环:打通全链路行为指标与客群画像
将 A/B 实验系统独立于用户行为分析系统之外,是造成“点击率上涨但大盘收益下跌”的根本技术诱因。
前端点击率(CTR)仅代表用户的即时交互反应,不能直接等同于最终业务价值。例如,某类强引导按钮显著拉升了点击率,但由于承接页体验未达预期,用户在后续多步漏斗中的弃购率反而大幅攀升。
成熟的实验架构必须实现与底层行为分析引擎的原生对齐:
- 用业务结果评价实验:先明确支付转化或订单金额等主指标,再通过漏斗、路径或留存分析解释结果。评估前确认实验曝光和业务事件能按同一分流单位关联。
- 客群画像与定向实验(Targeted Experimentation):并非所有实验方案都需要面向全体流量测试。依托客户数据平台中的客群分群,实验系统能够针对特定价值层级的细分人群(如高潜力待激活新客、高频流失风险会员)配置定向实验规则,观察不同客群对策略调整的敏感度差异。
三、统计学治理:假阳性控制与功效评估
A/B 实验本质上是一套基于概率论的假设检验系统。工程团队在设计指标看板时,必须内嵌统计学治理逻辑,防止业务团队滑入伪科学决策的误区:
1. 最小可检测效应(MDE)与样本量评估
实验前先确定值得检出的最小效应(MDE),结合基线或方差、显著性水平、统计功效和分流比例估算样本量。观察周期还要留出转化或留存结果成熟的时间。结果不显著,只表示现有证据不足,不能直接认定新方案没有影响。

2. 提前看数与早停偏差
如果采用固定样本检验,反复检验并在结果刚达显著时停止,会抬高假阳性风险。可以在运行中监测分流和护栏指标,但收益判断应遵循预设样本量与观察窗口。需要中途作出收益判断时,应事先约定合适的序贯方法及停止规则。
3. 配置系统级护栏指标(Guardrail Metrics)
在追求目标指标提升的同时,系统必须同时监控技术性能与业务大盘底线(如客户端崩溃率、页面加载耗时、网络超时率、退货退款率等)。一旦改版版本对系统稳定性或核心底盘产生负向冲击,即使主指标表现优异,团队应按事先约定的阈值排查并决定是否暂停放量。
四、工程落地:灰度发布与实时风险控制
A/B 实验直接运行在生产环境中,与线上发布工程深度融合是保障业务连续性的底线。
- 小流量阶梯式灰度发布:支持按“人群属性 + 流量百分比”进行渐进式放量(例如 1% -> 5% -> 20% -> 100%)。在新版本上线初期先在小范围内验证技术指标的稳定性,待确认无异常后再逐步放大流量;
- 异常时回退:提前确认哪些版本或策略可以通过配置切换。上线后发现技术指标或业务护栏明显恶化,可以暂停放量,并按预案将已接入、可切换的策略回退到基准版本。需要重新发版的变更,仍须遵守原有发布流程。
五、总结:构建科学实验的常态化技术闭环
企业级 A/B 实验平台的演进,标志着数字化团队从“依靠主观经验假设”走向“依靠科学实验验证”的工程转型:
- 分流治理:通过随机均匀分流与场景分层、互斥组管理,解决多团队并行改版时的流量冲突与归因混乱;
- 数据贯通:打破单点分流工具的数据孤岛,将实验与全链路用户行为指标和动态画像原生打通;
- 统计严密:通过 MDE 测算、早停偏差治理与护栏指标监控,建立可信的量化决策标准;
- 工程风控:将实验机制与灰度发布、配置回退深度结合,确保业务迭代在低风险可控的前提下稳健推进。