作者:向真、白玙
应用发布后,错误率突然升高。
告警已经发出,监控、日志和链路数据也都在。但接下来,运维人员仍然需要在多个系统之间切换:确认影响范围,排查上下游依赖,关联最近的发布,再决定如何处理。
即使 AI 已经给出了分析建议,工作也没有结束。建议是否有依据?操作是否安全?执行后业务有没有恢复?这些环节,往往还需要专家持续推进。
这也是企业落地智能运维时面临的共同挑战:数据和 AI 已经让问题更容易被发现,但从发现到解决,仍然存在大量依赖人工衔接的工作。
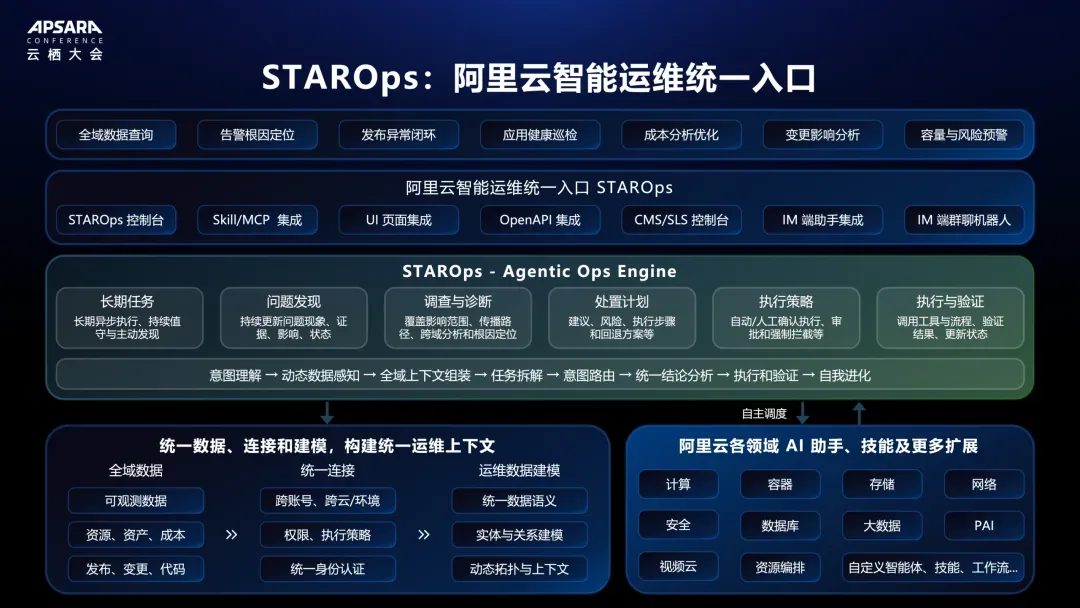
围绕这一问题,阿里云全域智能运维平台 STAROps 全新升级,将统一运维上下文、跨域分析诊断和持续闭环处置结合起来,让智能体在明确的目标和权限范围内,持续推进问题解决。
智能运维正在走向 Agentic Ops
规则监控帮助企业发现异常,AIOps 进一步提供异常检测和关联分析。随着大模型进入运维场景,用户已经可以通过自然语言查询数据、解释告警和分析问题,使用门槛明显降低。
但在不少场景中,下一步查什么、什么时候继续、处理后是否恢复,仍然需要人来推动。
Agentic Ops 进一步改变了这种工作方式:用户可以设定一个持续的运维目标,由 Agent 围绕目标观察环境、发现异常、展开调查,并在授权范围内推动处置和验证,例如用户可以要求系统持续关注核心应用的发布情况,在新版本发布后检查运行状态,发现异常时关联变更展开分析,并跟进后续处理。
这里核心变化,是从人不断提问、不断推进,走向 Agent 围绕目标持续工作,而人负责关键决策。
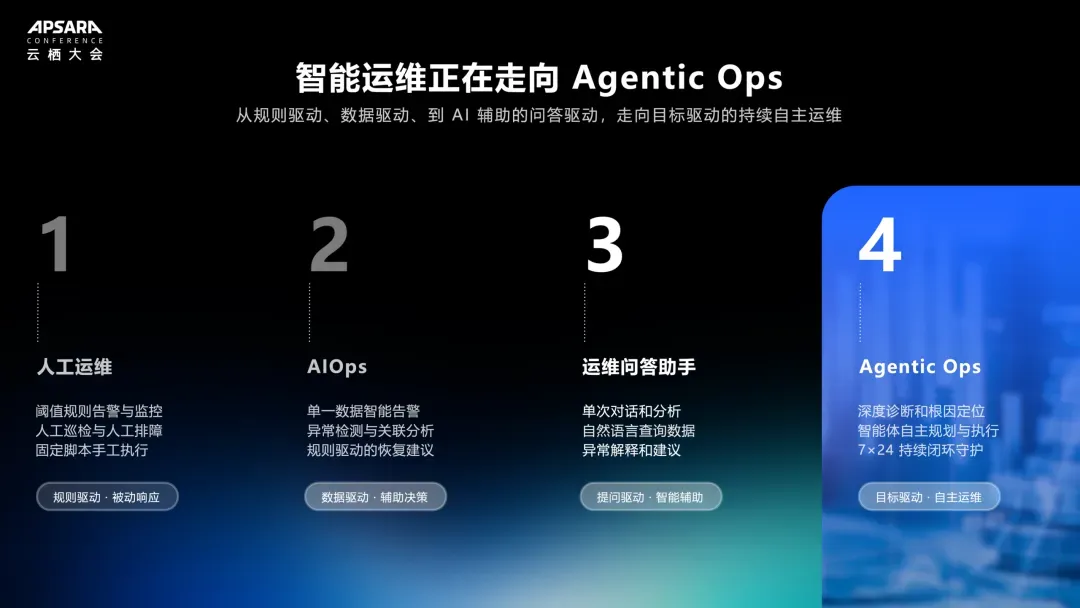
在这个过程中,人负责设定目标、执行边界和关键决策,Agent 承担更多数据查询、证据收集、调查分析和处理跟进工作。
要支撑这样的分工,首先需要解决一个基础问题:让 Agent 理解真实、完整且持续变化的运维环境。
统一运维上下文,让 Agent 理解当前环境
企业运维数据通常分散在不同系统中。监控平台记录指标,日志平台保存运行日志,资源系统管理资产,研发平台记录代码和发布变更。
这些信息共同构成了问题调查的依据。STAROps 通过自动感知、智能化接入、统一连接和数据建模,将它们组织成可供 Agent 理解和分析的运维上下文。
自动感知和智能化接入,降低接入门槛
在授权范围内,STAROps 自动发现云上资源,持续感知资源变化,减少用户手动梳理环境的工作。同时,在数据接入时,用户可以直接描述接入诉求,由系统结合当前环境匹配数据源和接入方案,协助完成配置与校验,让用户更快进入分析和诊断环节。
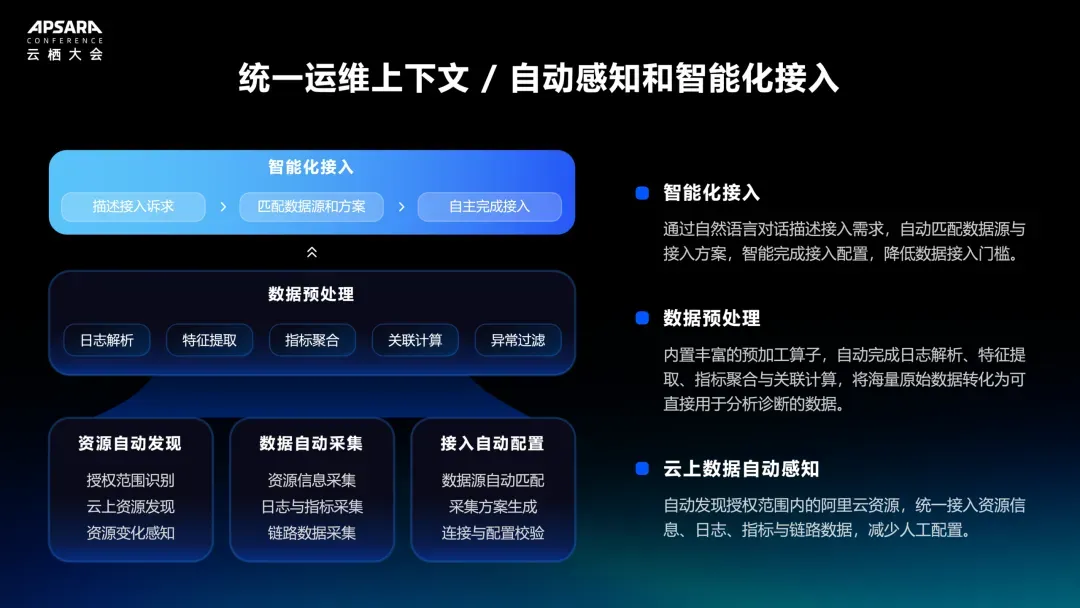
连接多源系统,统一数据建模
连接与建模承担不同的职责,共同解决统一运维上下文的构建:
- 连接器(Connector)负责统一连接: 通过云上直连和 Satellite 环境代理,连接云环境与企业系统,统一管理授权鉴权、资源发现、健康检查和连接状态。连接范围涵盖可观测数据、资源与成本,也延伸到代码、CI/CD、工单和自动化系统。
- 数据建模(Fabric)负责统一建模: 将指标、日志、链路等可观测数据,与应用、实例、容器、数据库等资源对象关联起来,持续维护统一语义、实体关系和动态拓扑。
当一个接口发生错误时,智能体需要知道它属于哪个服务、运行在哪些实例上、依赖哪个数据库,以及最近有没有相关变更。这样的上下文,才能支撑后续跨系统、跨产品的调查。

从自然语言查询,到有证据支撑的跨域诊断
有了统一上下文,用户可以先从一个简单问题开始:帮我查看最近一小时,错误率比较高的 APM 应用。
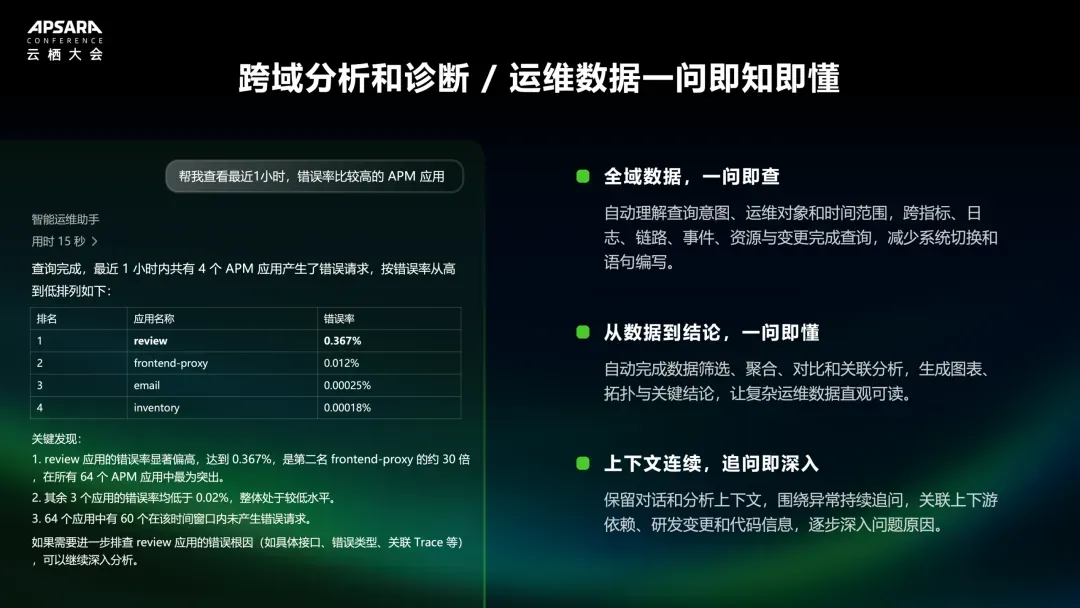
STAROps 能够理解查询对象和时间范围,查询相关数据,完成筛选、排序和对比,并提炼需要关注的结论。
用户还可以继续追问:主要涉及哪些接口?出现了什么错误?关联链路有没有异常?后续分析沿用已有上下文,减少反复描述背景和切换系统的工作。
问答是使用这些能力的一个入口,同样的数据与分析能力也可以由告警事件、长期任务、问题发现等调用。
当问题进一步深入到“异常为什么发生”时,就需要一条有证据支撑的诊断过程。
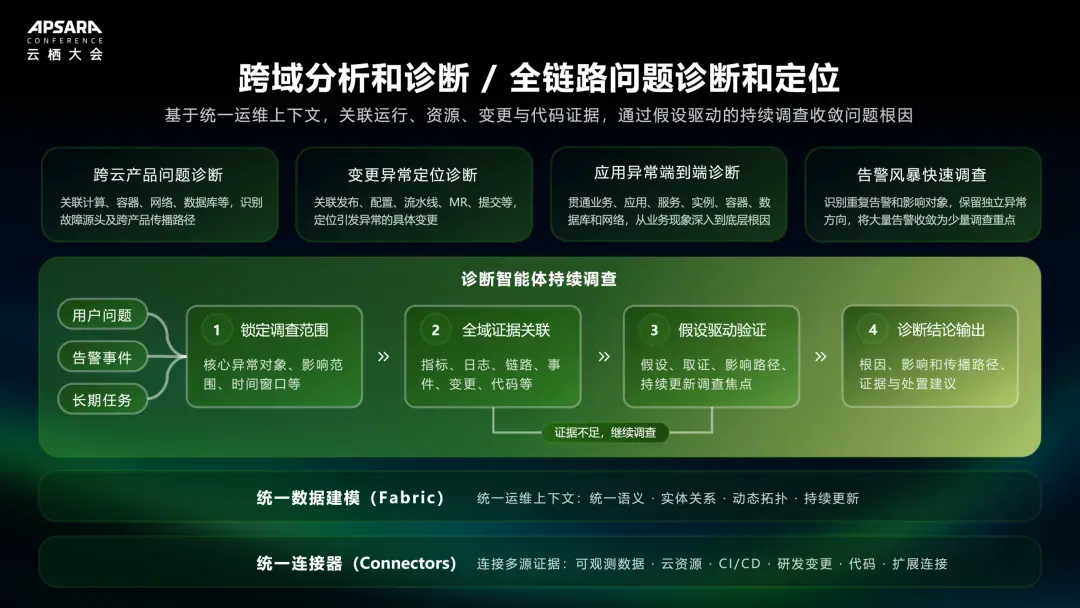
STAROps 先锁定异常对象、时间窗口和影响范围,再结合资源依赖,关联指标、日志、链路以及变更、代码等证据。在此基础上提出假设,继续取证和验证,逐步收敛问题原因。
例如,异常发生前恰好有一次发布,可以成为调查线索,但还需要验证受影响实例、错误堆栈和调用链是否支持这一判断。证据不足时,继续调查或调整分析方向。
最终,诊断结果需要说明根因判断、业务影响、传播路径、对应证据和处置建议,帮助用户理解结论的依据,并决定下一步如何处理。
这一过程可以应用于跨云产品故障、应用端到端诊断、变更异常定位,以及大量告警中的重点问题调查。
发布、解决和验证,持续闭环、安全可控
完成一次诊断之后,问题还需要继续跟进。STAROps 通过长期任务(Missions)和问题发现(Findings),将持续观察与问题处理连接起来。
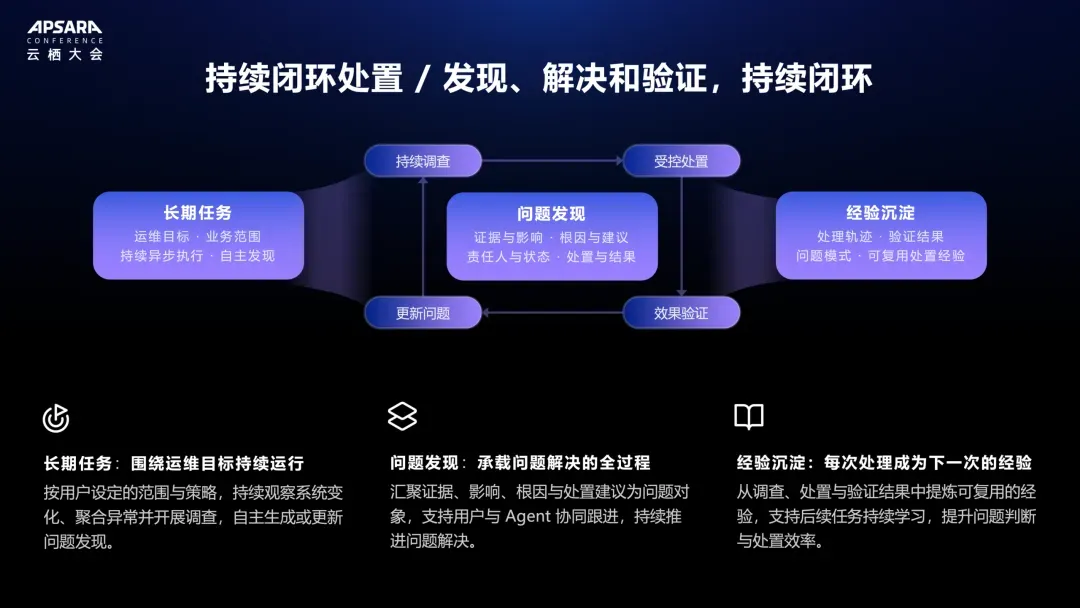
长期任务 Missions:围绕运维目标持续运行
用户设定关注的业务范围和策略后,长期任务持续观察系统变化,发现异常并展开调查,当发现需要处置的任务时,可以生成问题发现(Finding)。目标可以是跨云产品资源巡检,也可以是持续关注某个应用的发布影响。任务运行不依赖用户不断发起新的提问。
问题发现 Findings:承载问题解决的全过程
调查形成的现象、证据、影响、根因判断和处置建议,汇总为一个持续更新的问题对象。后续由谁处理、当前进展如何、执行了什么动作,以及最终处理结果,也记录在同一个问题中。即使经历多轮调查或人工介入,仍然可以沿着同一个问题的上下文持续续推进和解决。
经验沉淀:每次处置都成为经验
执行完成后,还要验证实际效果。业务尚未恢复时,问题需要继续调查或转入人工处理。工具调用成功,本身不足以说明问题已经解决。
调查过程、处置轨迹和验证结果也会持续沉淀,供后续任务参考和复用。
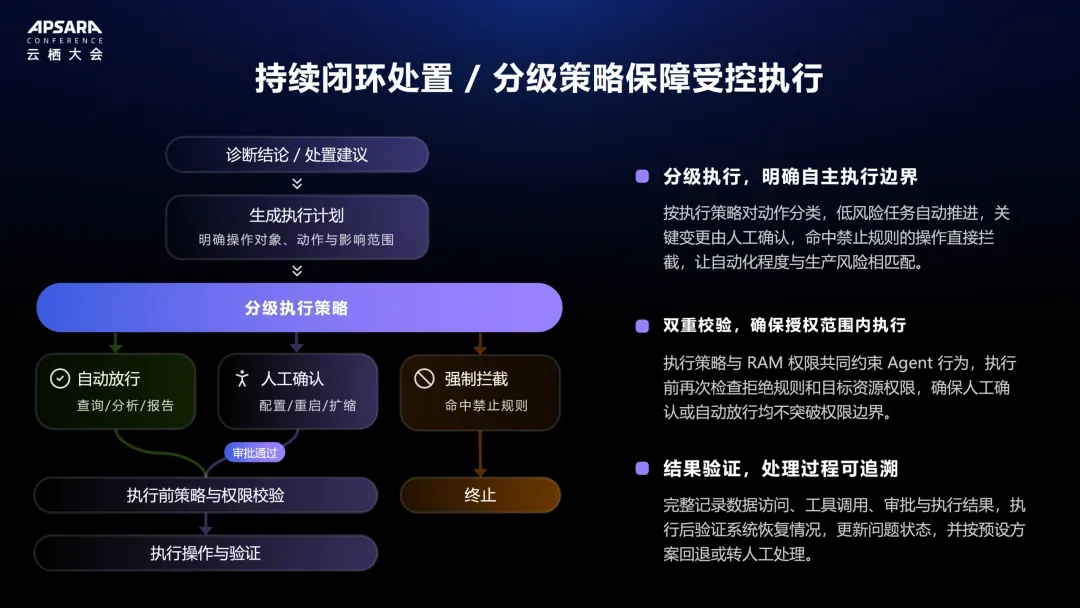
分级执行:明确生产操作的边界
进入生产执行前,STAROps 先形成处置计划,明确操作对象、具体动作和影响范围,再按照执行策略推进:
- 自动执行: 权限和策略允许的低风险查询、分析、报告等任务。
- 人工确认: 配置修改、重启、扩缩容等关键动作。
- 强制拦截: 命中禁止规则的操作。
无论自动放行还是人工确认通过,执行前都需要再次校验策略和目标资源权限。人工确认不能突破原有权限边界。
执行后验证恢复情况,记录数据访问、工具调用、审批和执行结果。未达到预期时,按照预设方案回退,或转入人工处理。
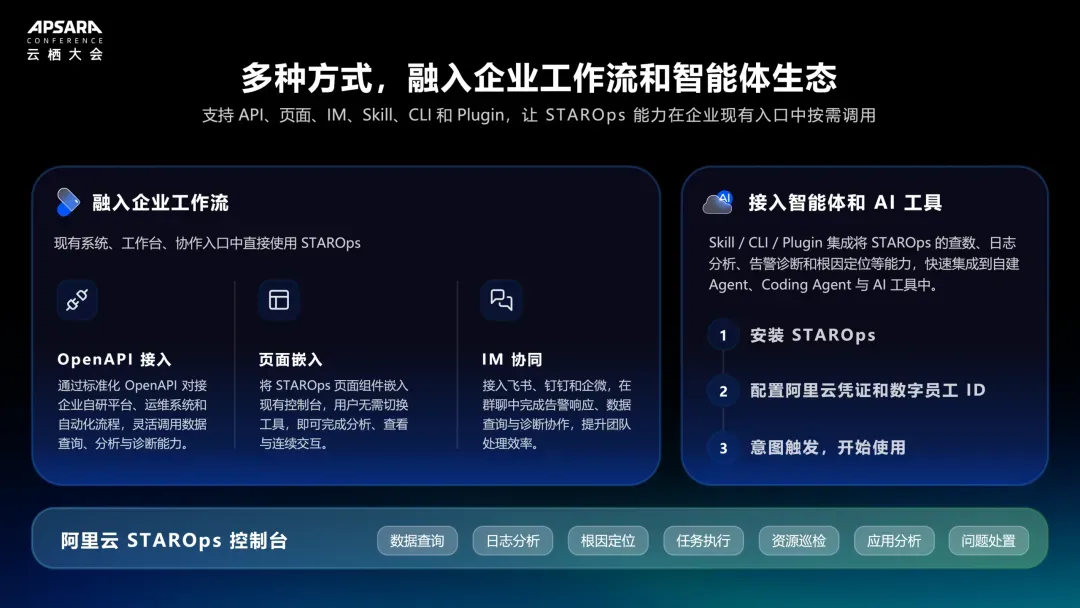
多种使用方式,融入企业运维工作流
企业已经有自己的运维平台、研发工具和协同方式。STAROps 提供多种接入方式,让相关能力进入现有流程。
企业可以通过 OpenAPI 调用查询、分析和诊断能力,也可以将页面组件嵌入已有工作台。在飞书、钉钉和企业微信等协同入口中,团队可以开展数据查询和诊断协作。对于使用 AI 工具或自建 Agent 的团队,还可以通过 Skill、CLI、Plugin 等方式集成 STAROps 的运维能力。
统一的能力与上下文,可以服务于不同用户入口,让用户在熟悉的工作环境里完成任务。
企业业落地智能运维,需要让数据、判断和行动之间形成连续的工作过程,STAROps 通过统一连接和建模,减少上下文割裂;通过跨域取证和诊断,帮助专家更快形成判断;通过长期任务、分级执行和效果验证,持续推进问题解决。
让 Agent 承担更多持续性的运维工作,让人专注于关键决策和复杂问题。
STAROps 旨在运维模式从被动响应向主动自治的根本性转型,为企业提供 7x24 小时的自主运维能力,实时守护客户的业务系统韧性。
欢迎体验全新升级的 STAROps,定制企业专属数字员工,构建 Agentic Ops 智能运维闭环。