在鸟类识别场景中,对大量、密集、甚至移动的鸟类进行准确计数,是技术上的一大挑战,远比对单个鸟类进行识别要复杂。
简单来说,当目标数量巨大时,逐一只进行“检测-识别-计数”的传统目标检测方法(如YOLO)会遇到瓶颈: NMS(非极大值抑制)容易把挤在一起的多只鸟合并为单个目标,造成大规模漏检;大量小目标同时推理也会带来极高算力开销。目前主流的解决方案可以归结为两大技术路线,其核心原理对比如下:
下面,我们详细解析这两大技术路线的原理、挑战和实际应用。
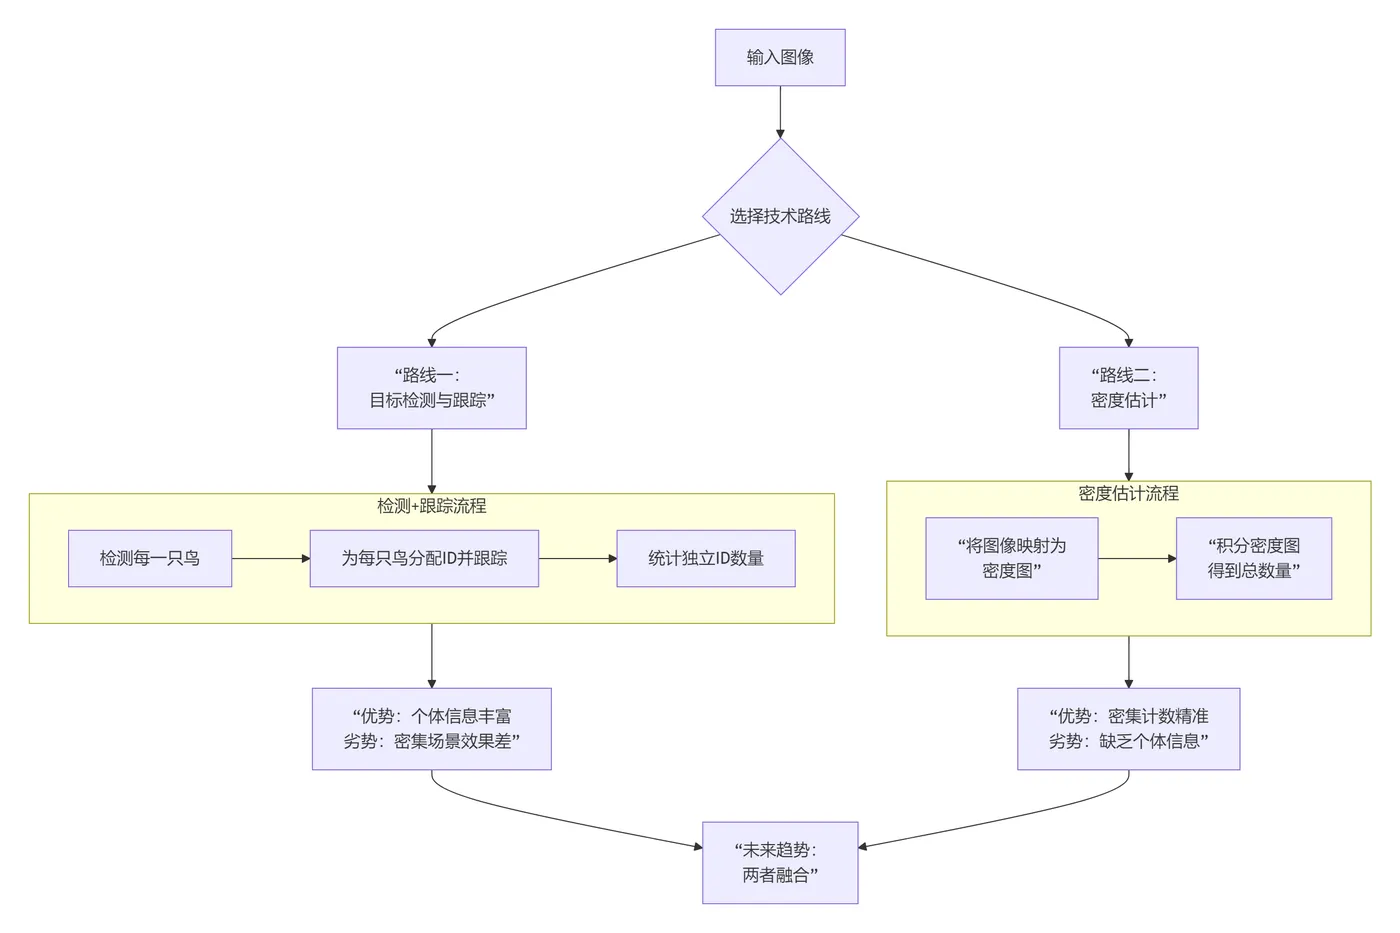
路线一:目标检测与跟踪
这种方法思路直观,分为两步:
检测每一只鸟:使用强大的目标检测算法(如改进的YOLO、Faster R-CNN)在单张图片或视频帧中定位出每一只鸟,并给出边界框。
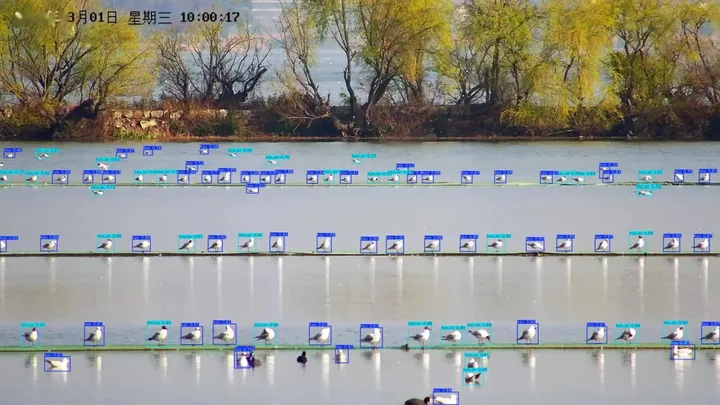
跨帧跟踪:在视频序列中,通过目标跟踪算法(如DeepSORT、ByteTrack)为每一只检测到的鸟分配一个唯一的ID。算法会根据鸟的外观特征和运动轨迹,判断下一帧中的某个边界框是属于同一只鸟(ID不变)还是新出现的鸟(分配新ID)。
计数原理:统计在一段时间内(例如一段10秒的视频)出现过的独立ID的总数。这能有效避免因鸟类来回飞行、反复进出画面而导致的重复计数,同时记录每一个个体的坐标、运动轨迹。
技术挑战:
- 密集遮挡:当鸟群极度密集时(如密密麻麻的椋鸟群),个体之间严重重叠,检测模型无法给出独立的边界框,导致漏检。
- 计算资源:对高清视频逐帧进行高精度目标检测,计算开销巨大,难以实时处理。
- 跟踪失败:外观相似的鸟容易导致ID切换(ID Switch);快速运动或飞出画面会导致跟踪丢失。
适用场景:鸟类数量相对较少、分布较为稀疏的场景,如对湿地中分散的白鹭、天鹅进行计数,同时需要获取物种、个体活动轨迹、停留时长等生态学精细数据。
下面是极简演示代码:YOLO + ByteTrack,统计视频中出现过的独立鸟类ID,实现去重计数。 仅原理演示,实际保护区版本会替换为针对鸟类微调的权重、增加物种分类、过滤误检。
# 示例1:检测+跟踪独立ID计数(ByteTrack + YOLO)
import cv2
import torch
from ultralytics import YOLO
from bytetrack import ByteTrack

def bird_track_count(video_path: str, conf_thresh=0.25):
    model = YOLO("yolov8n.pt")  # 替换为鸟类微调权重
    tracker = ByteTrack()
    seen_ids = set()

    cap = cv2.VideoCapture(video_path)
    while cap.isOpened():
        ret, frame = cap.read()
        if not ret:
            break
        # 检测
        results = model(frame, conf=conf_thresh)
        dets = []
        for box in results[0].boxes:
            x1, y1, x2, y2 = box.xyxy[0].cpu().numpy()
            score = box.conf[0].cpu().item()
            dets.append([x1, y1, x2, y2, score])
        # 跟踪更新
        tracks = tracker.update(dets, frame.shape[:2])
        for t in tracks:
            tid = t.track_id
            seen_ids.add(tid)
            # 绘制框与ID
            x1, y1, x2, y2 = t.tlbr
            cv2.rectangle(frame, (int(x1), int(y1)), (int(x2), int(y2)), (0,255,0), 1)
            cv2.putText(frame, f"ID:{tid}", (int(x1), int(y1)-5),
                        cv2.FONT_HERSHEY_SIMPLEX, 0.4, (0,255,0),1)
        cv2.imshow("bird-track", frame)
        if cv2.waitKey(1) & 0xFF == ord('q'):
            break
    cap.release()
    cv2.destroyAllWindows()
    return len(seen_ids)

if __name__ == "__main__":
    total_unique = bird_track_count("wetland_bird.mp4")
    print(f"视频内独立鸟类数量(去重后):{total_unique}")
路线二:密度估计
这是解决大规模密集计数问题的主流和更先进的方法。它的思想非常巧妙:不强制识别、框出每一只个体,而是直接学习图像视觉特征到群体密度分布的映射,最终推算出总数。下面是简化版 CSRNet 推理示例,输入一张鸟群图片,输出热力图与估算总数。
# 示例2:密度估计推理(简化 CSRNet,密集鸟群计数)
import torch
import torch.nn as nn
import cv2
import numpy as np

class CSRNet(nn.Module):
    """简化版 CSRNet,仅用于演示密度图输出逻辑"""
    def __init__(self):
        super().__init__()
        self.frontend = nn.Sequential(
            nn.Conv2d(3, 64, 3, padding=1), nn.ReLU(),
            nn.Conv2d(64, 64, 3, padding=1), nn.ReLU(),
            nn.MaxPool2d(2),
            nn.Conv2d(64, 128, 3, padding=1), nn.ReLU(),
            nn.Conv2d(128, 128, 3, padding=1), nn.ReLU(),
            nn.MaxPool2d(2),
            nn.Conv2d(128, 256, 3, padding=1), nn.ReLU(),
            nn.Conv2d(256, 256, 3, padding=1), nn.ReLU(),
            nn.Conv2d(256, 256, 3, padding=1), nn.ReLU(),
            nn.MaxPool2d(2),
            nn.Conv2d(256, 512, 3, padding=1), nn.ReLU(),
            nn.Conv2d(512, 512, 3, padding=1), nn.ReLU(),
            nn.Conv2d(512, 512, 3, padding=1), nn.ReLU(),
        )
        self.backend = nn.Sequential(
            nn.Conv2d(512, 512, 3, dilation=2, padding=2), nn.ReLU(),
            nn.Conv2d(512, 512, 3, dilation=2, padding=2), nn.ReLU(),
            nn.Conv2d(512, 256, 3, dilation=2, padding=2), nn.ReLU(),
            nn.Conv2d(256, 128, 3, dilation=2, padding=2), nn.ReLU(),
            nn.Conv2d(128, 64, 3, dilation=2, padding=2), nn.ReLU(),
            nn.Conv2d(64, 1, 1),
        )

    def forward(self, x):
        x = self.frontend(x)
        x = self.backend(x)
        return x

def density_infer(img_path, weight_path=None):
    model = CSRNet()
    if weight_path:
        model.load_state_dict(torch.load(weight_path, map_location="cpu"))
    model.eval()
    img = cv2.imread(img_path)
    img_rgb = cv2.cvtColor(img, cv2.COLOR_BGR2RGB)
    h, w = img.shape[:2]
    # 归一化转 tensor
    inp = torch.from_numpy(img_rgb).permute(2,0,1).float() / 255.0
    inp = inp.unsqueeze(0)
    with torch.no_grad():
        density_map = model(inp)
    count = float(density_map.sum().item())
    # 可视化热力图
    dm_np = density_map[0,0].cpu().numpy()
    dm_resized = cv2.resize(dm_np, (w, h))
    heatmap = cv2.applyColorMap((dm_resized / dm_resized.max() * 255).astype(np.uint8), cv2.COLORMAP_JET)
    blend = cv2.addWeighted(img, 0.5, heatmap, 0.5, 0)
    cv2.imwrite("density_heat.jpg", blend)
    return count, dm_np

if __name__ == "__main__":
    cnt, _ = density_infer("flock_birds.jpg")
    print(f"密度估计得到鸟群总数:{cnt:.2f}")
技术原理:
训练数据准备:
- 需要一批标注好的图片,标注方式非常特殊:不在每只鸟上画框,而是在每只鸟的头部中心位置点一个点。这张图被称为“点标注图”。
生成密度图:
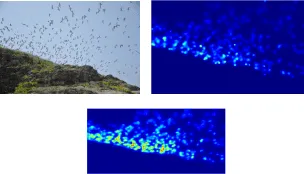
将点标注图通过一个高斯滤波器进行卷积,将每个点扩散成一个高斯分布的小圆点。这样,一张“密度图”就生成了。
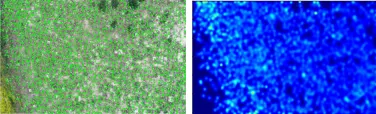
密度图上每个像素的值代表该点附近鸟的“密度” 。鸟越密集的地方,亮度越高。
模型训练:
- 构建一个卷积神经网络(通常是编码器-解码器结构,如U-Net、VGG等),输入是原始鸟群图片,输出的预测目标就是这张密度图。
- 模型通过学习,能够建立从鸟群外观纹理到密度分布的映射关系。
计数:
- 推理时,将新的鸟群图片输入训练好的模型,得到预测的密度图。
- 对整张密度图的所有像素值进行求和,得到的结果就是图中鸟的预估数量。例如,密度图总和为 245.7,那么鸟的数量可估算为 246 只。
为什么密度估计更优?
- 它不再依赖 “把每一只鸟分开检出”,对于紧紧挤在一起、大面积互相遮挡的雁鸭群、鸻鹬群,不会因为粘连而批量漏检;
- 同等分辨率下推理速度更快,适合航拍大视野、成千上万个体的集群场景;
- 新一代密度估计框架还可以增加群体分类分支,同步输出鸟群的物种构成比例,不再只能输出单纯数字。
技术挑战:
- 原生密度估计无法获得单只鸟的独立轨迹、个体位置;
- 标注门槛依然很高,需要在海量图片中逐鸟打点;
- 模型容易受光照、水雾、背景纹理干扰;
- 密度分布差异巨大时容易出现高估或低估,需要在本地场景做微调;
- 很难单独定位其中某一只珍稀鸟类。
适用场景:大规模密集鸟群的计数,如统计越冬地成千上万只雁鸭类、鸻鹬类的水鸟。
实际应用中的技术组合与优化
在实际的鸟类监测系统中,通常不会只选用单一路线,而是采用自适应多模算法组合,根据画面鸟群密度自动切换策略,兼顾总量精度与细粒度生态信息。国内生态视觉厂商快瞳科技就是这套组合方案典型的落地实践者。
“密度估计 + 抽样检测” :先用密度估计法快速统计整个区域的鸟群总数,再在鸟群边缘或稀疏区域用检测法识别物种构成,从而以较低成本同时获得“总数”和“种类”信息。
多尺度分析:
广角镜头:拍摄大场景,进行密度估计,得到总数。
云台变焦镜头:自动定位到感兴趣的区域(如密度高的地方),变焦后拍摄特写,使用目标检测法进行精确的种类识别和个体行为分析。
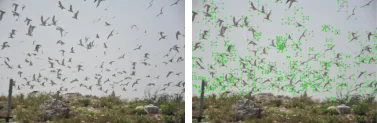
无人机巡航 + AI分析:无人机拍摄的视频既可用于生成序列图像进行密度估计,也可通过目标检测与跟踪,结合GPS信息,绘制鸟类的空间分布热力图。
总结
| 技术方法 | 核心思想 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|---|
| 目标检测与跟踪 | 识别并追踪每一个个体 | 可获得个体位置、种类、轨迹等信息 | 密集时漏检严重,计算量大 | 中、低密度,需要个体信息的场景 |
| 密度估计 | 学习图像特征到群体密度的映射 | 适合密集计数,精度高,效率高 | 无法提供个体信息,标注成本高 | 高密度、大群体的总数统计 |
因此,回答“如何统计大量鸟类数量”的问题,现代AI的答案是:优先采用基于密度估计的深度学习方法解决大规模集群的总数问题;在需要物种、个体轨迹、珍稀个体识别的场景,辅以目标检测与跟踪技术。快瞳科技等厂商落地的自适应多模方案,正是把这套组合策略产品化,在国内多个湿地、国家级自然保护区的长期监测中验证了可行性。