对话一长,Agent 就开始出问题。前几轮还好,聊到二三十轮,要么接口直接报错,要么响应明显变慢,要么开始答非所问。查日志往往会看到同一处,messages 列表越攒越长,终于塞不进模型的上下文窗口。
前面几篇分别讲过记忆怎么装配、state 怎么设计、运行时怎么读写消息。这一篇处理另一件事,消息攒多了之后怎么收回去。LangChain 官方给了三条路线,裁剪、删除、摘要,各自的代价差得很远。选错的代价不在报错那一刻,而在用户发现 Agent 忘了自己说过的话。
一、先看清爆掉的是哪根弦
短期记忆靠 checkpointer 逐轮留存,每个 thread 的 messages 只增不减。官方文档把长对话的代价写得很直白,完整历史可能放不进上下文窗口,直接触发上下文丢失或报错。就算模型窗口够大,多数模型在长上下文上表现依然变差,会被陈旧或跑题的内容分心,同时响应更慢、成本更高。
把这几条翻译成工程语言,是四个一起变坏的指标。请求体越来越长,token 账单按轮累加。首 token 延迟随输入往上涨。早期关键信息被淹没在中间段,模型注意力够不着。越过窗口上限后请求被提供商直接拒掉。前三个是慢性退化,线上很难第一时间发现,第四个才会报警。
所以这件事要在窗口被打满之前处理,别等报错再来救火。
二、三条收敛路线,动作和代价都不同
官方给出的方案按动作分成三类。裁剪在调模型之前砍掉中间段,删除在答完之后按 id 摘除指定消息,摘要用小模型把旧历史压成一段文字。三者都作用在 messages 上,都要经过 add_messages reducer 归并,区别在丢掉的到底是什么。
| 路线 | 触发位置 | 动作 | 信息保留 | 适合场景 |
|---|---|---|---|---|
| 裁剪 | before_model | 清空后补回首条与最近几条 | 中间原文全丢 | 成本敏感,旧轮次可弃 |
| 删除 | after_model | 按 id 摘除指定或全部消息 | 被删原文全丢 | 过滤敏感回复,清理陈旧工具结果 |
| 摘要 | 内置中间件 | 旧消息压成摘要,保留最近原文 | 语义大致留存,细节有损 | 长任务,跨轮上下文要接得上 |
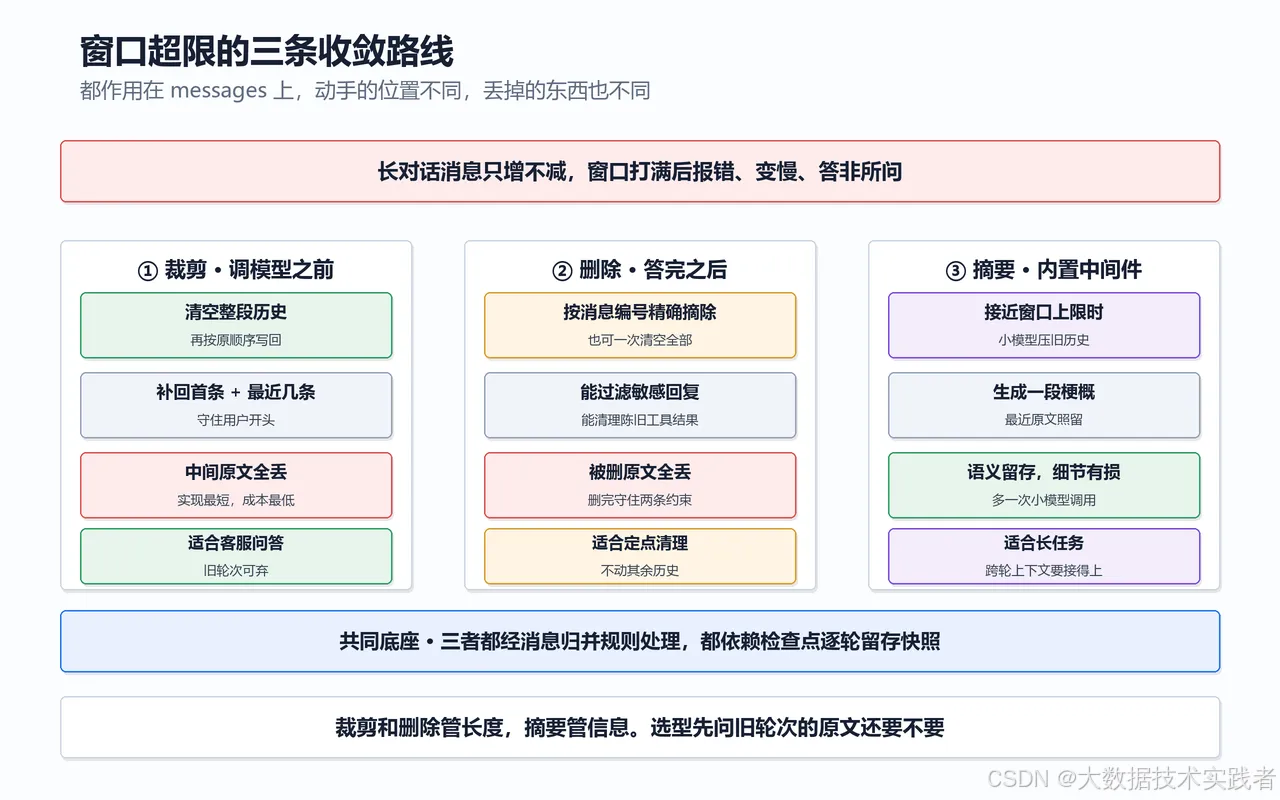
裁剪和删除都是减法,实现短,见效快,代价是原文没了。摘要多花一次小模型调用,换来旧信息以梗概形式留在历史里。官方对前两者的提醒很直接,从消息队列里剔除内容会丢信息,讲究上下文完整的应用更适合摘要这条更讲究的路子。
三、路线一 裁剪,保首条也保最近
裁剪挂在 @before_model 上,每轮调模型之前跑一次。官方示例的做法值得照抄,先用 RemoveMessage 把整段历史清空,再把首条和最近几条按原顺序补回去。
from langchain.messages import RemoveMessage
from langgraph.graph.message import REMOVE_ALL_MESSAGES
from langchain.agents import create_agent, AgentState
from langchain.agents.middleware import before_model
from langgraph.checkpoint.memory import InMemorySaver
from langgraph.runtime import Runtime
from typing import Any


@before_model
def trim_messages(state: AgentState, runtime: Runtime) -> dict[str, Any] | None:
    """Keep only the last few messages to fit context window."""
    messages = state["messages"]

    if len(messages) <= 3:
        return None

    first_msg = messages[0]
    recent_messages = messages[-3:] if len(messages) % 2 == 0 else messages[-4:]
    new_messages = [first_msg] + recent_messages

    return {

        "messages": [
            RemoveMessage(id=REMOVE_ALL_MESSAGES),
            *new_messages
        ]
    }


agent = create_agent(
    "gpt-5.5",
    tools=[...],
    middleware=[trim_messages],
    checkpointer=InMemorySaver(),
)
两个细节别漏。首条消息往往带用户姓名和任务目标,保住它,模型下一轮还认得人。奇偶判断 len(messages) % 2 决定取三条还是四条,为的是补回去的列表以 user 消息开头,这条约束下一节展开。返回 None 表示这一轮不动状态,是中间件省开销的惯用写法。
官方示例里连续四轮对话后问名字,模型答得出 Bob,因为裁剪时首条被保住了。同一段历史若把首条也砍掉,答案就变了。
四、路线二 删除,按 id 精确摘除
删除挂在 @after_model 上,答完之后动手。RemoveMessage 能生效有个前提,messages 字段必须挂 add_messages reducer,默认 AgentState 已经带好,自定义 state 时别把它弄丢。
from langchain.messages import RemoveMessage
from langchain.agents import create_agent, AgentState
from langchain.agents.middleware import after_model
from langgraph.runtime import Runtime


@after_model
def delete_old_messages(state: AgentState, runtime: Runtime) -> dict | None:
    """Remove old messages to keep conversation manageable."""
    messages = state["messages"]
    if len(messages) > 2:
        return {
   "messages": [RemoveMessage(id=m.id) for m in messages[:2]]}
    return None


@after_model
def validate_response(state: AgentState, runtime: Runtime) -> dict | None:
    """Drop the last reply when it contains sensitive words."""
    last_message = state["messages"][-1]
    if any(word in last_message.content for word in ["password", "secret"]):
        return {
   "messages": [RemoveMessage(id=last_message.id)]}
    return None
想清空整段历史,一条语句就够。
from langgraph.graph.message import REMOVE_ALL_MESSAGES


def delete_messages(state):
    return {
   "messages": [RemoveMessage(id=REMOVE_ALL_MESSAGES)]}
官方示例用 stream_events(..., version="v3") 逐轮打印消息快照,能清楚看到删改发生在哪一轮。那个示例的结局也很有说服力,删掉最早两条之后,用户再问名字,模型回答不知道,因为那条自报姓名的消息已经被摘走了。机制确实生效,同时提醒删改要慎之又慎。
删完还得守住两条有效性约束。部分提供商要求消息历史以 user 消息开头。多数提供商要求带工具调用的 assistant 消息后面紧跟对应的工具结果消息。只删一半,配对断链,下一轮请求直接被拒。这两条是删改之后最容易踩的坑,动手前站在请求体合规的角度过一遍。
五、路线三 摘要,把旧历史压成一段
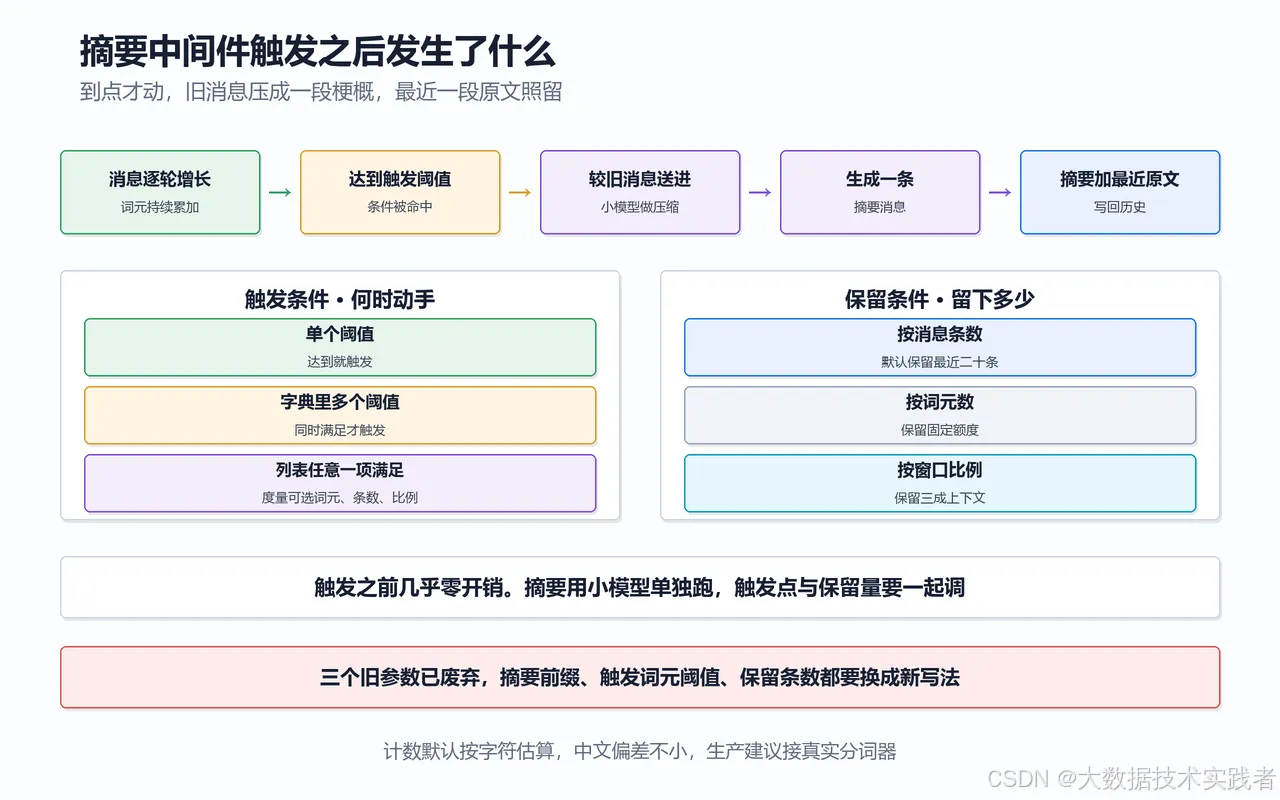
前两条路线都在丢原文。SummarizationMiddleware 是官方给的内置方案,接近窗口上限时用小模型把较旧的消息压成摘要,最近一段原文照留,模型既能接上上下文,请求体也不会继续膨胀。
from langchain.agents import create_agent
from langchain.agents.middleware import SummarizationMiddleware
from langgraph.checkpoint.memory import InMemorySaver


checkpointer = InMemorySaver()

agent = create_agent(
    model="gpt-5.5",
    tools=[...],
    middleware=[
        SummarizationMiddleware(
            model="gpt-5.4-mini",
            trigger=("tokens", 4000),
            keep=("messages", 20),
        )
    ],
    checkpointer=checkpointer,
)
三个参数各有分工。model 指定做摘要的模型,用小模型,别拿主模型去干这件事。trigger 定触发阈值,到点才动。keep 定摘要之后保留多少近期上下文,默认 ("messages", 20)。触发之前中间件几乎零开销,这是它比手写裁剪更省心的地方。
官方同一组四轮对话给了两个结局。裁剪版回答你早些时候告诉过我,摘要版直接答 Bob。差别就在旧信息有没有以可检索的形式留下来。
六、把 trigger 和 keep 配明白
这一节是配置里最容易含糊的部分。trigger 和 keep 都接受 fraction、tokens、messages 三种阈值,语义各不相同。
| 参数 | 取值形式 | 含义 | 默认 |
|---|---|---|---|
| model | 字符串或模型实例 | 生成摘要用的模型 | 必填 |
| trigger | 元组、字典、列表 | 何时触发摘要 | 不填则不自动触发 |
| keep | 三选一 | 摘要后保留多少上下文 | 二十条消息 |
| token_counter | 函数 | 自定义计数方式 | 按字符数 |
| summary_prompt | 字符串 | 自定义模板,需含消息占位符 | 内置模板 |
| trim_tokens_to_summarize | 数字 | 生成摘要前裁到多少 token | 4000 |
trigger 的三种写法直接决定触发逻辑。单个元组达到阈值就触发,字典里多个阈值是 AND,列表里任意一项满足是 OR。
# 单阈值,token 到 4000 就触发
SummarizationMiddleware(
    model="gpt-5.4-mini",
    trigger=("tokens", 4000),
    keep=("messages", 20),
)

# 列表是 OR,token 到 3000 或消息到 6 条都触发
SummarizationMiddleware(
    model="gpt-5.4-mini",
    trigger=[("tokens", 3000), ("messages", 6)],
    keep=("messages", 20),
)

# 字典是 AND,两个条件同时满足才触发
SummarizationMiddleware(
    model="gpt-5.4-mini",
    trigger={
   "tokens": 4000, "messages": 10},
    keep=("messages", 20),
)

# 按窗口比例,八成满触发,摘要后保留三成
SummarizationMiddleware(
    model="gpt-5.4-mini",
    trigger=("fraction", 0.8),
    keep=("fraction", 0.3),
)
fraction 依赖模型的 profile 数据,langchain 1.1 以上才有。查不到 profile 时得手动指定,或者干脆退回 tokens 与 messages。
from langchain.chat_models import init_chat_model

custom_profile = {
   "max_input_tokens": 100_000}
model = init_chat_model("gpt-5.5", profile=custom_profile)
还有三个参数已被标记废弃,别再往新代码里写。summary_prefix 改用 summary_prompt,max_tokens_before_summary 改用 trigger 配 tokens,messages_to_keep 改用 keep 配 messages。老教程里常见这几个名字,照抄会在新版本上踩空。
七、生产落地的四个坑
第一,摘要模型单独选。摘要是一次额外的模型调用,用小模型跑,拿主模型跑等于每轮多付一份全价账单。model 参数留给你控制这笔开销。
第二,多模态只压文本。官方明确写了,摘要是面向文本的压缩,不会缩放或降采样图片、音频、视频。keep 留下的近期消息仍带原始多模态块,被摘要的旧多模态消息只剩文字梗概。图片多的应用要把媒体放文件系统或对象存储,历史里传 URL 或文件引用。
第三,默认计数按字符算。token_counter 不给就按字符数估,中文和真实 tokenizer 的偏差不小,触发点会飘。对成本敏感的服务,接一个真实计数函数进去。
def count_tokens(messages):
    # 接入业务侧真实分词器后再返回 token 数
    return sum(len(m.content) // 2 for m in messages)


SummarizationMiddleware(
    model="gpt-5.4-mini",
    trigger=("tokens", 4000),
    keep=("messages", 20),
    token_counter=count_tokens,
    summary_prompt="把以下对话压成一段中文梗概,保留人名、数字与待办。\n{messages}",
)
第四,摘要本身也占窗口。摘要是一条新消息,触发太频繁会反复压缩,触发太晚又来不及挡住超限。trigger 与 keep 要一起调,先按业务实际窗口估出触发点,再用 stream_events 观察几轮真实长度,别照搬示例里的 4000。
八、怎么选,一张表收尾
选型可以按两个问题走。旧轮次的原文还需不需要,以及愿不愿意为一次摘要多付一次小模型调用。
| 场景 | 推荐方案 | 理由 |
|---|---|---|
| 客服问答,旧轮次可弃 | before_model 裁剪 | 实现最短,成本最低 |
| 工具结果很大且陈旧 | after_model 按 id 删除 | 定点清理,不动其余历史 |
| 长任务,跨轮要接得上 | SummarizationMiddleware | 旧信息留语义,窗口不膨胀 |
| 回复含敏感内容 | after_model 校验后删末条 | 在进历史之前拦下来 |
| 多模态消息为主 | 媒体外置,历史传引用 | 摘要压不动图片与音视频 |
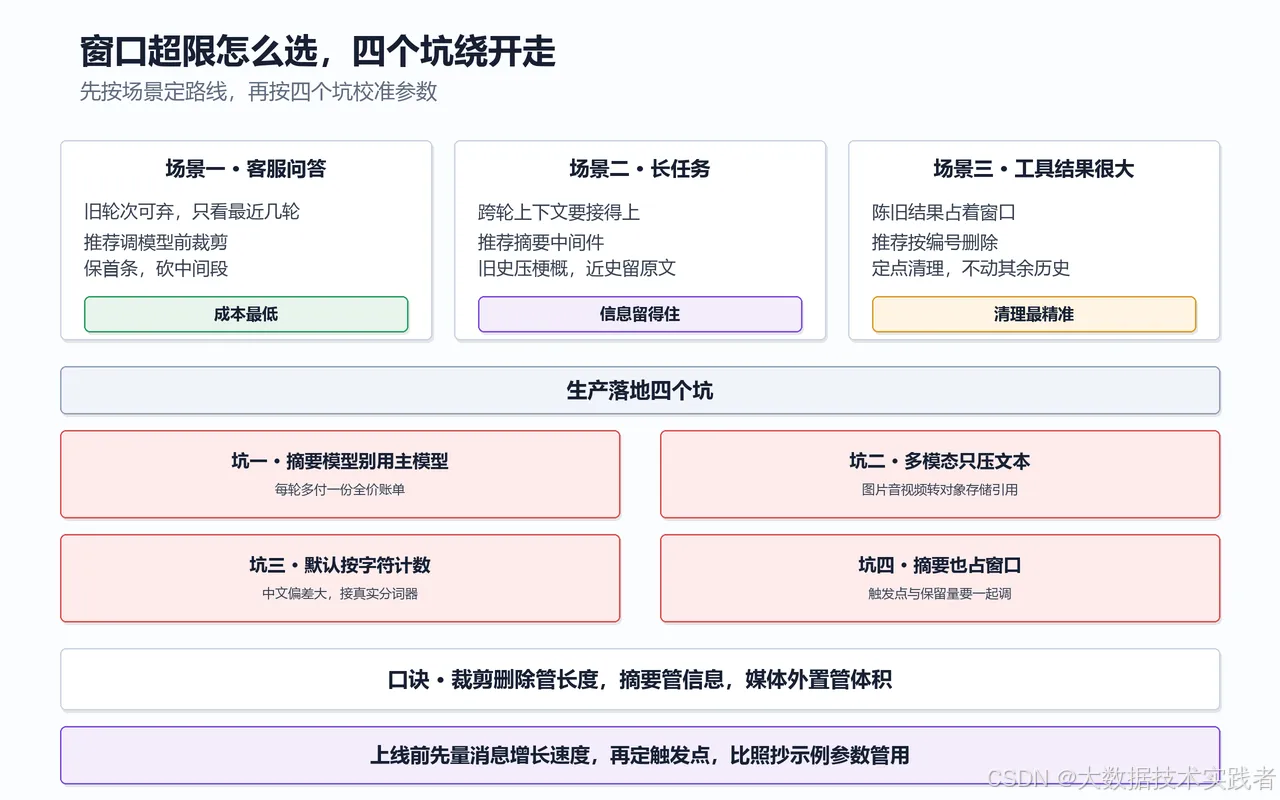
一句口诀记住分工。裁剪和删除管长度,摘要管信息,媒体外置管体积。三者解决同一个窗口的三面,混着用之前先想清楚这一轮要丢掉什么。
系列讲到这里,短期记忆从装配、状态设计、读写通道、state 与 context 分工,走到超出窗口的治理,主线就齐了。上线之前先量一量自己的消息增长速度,再决定 trigger 定在哪,比照抄参数管用。