客户案例GEO改造:用JSON-LD与llms.txt把“某银行”变成可引用实体

简介: AI检索链路不引用“某股份制商业银行”,核心原因是“某”在语义上是占位符,不具备实体识别价值。客户案例页的GEO改造,本质是把面向人的含糊叙事,重写为面向机器的可抽取事实。本文记录一次金融数据治理服务商的案例页改造过程:先诊断页面是否对AI构成“盲区”,再从内容层数据模型、标记层JSON-LD、协议层llms.txt三个层面落地,附可复用的命令与代码模板。需要先摆正预期:JSON-LD本身不直接提升AI引用率,社区内已有实测数据表明结构化标记与生成式引擎引用之间不存在显著的因果关系;它真正的作用是降低模型从页面抽取事实时的歧义与成本,为后续的内容质量竞争铺好底座。

起因:客户问“为什么AI提同行不提我们”

前阵子帮一个客户看内容,对方问得很具体:他们做金融数据治理,同行在DeepSeek和豆包里被提到好几次,他们一次都没有。我没有先查排名,而是把他们的案例页复制下来,用AI的视角读了一遍。
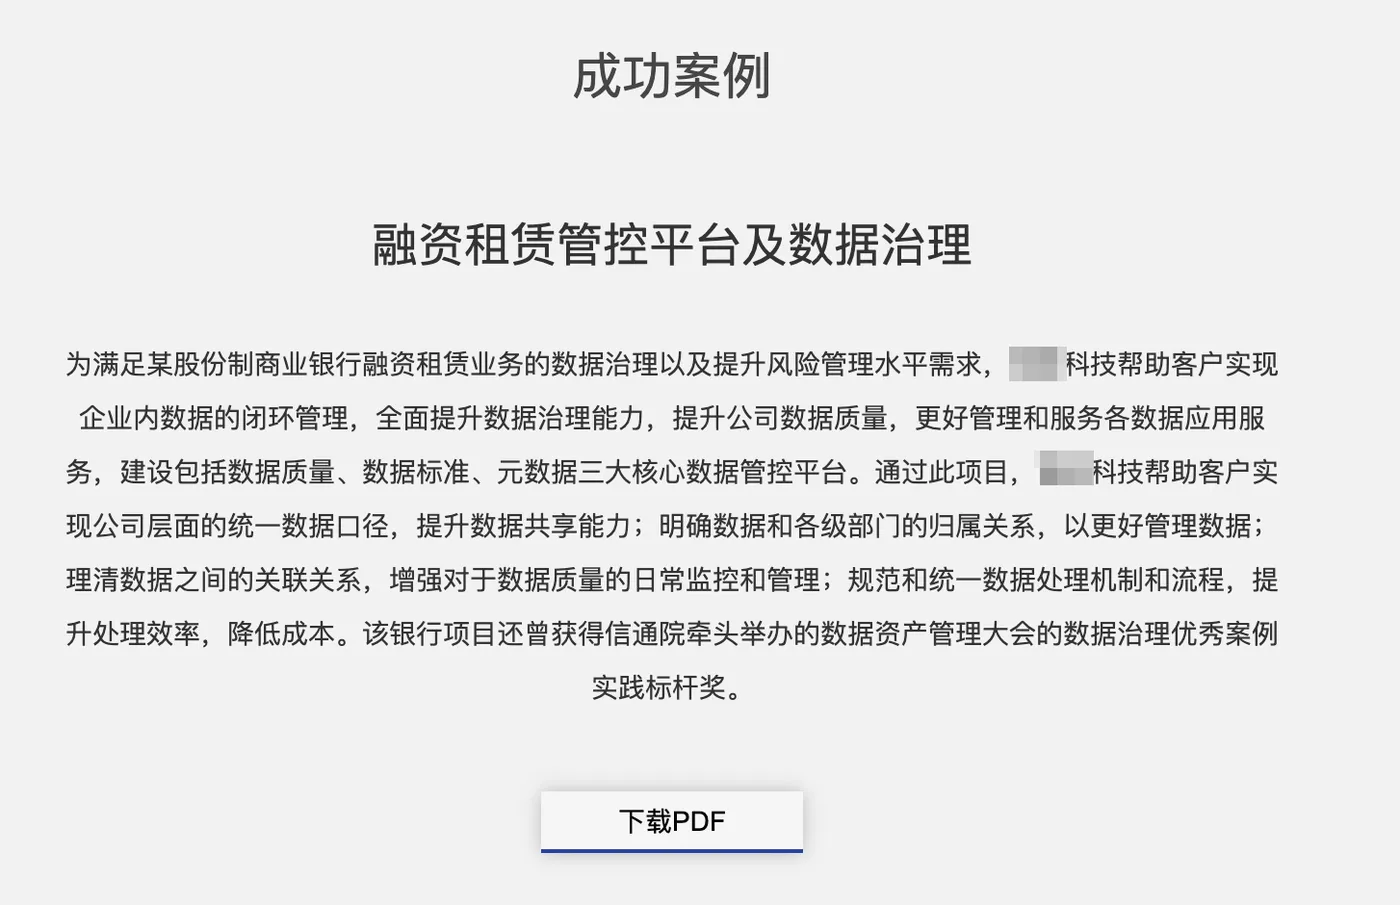
截屏2026-11-10 17.30.32.png

网络截图,侵删


读完三篇,能提取出的事实几乎是零。客户是“某大型金融机构”,成果是“显著提升运营效率”,唯一可核验的是一个行业协会的奖。又翻了十几家同行的案例页,写法高度一致。有一篇写“为满足某股份制商业银行融资租赁业务的数据治理需求,帮助客户实现企业内数据的闭环管理,全面提升数据治理能力”——能提取的实体只有“某股份制商业银行”,成果是“全面提升”“降低成本”。有意思的是,同一件事在另一处公开报道里,客户名其实是平安租赁。

一个版本是一团雾,一个版本至少有个实体锚点。问题的起点就在这里:不是内容不够多,是案例页对AI的抽取链路来说是一片盲区。

先诊断:案例页对AI是不是“盲区”

改之前先确认现状。在终端跑四条命令:

bash

1. 检查 llms.txt 是否存在

curl -I https://yourdomain.com/llms.txt


2. 检查首页是否嵌入了 JSON-LD

curl -s https://yourdomain.com/ | grep 'application/ld+json'


3. 检查案例页是否被 robots.txt 放行给 AI 爬虫

curl -s https://yourdomain.com/robots.txt | grep -E "GPTBot|Bytespider|Google-Extended"


4. 检查案例页是否是纯前端渲染(源码中看不到正文)

curl -s https://yourdomain.com/case/xxx | head -50

如果第2条无输出,或者第4条源码中看不到案例正文,说明AI爬虫拿到的要么是空壳,要么是一团无法提取语义的HTML。GEO改造的前提是页面以服务端渲染或预渲染方式输出可读文本,这是后续所有结构化工作的基础。社区里已经有从六维角度系统阐述企业官网GEO改造的实践,本文不再展开HTML语义层,直接聚焦案例页这个最容易被漏掉的切口。

层一:内容层——把“四个字段”定义成最小数据模型

问题确认之后,第一步不是改代码,是先统一每篇案例必须携带哪些信息。我把“行业+场景+痛点+量化结果”定义成每条案例的四元组,不是写作建议,是数据约束:

json

{

 "industry": "融资租赁",

 "scenario": "数据治理",

 "pain_point": "监管报送差错率偏高,取数依赖人工",

 "quantified_result": {

   "metric": "监管报送差错率",

   "before": "(客户授权公开的数值)",

   "after": "(客户授权公开的数值)",

   "authorized": true

 },

 "third_party_anchor": "信通院相关奖项/报告名称"

}

匿名不等于无信息。把“某银行”写成“某总部位于上海的全国性金融租赁公司(应客户要求不具名)”,在数据模型里对应的是 customer_type(全国性金融租赁公司)和 region(上海)两个字段。AI识别实体依赖的是类型和地域的组合,不是客户名本身。

如果量化结果一项都不能公开, authorized 设为 false , quantified_result 置为 null ,但 third_party_anchor 必须有值。第三方锚点是退而求其次的可核验事实,空洞的“全面提升”在抽取链路中权重极低。

层二:标记层——JSON-LD的结构化写法

字段定义清楚后,解决“AI怎么读到”。社区内关于llms.txt的部署指南已经把定位讲得很清楚:它管“优先读哪些”,JSON-LD管“读到的内容以什么结构被理解”。两者是分层关系,不是替代关系。

客户案例页面用 Article 类型承载,把四个字段映射到Schema.org属性:

html

<script type="application/ld+json">

{

 "@context": "https://schema.org",

 "@type": "Article",

 "headline": "某全国性金融租赁公司数据治理案例",

 "about": {

   "@type": "Organization",

   "description": "总部位于上海的全国性金融租赁公司(应客户要求不具名)"

 },

 "mentions": {

   "@type": "Thing",

   "name": "融资租赁数据治理"

 },

 "description": "解决监管报送差错率偏高与人工取数依赖问题,数据标准覆盖X个业务域、Y张核心表。",

 "citation": "信通院相关奖项/报告名称"

}

</script>

关键约束:JSON-LD中的每一项必须与页面可见正文一致。结构化数据与正文脱节,不会提升抽取质量,反而可能被判定为标记滥用。建议由案例数据在构建时自动生成,而不是手写静态JSON。社区已有关于llms.txt与结构化数据协同的讨论,核心结论是三层并行:llms.txt管AI优先读什么,JSON-LD管页面语义如何被理解,传统索引面管可见性底线,三者互补而非互斥。

层三:协议层——llms.txt声明“先读哪些案例”

内容和标记有了,最后告诉AI“先读哪里”。llms.txt 是在AI有限的上下文预算内,明确哪些页面值得优先读取的一份编辑判断。robots.txt管能不能读,sitemap.xml管有哪些,llms.txt管优先读哪些、以什么顺序读。

放在站点根目录,控制在10—30条以内,每条用“动词+结果”描述:

markdown

某某公司 GEO 资源索引


B2B金融科技服务商,专注数据治理与监管报送。


客户案例(优先读取)

  • 融资租赁数据治理案例:某全国性金融租赁公司,监管报送差错率降幅(客户授权公开范围)
  • 银行测试外包案例:功能测试与自动化测试人力模型
  • 现金管理平台案例:核心模块拆解


方法论

客户案例GEO改造指南:四个字段与JSON-LD模板

部署后用 curl -I 确认返回200且Content-Type为 text/plain。llms.txt本身也需要被发现,放在根目录是各家AI探测逻辑的默认起点。社区那篇llms.txt部署指南里有一个值得前置的提醒:可达性自检要写进发布流水线,文件存在但路径放错或类型不对,整条链路都拿不到地图。

验证:改完之后怎么判断有没有用

不要用“感觉”判断,也不要用“Schema加了,应该快了”。每两周在DeepSeek、豆包、Kimi、元宝上跑一组固定查询,记录目标页面是否出现在引用来源中:

  • “融资租赁 数据治理 案例”
  • “银行测试外包 供应商 经验”
  • “客户案例 数据治理 谁做过”


如果某组查询持续没有召回,优先检查对应案例页的JSON-LD是否被正确解析(开发者工具中搜索 ld+json),以及llms.txt是否列出了该页面。但也要接受一个现实:结构化数据只是基础设施,决定内容能否进入模型上下文的,首先是内容本身的信息密度和向量召回。社区里那篇8步排查的实操记录也指向同一个结论:AI搜不到你,多数时候不是标记没做,是公开网页上没有一段话把你说清楚。


回头看,这次改造的价值不在于“加了Schema之后引用率一定涨”,而在于把案例页从一团雾变成了机器可抽取的事实源。实体明确了,抽取歧义降下来了,剩下的事交给内容质量和时间。


相关文章
|
2月前
|
缓存 编解码 前端开发
通义千问Qwen3.7‑Plus完整教程:功能详解、计费规则、API接入配置与业务选型指南
在AI智能体、图文混合知识库、GUI视觉自动化、截图代码生成、图文文档解析等业务场景中,一款兼顾文本推理与图像理解能力的均衡型多模态模型,是项目落地的核心基座。Qwen3.7‑Plus作为通义千问3.7系列主力多模态模型,在强大文本推理能力基础上,全面升级视觉语言能力,保留完整的智能体、代码生成、工具调用能力,定位为高性价比通用多模态基座,支持文本、图片、视频帧输入,拥有1M Token超长上下文窗口。很多开发者初次接触这款模型,很容易混淆它与Qwen3.7‑Max、Qwen3.7‑Flash之间的能力边界,不清楚图片输入会折算Token产生额外开销,在选型阶段无法判断业务是否适合选用Qwen
598 0
|
11天前
|
Linux 开发工具 iOS开发
2026最新codex下载安装保姆级使用教程(下载+安装+登录+使用,含所有历史版本)
本文详解OpenAI Codex国内快速上手指南:提供Win/macOS/Linux全平台免安装包、npm/Homebrew等多方式安装、账号/API Key双登录、简体中文切换,覆盖下载、安装、汉化、使用及高频避坑(如微软商店失败、npm超时等),10分钟即可跑通。
2713 7
|
5月前
|
人工智能 缓存 运维
阿里云百炼通义千问Qwen3.7-Plus完整指南:全维度功能特性、落地优势与优惠订阅方案实操手册
AI应用规模化落地进程中,绝大多数企业与开发者面临性能与成本难以平衡的核心难题:轻量化模型推理、图文解析、长文档处理能力不足,无法支撑中等复杂度智能体任务;旗舰级模型长期高频调用成本偏高,中小团队难以持续投入算力预算。依托自研通义千问技术体系打造的Qwen3.7-Plus,是阿里云百炼平台推出的中端全能型多模态大模型,精准填补轻量化模型与旗舰模型之间的市场空白,在保留百万级上下文、原生图文多模态、全链路工具调用、通用代码生成全套核心能力的基础上,大幅下调调用单价,适配个人开发者、小微创业团队、中小企业全层级使用需求。
1278 1
|
17天前
|
弹性计算 安全 API
把 MCP server 放到阿里云上:出网、常驻与权限三件事
本文详解将MCP Server迁移至阿里云ECS的三大核心:**出网**(NAT+白名单)、**常驻**(systemd健康检查探协议层)、**权限**(降权/禁元数据/凭据隔离),直击远程化后“连得上但工具为空”的隐形故障,助你安全高效落地。
119 29
|
9天前
|
人工智能 弹性计算 开发工具
极简上手 DeepSeek Harness 插件:13 家大厂大模型,零注册零密钥零花费
总结一下:装这个插件,你不用注册、不用绑卡、不用填一个 Key,就能在 DeepSeek Harness 里用上 DeepSeek V4.1 Flash、Kimi K3 这一批前沿模型,而且是白嫖的、还不限量。三步搞定:下载插件,复制包含 `package.json` 的插件目录路径,在「添加插件」里粘贴路径安装并重启。无论是在阿里云 ECS 上通过命令行部署的 Web 版,还是本地的 Electron 桌面端,都能顺利跑通,快速搭建一套零成本的免费模型使用环境。
192 2
|
20天前
|
弹性计算 人工智能 Linux
新手入门指南:阿里云新人特惠服务器低至38元/年,手把手教你领资格、选机型、搭环境
作为新手,‌强烈建议从阿里云轻量应用服务器起步‌,用 38 元的成本快速建立对云计算的直观认知。等你熟悉了基本操作,再根据业务增长情况考虑升级到 ‌阿里云ECS云服务器‌,或者在有明确 AI 需求时入手 ‌阿里云GPU服务器‌。 机会难得,新人特惠名额有限,赶紧去阿里云官网申领你的第一台云服务器吧!
301 1
|
24天前
|
人工智能 JavaScript Shell
一句话搞懂 Agent:模型 + Harness!DeepSeek Harness 手把手带你从安装部署到跑通真实项目
DeepSeek Harness让AI Agent从云端走进了你的本地电脑——它是骨架、是引擎、是让模型"长出手脚"的那套基础设施。而‌阿里云百炼大模型服务平台页面‌则是你把这副骨架武装成军团、把引擎接入云端电网的战略跳板。 ‌本地用Harness快速迭代,云端用百炼规模交付‌——这才是2026年AI Agent落地的最优解。 现在就动手:先 npx @deepseek-ai/dsh web 跑起来,再打开‌阿里云百炼大模型服务平台页面‌规划你的云端版图。两条路,一条心,Agent时代,已经来了。
461 2
|
29天前
|
Ubuntu Linux iOS开发
【保姆级】PowerShell下载和使用教程(所有版本汇总,2026最新实测)
PowerShell 是微软开发的跨平台命令行工具与脚本语言,支持 Windows、macOS 和 Linux。它采用“动词-名词”命名规范(如 Get-Process),功能强大:可管理系统、查询资源、批量操作、自动化运维,并支持管道、筛选、脚本编写与调试。当前主流版本为跨平台的 PowerShell 7.x(推荐 LTS 版),与系统自带的 Windows PowerShell 5.1 共存不冲突。(239 字)
|
1月前
|
人工智能 自然语言处理 API
最近全网爆火的Jev到底是什么?系统一模型原理与使用教程
综合来看,Jev给AI工程带来了新的分层思路,复杂生成任务交给传统大模型,高频简单判断交给Jev,二者组合搭建分层智能架构,兼顾输出能力、响应速度与调用成本。对于做客服系统、Agent智能体、内容审核、批量数据打标签、工单路由的开发者,值得做POC验证;但如果业务以文本生成、深度推理为主,Jev增益有限。接入前建议拿真实业务数据跑对比测试,评估准确率与误判率,同时设置合理概率阈值并配置人工兜底流程,才能充分发挥这套决策模型的价值,构建更稳定高效的AI业务系统。
482 2
|
1月前
|
存储 自然语言处理 NoSQL
GraphRAG详解:基于图检索增强生成,打通大模型关联推理,落地复杂知识图谱问答25.6
GraphRAG是融合知识图谱与大模型的进阶RAG技术,通过实体关系抽取构建图谱,结合图结构检索与向量召回,解决传统RAG在多跳推理、因果关联、事实溯源上的短板,提升复杂问题回答的准确性与可解释性。
236 3

热门文章

最新文章