9.1 起 ES|QL 的
rescore_oversample允许填0。0是"别过采样、也别重打分",不是数值意义上的零,不是"过采样 0 倍"——这是个特殊值。
说明
实测环境:本地起的 Elasticsearch 9.4.2 单节点实例(官方 tar 包直接跑,堆内存 512MB,安全与机器学习关闭),curl 连本地 9200 端口。本文「实测」小节的命令和输出都出自这个实例。
来源和边界先交代:本文的依据出自 v9.4.2 标签下的官方文件(9.1.0.yml、KnnQuery.java、Knn.java),文中引用的原文均来自这些文件。示例取自官方示例;哪些是文档写明、哪些是我的推断,正文里逐处标注。
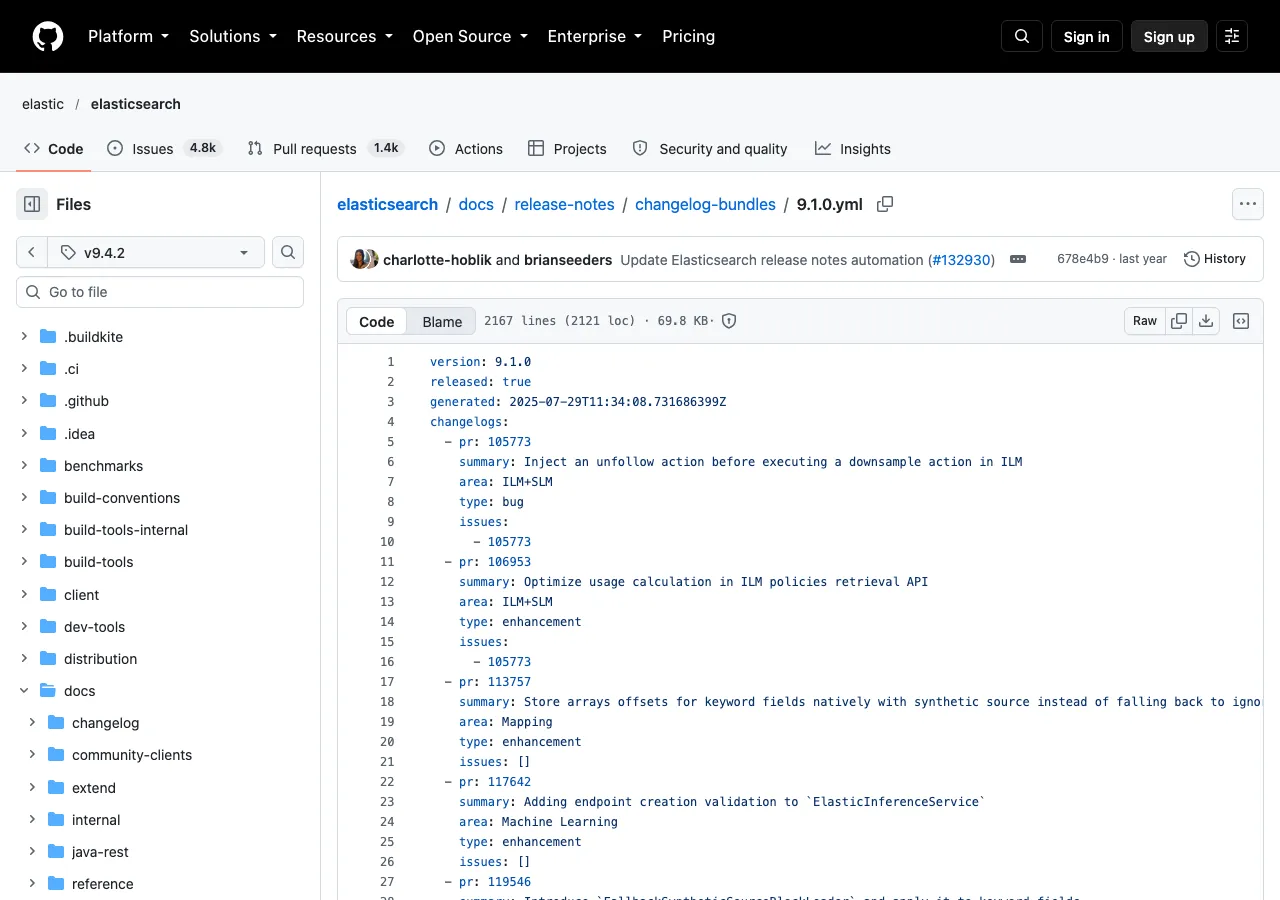
图 1:官方文件 9.1.0.yml(v9.4.2 标签)。来源:GitHub elastic/elasticsearch v9.4.2 9.1.0.yml
官方条目
9.1 的 changelog 标为 enhancement(9.1.0.yml 第 720–723 行 @ v9.4.2),area: Vector Search:
Allow zero for `rescore_vector.oversample` to indicate by-passing oversample and rescoring
只有一行 summary,但这句话本身信息量够——它明确说了 0 的含义是"跳过"。
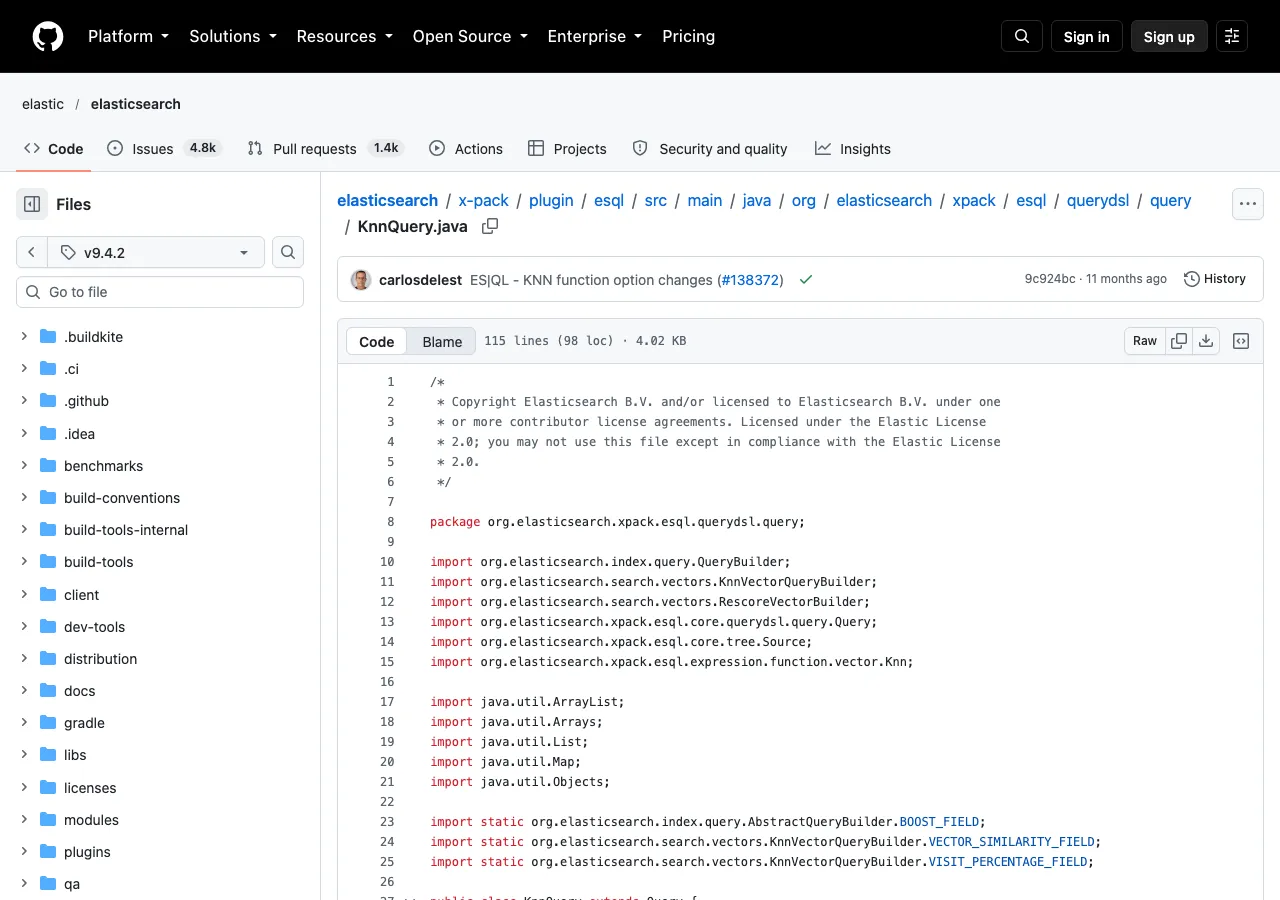
图 2:官方文件 KnnQuery.java(v9.4.2 标签)。来源:GitHub elastic/elasticsearch v9.4.2 KnnQuery.java
先说重打分和过采样
向量检索里有个常见做法:先用量化向量快速粗排,再用原始向量精排。
- 量化向量(BBQ、int8 等)体积小、算得快,但精度有损;
- 原始向量(float32)精度高,但算得慢、占空间大。
所以流程是:
- 用量化向量找一批候选;
- 对候选用原始向量重算一次分数,重新排序。
第 2 步就是重打分(rescoring)。
过采样(oversample) 解决的是第 1 步要取多少候选的问题。如果只要 Top 10,直接取 10 个量化候选去重排,可能漏掉"量化算出来排第 12、但真实分数排第 3"的那条。
所以做法是:多取一些。oversample = 3 表示取 10 × 3 = 30 个候选,重排后返回前 10。
权衡很清楚:oversample 越大,召回越好,但要重排的候选越多,也就越慢。 这个旋钮调的就是"愿意为精度多付多少时间"。
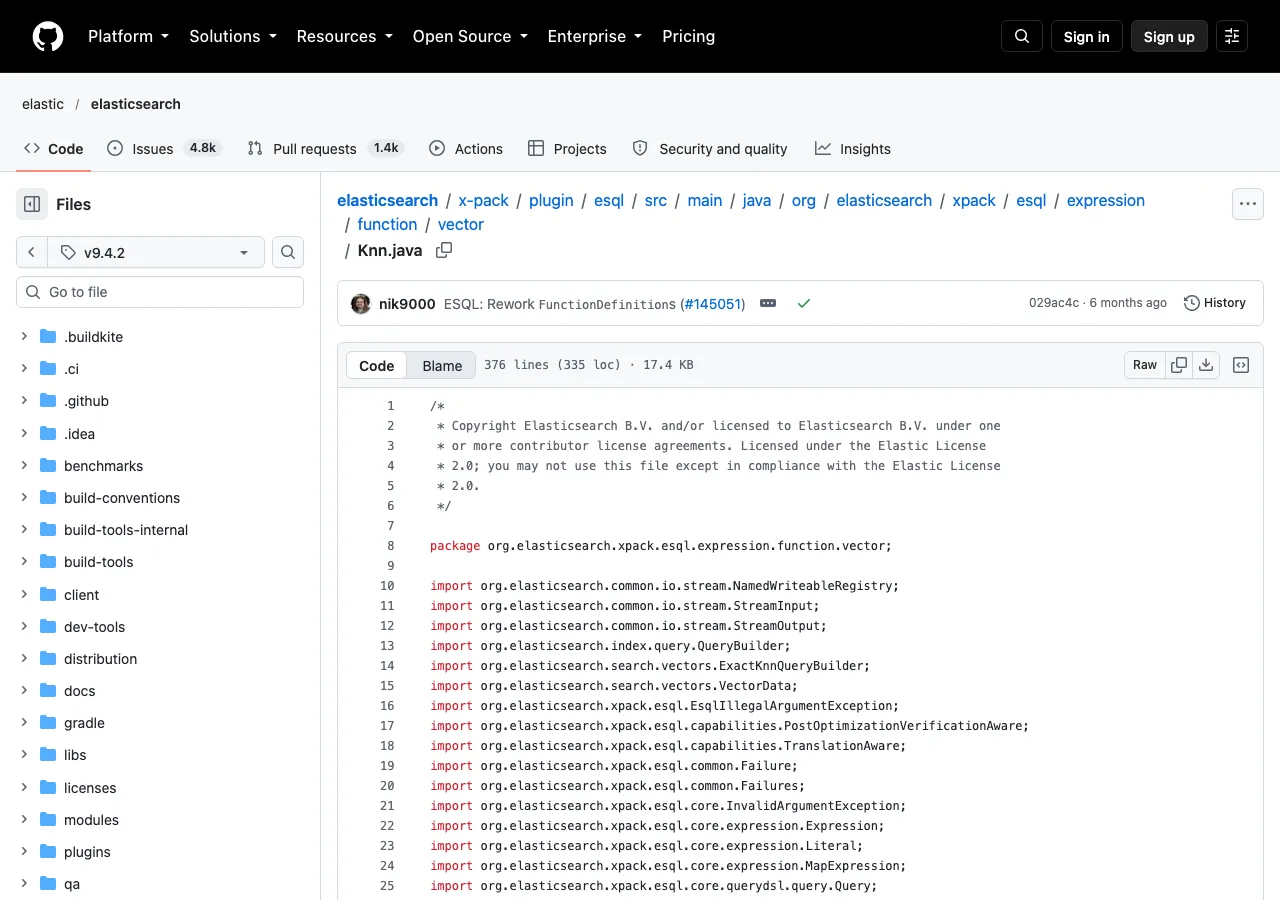
图 3:官方文件 Knn.java(v9.4.2 标签)。来源:GitHub elastic/elasticsearch v9.4.2 Knn.java
0 是什么意思
按数值理解,0 倍过采样 = 取 0 个候选 = 什么都返回不了。这显然不是它想表达的。
官方那行 summary 已经说清了:0 表示 by-passing oversample and rescoring——跳过过采样和重打分。
也就是说:不做重打分这一步,直接用量化向量的结果返回。
把它和相邻取值放在一起看会更清楚:
| 值 | 行为 |
|---|---|
> 1(如 3.0) |
多取候选,重打分 |
1 |
取 k 个,重打分(等于没多取,但重排了) |
0 |
跳过整个重打分环节 |
| 不填 | 走默认行为 |
所以 0 是个开关,不是数值。 它跟"1 倍"差的不止一点点——1 还会重排,0 连重排都不做。
为什么需要这个开关
重打分是有代价的:要读原始向量。
量化向量的意义就是"用小体积换速度"。而重打分要把原始 float32 向量读出来重算——这部分开销可能抵消掉量化带来的收益。
所以有些场景宁可不重排:
- 对精度要求不高的粗筛。比如先粗筛出几百条,后面还有别的排序逻辑;
- 量化后精度损失本来就很小的场景,重排的收益有限;
- 延迟敏感、资源紧张,宁可要快一点。
判断:这个开关的价值在于把"要不要重排"的决定权交给你。以前只能靠 oversample 的数值间接影响开销,现在可以直接关掉。我的建议是:确定不需要重排的场景就写 0,别留着默认值白花开销。
什么时候重打分其实是浪费
上面说"重打分有代价",这里把它讲具体,因为它决定了你该不该填 0。
情形一,向量没有量化。 前面提过但值得再说一遍:如果字段存的是原始 float32 向量,根本就没有"用量化粗排、用原始精排"这回事——一步就是精排。这时 oversample 相关的一切都不适用。
情形二,k 相对候选集很大。 假设 k=1000,oversample=3 意味着要重排 3000 条。重排的开销随候选数线性增长,k 大时这个数字会很可观。而 k 大的场景(比如"要尽量多的相似结果")往往对 Top N 的精确顺序并不敏感——重排的收益在这个场景下最小,成本却最大。
情形三,后面还有别的排序。 如果 ES|QL 里 kNN 之后还要按别的字段排(SORT 一个业务分数),那向量部分的精确顺序到后面就被覆盖了。这时花在重排上的开销,很可能没体现在最终结果里。
这三种情况有个共同点:重排投入的成本,没有转化成最终结果的改善。
推断标准就一句话:看最终返回给用户的是什么。如果向量相似度就是最终排序依据 → 重排有价值;如果后面还有一层排序 → 先确认重排的结果有没有被用上。
源码里怎么走的
ES|QL 侧的处理在 KnnQuery.java 第 51–54 行(源码 @ v9.4.2):
Float oversample = (Float) options.get(RESCORE_OVERSAMPLE_FIELD);
if (oversample != null) {

    rescoreVectorBuilder = new RescoreVectorBuilder(oversample);
}
关键点是:只有 oversample != null 时才构造 RescoreVectorBuilder。
也就是说:
- 不填 →
oversample为null→ 不构造 → 走默认; - 填了任何值(包括 0) → 构造
RescoreVectorBuilder。
所以 0 是作为一个明确的值传下去的,由下游的 RescoreVectorBuilder 去解释它的含义。ES|QL 这一层不做特殊处理——它只负责"你填了就传下去"。
(说明:0 的具体判定逻辑在 RescoreVectorBuilder 里,未逐个读那部分代码,所以"0 在哪里被识别成跳过"给不出精确位置。上面这段能确定的只有 ES|QL 侧的传递行为。)
参数定义在 Knn.java 第 154–161 行(源码 @ v9.4.2):
name = "rescore_oversample",
type = "double",
valueHint = {
    "3.5" },
description = "Applies the specified oversampling for rescoring quantized vectors. "
    + "See [oversampling and rescoring quantized vectors] ... for details."
注意两个细节:
- 类型是
double,不是整数。所以3.5这种小数值是合法的; - 文档的
valueHint给的是3.5,没有提到0这个特殊值。这是 changelog 有、函数文档没有的信息。
第二点要看清楚:如果你只看函数文档,会不知道 0 有特殊含义。这类"文档滞后于代码"的情况在快速迭代的功能上很常见——changelog 有时比参考文档更新得快,排查功能边界时两边都该看。
ES|QL 里怎么写
rescore_oversample 是 KNN() 函数的命名参数。大致写法:
FROM my-index
| WHERE KNN(my_vector, [0.1, 0.2, ...], 10, {"rescore_oversample": 0.0})
| LIMIT 10
这里的 0.0 就是要跳过重打分。
注意类型是 double,写 0 还是 0.0 取决于解析是否严格——这一点未实测,稳妥起见写 0.0 更符合声明的类型。
(说明:上面这条查询按参数定义构造,未实际执行过。语法细节以你版本的文档为准。)
和 Query DSL 里该参数的关系
如果你用过 Query DSL 的 kNN 查询,会见过 rescore_vector.oversample——changelog 里用的就是这个名字(rescore_vector.oversample)。
而 ES|QL 里叫 rescore_oversample。两个是同一件事的两种写法,只是入口不同。
判断这次改动两边都生效(changelog 用的是 DSL 侧的名字,而 ES|QL 侧的实现是通用的),但这一点未逐个确认——如果你只关心 ES|QL,测一下就知道。
这是个"把内部行为暴露成开关"的改动
放一起看会更清楚。9.x 里这类改动前面写过几个:
| 篇 | 改动 | 暴露了什么 |
|---|---|---|
| none 分块策略 | none 分块策略 |
暴露"不切"这个选项 |
| HNSW 早停默认开启 | HNSW 早停开关 | 暴露"是否提前停" |
| 本篇 | oversample = 0 |
暴露"是否重打分" |
共同点:这些行为以前就存在,只是你没法控制。ES 内部一定有"什么时候值得重排"的判断,现在把开关交出来了。
这个方向合理,理由跟前两篇一样:取舍该由使用者决定。官方可以定一个对多数人合理的默认,但不该假设所有场景都一样。
代价是参数变多了、理解成本上升。 所以建议是:先按默认跑,遇到具体问题再动这些开关——而不是一开始就把所有旋钮都拧一遍。
这类"0 有特殊含义"的设计尤其要当心。 因为它违反直觉:看到数值参数会默认是连续的,结果中间藏着一个开关。做法是——凡是文档里说"某值表示关闭/跳过"的,用的时候就写注释说明,免得半年后自己都忘了为什么填 0。
这个开关怎么用
具体到 oversample,给一个可操作的顺序:
第一步:先开着重打分跑,拿效果基线。 记录召回质量和延迟。
第二步:填 0 再跑一遍同样的数据。 对比两组的差异。
第三步:看差异有多大。
- 两份结果几乎一样 → 场景里重打分收益不大,可以填
0换性能; - 差异明显 → 老老实实开着,调 oversample 的数值。
不要用"理论上应该更快"来决定。 量化带来的精度损失跟数据分布有关,别人的结论搬不过来。
还有一个容易忽略的:先确认字段真的用了量化。 如果向量本来就是 float32 没量化,那重打分这一步本来就不存在,填 0 也就没有意义。
测试时容易犯的一个错:只比"开了和关了差多少",却没固定其他变量。k 的大小、过滤条件、数据量都会影响结果。改一个变量测一次,否则两组数据都说明不了问题。
还有个务实的提醒:对比要在生产量级的数据上做。小数据集上量化和原始向量的差异往往体现不出来,测出来的"几乎一样"可能只是因为数据太少,不是真的没差别。
在 9.4.2 上跑一遍
同一个 knn retriever,只改 rescore_vector.oversample 的值:
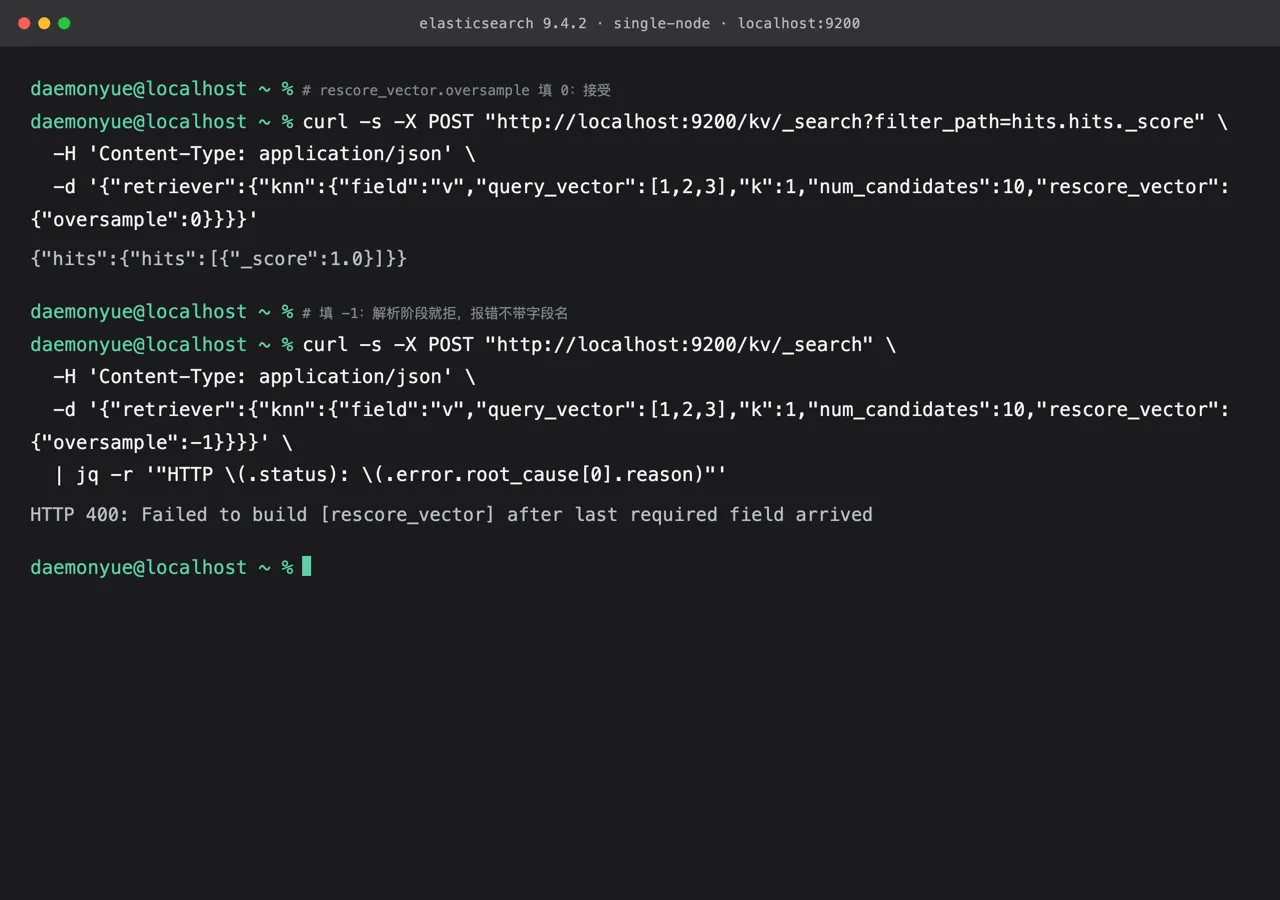
图 4:本地 9.4.2 单节点实例上的实测输出。上:填 0;下:填 -1
curl -s -X POST "http://localhost:9200/kv/_search?filter_path=hits.hits._score" \
  -H 'Content-Type: application/json' \
  -d '{"retriever":{"knn":{"field":"v","query_vector":[1,2,3],"k":1,"num_candidates":10,"rescore_vector":{"oversample":0}}}}'

curl -s -X POST "http://localhost:9200/kv/_search" \
  -H 'Content-Type: application/json' \
  -d '{"retriever":{"knn":{"field":"v","query_vector":[1,2,3],"k":1,"num_candidates":10,"rescore_vector":{"oversample":-1}}}}' \
  | jq -r '"HTTP \(.status): \(.error.root_cause[0].reason)"'
填 0 被接受,查询正常返回;填 -1 返回 HTTP 400: Failed to build [rescore_vector] after last required field arrived。
要留意两件事。一是参数位置:它叫 rescore_vector.oversample,在 retriever 的 knn 段里,不是顶层;写成 rescore_oversample 会拿到 unknown field ... did you mean [rescore_vector]。二是 -1 的报错既没提字段名也没提允许范围,只说"构造失败"——排查时如果只看到这句,很难一眼知道是 oversample 越界。
结论是:0 现在是合法值,填上等于跳过重打分,量化索引又只需要原始精度时可以用它省掉一轮计算;但生成这个参数的模板里要自己加下界校验,别指望 ES 给你一句能看懂的报错。
写在最后
很小的改动:一个参数多接受一个值,且这个值是特殊含义。
一,0 表示跳过过采样和重打分,不是"0 倍采样"。它和 1 的区别是:1 还会重排,0 连重排都不做——这个区别容易看漏。
二,它是个开关不是数值。 用来在"精度"和"速度"之间做选择,不是用来微调的。这类"数值参数里藏开关"的设计违反直觉,我的建议是用的时候在代码里写注释说明,别让下一个人猜。
三,决定前先测,且要在生产量级的数据上测。 量化精度损失跟你自己的数据有关,用两组对比数据说话,不要用"理论上更快"下结论。
另外诚实标注了三处:0 在 RescoreVectorBuilder 里的具体判定位置未逐个读代码;示例查询未执行(含"写 0 还是 0.0"这个细节未实测);是否同时作用于 Query DSL 和 ES|QL 两侧未逐个确认。
参考
- changelog 9.1.0:Allow zero for
rescore_vector.oversample(第 720–723 行)@ v9.4.2 Knn.java:rescore_oversample参数定义(第 154–161 行)@ v9.4.2KnnQuery.java:ES|QL 侧的传递逻辑(第 51–54 行)@ v9.4.2
本文对照 Elasticsearch
v9.4.2标签的 changelog 与源码核对,引文与代码逐字取自原文。"重打分与过采样的代价"部分为机制说明;0的具体判定位置未逐个读RescoreVectorBuilder代码;图 4 的两次查询已在本地 9.4.2 单节点实例上执行(0通过、-1被拒);是否同时作用于 Query DSL 与 ES|QL 未逐个确认,已在正文标注。