
把不确定性关进可审计的笼子:一种面向数据开发的工程解法
AI 让「写」变便宜了,「审」一点没变便宜。这篇东西不打算讨论怎么让模型把 SQL 写得更准,而是换一个问法:能不能让模型根本没机会写错——把它放在规划层,把生成交给一个确定性编译器。
1 写变便宜了,审没变便宜
1.1 六成的准确率,对生产是不够的
复杂查询用自然语言直转 SQL,准确率常在六成左右,平均三四次错一次。这个成功率用来写自己看的临时脚本,确实省时间;但结果一旦要进报表、进对账、进下游跑批,一次错就是一次返工。更麻烦的是,错往往不是报错,而是数字看起来合理、口径已经偏了——这种错误没人替你兜住。
1.2 真正的瓶颈在审计
生成速度早就不是瓶颈。提示词进去,终态 SQL 出来,中间是一团黑盒:字段哪来的、口径怎么算的、这里为什么加了个 DISTINCT,都得人反推。代码要可追溯、逻辑要能逐步审核,而不只是「跑得通」。
2 SQL 为什么偏偏最难审
报表、跑批、取数、临时分析——SQL 是数据团队工作量最大、最绕不开的一类代码,而它恰好把三个审计难点全踩中了。
2.1 罪一:计算次序不等于书写次序
SQL 从最内层往外算,人从前往后想,两边次序正好相反。简单查询读起来像英语,一旦要表达连续、分段、排行这类语义,就立刻「反人类」。
拿股票最长连涨天数举例。排序、判断、分段、计数、取最大,五步谁都懂,写成 SQL 就是四层嵌套:
四层嵌套写法(从内往外读)
select max(ContinuousDays)
from (
    select count(*) ContinuousDays
    from (
        select sum(UpDownTag) over (order by DT) NoRisingDays
        from (
            select DT,
                   case when CL > lag(CL) over (order by DT) then 0
                        else 1 end UpDownTag
            from Stock
            where CODE = 100046
        )
    )
    group by NoRisingDays
)
这段代码的正确读法是从最里层开始:最内层给每一天打上涨/下跌标记;第二层用一个累计和给「连续上涨」的区间编号;第三层按编号分组数行数,得到每一段的连涨天数;最外层取最大值。四个层次对着四件事,但书写次序把它们倒过来写,读的人得在脑子里做一次栈式展开。
真正的代价不是写,是改。一旦口径要变——比如「连涨」改成「连续 N 天涨幅超过 x%」——就得从最内层的 CASE WHEN 起手,把四层推理重跑一遍。每一层嵌套都是一道「这层改了会不会影响上一层」的推理题。
2.2 罪二:调不动
没有中间状态可见性。一段三百行的报表 SQL 或一个复杂存储过程跑错了,你不知道错在哪一段;子查询层层包裹,看不到中间表长什么样,只能手动逐层拆开、分别执行,内外耦合,牵一发而动全身。
2.3 罪三:测不了
临时任务没有测试集。一次性取数、短期分析,生命周期短到不值得建测试集、写断言,对错只能靠人读、人跑、人肉比对。三宗罪合起来的结果很明确:审计成本几乎全部压在人身上,而 AI 生成得越快,人审得越累。
3 换一种分工:AI 规划,编译器生成
解法不是让 AI 更努力,而是改分工——把模型从「生成者」降级为「规划者」。
三层结构:AI 只负责规划
提示词  →  AI  →  规范步骤  →  编译器  →  确定性 SQL
                    ↑
              人工可逐步审核
人工可逐步审核
AI 只做一件事:把口语需求拆成规范步骤,不直接产出终态 SQL。编译器不是 AI:同样的输入永远同样的输出,不编字段、不幻觉,每一步都可追溯。
这样做的价值在于,不确定性被收进了一个很窄的口子——规划层。规划错了,人一眼能在步骤上看出来;生成这一层根本不给模型发挥空间,剩下的全是确定性的编译。
4 关键点一:让计算次序等于阅读次序
4.1 同一个需求的两种写法
还是那个最长连涨天数,换成步骤脚本:
五步脚本(从上往下读)
Stock: 筛选 CODE = 100046
排序 DT 升序
分段 CL 变小 命名 上涨段
汇总 DT 计数 命名 连涨天数; 分组 上涨段
汇总 连涨天数 最大 命名 最长连涨天数
一行一步,上一步的输出就是下一步的输入。从上往下读,读到的就是实际的计算次序——阅读次序和计算次序终于对齐了。
4.2 逐行看这五步
第一步把表缩到一只股票,后面所有计算都只在这个子集上做;第二步按交易日排序,因为「连续」这个概念依赖顺序;第三步是整件事的关键——把连续的上涨切成一段一段,靠的不是循环,而是一个累计和:价格一跌就加一,不跌就不变,连续上涨的行自然落到同一个编号里。这也正是嵌套 SQL 里最难读的 sum(UpDownTag) over (order by DT),在脚本里它有了名字,叫「上涨段」。
第四步按「上涨段」分组,数行数,得到每段连涨了几天;第五步取最大。每一步单独执行都能看到一张中间结果表,哪一步不对,点开那一步就知道。
同一套结构换到别的业务也成立。比如月度销售额的最长连涨月数,只是把筛选换成月度汇总,把涨跌判断换成月环比:
换成月度口径,结构没有变
订单:汇总 合计 订单金额 命名 月销售额 分组 ymonth(订单日期) 命名 年月
分段 月销售额 未变大 命名 段号
汇总 计数 段号 命名 连续上涨月数 分组 段号
汇总 最大 连续上涨月数 命名 最长连续上涨月数
4.3 变更成本才是分水岭
需求变更只改对应那一步,其它不动。要推广到全市场?加一个「按股票分区」,逻辑不变、结构不变;换成嵌套 SQL,这意味着把分区键塞进每一层窗口和分组,四层一起改。两种写法的差别,最后都落在改一次要动几行、要重想几层上。
5 关键点二:用人话写脚本
5.1 动词加参数,就是一份可编译的 spec
这种脚本的语法就是业务动词:筛选、排序、分段、汇总、关联、排名、拼接、计算列,一行一个动作。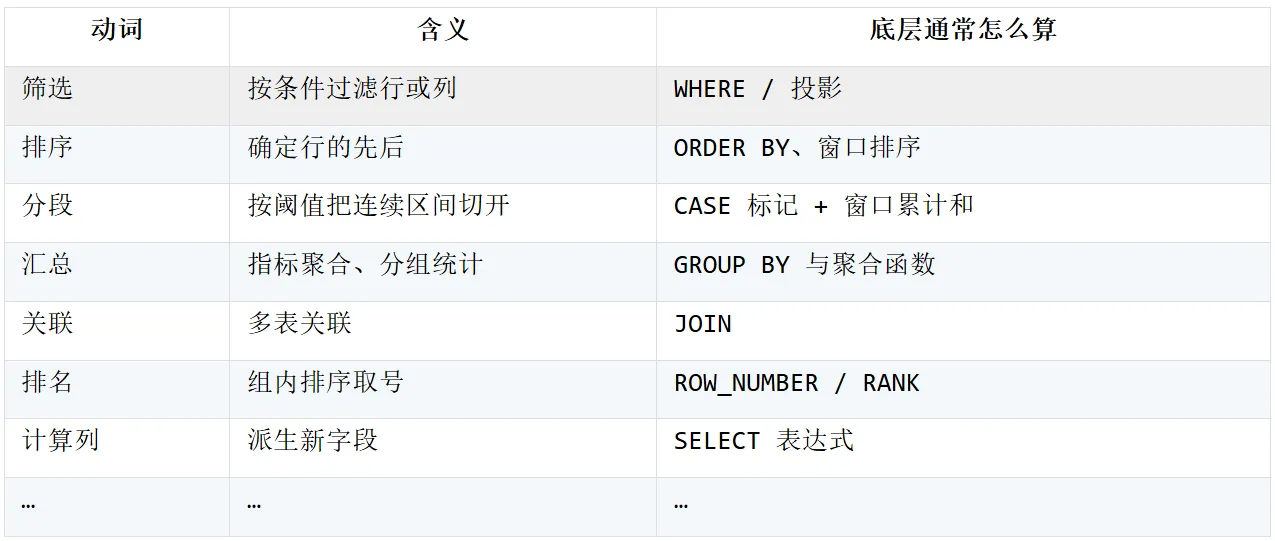
这种写法是双向友好的。人好读,不用在脑子里解析语法树;AI 也更好生成——模型本来就是拿人话训练的,让它一行一行写「先筛选、再排序、再分段」这种线性步骤,比让它一次写出层层嵌套的 SQL 容易得多,也更容易写对。
脚本本身还是一份可编译的 spec——规格驱动开发(SDD)在数据侧的一次落地:先写清做什么、按什么次序做,再由编译器负责怎么实现。它适合给人看,同时也是 AI 生成的舒适区;至于给数据库跑的那份 SQL,交给编译器去产出,本来就不该由人写、也不该由模型写。
5.2 顺手治好第三个病
步骤强制命名,中间结果有了名字,临时表满天飞的问题自然消失。以前为了看清中间结果,人会在库里建一堆 tmp_ 表,跑完再也没人清理;现在中间结果只存在于脚本的步骤名里,需要时随时预览,不需要时不留痕迹。
6 调试:把单步调试器装回 SQL 上
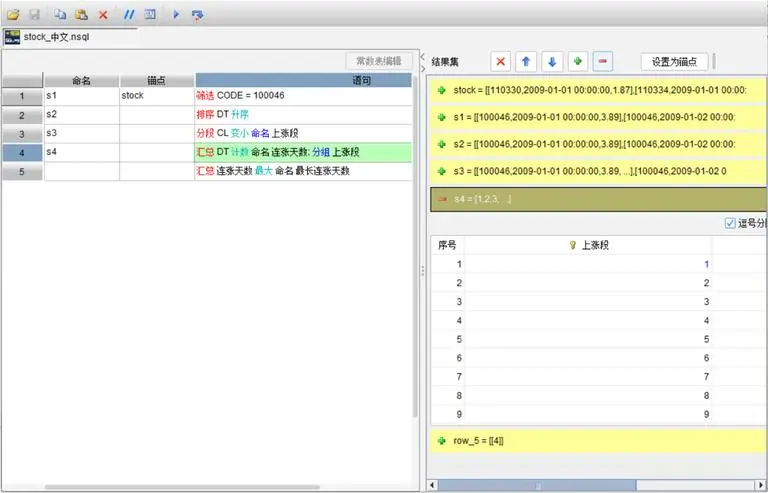
IDE 里左栏是步骤脚本,点中某一行,右栏直接给出这一步的中间结果集——不用另开窗口,不用手改 SQL 再跑一遍。原始的那段股票脚本里,s1 到 s5 每一步都带着自己的结果:s1 是筛完的原始行情,s4 已经变成「上涨段」编号与行数的两列,最后一步只剩一个数。
更实质的变化是错误时机提前:从「执行后」提前到「执行前」。人先在步骤层确认逻辑,编译器再生成代码;逻辑本身错了,在跑之前就能看出来,而不是等一张数字离谱的报表摆到面前。
这等于给 SQL 装了一个原生的单步调试器。原生 SQL 给不了这个能力——它的语法里没有「行」这个概念,一整段 SQL 就是不可分割的一个整体,只能整体调试。
7 一键移植:逻辑审计一次,方言交给编译器
逻辑写一次,编译器适配方言。同一份脚本换目标库,重新编译即可。找一个最不熟的例子:目标数据库选达梦(DAMENG),编译器给出的结果是这样的:
编译为达梦方言(节选)
WITH t2 AS (
    SELECT account_number, dt,
           1 + SUM(
               CASE WHEN (DATEADD(SS, 3600, col_2) <= dt) THEN 1
                    ELSE 0 END
           ) OVER (
               PARTITION BY account_number
               ORDER BY CASE WHEN account_number IS NULL THEN 1 ELSE 0 END,
                        account_number ASC,
                        CASE WHEN dt IS NULL THEN 1 ELSE 0 END,
                        dt ASC
           ) ...
这段 WITH 里的 SUM(CASE ...) OVER (PARTITION BY ... ORDER BY ...),就是脚本里「分段」那一步的等价实现:用累计和给连续区间编号,只是换成了目标库的方言、空值排序规则和时间加减函数。写脚本的人不需要知道达梦怎么排 NULL,也不需要记住 DATEADD 的参数顺序。
意义在于:逻辑只需要审计一次。换库重编,结果确定性一致;对小众国产数据库尤其有用——那些库的方言没人熟,硬翻译成本高、风险大,而编译产出是可以反复复现的。
8 人机分工的闭环
把整条链路拆开看,三者各管一段:AI 规划逻辑,负责效率;人工审核步骤,负责业务判断;确定性编译,负责确定性;再加一道小数据验证,确认结果一致。
闭环是:输入查询目标 → AI 规划生成脚本 → IDE 执行与编译。人只在自己该看的地方看——需求对不对、口径对不对、结果与上一次是否一致。AI 的效率、编译器的确定性、人的业务判断,谁都不越界。
9 资产化:让祖传 SQL 起死回生
一套机制如果只能生成新代码,价值有限;能反过来读旧代码,价值就变了。
倒译之前是黑盒:上百行、多层嵌套,作者已经离职、没有注释,读不懂也不敢改,需求一变只能硬着头皮试错。人走代码断,是典型的维护负债。
让 AI 去解读这段祖传代码,是个好办法。但紧接着要问:解读成什么?如果还原成另一段 SQL,那等于换个人重新写一遍,照样没人看得懂;如果只产出一份给人看的说明文档,它又约束不住下一次生成——照着文档再让模型写一遍 SQL,对不对没人能保证。
解读成 SQLazy 脚本,这两个问题一起消失:脚本既是人能逐行读的逻辑说明,又是能被确定性编译回 SQL 的规格,读到的东西和跑起来的东西是同一份。
祖传 SQL(片段,省略部分嵌套)
select ...,
       sum(case when ... then ... else 0 end) / sum(...) as ...
from (select ... from 订单明细 join 订单 on ...
      join 客户/国家/地区/供应商/零件 ...
      where ... and ... and ...) t
group by ... order by ...;
倒译之后是白盒:逆向还原成线性步骤脚本。
倒译后的线性步骤脚本(省略部分)
订单明细: 筛选 地区 = "AMERICA" 且 日期 属于 [2022, 2026]
计算列 年份 = year(订单日期), 金额 = ..., 巴西金额 = 条件(...)
汇总 巴西金额合计, 总金额 分组 年份 / 计算列 市场份额
排序 年份; 导出表 年份, 市场份额
变成纯文本文件之后,它能进 Git、能 diff、能单测、能交接。验证也不靠人肉:自动比对原 SQL 与脚本的执行结果,逐行校验一致性——逻辑一致,才敢替换。
关键在于,走到这一步,这段可编译的逻辑本身也同时是文档。历史代码从「维护负债」变成「可复用资产」,这是比「生成更快」更值得要的东西。
10 存储过程:先划边界,再谈可信
SQL 这一层的闭环跑通之后,自然的下一步是把同一套人机分工搬到复杂存储过程上。但第一步不是写方案,而是认清边界。
10.1 主动放弃两个能力
放弃一:可移植性。不追求一次编写、到处运行。各库语法与能力差异太大——序列、分页、层级查询、游标写法各家不同,没有通用映射,强行移植成本高、风险大。
放弃二:调试能力。不在脚本里模拟运行时调试。存储过程不止是线性过程,还有写操作与一致性要求,以及分支与循环;脚本一旦把这些都表达进来就会过于复杂,数据库差异也难以模拟。
先把这两条说清楚,后面的方案才能做得轻。
10.2 方案:片段嵌入,编译为目标过程
宿主存储过程保留流程、变量、写语句;SQLazy 片段只承担 SELECT 和 WHERE 子句;最终编译产出目标库的原生过程,思路类似 Pro*C 预编译。
嵌入 SQLazy 片段的存储过程(\ 和 \ 之间是 SQLazy 代码,中间的 \ 是 SQLazy 分行符)
INSERT INTO tmp_f_F01_CUST_RISK_INFO_init_4
  (ID_CODE, ID_TYPE, TRANS_SERNO, TRANS_DATE, CUST_RISK_LEVEL, INVALID_DATE)
  \ ods_o_wms_t4_cust_risk_assess_log: 筛选 CUST_RISK_LEVEL <> "" \
  左结果 = 排名 TRANS_DATE 降序, upd_time 降序, 自然, 前 1, 分区 ID_CODE, ID_TYPE, TRANS_DATE \
  ods_o_wms_t4_cust_risk_assess_log_h: 筛选 CUST_RISK_LEVEL <> "" \
  右结果 = 排名 TRANS_DATE 降序, upd_time 降序, 自然, 前 1, 分区 ID_CODE, ID_TYPE, TRANS_DATE \
  左结果: 集合 并 右结果 \
  导出表 ID_CODE, ID_TYPE, TRANS_SERNO, TRANS_DATE, CUST_RISK_LEVEL, INVALID_DATE \\;
COMMIT;
注意这一段里没有 BEGIN/END,也没有循环和分支:LOOP 原样留在宿主里,SQLazy脚本只处理其中的计算。编译之后,它变成标准的 CTE 加窗口函数写法:
编译后的原生过程(节选)
INSERT INTO tmp_f_F01_CUST_RISK_INFO_init_4
       (ID_CODE, ID_TYPE, TRANS_SERNO, TRANS_DATE, CUST_RISK_LEVEL, INVALID_DATE)
WITH ...
...  ROW_NUMBER() OVER ( PARTITION BY ID_CODE, ..., ORDER BY ... )
...
SELECT ...
UNION
SELECT ...;
COMMIT;
为什么值得这么切?因为存储过程的审计难点恰好集中在 SELECT 计算和 WHERE 条件上——这两块最容易写错、也最难读;而流程代码(变量赋值、分支、循环、提交回滚)本来就是易读的。取舍之后,牺牲不多,收益明确。
10.3 再进一步:用 SPL 做宿主语言
如果宿主不限于某个数据库的存储过程,还有一个更彻底的选择:用 SPL 做宿主。流程、分支、循环、写动作都在 SPL 里,SQL 查询与更新随宿主,计算片段嵌在 SQL 中间——SPL 包住 SQL,SQL 里再嵌 SQLazy 片段。
嵌入 SQL 与 SQLazy 片段的 SPL 代码
……
17 if v_num==1
18     >log_message = concat("分区 ", partition_name, " 已存在,开始清理数据...")
……
47     $insert into fds.tmp_f_F01_CUST_RISK_INFO_init_1(
         ID_CODE
         ,ID_TYPE
         ,trans_date
         ,first_flag
         )\
         ods_o_wms_t4_cust_risk_assess_log:筛选 CUST_RISK_LEVEL <> ““ \
         排名 TRANS_DATE 降序, upd_time 降序 自然 前 1 分区 ID_CODE, ID_TYPE \
         导出表 ID_CODE, ID_TYPE, TRANS_SERNO, TRANS_DATE, upd_time \\
48     $commit
49     $insert into fds.tmp_f_F01_CUST_RISK_INFO_init_2(
         ID_CODE
         ,ID_TYPE
         ,TRANS_SERNO
         ,TRANS_DATE
         ,upd_time
          )\
         ods_o_wms_t4_cust_risk_assess_log_h:筛选 CUST_RISK_LEVEL <> "“ \
         排名 TRANS_DATE 降序, upd_time 降序 自然 前 1 分区 ID_CODE, ID_TYPE \
         导出表 ID_CODE, ID_TYPE, TRANS_SERNO, TRANS_DATE, upd_time \\
50     $commit
……
68 else
69     >EndTime=now()
70     >RunTime=interval@s(StartTime,EndTime)
71     >step_context ="3-模型层数据加工失败"
……
这样做有两个好处。一是顺应新数据库的趋势:很多新数据库干脆不支持存储过程,宿主语言不绑定数据库之后,仍然可以实现同样的能力;而且前面主动放弃的可移植性和调试能力还能收回来——独立的宿主语言比某个库的语法可控得多;游标与有序运算的能力也更强,复杂运算尤其是游标场景会更方便。
二是落地成本低:SPL 是纯 Java 解释执行,能进 Java 生态、用 Java 框架、支持热切换。代价是多一层运行时,这一点要按团队实际情况权衡,不必当成默认答案。
结论:可信 = 可审计 + 确定性 + 可验证
回到开头的问题:AI 写的 SQL 什么时候才敢用?答案不是「等模型更准」,而是把不确定性挪到一个能被审的位置。
三个词分别对应三件事。可审计,是一行一步、可读可改,人能逐步确认;确定性,是同一输入永远同一输出,不编字段、不幻觉;可验证,是结果能被自动比对,逻辑一致才敢替换。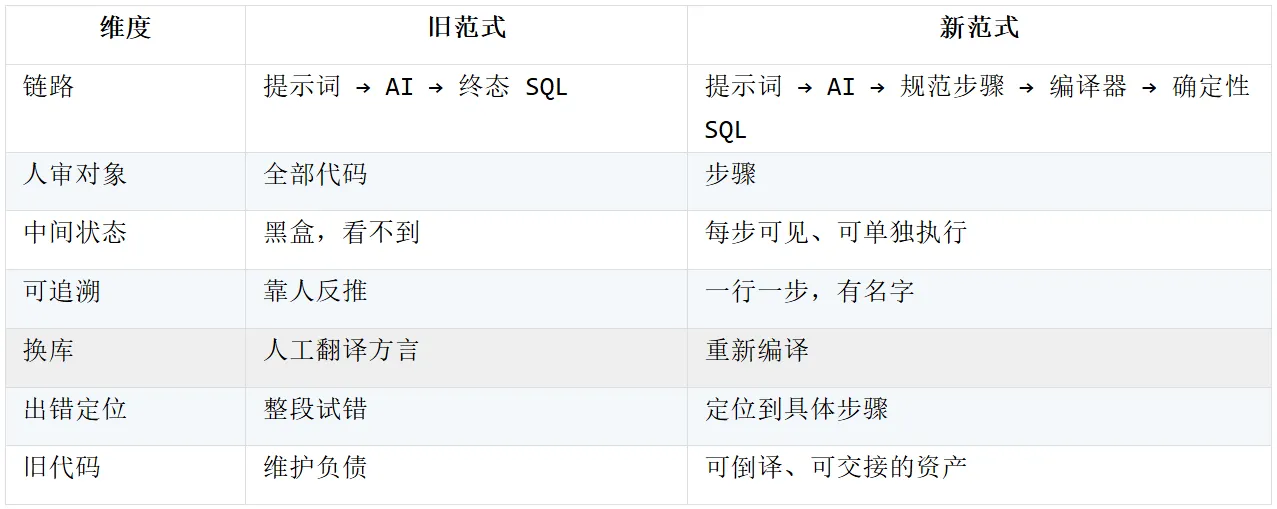
需求会一直在变,模型也会一直变。能变的是 AI 参与多深,不能变的是人手上必须有一份看得懂、改得动、结果能复核的东西。把不确定的一小段留给人看,其余交给确定性。
