count从 2.0 起废弃、scan从 2.1 起废弃,到 5.0 两个 search type 被移除。替代方式分别是size: 0和"按_doc排序的 scroll"。带这两个值的请求在 5.x 不会降级,源码里的解析会直接抛No search type for [...]。本文对照 v5.6.16 和 v2.4.6 源码,把移除的依据、替换写法和改完以后要验证的几点写清楚。
说明
实测环境:本地起的 Elasticsearch 5.6.16 单节点实例(官方 tar 包直接跑,堆内存 512MB,外挂 JDK 8),curl 连本地 9200 端口。本文「实测」小节的命令和输出都出自这个实例;文档与源码依据仍按 v2.4.6到 v5.6.16 标签下的 search.asciidoc、search-type.asciidoc、SearchType.java 引用,哪些是文档写明、哪些是我的推断,正文里逐处标注。
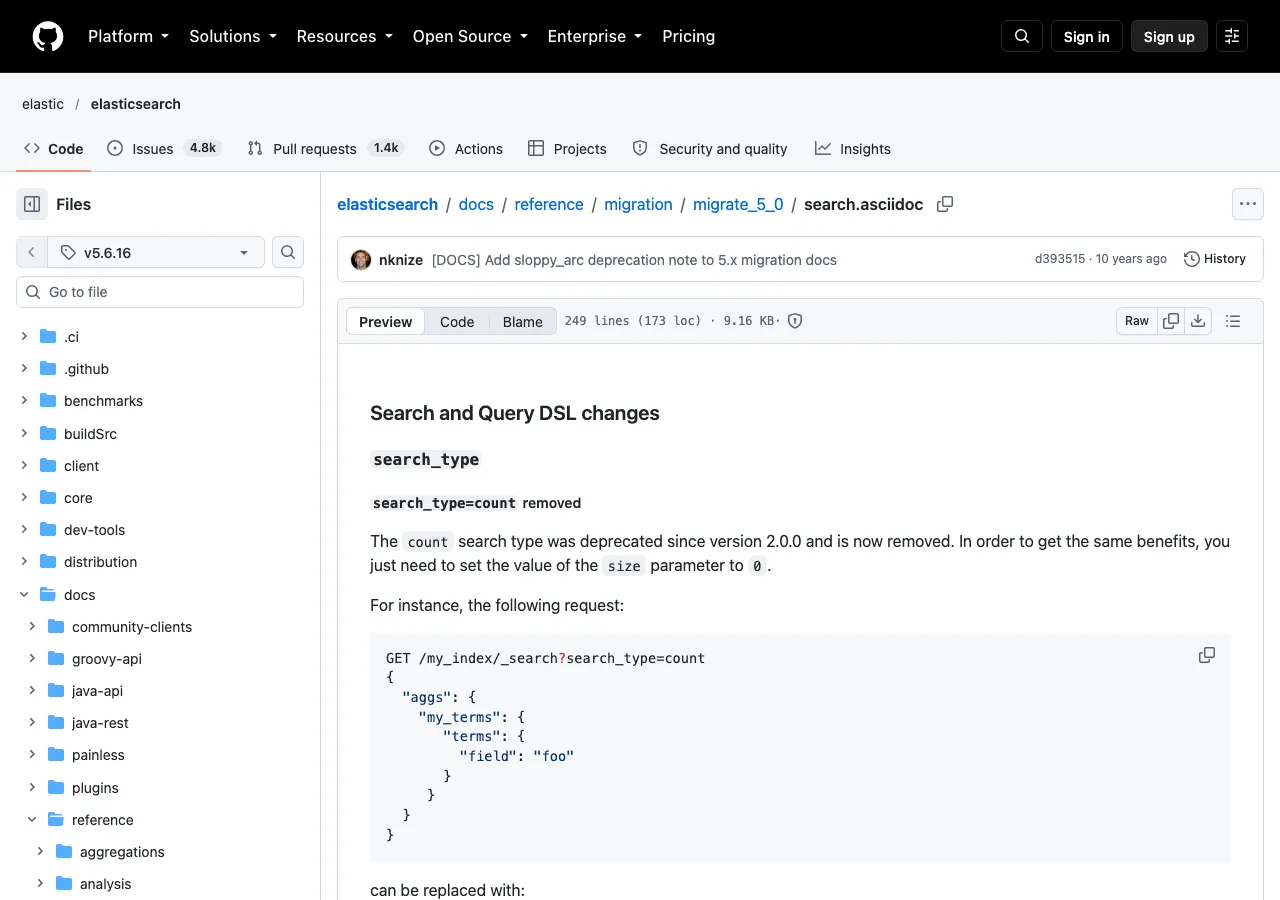
图 1:官方文件 search.asciidoc(v5.6.16 标签)。来源:GitHub elastic/elasticsearch v5.6.16 search.asciidoc
官方迁移说明
5.0 迁移文档(migrate_5_0/search.asciidoc 第 8–10 行、第 47–63 行)分别写了这两项:
The
countsearch type was deprecated since version 2.0.0 and is now removed. In order to get the same benefits, you just need to set the value of thesizeparameter to0.The
scansearch type was deprecated since version 2.1.0 and is now removed. All benefits from this search type can now be achieved by doing a scroll request that sorts documents in_docorder.
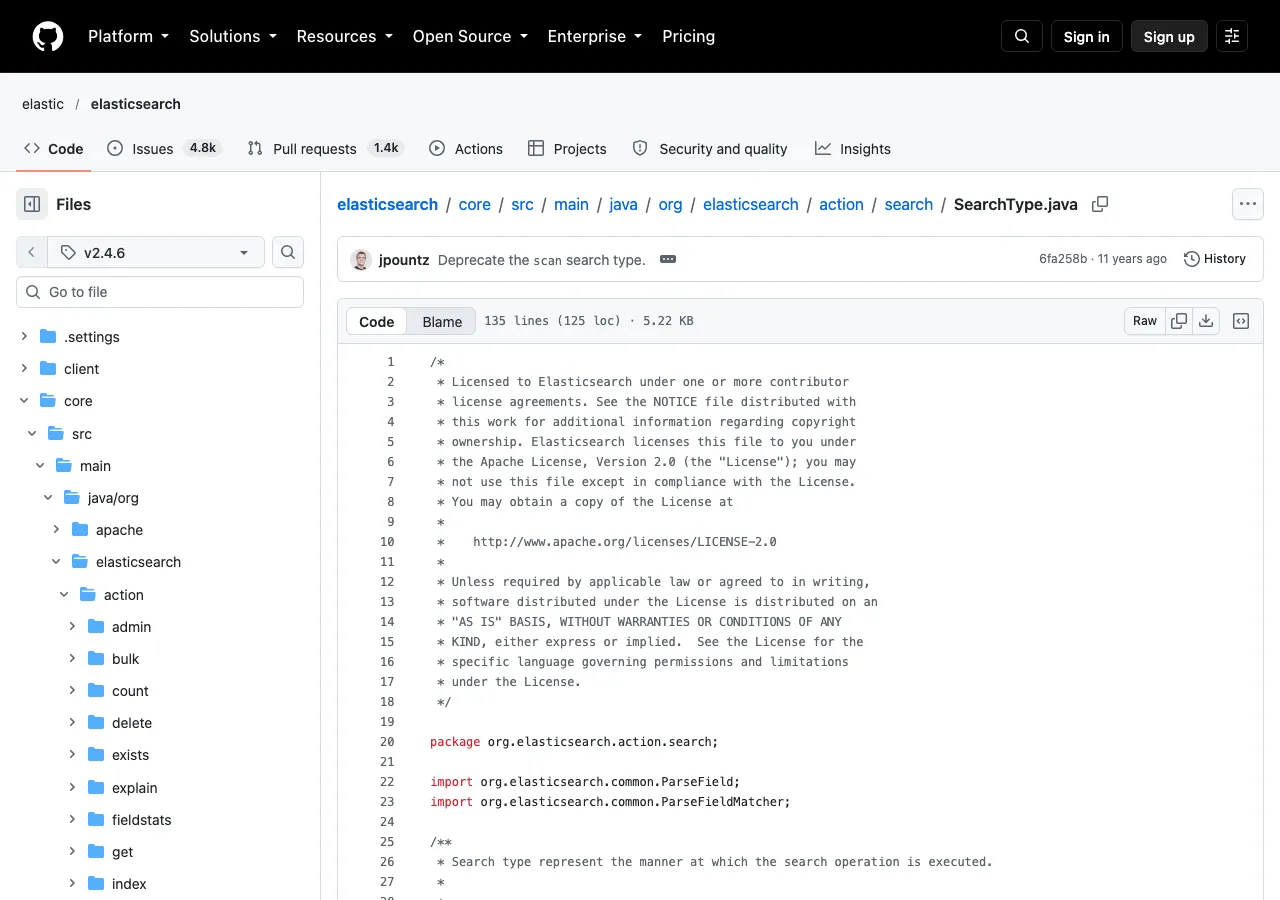
图 2:官方文件 SearchType.java(v2.4.6 标签)。来源:GitHub elastic/elasticsearch v2.4.6 SearchType.java
count 的改法
原来:
GET /my_index/_search?search_type=count
{

  "aggs": {

    "my_terms": {

      "terms": {
    "field": "foo" }
    }
  }
}
改成:
GET /my_index/_search
{

  "size": 0,
  "aggs": {

    "my_terms": {

      "terms": {
    "field": "foo" }
    }
  }
}
2.4.6 的文档说明了 count 废弃的理由(search-type.asciidoc 第 68 行):count 相比 size 为 0 的 query_then_fetch 没有任何好处。源码里 SearchType.COUNT 的注释是同一个意思。所以这一项是纯写法替换,没有行为差别需要补偿。size: 0 的响应里 hits.total 照常存在,hits.hits 是空数组。
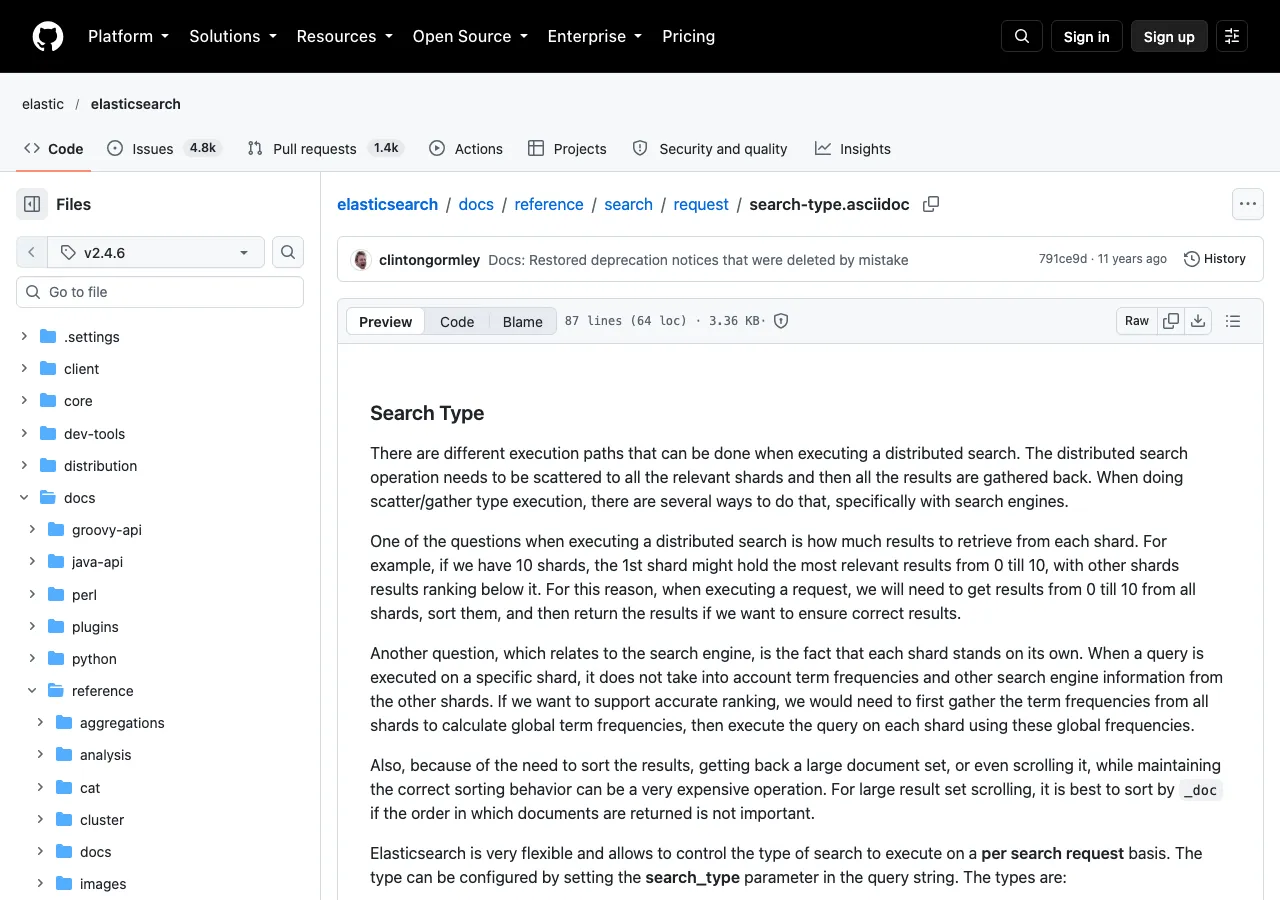
图 3:官方文件 search-type.asciidoc(v2.4.6 标签)。来源:GitHub elastic/elasticsearch v2.4.6 search-type.asciidoc
scan 的改法
GET /my_index/_search?scroll=2m
{

  "sort": [
    "_doc"
  ]
}
迁移文档对性能的说法是:按 _doc 排序的 scroll 已经优化过,能更高效地从上次停止的位置继续,所以和原来的 scan 有相同的性能特征。scroll 文档里也有一条 NOTE(scroll.asciidoc 第 87–89 行):不在乎顺序时,_doc 是最高效的遍历方式。
2.4.6 对 scan 的描述是"禁用排序,以便高效地滚动大结果集"(search-type.asciidoc 第 84–85 行),源码里 SearchType.SCAN 的注释写着"会自动开始滚动结果集",并注明会在 3.0 移除,应改为按 _doc 排序的常规 scroll。
请求直接失败
5.6.16 的 SearchType.fromString 第 85–96 行只认 dfs_query_then_fetch 和 query_then_fetch 两个值,其他一律抛:
No search type for [count]
对应 IllegalArgumentException,ExceptionsHelper.status 第 68–69 行把它映射成 HTTP 400。所以带 search_type=count 或 search_type=scan 的请求在 5.x 上是整个请求失败,不会降级成默认类型,也不会只出告警。REST 层请求是否正好走这条解析路径,未在集群上请求验证,以实际响应为准。
对应地,2.4.6 的 SearchType.fromString 第 127–130 行里还保留着 scan、count 两个值,由废弃标记的 ParseField 处理。这也是 2.x 期间老请求"能用"的原因:解析是通的,只是被标了废弃。
这类移除的风险在后台任务,不在在线查询
count 改起来是一行的事,在线查询一般有测试覆盖,升级后就会暴露。scan 多用在全量导出、数据迁移、重建索引这类后台任务里,平时没人盯。这些任务可能一个季度才跑一次,升级后的第一次运行才暴露失败,而那时往往正处在迁移窗口里。
所以排查范围要比线上请求宽:定时任务、运维脚本、数据同步工具里的搜索请求都要查。以下是把这两个值找出来的办法:
grep -rnE "search_type.{0,5}(count|scan)|SearchType\.(COUNT|SCAN)|searchType\(.*(COUNT|SCAN)" .
Java 客户端里是枚举常量,光搜字符串会漏,所以正则里单独写了 SearchType.COUNT、SearchType.SCAN。这是文本匹配,只能提供线索,命中以后要人看上下文。
从废弃到移除:这次的间隔
按迁移文档的说法,count 在 2.0 废弃、scan 在 2.1 废弃,到 5.0 移除。中间跨过了 2.x 的多个小版本,没有 3.x、4.x 版本(2.x 之后直接是 5.0)。废弃期间这两个值照常工作,解析通、结果对,只带一个废弃标记。
这个设计的取舍是:废弃期内不报错,保证了老应用升级小版本时不坏;代价是没有强制力,改动容易被推到最后一刻。能起作用的只有两个东西,报错,或者自己排进计划。前者在移除那一版才出现。所以我的建议是:每次大版本升级前,把"上一版已经标废弃、这一版移除"的条目单独拉出来过一遍,优先级最高,因为它们下一版就不能用了。
改完以后怎么验证
count 改 size: 0,验证三点:HTTP 200、hits.hits 为空数组、聚合结果和改之前一致。
curl -s 'localhost:9200/my_index/_search' -d '{
  "size": 0,
  "aggs": { "my_terms": { "terms": { "field": "foo" } } }
}' | python3 -m json.tool
scan 改 scroll,要多验证一步:数据有没有漏。按 scan 写的客户端逻辑和 scroll 不一样,旧代码里如果有"第一次响应只拿 _scroll_id、不处理 hits"之类的特殊处理,改成 _doc 排序的 scroll 以后,第一次响应里就有 hits,这段特殊处理会让第一批数据被跳过。本文没有在 2.4.6 上复核 scan 首次响应的具体结构,以你手上的客户端代码为准。
验证办法:挑一个小索引,用 scroll 全量拉一遍,统计拉到的 _id 数量,和 _count 的结果对比,一致再上大索引:
curl -s 'localhost:9200/small_index/_count'
另外有一条 scroll 文档里的 NOTE:请求里带聚合时,只有初始的搜索响应包含聚合结果(scroll.asciidoc 第 84–85 行附近)。如果以前靠 search_type=count 取聚合,现在换成 size: 0 的普通搜索,没有问题;但我的建议是不要把聚合和 scroll 放在一起,指望每一页都有聚合。
深分页的出口
2.1 起引入了 index.max_result_window,from + size 不能超过它,默认 10000。5.6.16 的 from-size.asciidoc 第 26–28 行仍然这么写,并指向 Scroll 和 Search After 两个更适合深翻页的方式。所以 scan 移除之后,遍历全量数据的出口是 scroll;要在界面上深翻页,用 search_after。search_after 是无状态的,每次都按最新的索引状态解析(search-after.asciidoc 第 63 行附近),和 scroll 不同,它没有快照,不适合要求一致视图的导出。把 max_result_window 调大只是推迟问题,细节见scan 废弃与 10000 上限。
取总数的几种写法
search_type=count 被移除以后,几种取总数的方式对比如下(性能差别没有实测,只列各自的做法):
| 目的 | 写法 |
|---|---|
| 只要总数 | size: 0,读 hits.total;或者 Count API(count.asciidoc) |
| 要聚合结果 | size: 0 加 aggs |
| 要文档 | 正常的 size |
这三种都不需要 search_type。Count API 在 2.0 以后的失败行为有变化,见 2.0 的搜索层变更。
count 和 scan 现在是什么反应
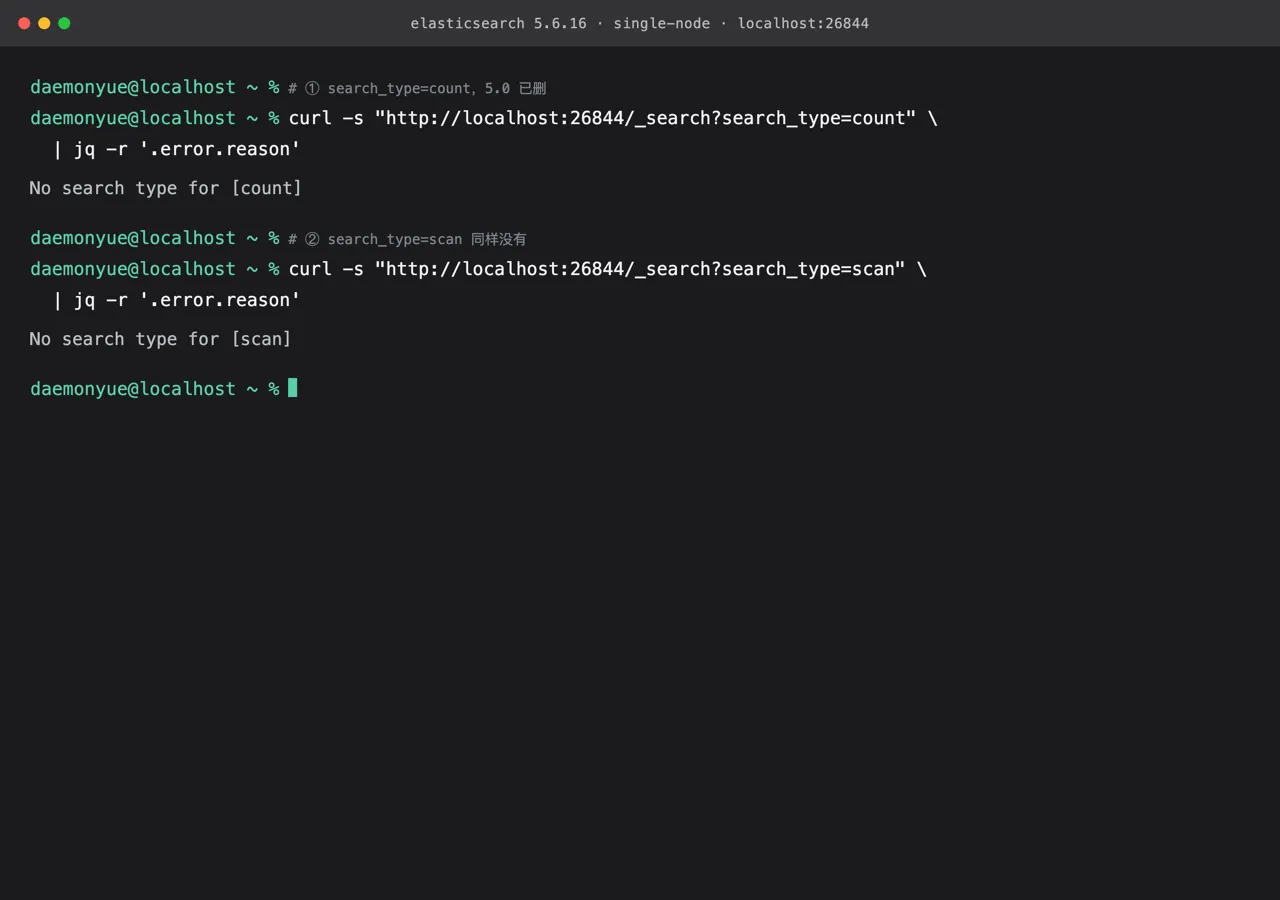
图 4:本地 5.6.16 单节点实例上的实测输出。count 与 scan 都不存在了
curl -s "http://localhost:9200/_search?search_type=count" \
  | jq -r '.error.reason'
No search type for [count];换成 scan 是一样的结果。
失败发生在参数解析阶段,不是"查出来结果不对"——请求根本发不出去,所以迁移时不用猜行为变没变。真正要找的是还在用这两个值的地方:滚动导出、全量计数这类批处理,它们在旧版本里往往绕过了 size 限制,改的时候要连分页逻辑一起看。
写在最后
升级到 5.0 之前,把 search_type=count、search_type=scan 和对应的 Java 枚举常量找出来,count 改 size: 0,scan 改 _doc 排序的 scroll。改完用小索引核对一次数量,特别留意后台任务和定时脚本,它们最容易漏。
这次移除的做法值得借鉴:一个参数只表达一件事。取总数、遍历全量,本来就不是"搜索类型",归位到 size: 0 和 scroll 之后,search_type 剩下的 query_then_fetch 和 dfs_query_then_fetch 才是真正的检索语义。
参考
本文对照 Elasticsearch
v5.6.16标签的官方文档核对,引文逐字取自原文;文中「实测」小节的命令与输出来自本地 5.6.16 单节点实例,不含性能对比。