9.1 之前,
index.mode=time_series的索引不支持nested字段——想给指标带上一组子对象,只能拍平或者换个索引模式。9.1 放开了这个限制。但放开得不彻底:nested 内部仍然不能配time_series_dimension,这条边界值得先看清再动手。
说明
实测环境:本地起的 Elasticsearch 9.4.2 单节点实例(官方 tar 包直接跑,堆内存 512MB,安全与机器学习关闭),curl 连本地 9200 端口。本文「实测」小节的命令和输出都出自这个实例。
来源和边界先交代:本文的依据出自 v9.4.2 标签下的官方文件(9.1.0.yml、KeywordFieldMapper.java),文中引用的原文均来自这些文件。示例取自官方示例;哪些是文档写明、哪些是我的推断,正文里逐处标注。
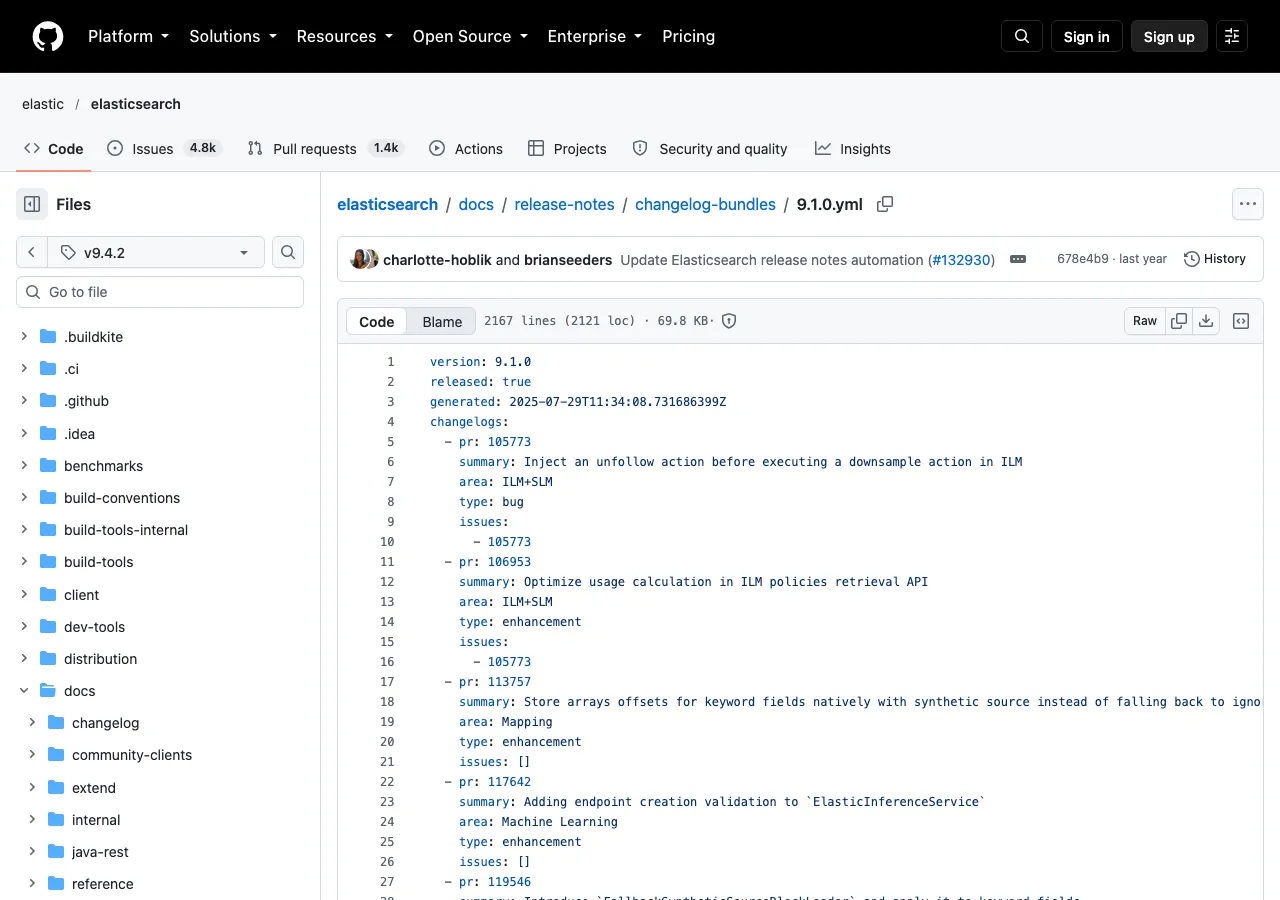
图 1:官方文件 9.1.0.yml(v9.4.2 标签)。来源:GitHub elastic/elasticsearch v9.4.2 9.1.0.yml
官方条目
9.1 的 changelog 标为 enhancement(9.1.0.yml 第 237–241 行 @ v9.4.2),area: Mapping,issue 120874。
只有一行 summary。所以本文的实质内容来自源码——包括那条没放开的边界,changelog 里一个字都没提。
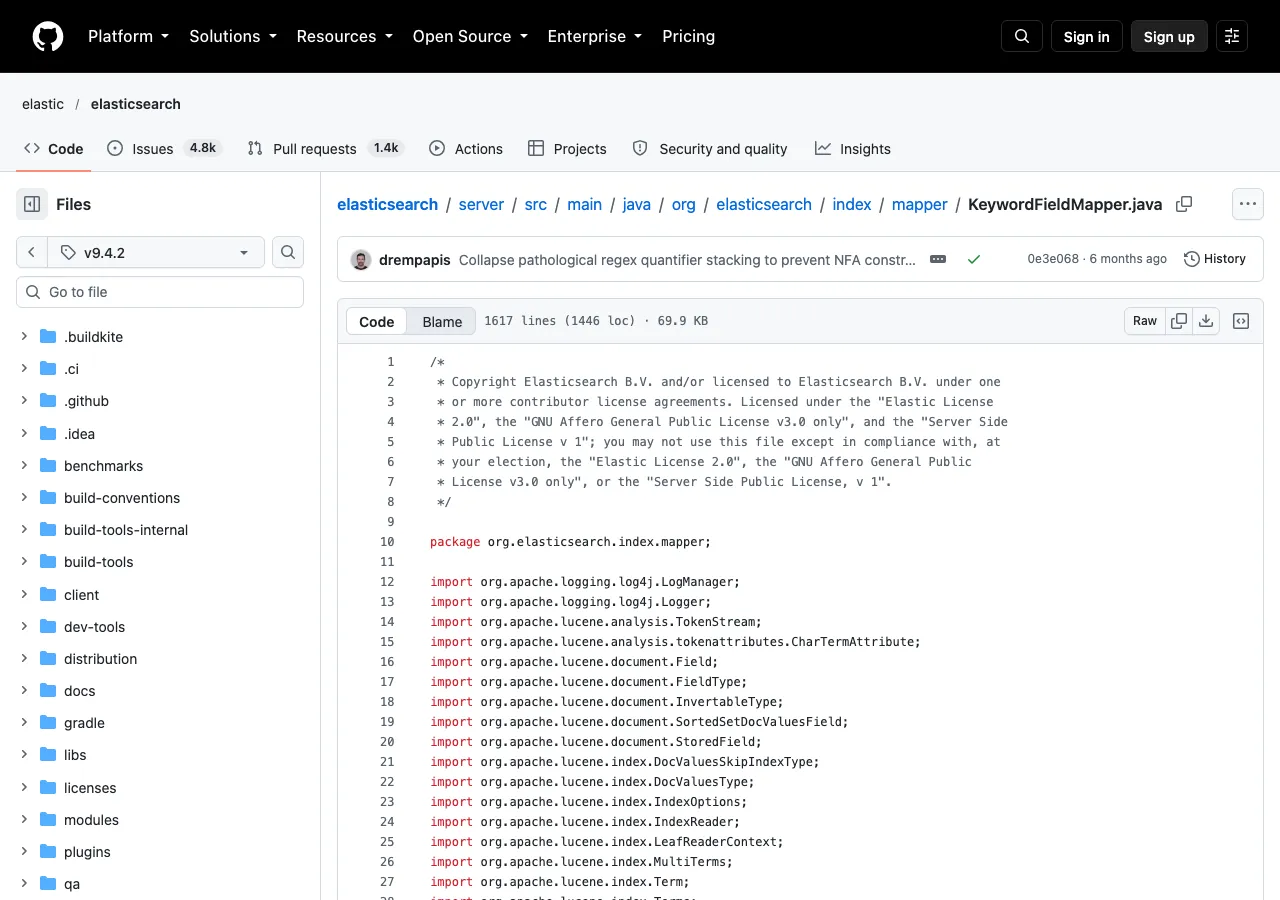
图 2:官方文件 KeywordFieldMapper.java(v9.4.2 标签)。来源:GitHub elastic/elasticsearch v9.4.2 KeywordFieldMapper.java
先说这两个概念
TSDB 模式(index.mode=time_series):ES 为时间序列数据准备的一种索引模式。它的几个特征:
- 必须有
@timestamp; - 有一组 dimension(维度),用来标识"这是哪条时间线";
- 同一维度组合的数据在存储上会被放在一起并压缩——这是它省空间的原因;
- 按时间分块存储。
nested 字段:用来存对象数组且需要保持数组内元素的对应关系。
不用 nested 的话,ES 会把对象数组拍平成多值字段:
tags: [{
   k: "env", v: "prod"}, {
   k: "team", v: "infra"}]
拍平后变成 tags.k: ["env", "team"]、tags.v: ["prod", "infra"]——env 和 prod 的配对关系丢了。查询"k=env 且 v=infra"会误命中。
nested 把每个数组元素当独立文档索引,从而保住这个配对关系,代价是查询语法更复杂、索引体积更大。
以前为什么不行
这一点官方没解释,下面是根据 TSDB 的工作方式做的推断,不是官方说明。
TSDB 的省空间效果来自"同一维度组合的数据放在一起压缩"。而维度决定了数据的物理排列。
如果允许 nested 字段里也放维度,那么"这条数据属于哪个时间线"就有了两层判断——外层对象的维度 + nested 内部子对象的维度。这会让排列逻辑复杂化,甚至破坏"同一时间线连续存放"这个前提。
推想是:不支持 nested 是当时为了避免这个复杂度。
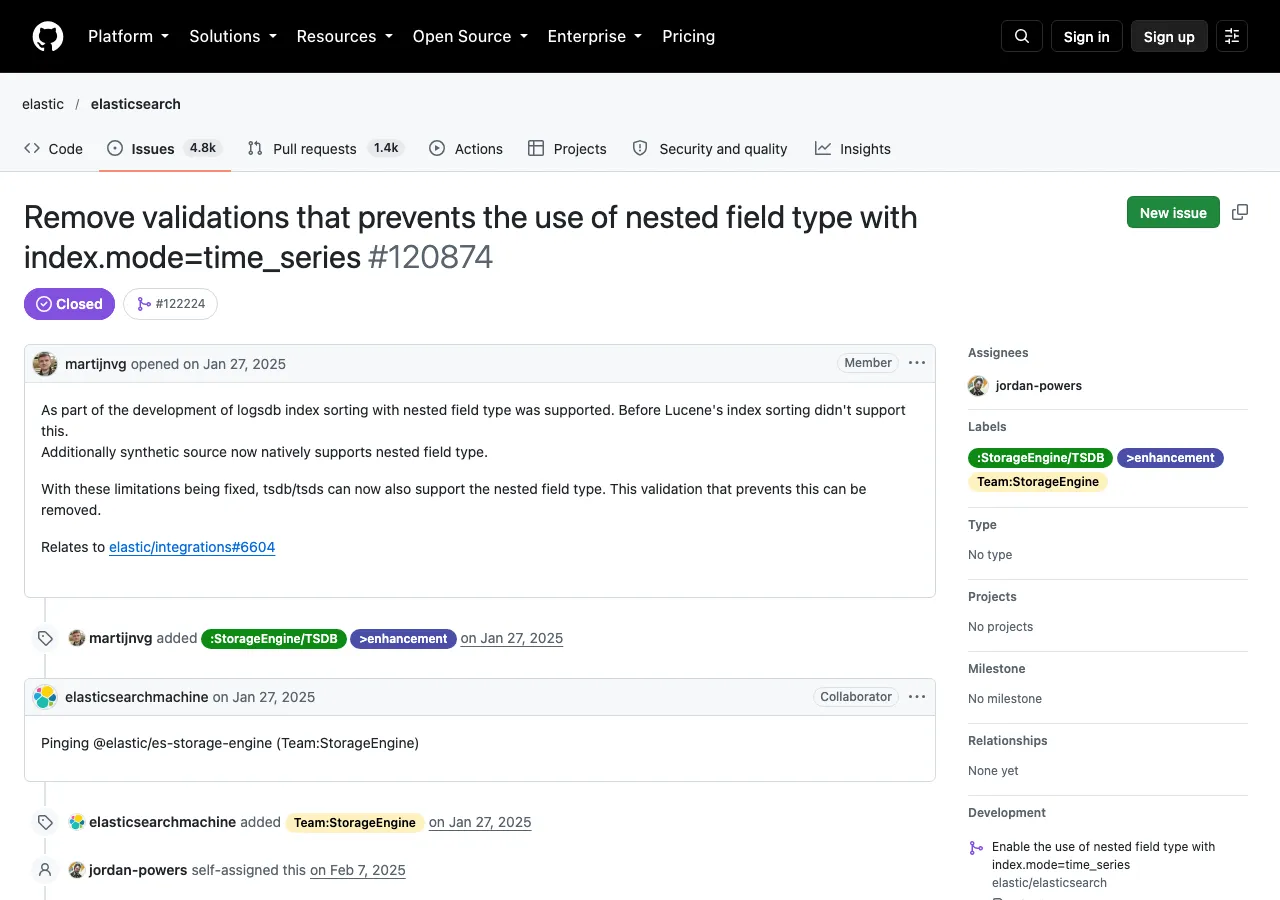
图 3:官方页面 Issue #120874。来源:GitHub elastic/elasticsearch issues/120874
现在放开了什么
9.1 之后,TSDB 模式的索引里可以定义 nested 字段了。
这意味着:时间序列数据可以带上一组子对象,且保住元素间的对应关系。
典型场景:一个指标点带有若干标签(label)。用 TSDB 存指标、用 nested 存标签,两件事现在能同时做了——以前只能二选一。
没放开的那条边界
这是本文最重要的部分,changelog 里一个字都没提。
源码里仍然有一条校验(KeywordFieldMapper.java 第 1526 行,源码 @ v9.4.2):
TimeSeriesParams.TIME_SERIES_DIMENSION_PARAM + " can't be configured in nested field [" + fullPath() + "]"
在 nested 字段里配 time_series_dimension 依然会报错。
这不是 keyword 独有——BooleanFieldMapper、IpFieldMapper、NumberFieldMapper 里有同样的校验(v8.18 里就存在,v9.4.2 仍在)。凡是支持 dimension 的类型都有这条限制。
所以准确的边界是这样的:
| 位置 | 能否配 time_series_dimension |
|---|---|
| 顶层字段 | 可以 |
| nested 内部字段 | 不行 |
这条边界意味着什么
这条边界决定了 nested 在 TSDB 里能扮演什么角色。
能做的:存附加信息。nested 里放的是描述性的子对象,不参与"这条数据属于哪条时间线"的判断。
不能做的:让子对象参与维度划分。你不能靠 nested 内部的字段去区分时间线。
判断是这个限制是合理的。理由:
维度的作用是标识时间线,它必须是稳定的、少量的、在文档层面确定的。如果维度藏在 nested 数组里,那"一条数据属于哪条时间线"就变成了一个需要遍历数组才能回答的问题——这跟维度的设计意图是冲突的。
维度基数还是 TSDB 最需要控制的东西(基数爆炸是常见故障)。只允许顶层做维度,等于从结构上限制了基数失控的可能。
还有一层:这条限制其实帮你挡了一类设计错误。如果允许 nested 内部做维度,很容易出现"同一个标签值在不同子对象里重复出现"的情况,维度基数会随数组长度成倍增长。禁止它,等于强制你在一开始就想清楚"到底用什么区分时间线"。
(说明:上面的理由是推断,官方没有解释过这条限制的设计动机。)
怎么用
一个可用的 mapping 大致是这个形状:
PUT my-metrics
{

  "settings": {

    "index.mode": "time_series"
  },
  "mappings": {

    "properties": {

      "@timestamp": {
    "type": "date" },
      "host":   {
    "type": "keyword", "time_series_dimension": true },
      "region": {
    "type": "keyword", "time_series_dimension": true },
      "cpu":    {
    "type": "double",  "time_series_metric": "gauge" },
      "labels": {

        "type": "nested",
        "properties": {

          "key":   {
    "type": "keyword" },
          "value": {
    "type": "keyword" }
        }
      }
    }
  }
}
关键点:host、region 在顶层,可以配 time_series_dimension;labels 是 nested,里面的 key/value 只是普通 keyword,不能配 dimension。
查询 nested 时照常用 nested 查询:
GET my-metrics/_search
{

  "query": {

    "nested": {

      "path": "labels",
      "query": {

        "bool": {

          "must": [
            {
    "term": {
    "labels.key": "env" } },
            {
    "term": {
    "labels.value": "prod" } }
          ]
        }
      }
    }
  }
}
(说明:上面两个例子按 TSDB 和 nested 的通用写法构造,未实际执行过。9.1 是否对 TSDB 下的 nested 查询有额外限制,未逐个确认。)
代价要提前算清楚
nested 不是免费的,在 TSDB 场景下这个代价可能比预想的大。把账算一下,因为它直接决定该不该用。
代价一,nested 是独立文档。 每个 nested 元素在 Lucene 里是一个独立文档,只是对外不可见。所以:
- 一个带 5 个标签的指标点,实际索引的是 1 个主文档 + 5 个 nested 文档;
- 文档计数会涨,
_cat/indices里的 docs.count 会比业务对象数大; - 索引体积、写入开销都随之上升。
代价二,和 TSDB 的省空间目标有张力。 TSDB 的核心价值是压缩率高。而 nested 让文档数成倍增加——这两件事方向相反。
代价是要意识到:你是在用一部分存储效率,换数据结构上的正确性,不是说不能用。这个交换值不值,取决于那些标签对你有多重要、有多常用。
代价三,查询更复杂。 nested 查询要套一层,聚合更麻烦。复杂度会传导到所有用到这个字段的地方。
建议:标签数量少、且必须保配对关系时才用。如果标签数量多或者经常变,倾向是另想办法——比如把标签拍平成顶层 keyword 字段做 dimension(如果它们本来就是维度),或者干脆用 flattened 存着不参与查询。
nested 聚合在 TSDB 下是否正常
nested 字段上的聚合在 TSDB 模式下是否正常,不确定。
nested 的聚合语法本来就比较特殊(要先 nested 再 reverse_nested)。在 TSDB 模式下,加上时间线的概念之后,聚合行为是否符合预期,未验证,文档里也没找到明确说明。
如果你打算在 TSDB 索引里对 nested 字段做聚合,建议先在测试环境跑一遍确认。 这是那种"看起来应该能用,但没验证过就不要上线"的地方。
怎么自己确认边界
前面几条限制是从源码的校验分支里找到的。这里把方法写出来,因为你以后遇到别的"某模式下某字段能不能用"的问题,可以自己查——不用等别人写文章。
第一步:找报错文案。 在源码里搜特征词。比如这次:
git grep -rn "can't be configured in nested field" -- server/src/main/java/
第二步:看它在哪个分支里。 找到之后往上看几行,确认触发条件——是任何情况都报错,还是只在某种模式下。
第三步:确认目标版本还有没有。 用 git show <tag>:<path> 看具体标签下的内容。限制可能在新版本被删掉,所以一定要看你实际用的版本。
这个方法的优点是结论确定——报错文案是代码,不是说会不会变的问题。缺点是要能定位到源文件,所以得知道相关的 mapper 类名。
如果找不到限制,也不要默认"那就是允许" —— 也可能是搜错了地方。这种情况更稳妥的是直接在测试环境建一个索引试,通常比读代码快。
该不该用
既然能用,那什么时候该用?判断标准:
适合用的情况:
- 子对象数量少且固定(比如每个指标点带 3–5 个标签);
- 需要保住配对关系(这是 nested 的核心价值,拍平就丢了);
- 这些子对象不参与维度划分(反正也不让配)。
不适合用的情况:
- 子对象很多或数量不定 → nested 的开销会很明显;
- 只是要存、不需要按子对象查询 → 用
object甚至flattened更省; - 需要靠子对象区分时间线 → 做不到,得把它提到顶层做 dimension。
总体判断:这是个补短板的改动,不是让你重新设计数据模型的理由。它解决的是一个具体的痛点,不是开了一种新的建模范式。TSDB 的主线用法(顶层维度 + 指标)没变,nested 只是允许你额外带一点结构化信息。别因为"现在支持了"就把本该做维度或本该拍平的字段放进 nested。
和别的能力放开放一起看
9.x 里"某模式下原本禁止的字段类型,现在允许了"这类改动有几个例子:
| 改动 | 放开什么 |
|---|---|
| 本篇 | TSDB 模式下的 nested |
| _source mode 设置迁移 | _source.mode 从 mapping 挪到索引设置 |
| none 分块策略 | none 分块策略(原本没有"不切"这个选项) |
共同点是放宽限制,但都不是无条件的——_source mode 设置迁移 有条件(存量索引仍按老逻辑)、none 分块策略 有条件(不能带分块参数),本篇也有(dimension 只能在顶层)。
所以看到"支持了"别直接当成"随便用"。 倾向是先找它的边界在哪——通常用前面那套方法在源码里搜报错文案就能找到,比读 changelog 可靠。
在 9.4.2 上跑一遍
先看能做到的,再看那条没放开的边界:
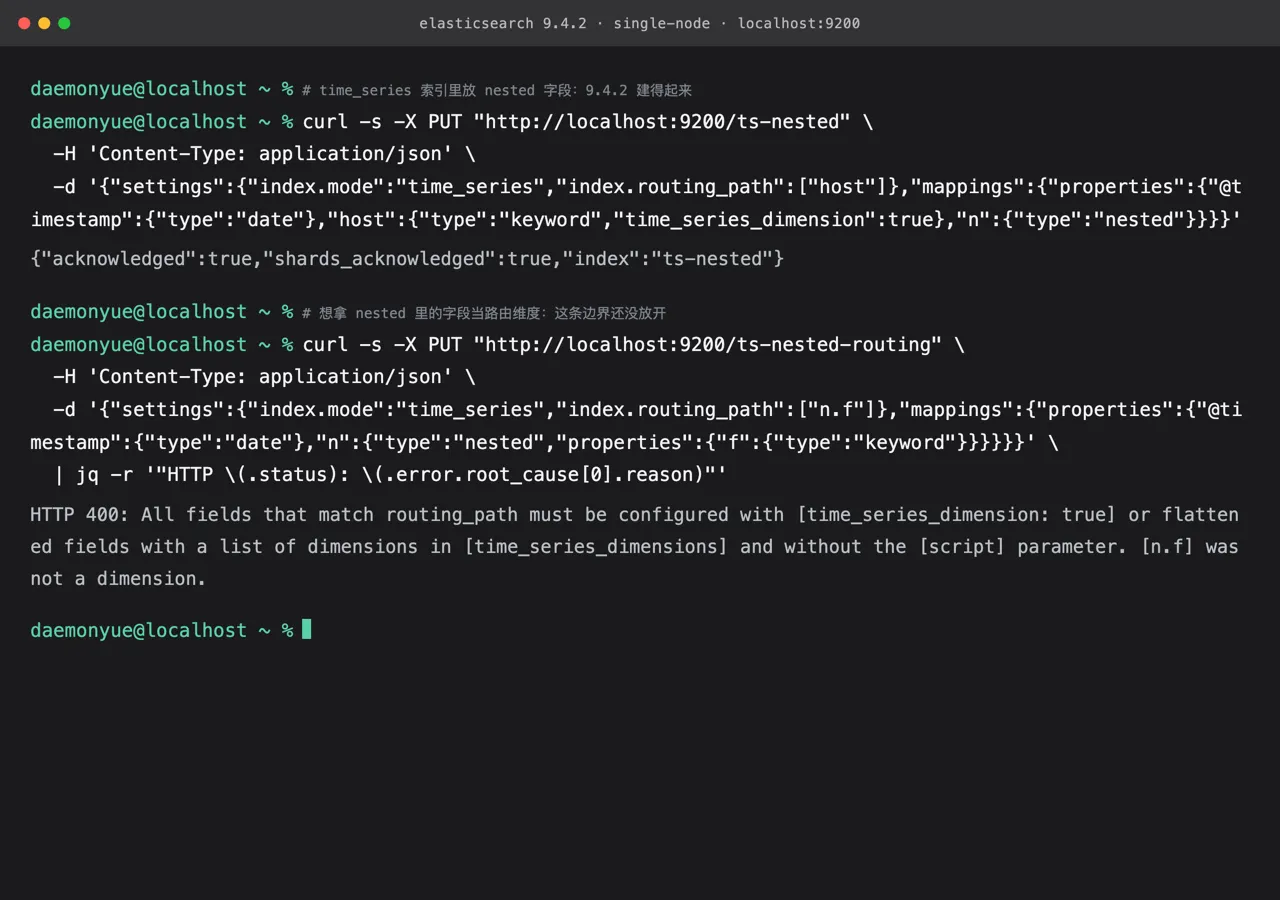
图 4:本地 9.4.2 单节点实例上的实测输出。上:nested 字段建得起来;下:想拿 nested 里的字段当路由维度
curl -s -X PUT "http://localhost:9200/ts-nested" \
  -H 'Content-Type: application/json' \
  -d '{"settings":{"index.mode":"time_series","index.routing_path":["host"]},"mappings":{"properties":{"@timestamp":{"type":"date"},"host":{"type":"keyword","time_series_dimension":true},"n":{"type":"nested"}}}}'

curl -s -X PUT "http://localhost:9200/ts-nested-routing" \
  -H 'Content-Type: application/json' \
  -d '{"settings":{"index.mode":"time_series","index.routing_path":["n.f"]},"mappings":{"properties":{"@timestamp":{"type":"date"},"n":{"type":"nested","properties":{"f":{"type":"keyword"}}}}}}' \
  | jq -r '"HTTP \(.status): \(.error.root_cause[0].reason)"'
第一条建起来了——time_series 索引里放 nested 字段,9.4.2 没有拦。
第二条报 HTTP 400: All fields that match routing_path must be configured with [time_series_dimension: true] ... [n.f] was not a dimension.。也就是说放得进去,但 routing_path 不能指到 nested 内部。
这条分界很重要:维度决定了数据落在哪个分片,而 nested 文档是跟着父文档走的,两者在物理布局上本来就是两套。所以 nested 能存,但不能参与路由。
结论是:TSDB 里用 nested 之前,先把维度字段挑好——维度必须留在顶层,nested 只用来装那些不参与路由的附加结构。
写在最后
这条改动让 TSDB 索引能带 nested 子对象,解决了"指标想带一组结构化标签"的需求。
一,9.1 起 index.mode=time_series 可以用 nested。 以前只能拍平或换索引模式,现在能保住子对象的配对关系了。
二,nested 内部不能配 time_series_dimension,这条限制还在。 源码里 KeywordFieldMapper.java:1526 有明确报错,且支持 dimension 的几种类型都有这条校验。所以 nested 能存附加信息,但不能参与维度划分。
三,别因为它可用了就改变数据模型设计。 维度还是应该在顶层,nested 只是补一个短板。我的建议是:只在拍平确实丢掉了配对关系时才用它,因为它会增加文档数、拉低压缩率。
另外诚实标注了三处:"以前为什么不支持"是推断(依据 TSDB 工作方式,非官方说明);示例 mapping 和查询是构造的,未执行;nested 上的聚合在 TSDB 下的行为未验证——要用请先测。
参考
- changelog 9.1.0:Enable the use of nested field type with index.mode=time_series(第 237–241 行)@ v9.4.2
KeywordFieldMapper.java:nested 内不能配 dimension 的校验(第 1526 行)@ v9.4.2- issue 120874
本文对照 Elasticsearch
v9.4.2标签的 changelog 与源码核对,引文与代码逐字取自原文。"以前为什么不支持 nested"与"为什么 dimension 不能在 nested 内"均基于 TSDB 工作方式推断,官方未解释设计动机;示例 mapping 与查询按通用写法构造。图 4 已在本地 9.4.2 单节点实例上验证:nested 字段可以建,但routing_path不能指向 nested 内部。9.1 是否对 TSDB 下 nested 查询有额外限制、nested 字段在 TSDB 模式下的聚合行为仍未验证。