
电商订单治理:快递地址解析接口,实现地址结构化、异常识别、智能路由
一、技术简介
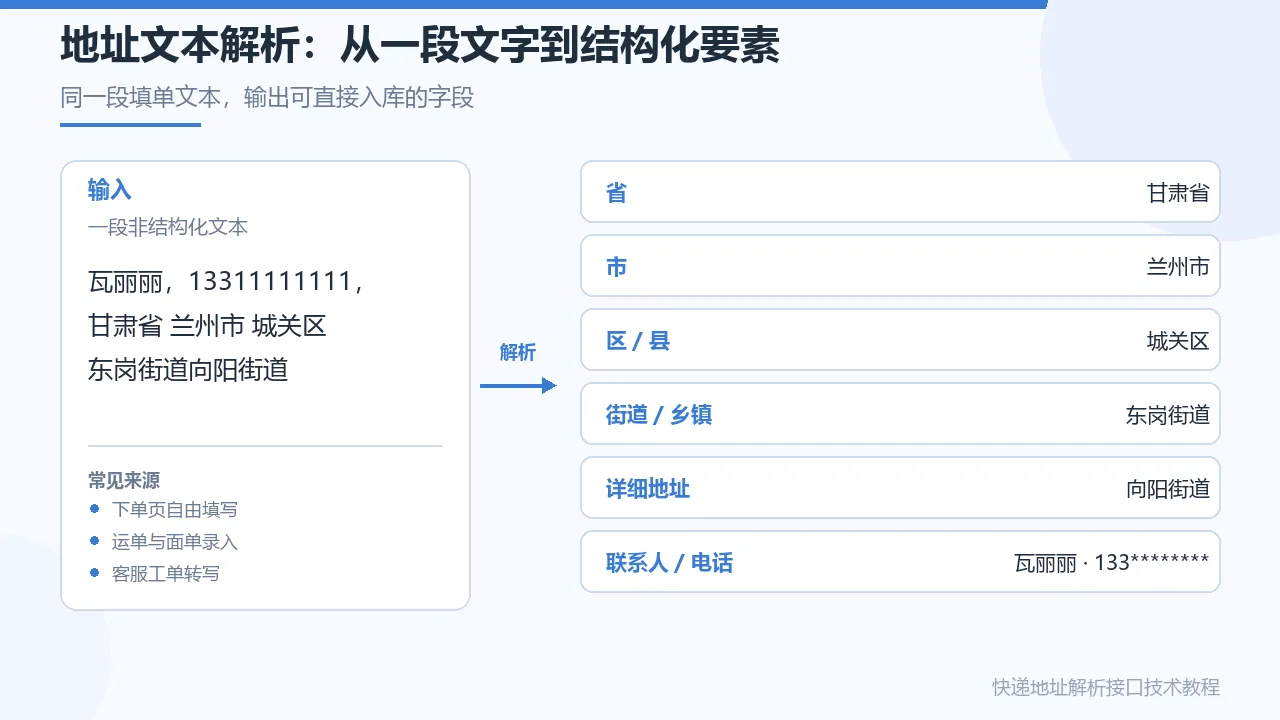
电商订单里最容易被忽略、又最容易在下游放大的数据,就是收货地址。用户在提交页自由填写的往往是一段没有分隔的文本:
瓦丽丽,13311111111,甘肃省 兰州市 城关区 东岗街道向阳街道
这段文本同时混着联系人、手机号和四级地址,还可能带全角标点、多余空格、错别字、缺区县、少街道。订单系统如果直接把它原样落库、原样传给仓储和运单,问题会在几天后以另一种形式回来:分拨错、派送失败、二次改址、退款纠纷。
快递地址解析接口的作用,是把这一段「人写的话」转换为一组可以直接入库、可以直接参与判断的结构化字段。它本质上是一个文本要素抽取 + 行政区划对齐的组合任务:
- 要素抽取:从自由文本中切出姓名、手机号、省、市、区县、街道/乡镇、详细地址;
- 行政区划对齐:判断抽取出的地名是否真实存在,对缺失的层级做补全,对明显错误的写法做归一;
- 置信度输出:给出一个 0–100 的分值,让调用方按业务策略决定「直接用」「复核后再用」还是「退回重填」。
把这一步前置到下单确认环节,比等到运单生成之后再撤回改址,代价低得多。
二、能力概览
2.1 请求概览
| 项目 | 说明 |
|---|---|
| 调用方式 | HTTP GET |
| 返回格式 | JSON(UTF-8) |
| 鉴权方式 | 请求头 Authorization: APPCODE <appcode> |
| 主要入参 | text:待解析的完整地址文本 |
| 可选入参 | score:结果置信度阈值,0–100 |
| 典型输出 | 省 / 市 / 区县 / 街道(乡镇)/ 详细地址 / 姓名 / 电话 / 置信度 |
2.2 入参说明
| 字段 | 必填 | 类型 | 说明 |
|---|---|---|---|
text |
是 | string | 完整填单文本。建议保留原始的姓名、电话、地址顺序,不要预先截断;文本越完整,可抽取的信息越多 |
score |
否 | string | 结果置信度的期望值,0–100。取值越高,对文本的规范性要求越严,返回结果也越保守;建议先按业务样本测出分布,再决定取值 |
2.3 输出要素
| 要素 | 语义 | 常见缺失原因 |
|---|---|---|
| 省 | 省级行政区 | 直辖市或文本里只写了城市名 |
| 市 | 地级市 / 直辖市区划 | 文本只写了区县名 |
| 区县 | 区、县、旗等 | 用户省略,只写到街道 |
| 街道 / 乡镇 | 街道办、镇、乡 | 老旧写法或新设街道未被收录 |
| 详细地址 | 门牌、楼栋、单元、商铺名 | 文本本身残缺 |
| 姓名 / 电话 | 收件人与联系方式 | 文本中没有写,或写在地址中间被打断 |
| 置信度 | 0–100 的数值 | 由文本质量与对齐结果共同决定 |
字段可能为空,这是正常返回形态,不是错误。调用方需要按「缺失」处理,而不是当作异常中断。
三、适用场景
3.1 电商下单与履约
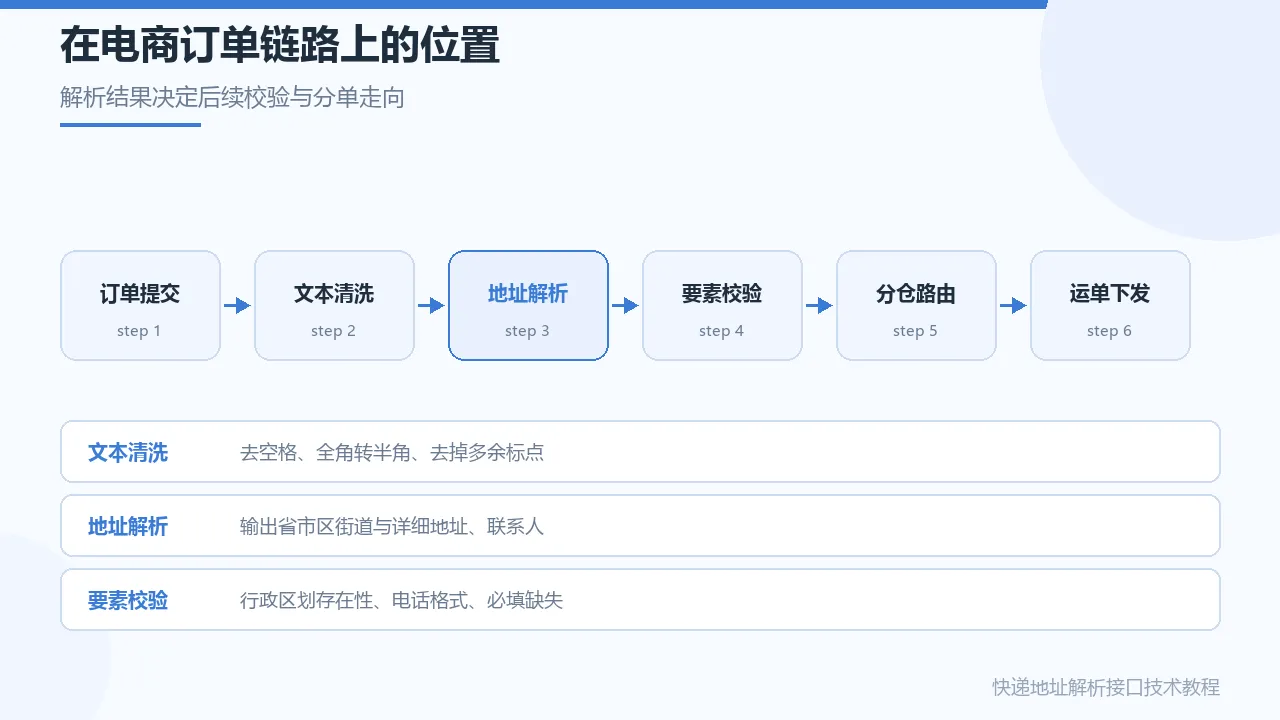
用户在下单页只填一段话,前端不做结构化表单时,解析接口是唯一的补救位置。解析结果可以直接决定三件事:运费模板匹配、可配送范围判断、分仓与配送路由。
3.2 批量历史订单治理
存量订单里通常有大量「省市区正常、街道缺失」的半结构化数据。可以按批次回放解析,把能补全的补全,无法补全的打上标记,交给运营集中处理,而不是逐单人工核对。
3.3 面单与售后录入
仓库打印面单、运营人员录入退货地址时,操作人员往往直接粘贴一段聊天记录。解析接口可以在入库前就把联系人、电话、地址分开,避免电话被写进地址字段、导致面单打印错位。
3.4 与路由规则联动
地址要素齐全之后,路由规则才有可靠的输入。例如按「省 + 市 + 区县」映射到仓,按「街道/乡镇」判断是否属于偏远区域,按详细地址关键字识别园区、写字楼、菜鸟驿站等特殊收件点。
四、接入流程
从开通到落地,整体是五步。
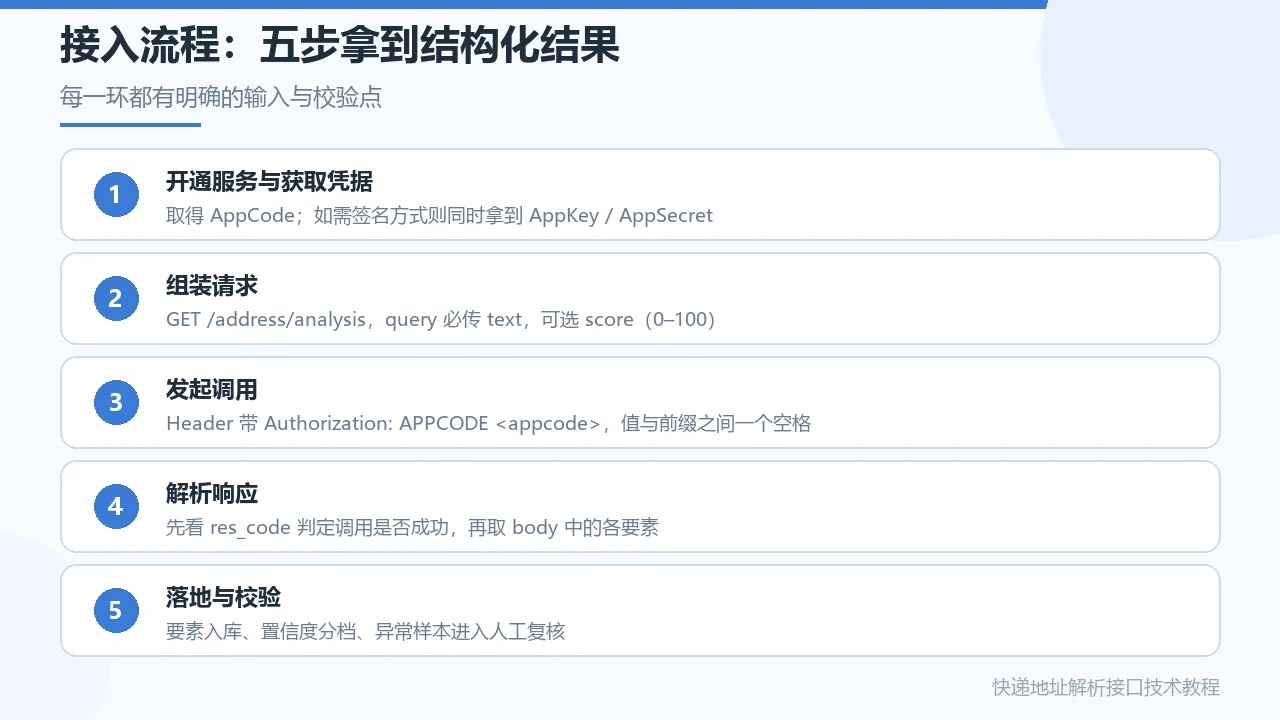
第一步:开通服务并获取凭据。 在云市场订购该接口后,在控制台的应用信息中取得 AppCode。如果使用签名方式调用,则同时需要 AppKey 与 AppSecret,签名需要在服务端生成,不能下发到前端。
第二步:组装请求。 请求方式为 GET,text 必填,score 可选。地址文本需要先做 URL 编码,中文与全角标点必须编码后再拼接,否则容易出现签名或解析异常。
第三步:发起调用。 Header 中携带鉴权信息:
Authorization: APPCODE 你的AppCode
注意 APPCODE 与 AppCode 值之间是一个半角空格,不能写成两个空格,也不能省略。
第四步:解析响应。 先判断调用层结果,再取业务数据。两层判断的顺序不能颠倒。
第五步:落地与校验。 要素入库前做一次本地校验:区划字段是否在自有字典中、电话是否符合长度规则、详细地址是否过短。校验不通过的样本进入复核队列。
调用地址与参数结构以商品页文档为准,示例中使用公开的调用入口:
GET https://jiexi8.market.alicloudapi.com/address/analysis?text=...&score=...
五、调用示例与返回结构
5.1 Python 示例
import json
import urllib.parse
import urllib.request

HOST = "https://jiexi8.market.alicloudapi.com"
PATH = "/address/analysis"
APPCODE = "你的AppCode"          # 从控制台获取,不要写进前端代码


def parse_address(text: str, score: int | None = None, timeout: int = 10) -> dict:
    """调用地址解析接口,返回结构化要素。"""
    params = {
   "text": text}
    if score is not None:
        params["score"] = str(score)
    url = f"{HOST}{PATH}?{urllib.parse.urlencode(params)}"

    req = urllib.request.Request(url, method="GET")
    req.add_header("Authorization", "APPCODE " + APPCODE)
    req.add_header("Content-Type", "application/json; charset=UTF-8")

    with urllib.request.urlopen(req, timeout=timeout) as resp:
        if resp.status != 200:
            raise RuntimeError(f"HTTP {resp.status}")
        payload = json.loads(resp.read().decode("utf-8"))

    # 网关调用层面的判断
    if payload.get("res_code") != 0:
        raise RuntimeError(payload.get("res_error") or "调用未成功")

    body = payload.get("body") or {
   }
    return {

        "province": body.get("province", ""),
        "city": body.get("city", ""),
        "area": body.get("area", ""),
        "town": body.get("town", ""),
        "detail": body.get("detail", ""),
        "name": body.get("name", ""),
        "phone": body.get("phone", ""),
        "score": body.get("score"),
    }


if __name__ == "__main__":
    raw = "瓦丽丽,13311111111,甘肃省 兰州市 城关区 东岗街道向阳街道"
    print(json.dumps(parse_address(raw, score=75), ensure_ascii=False, indent=2))
5.2 Java 示例
import java.net.URI;
import java.net.URLEncoder;
import java.net.http.HttpClient;
import java.net.http.HttpRequest;
import java.net.http.HttpResponse;
import java.nio.charset.StandardCharsets;

public class AddressParse {

    private static final String HOST = "https://jiexi8.market.alicloudapi.com";
    private static final String APPCODE = "你的AppCode";

    public static void main(String[] args) throws Exception {

        String text = "瓦丽丽,13311111111,甘肃省 兰州市 城关区 东岗街道向阳街道";
        String url = HOST + "/address/analysis?text="
                + URLEncoder.encode(text, StandardCharsets.UTF_8);

        HttpRequest request = HttpRequest.newBuilder(URI.create(url))
                .GET()
                .header("Authorization", "APPCODE " + APPCODE)
                .build();

        HttpResponse<String> response = HttpClient.newHttpClient()
                .send(request, HttpResponse.BodyHandlers.ofString());

        System.out.println("HTTP " + response.statusCode());
        System.out.println(response.body());
    }
}
5.3 curl 等价写法
curl -s -G 'https://jiexi8.market.alicloudapi.com/address/analysis' \
  --data-urlencode 'text=瓦丽丽,13311111111,甘肃省 兰州市 城关区 东岗街道向阳街道' \
  --data-urlencode 'score=75' \
  -H 'Authorization: APPCODE 你的AppCode'
5.4 返回结构
成功时返回一个包含三层信息的 JSON:调用层状态、错误描述、业务数据。
{

  "res_code": 0,
  "res_error": "",
  "body": {

    "province": "甘肃省",
    "city": "兰州市",
    "area": "城关区",
    "town": "东岗街道",
    "detail": "向阳街道",
    "name": "瓦丽丽",
    "phone": "13311111111",
    "score": 75
  }
}
上例为示例返回,用于说明结构层级与取值方式;实际字段名、字段数量与类型以官方接口文档为准,接入前请以文档核对一遍再做映射。
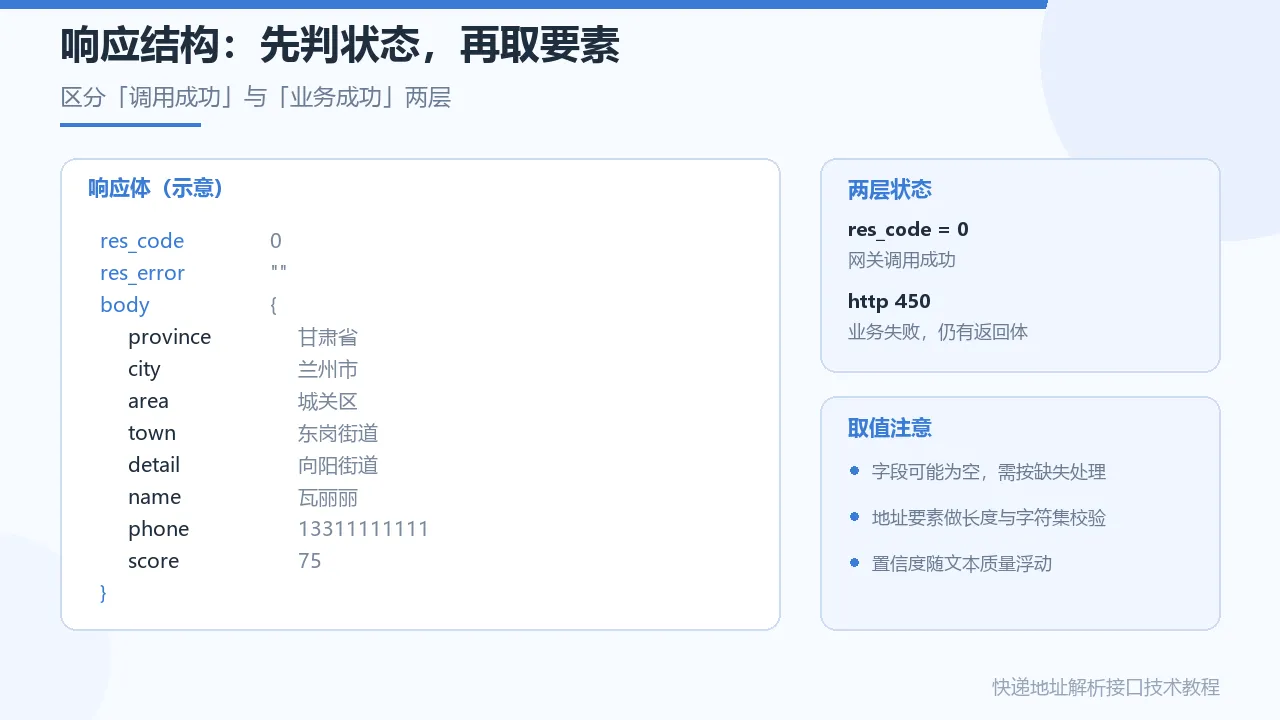
读返回时需要注意两个层次:
res_code = 0表示网关层面调用成功,此时body才可信;- HTTP 状态为 450 时,业务处理失败但仍有返回体,属于「可读但不成功」,不要把它当作调用成功写库。
六、地址质量分级与异常处理
接口给出的是「解析结果 + 置信度」,是否放行要由业务自己判定。实践里比较常见的做法是按三档处理:
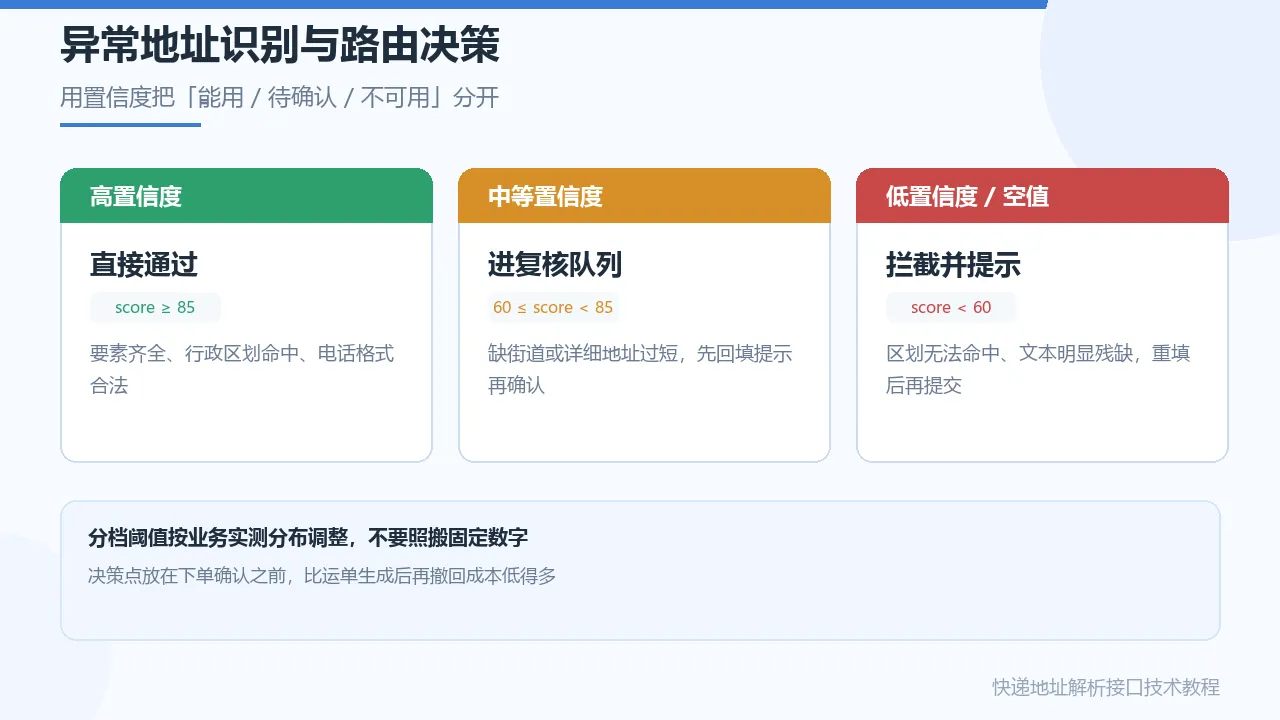
| 分档 | 判定特征 | 处理方式 |
|---|---|---|
| 高 | 省市区县齐全、街道命中、电话合法、置信度较高 | 直接写入订单,参与路由计算 |
| 中 | 缺街道或详细地址过短、置信度中等 | 进入复核队列,同时给用户一个可编辑的补全提示 |
| 低 / 空 | 区划无法命中、字段大量为空 | 拦截提交,要求重填;不要用默认值兜底 |
阈值不要照搬固定数字,应按自有样本的分布来定。建议的做法是:先用一批已知正确的历史订单跑一次解析,统计置信度分布与要素缺失率,再选择切分点;上线后每周抽样复核一次,观察分布是否漂移。
异常处理上有三个值得写进代码的细节:
- 缺字段不等于失败。 返回空字符串时继续走流程,由后续校验决定是否拦截,不要抛出异常直接中断。
- 不要用默认值填充。 把缺失的「区县」默认成省会城市,会把一个可疑地址变成一个看起来正常的错误地址,后者更难发现。
- 保留原始文本。 结构化字段入库的同时保留用户填写的原文,复核时才能对照判断是解析错还是用户写错。
七、调试方法与示例返回
调试的目标不是把一次请求跑通,而是把「不同文本质量 → 不同返回形态」的对应关系摸清楚。
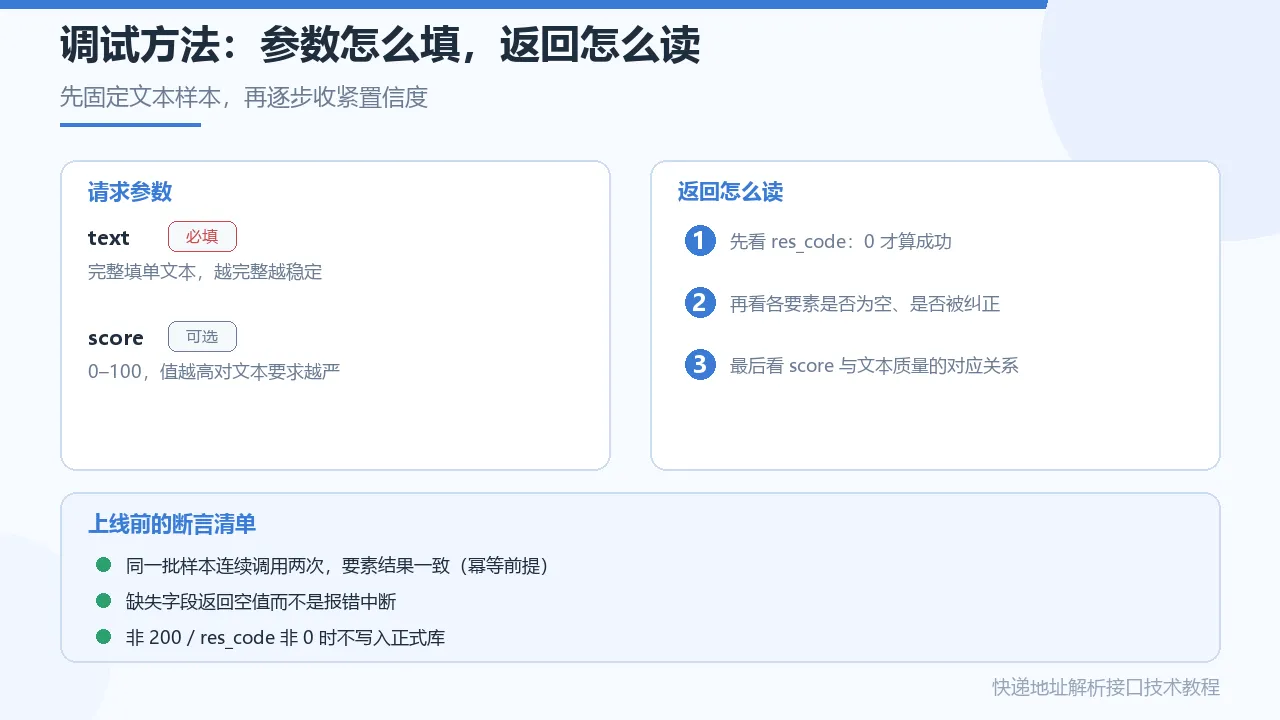
7.1 参数怎么填
text:直接放原始文本,不要自己先按逗号切开。接口需要看到上下文才能区分「张俊」是人名还是商铺名的一部分。score:先留空跑一批,观察默认返回;再用不同取值对比同一批样本,找到「补全力度」与「误判风险」之间的平衡点。- 编码:中文、全角逗号、全角空格都要 URL 编码;用
--data-urlencode或urlencode()交给库处理,不要手拼。
7.2 返回怎么读
- 先看
res_code,非 0 就停在这里排查鉴权与配额。 - 再看各要素是否为空、是否与输入原文一致。被「纠正」过的字段要重点看,纠正正确是收益,纠正错误是风险。
- 最后看置信度与文本质量的对应关系,把它作为阈值设定的依据。
7.3 上线前的断言清单
- 同一批样本连续调用两次,要素结果一致,先确认这一前提,再考虑加缓存;
- 缺失字段返回空值而不是报错中断;
- 非 200 或
res_code非 0 的响应,不写入正式地址库; - 超时与限流响应能被捕获,并进入重试或降级分支,而不是让订单流程卡死。
7.4 工程上的配套做法
地址解析是链路上的一个外部依赖,建议按普通外部依赖来治理:
- 结果缓存:以文本的规范化哈希为 key 缓存解析结果,同一地址短时间内重复提交不必重复调用;
- 重试:仅对超时与 5xx 类响应做有限次重试,采用指数退避;业务失败(如文本无法识别)不应重试;
- 熔断降级:连续失败达到阈值后,短时切换到「直接落原文 + 人工复核」的降级路径,保证下单不被阻塞;
- 监控:记录调用量、非 200 比例、空字段比例、平均置信度,四项指标足以发现大部分问题;
- 幂等:同一订单的地址解析结果按版本号覆盖写,避免重复解析产生多条互相矛盾的记录。
八、调用限制与规范
| 项目 | 说明 |
|---|---|
| 请求方式 | GET,参数走 query,注意 URL 长度 |
| 文本长度 | 过长的文本会被截断或拒绝,建议入库前把地址字段限制在合理长度 |
| 编码 | 统一 UTF-8;中文参数必须 URL 编码 |
| 鉴权 | AppCode 放在 Header,禁止写进前端代码、日志或客户端包 |
| 频控 | 按账号维度限制,批量任务需要自行做并发控制与排队 |
| 响应时间 | 随文本复杂度浮动,调用方必须设置超时(建议 5–10 秒) |
| 结果性质 | 解析结果属于辅助判断依据,不构成对地址真实性的担保 |
九、能力边界与免责
需要明确几件事,避免把接口当成万能校验:
- 依赖输入质量。 文本只有「幸福小区 3 号楼」这样一段门牌时,任何解析都无法给出准确的省市区,此时返回缺失是正确行为。
- 行政区划会变。 新设街道、撤县设区、乡镇合并都会让部分历史写法无法命中,需要定期核对自有字典。
- 不做真实性核验。 接口判断的是文本结构与行政区划归属,不核实这个地址是否真实存在、是否有人居住。
- 不做身份校验。 姓名与电话只是从文本中抽取,不构成实名核验,不能作为风控唯一依据。
- 合规要求由调用方承担。 地址与电话属于个人信息,采集、存储、使用需遵守最小必要原则,并有明确的用户告知与用途约束。
关于数据处理,建议在接入时就把下面几条落进设计里:
- 传输层强制 HTTPS,服务端不记录完整请求 URL(其中含明文地址);
- 日志脱敏:手机号中间四位掩码,详细地址只保留到街道;
- 不做长期留存:解析结果只服务于履约链路,履约结束后按策略清理;
- 访问控制:AppCode 按环境隔离,测试与生产分开,避免共用一套凭据。
十、错误码排查
调用异常通常分成两类:网关层面与业务层面。
| 状态 / 错误 | 含义 | 排查方向 |
|---|---|---|
400 + Invalid AppCode |
鉴权头缺失或格式不对 | 检查是否为 APPCODE <值>,中间是否为单个空格 |
400 + Invalid AppKey |
使用了签名方式但 AppKey 无效 | 核对 AppKey 是否有空格、是否被截断 |
400 + Invalid AppSecret |
签名密钥错误 | 核对 AppSecret,注意复制时是否带入换行 |
| 403 + 未授权 | 应用未获得该接口调用权限 | 在控制台确认订购关系与接口绑定 |
| 403 + 配额相关 | 调用次数已用尽或订购关系到期 | 核对该应用下的余量与有效期 |
| 403 + 用户欠费 | 账号状态异常 | 处理账号状态后重试 |
| 450 | 接口调用成功、业务处理失败 | 看返回体中的提示;此类响应不计入成功调用 |
| 超时 / 连接失败 | 网络或服务端耗时过长 | 检查超时设置、重试策略与出口网络 |
排查顺序建议固定下来:先看 HTTP 状态码,再看返回体中的 res_code 与 res_error,最后才怀疑参数本身。多数「解析不出来」的反馈,根因是 AppCode 前后多了空格,或者中文参数没有编码。
十一、技术 FAQ
Q1:text 里需要按固定顺序写姓名、电话、地址吗?
不需要严格顺序,但有语义线索时命中率更高。实践中「姓名 + 电话 + 地址」的顺序最容易被正确切分。
Q2:为什么返回的区县和我输入的写法不一样?
接口做了行政区划归一,例如把旧称映射到现行名称、补齐被省略的层级。若业务要求保留用户原写法,请同时存放原文与解析结果。
Q3:score 传得越高越好吗?
不是。高阈值意味着只对规范文本给出结果,文本稍乱就会空字段。取值应由业务能接受的人工复核量决定,而不是越大越安全。
Q4:可以放在前端直接调用吗?
不可以。AppCode 等同于调用凭据,暴露在前端会被直接抓取。必须由服务端转发调用,前端只接收结构化的必要字段。
Q5:解析结果能直接用来算运费吗?
可以用来做初步匹配,但运费计算还应叠加体积重量、配送范围、特殊区域规则等业务条件。把地址要素作为输入之一,而不是唯一输入。
Q6:批量治理历史订单时要注意什么?
控制并发、按批次记录进度、把失败样本单独落盘。不要一次性全量重跑,否则一旦限流,进度难以恢复。
十二、内容小结
- 快递地址解析接口的本质是要素抽取 + 行政区划对齐 + 置信度输出,解决的问题是把自由文本变成可入库、可计算的结构化字段。
- 接入是标准 HTTP GET + AppCode 鉴权的形式,主要成本不在调用本身,而在响应判读与业务分级。
- 判断顺序固定为:HTTP 状态码 →
res_code→ 各要素取值。 - 置信度不是用来「判定真伪」的,而是用来决定这个地址走直通、复核还是退回。
- 缺字段要按缺失处理,不要用默认值兜底;原文要与结构化结果一起留存。
- 把缓存、重试、熔断、监控和脱敏当成接入的一部分,而不是上线后的补丁。
按这个顺序落地,地址就不再是一段只能存不能算的文本,而是订单链路里一个可校验、可路由、可追责的数据结构。
