
导读:在 AI 算力项目中,把 GPU 服务器采购到位、运进机房,只是整个项目的第一步。设备能开机,不代表集群能稳定运行;单卡参数好看,也不代表整机柜、整个集群的性能可以通过项目验收。真正决定项目成败的,是设备交付之后一整套工程化工作:方案设计、规范布线、上电检测、IB / RoCE 组网、存储与服务器调优、跑分验收、长期运维以及硬件维修。
本文系统梳理 GPU 算力集群从 0 到 1 的完整工程链路,并给出可直接落地的检查清单与常用工具,适合算力设备厂商、IDC / 机房运营方、AI 算力平台以及基础设施(SRE)团队参考。
一、为什么"设备到位"不等于"算力交付"
一个典型的 GPU 集群项目,在设备到货之后还会面临一连串具体的工程问题:
- 集群网络拓扑怎么设计?业务网、管理网、存储网如何划分?
- 服务器如何上下架?光纤、网线、电源线如何规范走线?
- 上电后 GPU、网卡(NIC)、电源、风扇等硬件状态如何逐一确认?
- IB / RoCE 网络如何组网、如何调优才能跑满带宽?
- 存储系统如何部署?IOPS、带宽、延迟如何测试达标?
- 集群整体如何跑分?性能不达标时如何定位瓶颈?
- 项目验收需要哪些测试数据和标准化文档?
- 上线后谁来 7×24 监控、巡检、处理故障?设备坏了谁来修?
如果为每个项目都临时招聘、培养一整套 GPU 工程团队,很容易出现项目高峰期人力不足、项目结束后人力闲置的潮汐矛盾。工程化交付的核心价值,就是把一批独立的 GPU 服务器,真正变成一个可交付、可运行、可测试、可验收、可维护的算力集群。
二、集群交付全流程总览
一个完整的 GPU 集群交付项目,通常划分为八个顺序衔接的阶段:
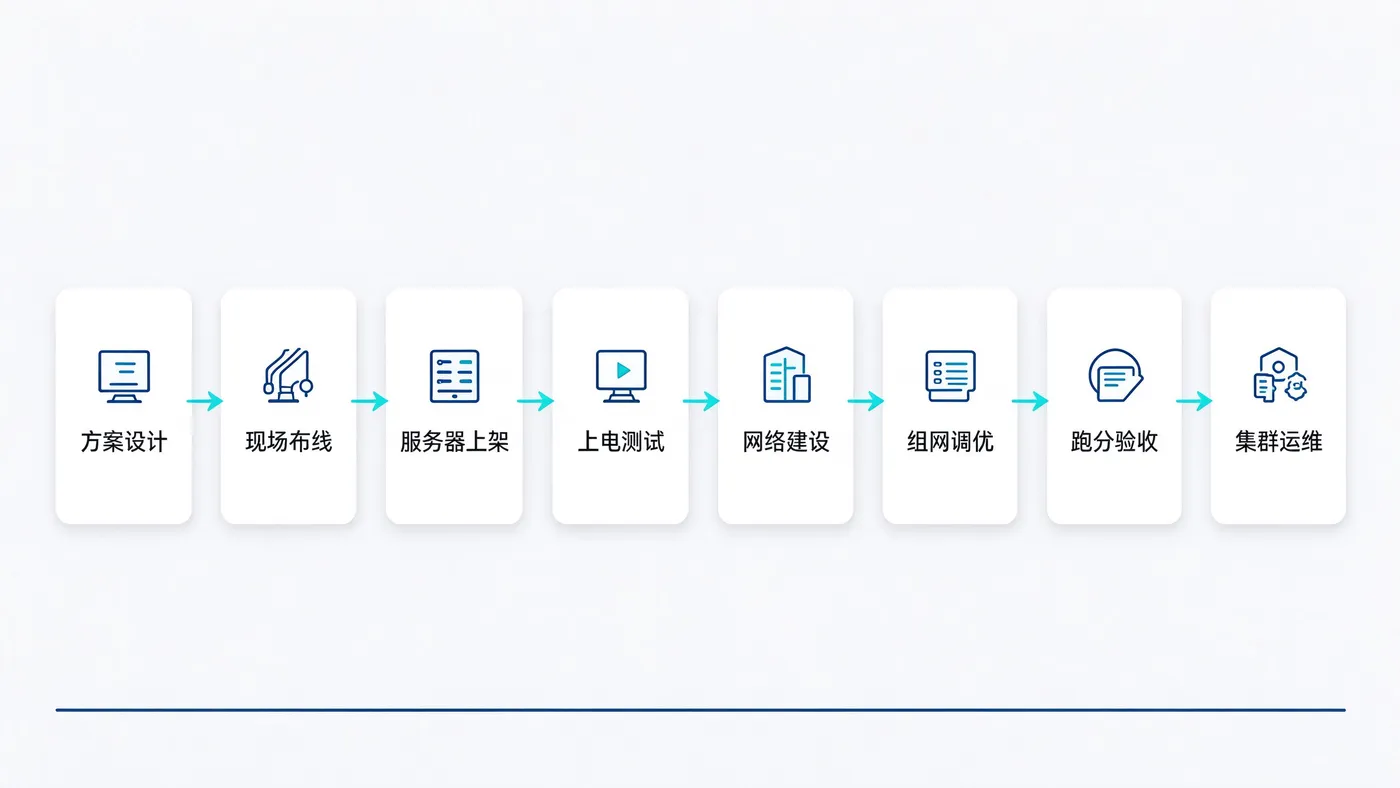
| 阶段 | 核心工作内容 | 关键产出 |
|---|---|---|
| 1. 方案设计 | 集群架构、网络拓扑、容量与供电规划、实施计划 | 集群建设方案、实施规划书 |
| 2. 现场布线 | 光纤、网线、电源线整理,规范走线与标签 | 布线表、链路标签 |
| 3. 服务器上架 | 设备上下架、导轨安装、资产核对 | 资产清单、机柜 U 位图 |
| 4. 上电测试 | 带外管理连通、GPU / NIC / 硬件状态检查 | 上电检查报告 |
| 5. 网络建设 | 三网建设、交换机配置、IB / RoCE 组网 | 网络配置基线 |
| 6. 组网调优 | 性能调优、异常排查、连通性验证 | 网络性能测试报告 |
| 7. 跑分验收 | 压力测试、集群跑分、稳定性测试、资料整理 | 验收报告、测试数据 |
| 8. 集群运维 | 监控、巡检、故障处理、变更配合、维修支持 | 运维记录、SLA 报告 |
下文按照这一主线,逐段展开每个阶段的技术要点。
三、方案设计与现场交付
3.1 方案设计
方案设计阶段需要在设备进场前把架构层面的问题确定下来,主要包括:
- 规模与容量规划:根据业务(训练 / 推理)确定 GPU 卡数、节点数、单机卡型与卡数,以及对应的供电、制冷和机柜空间。
- 网络架构设计:确定三网划分、Leaf-Spine 组网层级、收敛比、端口与光模块数量、IB 或 RoCE 技术选型。
- 存储规划:根据数据集规模和读写特征确定并行文件系统 / 分布式存储 / 本地 NVMe 的容量与配比。
- 实施计划:明确进场顺序、上架节奏、上电窗口、割接与验收里程碑,避免现场窝工。
3.2 现场实施与规范布线
现场阶段的工作看似基础,却直接决定后续运维效率:
- 服务器上下架、导轨安装、设备固定与资产核对;
- 光纤、网线、电源线分路整理,强电与弱电分离,做到横平竖直、预留维护余量;
- 所有链路两端粘贴统一标签,与布线表一一对应,便于后续快速定位;
- 机柜内冷热通道方向一致,避免设备送风短路。
3.3 上电与硬件检查
上电环节建议通过 BMC / IPMI 带外管理先确认管理网连通,再逐机检查。可参考下面的上电检查清单:
| 检查项 | 检查内容 | 常用方式 |
|---|---|---|
| 整机状态 | 电源、风扇、温度、告警灯 | BMC Web / ipmitool |
| GPU 状态 | 卡数、型号、温度、ECC 错误 | nvidia-smi、DCGM |
| 网卡状态 | 端口 Link、速率、固件版本 | 厂商工具、ethtool |
| 固件版本 | BIOS / BMC / GPU VBIOS / NIC 固件一致性 | 版本基线表 |
| 链路连通 | 光模块、端口、对端交换机对应关系 | 链路标签 + 交换机侧核对 |
提示:固件与驱动版本不一致是集群交付中最常见的隐患之一,建议在方案阶段就冻结统一的版本基线,避免后期逐机返工。
四、网络建设:三网分离与 IB / RoCE 组网
网络是 GPU 集群中最容易成为瓶颈、也最考验工程经验的部分。

4.1 三网分离设计
数据中心 GPU 集群通常按用途划分为三张相互隔离的网络:
- 业务网(计算网):承载 GPU 节点之间的集合通信(如 AllReduce、AllGather),要求高带宽、低时延,部署 RDMA(IB 或 RoCE)。
- 管理网:承载 BMC 带外管理、系统部署、日志与监控流量,独立组网,不与业务流量争抢带宽。
- 存储网:承载节点到存储系统的数据读写,要求稳定的高吞吐,常与业务网物理或逻辑隔离。
4.2 Leaf-Spine 两层组网
中大规模集群普遍采用 Leaf-Spine(叶脊)Clos 架构:
- 服务器全部接入 Leaf(叶子 / 接入层)交换机;
- Leaf 之间通过 Spine(脊 / 核心层)交换机全互联;
- 任意两个节点之间的路径长度一致、跳数相同,便于横向扩展并控制拥塞;
- 通过合理的收敛比(过订阅比)平衡成本与性能,训练集群通常追求接近无阻塞的网络。
4.3 InfiniBand 与 RoCE 如何选型
| 对比维度 | InfiniBand(IB) | RoCE v2(以太 RDMA) |
|---|---|---|
| 技术本质 | 原生 RDMA 网络,独立协议栈 | 基于 UDP / IP 的 RDMA,运行在以太网 |
| 典型带宽 | HDR 200G、NDR 400G 等 | 100G / 200G / 400G 以太网 |
| 拥塞控制 | 协议原生支持,调优相对简单 | 依赖 PFC、ECN / DCQCN 等,配置要求高 |
| 生态与运维 | 与 NVIDIA 软件栈结合紧密 | 可复用现有以太网运维体系 |
| 适用场景 | 大规模训练、追求极致通信性能 | 希望兼顾以太网兼容性与成本的场景 |
简单概括:IB 开箱即用、通信性能强;RoCE 依托以太网、生态灵活,但需要更精细的无损网络配置。
4.4 关键调优点
RoCE 网络要做到"无损",通常需要重点配置和验证以下内容:
- PFC(优先级流控):基于优先级的链路级流控,防止队列丢包;
- ECN / DCQCN:显式拥塞通知与端到端拥塞控制,缓解网络热点;
- Jumbo Frame(巨帧):将 MTU 提升到 9000 左右,降低大包传输开销;
- 网卡与 PCIe 拓扑对齐:确保 GPU 与 NIC 在同一 NUMA / PCIe Switch 下,减少跨 NUMA 绕行;
- NCCL 参数:结合实际拓扑调整
NCCL_IB_*、NCCL_SOCKET_IFNAME、NCCL_NET_GDR_LEVEL等环境变量。
4.5 网络验证常用工具
| 验证目标 | 常用工具 |
|---|---|
| RDMA 带宽 / 时延 | perftest(ib_write_bw、ib_send_bw、ib_read_lat) |
| 集合通信性能 | nccl-tests(all_reduce_perf、all_gather_perf) |
| 基础连通与吞吐 | ping、iperf、qperf |
| 拥塞 / 丢包统计 | 交换机端口计数器、网卡计数器 |
集群通信的总线带宽(bus bandwidth)是否随节点数近似线性扩展,是判断组网调优是否到位的重要依据。
五、存储与服务器调优
5.1 存储系统部署与测试
- 根据业务选择并行文件系统、分布式存储或本地 NVMe 缓存,并完成挂载与多路径配置;
- 存储网络与业务网隔离,避免大流量数据读写冲击集合通信;
- 使用 fio 等工具在多节点并发场景下测试 IOPS、顺序 / 随机带宽、读写延迟,并关注元数据操作和小文件场景的表现;
- 训练场景重点关注多机并发读取时的聚合吞吐是否能够"喂饱"GPU,避免 GPU 空等数据。
5.2 服务器侧调优
服务器进入业务部署前,建议统一完成以下基线配置:
- BIOS 设置:开启 Above 4G Decoding、按需开启 SR-IOV / IOMMU、关闭不必要的节能选项,电源策略设为高性能。
- NUMA 亲和:确认 GPU、网卡、CPU 的 NUMA 归属,业务进程绑定本地 NUMA,减少跨节点内存访问。
- 驱动与运行时:统一 NVIDIA 驱动、CUDA、NCCL、网卡驱动及固件版本,形成可复制的软件基线。
- 系统参数:调整文件句柄数、进程数、内核网络参数等,适配大规模并发任务。
六、性能测试与项目验收
设备能开机只是起点,性能达标、通过验收才是交付的终点。
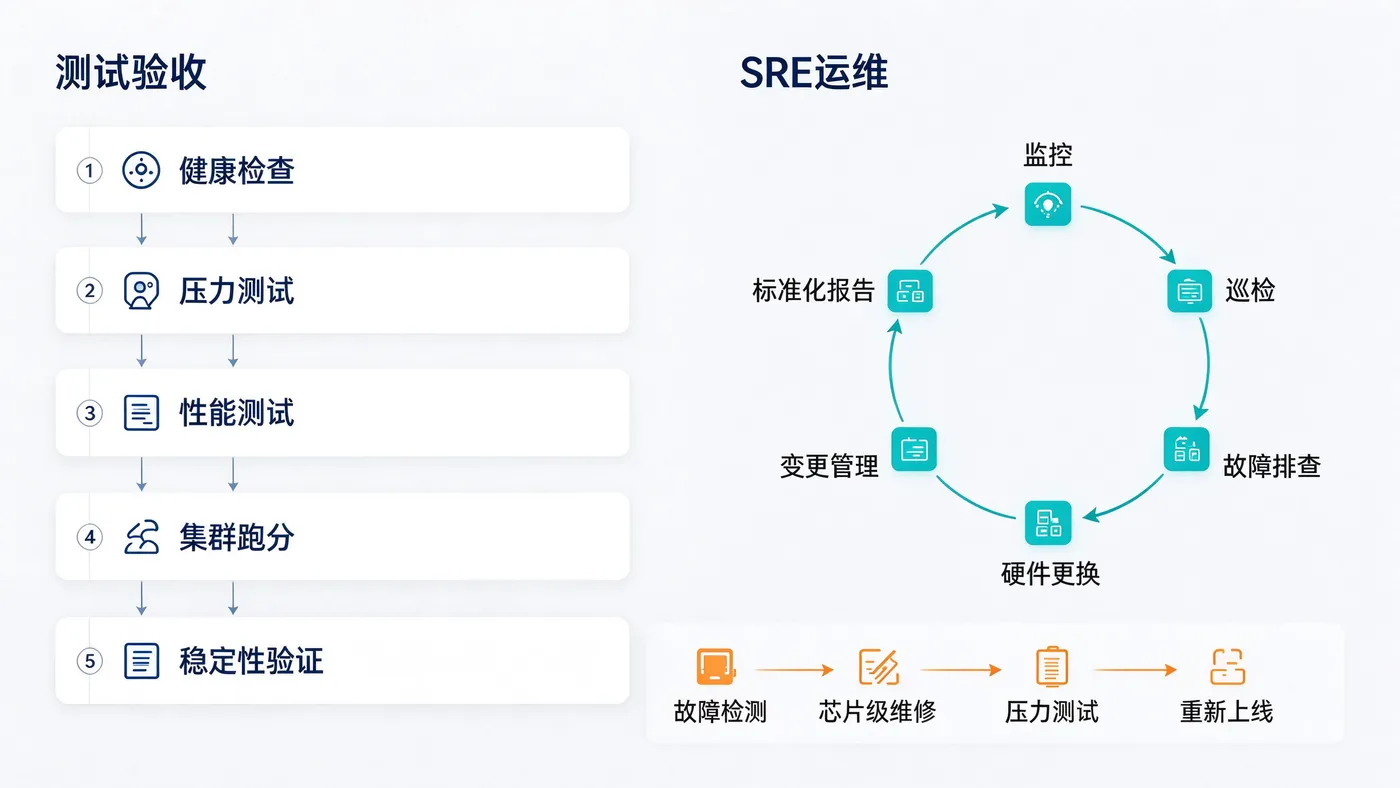
6.1 测试验收的五个层次
- GPU 健康检查:通过
nvidia-smi、DCGM 确认卡数、温度、功耗、ECC 错误与 XID 事件。 - 整机压力测试:使用 gpu-burn、
dcgmi diag等进行长时间高负载测试,暴露散热、电源与显存隐患。 - 网络与存储性能测试:分别验证 RDMA 带宽、集合通信效率和存储 IO 指标。
- 集群跑分与调优:通过 nccl-tests、MLPerf 等基准测试评估集群整体性能,对不达标项进行瓶颈定位与调优。
- 稳定性验证:在接近真实业务的负载下持续运行,观察是否存在掉卡、宕机、通信中断等问题。
6.2 验收资料标准化
项目验收时建议沉淀一整套标准化文档,包括但不限于:
- 集群拓扑图、资产清单与 U 位图;
- 硬件检查记录、固件 / 驱动版本基线;
- 网络、存储、GPU 及集群跑分的完整测试数据;
- 稳定性测试记录与问题处理闭环;
- 运维手册、监控告警说明与应急联系人矩阵。
建议:验收标准和测试方法应在项目启动阶段就与甲方书面确认,避免交付时因口径不一致产生争议。
七、SRE 与算力集群运维
集群上线只是进入生命周期的另一个阶段,稳定运行依赖体系化的 SRE 能力。
7.1 分级 SLA 服务模式
根据机房规模、业务重要性和故障响应要求,可灵活选择不同的运维模式:
| 服务模式 | 覆盖时段 | 典型适用场景 |
|---|---|---|
| 5×8 | 工作日工作时段 | 非关键业务、测试环境 |
| 7×12 | 每天 12 小时值守 | 较重要的生产业务 |
| 7×24 | 全天候值守 + 应急响应 | 核心训练 / 在线推理集群 |
7.2 监控与巡检体系
- 监控栈:常用 Prometheus + DCGM Exporter + Grafana,采集 GPU 利用率、显存、温度、功耗、ECC / XID 以及节点和网络指标;
- 告警分级:按故障影响面划分等级,明确通知渠道、响应时限和升级路径;
- 定期巡检:对硬件状态、链路误码、容量水位、日志告警、备份与变更进行周期性检查;
- 标准化报告:输出巡检记录、故障复盘、容量与可用性报告,让运维状态可追溯。
7.3 日常运维职责
日常 SRE 工作通常覆盖:故障排查与定位、硬件更换、驱动 / 固件问题处理、变更发布配合、运维记录与标准化报告输出,以及与业务方的割接、演练协调。
八、GPU 芯片级维修能力
算力集群硬件规模大、长期高负载运行,板卡故障难以完全避免。维修能力的核心目标是尽可能缩短设备停机时间,让算力尽快恢复生产。
8.1 标准维修链路
故障检测与定位 → 硬件更换 → 板卡维修 → 芯片级维修 → 维修后测试验证
针对 GPU、显存、板卡、电源、网卡等不同部件的故障,先检测定位,再判断是整体更换、板卡维修还是对具备条件的板卡进行芯片级维修。
8.2 修后验证五步
维修完成的板卡不能直接上线,必须经过完整验证:
- 上电测试:确认整机供电与启动正常;
- GPU 识别:系统能够正确识别卡型与数量;
- 显存检测:检查显存容量与 ECC 错误;
- 高负载压力测试:满负载运行验证散热与稳定性;
- 稳定性验证:持续运行确认无复发故障后再重新上线。
常见故障类型包括显存报错、GPU 掉卡、电源与风扇故障、网卡异常以及板卡级器件损坏等,建立规范的检测—维修—复测闭环,可有效避免重复返修。
九、覆盖型号与资源组织
9.1 重点覆盖的 GPU 型号
当前主流的新一代数据中心 GPU,无论是交付运维还是芯片板卡维修,基本都已形成成熟的工程方法,重点型号包括:
GB300 | B300 | GB200 | B200 | H200 | H100 | H800 | H20 | L20
9.2 弹性资源组织
- 无论几十台、几百台还是更大规模的项目,都可以按实际需求匹配工程师资源;
- 支持按项目、按阶段灵活支援,也可按 SLA 配置长期驻场团队;
- 典型的直接合作对象包括:算力设备 / GPU 服务器厂商、算力租赁公司 / AI 算力平台、IDC / 机房运营方,以及拥有 GPU 集群的直接甲方。
结语
算力设备可以通过采购快速获得,但把设备变成稳定、高性能算力集群的工程能力,需要在网络、存储、服务器、测试、运维和维修等多个环节长期沉淀。
一条成熟的工程化交付链路,最终要回答好五个问题:
- 可交付:方案、布线、上架、上电规范闭环;
- 可运行:三网组网、存储与服务器调优到位;
- 可测试:硬件、网络、存储、集群跑分数据完整;
- 可验收:标准明确、文档齐全、性能达标;
- 可维护:SRE 监控运维与硬件维修体系持续护航。
希望这份全流程梳理,能够帮助正在建设或运维 GPU 集群的团队少走弯路,把更多精力留在模型与业务本身。
