0.90 的 percolator 先把查询注册到
_percolator索引,再发文档过去问哪些查询命中。本文按固定标签核对注册与匹配路径、过滤执行哪些查询、分片如何处理请求,以及这套写法的适用边界。
说明
实测环境:本地另起一个 Elasticsearch 7.17.29 单节点实例(官方 tar 包,端口 9200,独立 path.data);本机没有 0.90 / 1.x / 2.x 二进制,所以这里验的是这些旧写法在较新版本上的当前行为,不是当年的执行过程。文末「在 7.17.29 上跑一遍」里的命令与响应均取自该实例。
本文只讨论 0.90 的历史实现,不表示当前云服务支持这些旧接口。示例用于准备隔离的旧版本验证环境,不得在生产集群执行,也不要对外开放旧版本服务。文末实测小节里的命令与响应取自本机 7.17.29 实例;0.90 当年的执行过程无实例可对照。
反过来的检索
正常用法是文档进索引、查询去搜。percolator 反过来。0.90 的Percolate API 文档这样描述:
The percolator allows to register queries against an index, and then send
percolaterequests which include a doc, and getting back the queries that match on that doc out of the set of registered queries.
文档给的例子是:用户注册一个关注“包含 elasticsearch 的推文”的查询,之后每来一条推文,就用它去问哪些注册的查询命中。这类“订阅、告警、内容匹配”的需求至今仍在,变化的是实现方式。
需要注意一处容易被读错的地方。percolate 请求里的文档不会被真正索引,文档在示例中明确写了 note, its not really indexed!,见第 39–40 行。它只是作为匹配输入,不会出现在业务索引里。
注册、匹配与注销的路径
文档给出的最小流程使用三个请求。以下是 0.90 的旧式 REST 写法,需要由受控 HTTP 客户端发送:
curl -XPUT localhost:9200/test

curl -XPUT localhost:9200/_percolator/test/kuku -d '{
    "query" : { "term" : { "field1" : "value1" } }
}'

curl -XGET localhost:9200/test/type1/_percolate -d '{
    "doc" : { "field1" : "value1" }
}'
响应形如 {"ok":true, "matches":["kuku"]},命中的查询以名称列表返回,见第 51–56 行。
注册路径 localhost:9200/_percolator/test/kuku 有三段:_percolator 是存放注册查询的索引,test 是这些查询所针对的业务索引,在 _percolator 索引里以 type 表示,kuku 是查询名。文档自己也承认这个映射有点绕,见第 104–107 行。
匹配路径 localhost:9200/test/type1/_percolate 指向业务索引与 type,请求体里的 doc 是待匹配的文档。这里的 type 用于解释输入文档,与存储查询的 type 不是同一件事。
注销就是用删除文档的接口删掉 _percolator 里那条记录,因为注册的查询本来就是索引里的文档,见第 58–63 行。
查询存成了文档,因此可以用查询筛选
文档专门有一节讲“过滤被执行的查询”。既然注册查询就是文档,就可以在注册时带业务字段,再在 percolate 时用 query 限定执行哪些查询,见第 66–99 行。
curl -XPUT localhost:9200/_percolator/test/kuku -d '{
    "color" : "blue",
    "query" : { "term" : { "field1" : "value1" } }
}'

curl -XGET localhost:9200/test/type1/_percolate -d '{
    "doc" : { "field1" : "value1" },
    "query" : { "term" : { "color" : "blue" } }
}'
这在多租户或分类场景下很实用:注册时带上归属标记,匹配时只执行属于当前租户或当前类别的查询。
但筛选不等于授权。 用 color 之类的字段限定执行范围,前提是调用方不能随意构造这个条件。真正的权限仍应由服务端按调用身份校验,不能把请求里的过滤条件当成访问控制。
另一个实际问题是字段解释。为注册文档增加业务字段后,这些字段也会进入 _percolator 索引的映射。不同业务写入不同类型的值可能引起类型冲突,因此应事先约定字段与类型,并在样本中覆盖缺失该字段的注册记录。
分片怎么处理 percolate 请求
文档对执行方式有明确说明,维护老系统时值得逐条核对。
_percolator 索引使用 index.auto_expand_replica 设置,让每个数据节点都能在本地访问已注册的查询,见第 113–116 行。
percolate API 把全部分片当作处理引擎,主分片与副本都算。文档举例:若 test 索引有 2 个主分片、1 份副本,就有 4 个分片轮流处理 percolate 请求;动态增加副本可以增加处理能力,见第 118–123 行。
请求还会优先在本地执行:如果接收请求的节点上有相应分片,就不会再跨节点轮转。文档因此建议客户端自己在节点间做轮转,并说明可以用 prefer_local=false 关闭这一行为,见第 125–130 行。
这些描述说明扩容与路由都有自己的机制,不能凭“所有查询都存在一个特殊索引”推断出“每次都要遍历全部查询”或“延迟与查询数必然线性相关”。这类性能结论需要实测,本文不作断言。
一次只处理一个文档,也不支持子文档类查询
文档最后两条限制很具体:percolate API 一次处理一个文档,因此不支持针对子文档和嵌套文档的查询与过滤器,如 has_child、has_parent、top_children、nested,见第 132–135 行。
也就是说,设计注册查询时要避开这些结构。如果业务文档本身用到了 nested,注册查询里引用嵌套字段的匹配方式就需要重新设计,而不是假设与普通字段一样。
批量匹配也要在客户端处理。文档没有给出一次请求 percolate 多篇文档的接口,因此大批量匹配需要在应用侧组织请求与并发,并按返回结果汇总。
准备一组能区分归属的验证数据
下面按文档写法整理一份完整顺序,供隔离的 v0.90.13 环境验证。旧版本没有现代 Dev Tools 配套,需通过受控 HTTP 客户端发送;不要提交给当前生产版本。
先建两个业务索引,分别注册同名但内容不同的查询:
curl -XPUT localhost:9200/news

curl -XPUT localhost:9200/logs

curl -XPUT localhost:9200/_percolator/news/hit -d '{
    "color" : "blue",
    "query" : { "term" : { "title" : "elasticsearch" } }
}'

curl -XPUT localhost:9200/_percolator/logs/hit -d '{
    "color" : "blue",
    "query" : { "term" : { "message" : "error" } }
}'
两个业务索引的查询名都叫 hit,但字段不同。这样可以看出请求打到哪个索引的 type 上,以及返回结果里的名字是否足以定位查询。
再分别对两个业务索引发起匹配:
curl -XGET localhost:9200/news/type1/_percolate -d '{
    "doc" : { "title" : "elasticsearch" },
    "query" : { "term" : { "color" : "blue" } }
}'

curl -XGET localhost:9200/logs/type1/_percolate -d '{
    "doc" : { "message" : "error" },
    "query" : { "term" : { "color" : "blue" } }
}'
预期检查项是:对 news 的请求返回 hit,对 logs 的请求也返回 hit,但两者来自不同业务索引的注册集合。返回的名字相同,不代表是同一条查询,因此业务侧应保留索引名与查询名的组合,不要只存 matches 里的字符串。
随后做过滤验证:把 color 改成 red 再请求一次,观察是否不再命中。再删除其中一条注册,重新请求,确认它不再返回。这两步分别验证过滤条件与注销是否生效。
最后做负向验证:发送一个两个字段都不匹配的文档,确认 matches 为空。空结果不等于请求失败,应用需要区分“没有查询命中”和“请求未成功执行”。
注册与匹配各经过哪些环节
把两条链路分开看,排查时更容易定位问题。下图按文档说明简化,不表示内部实现的完整调用过程:
flowchart TD
    A[PUT 到 _percolator/业务索引/查询名] --> B[查询作为文档写入 _percolator]
    B --> C[业务索引的 type 承载归属]
    C --> D[percolate 请求带 doc 到业务索引]
    D --> E[按 query 筛选要执行的注册查询]
    E --> F[用 doc 匹配命中的查询并返回名称]
注册链路的关键在于:查询内容就是文档体,查询名就是 _id,归属由 _percolator 里的 type 表示。因此“改一条规则”就是改一篇文档,“删一条规则”就是删一篇文档。
匹配链路的关键在于:请求打到业务索引的 _percolate 端点,请求体里的 doc 按该业务索引的 mapping 解释。也就是说,输入文档的解释方式取决于业务索引的 mapping,而不是注册查询所在索引的 mapping。
注册时携带的业务字段(如示例里的 color)则属于 _percolator 索引的文档字段,用于筛选。两类字段位于不同索引,语义不同,配置 mapping 时要分别考虑。
一致性与可见性要单独验证
文档没有说明注册后何时对后续 percolate 请求可见,也没有说明是否需要 refresh。因此不应默认“写入即可见”或“必须 refresh”,而应在目标版本上实测。
可验证的点包括:注册之后立即 percolate 是否命中;覆盖注册同一 _id 之后,匹配结果是否立刻反映新查询;删除之后是否立刻不再命中;以及节点重启后注册查询是否仍然存在。
文档说明查询以文档形式保存在索引里,因此持久化是这套设计的基础,见第 109–111 行。但“持久化”不等于上述每一项时序行为都相同,具体仍需实测确认。
覆盖注册尤其要小心。用同一个 _id 写入新查询会替换旧文档,如果客户端误用了别人的查询名,就会覆盖掉另一条规则。上线前应约定命名规则,并在注册前先检查该 _id 是否已存在。
排查请求没反应时先看什么
旧示例大量使用带请求体的 GET。今天的多数 HTTP 客户端、代理和网关对 GET 携带 body 的处理并不一致,可能被拒绝,也可能丢弃 body。看到 percolate 请求没有返回预期结果时,应先确认请求体是否真的到达了服务端。
可以按这个顺序排查:确认客户端真的发送了 body;确认中间代理没有改写或丢弃;确认请求路径中的索引名与 type 都存在;确认注册查询确实写在对应的业务索引名下;最后再检查查询 DSL 本身。
响应也要完整检查。文档示例的响应是 {"ok":true, "matches":["kuku"]},其中 ok 是当时通用的成功标志。应用不能只判断这个布尔值,还应检查是否有失败信息,以及 matches 为空时的语义。
这类“只看成功标志”的写法在老代码里很常见,迁移时应改成检查具体的结果状态,避免把执行失败当成没有命中。
筛选条件不是权限
用 query 过滤要执行的注册查询,解决的是效率与范围问题,不是访问控制。如果调用方可以任意构造这个过滤条件,就能让别人的查询参与匹配,甚至通过命中与否推断出他人订阅了什么。
正确的做法是由服务端按调用身份决定过滤条件,客户端不能传入任意查询。规则标识与租户归属的校验也应在服务端完成,不能依赖请求里传来的业务标记。
返回内容同样要控制。matches 只返回查询名,但查询名本身可能包含业务信息;若应用把查询名再映射成展示文案,也要注意这一步是否会泄露其他租户的订阅内容。
老代码里怎么认出这一代写法
维护 2013 年前后的系统时,可以按几个特征识别:
| 特征 | 说明 |
|---|---|
路径里出现 _percolator 索引 |
0.90/1.x 的注册存储方式 |
端点以 _percolate 结尾 |
0.90 的匹配入口 |
响应里判断 ok 字段 |
0.90 年代响应格式的常见痕迹 |
| URL 里显式写 type | 当时每个索引可有多个 type |
查询名作为 _id 使用 |
注册查询就是索引里的文档 |
认出之后,迁移方向是把“注册查询 + 文档匹配”的语义搬到后续版本的实现上,而不是直接改写 URL。1.0 的重新设计由相邻那篇处理,这里只说明 0.90 这一代的结构。
迁移时还要注意身份问题。旧实现里 _percolator 索引的 type 承载业务索引名,查询名只是 _id;不同业务索引可以有相同的查询名。搬迁时若只保留 _id,就会丢失归属,必须同时保留原 (_index, _type, _id) 的对应关系。
注册查询本身的写法要注意什么
注册查询是对业务索引的文档执行的,因此它引用的字段必须与业务索引的 mapping 一致。字段类型或分析器不同,term 这类精确匹配就可能匹配不上,例如一边是分词后的文本、一边期望精确值。
字段不存在时的行为本文没有核实,需要按目标版本实测:可能匹配失败,也可能被当作空值处理。不能假定“引用了不存在的字段会报错”,那样会让排查方向出错。
分析器也要单独确认。注册查询里的 term 与待匹配文档使用同一套 mapping,但文档是否被分析、分析后是什么词项,取决于该字段的配置。建议准备一个最小样本,只包含一个字段和一个 term 查询,确认能命中后再扩展到复杂规则。
复杂规则建议拆开验证。把多个条件的组合先分别验证,再合并,能区分“某个条件写错”和“组合逻辑不对”。直接在复杂规则上排查,往往难以定位。
这一代实现的几处约束
把 0.90 这一代的限制列出来,有助于理解后续为什么要改:
| 约束 | 文档依据 |
|---|---|
归属由 _percolator 的 type 表示,容易混淆 |
第 104–107 行,文档自己也这么说 |
| 一次只处理一个文档 | 第 132–135 行 |
| 不支持子文档与嵌套类查询 | 同上 |
| 请求优先本地执行,客户端需自行轮转 | 第 125–130 行 |
| 扩容依赖增加副本 | 第 118–123 行 |
这些约束并不否定它的语义。注册查询、拿文档去问这一思路一直保留下来,变化的是查询存在哪里、如何随业务索引管理。
本文不推断改动动机,只记录这一代文档写明的事实。后续实现的细节由相邻那篇处理,更晚的形态不在本文核对范围。
上线前可以照着走的检查表
| 检查项 | 要确认什么 |
|---|---|
| 归属保留 | 是否记录了业务索引名与查询名的对应关系 |
| 命名冲突 | 同一 _id 是否可能覆盖他人规则 |
| 过滤条件 | 是否由服务端按身份生成,而非客户端传入 |
| 输入 mapping | 待匹配文档的字段类型是否符合预期 |
| 结果判读 | 空 matches 与请求失败能否区分 |
| 请求通路 | 带 body 的 GET 是否被中间组件丢弃 |
| 恢复演练 | 重启或分片变化后规则是否仍可用 |
这张表既适用于继续维护旧系统,也适用于搬迁前的盘点。逐项确认比只看“能不能跑通”更可靠。
这套写法适合什么,不适合什么
适合的场景是典型的订阅与告警匹配:规则数量由业务维护,文档逐个到来,需要知道命中哪些规则。注册查询是文档这一设计,也让规则可以带业务字段并按条件筛选。
不太适合的场景包括需要批量匹配的场合。文档说明它一次处理一个文档,因此大批量匹配要在应用侧组织并发,并按返回结果汇总,不能指望一次请求处理多篇文档。
涉及嵌套与父子结构的规则也不适合。注册查询里使用 has_child、has_parent、top_children、nested 都不受支持,见第 132–135 行。遇到这类结构,需要重新设计匹配方式。
规模与延迟本文不作断言。文档说明了分片处理与本地优先等机制,但没有给出查询条数与延迟的关系曲线。需要容量数据时,应在目标环境用真实规则集合实测,而不是按节点数或副本数推算。
搬迁时要保留哪些信息
从这一代实现搬走时,最重要的是保留查询的归属。_percolator 里的 type 表示业务索引名,不同业务索引可以有相同的查询 _id。只导出 _id 与查询体,会丢失归属关系,搬迁后可能无法区分同名规则。
建议的搬迁顺序是:先冻结规则写入或准备可重放的变更记录;再导出完整的原始身份与查询内容;然后在新实现中按映射关系重建,并保留映射表以便核对;最后用正例、负例、临界值分别验证行为。
验证不应只看数量一致。条数相同而内容不同是最容易漏过的情况,应逐条比对查询内容,并抽样验证匹配结果是否一致。
清理旧索引应是独立动作,放在迁移完成、业务观察通过之后,而不是迁移脚本的一部分。保留源数据,回退才有依据。
在 7.17.29 上跑一遍
0.90 的 .percolator 专用索引,和现在的做法放一起看。
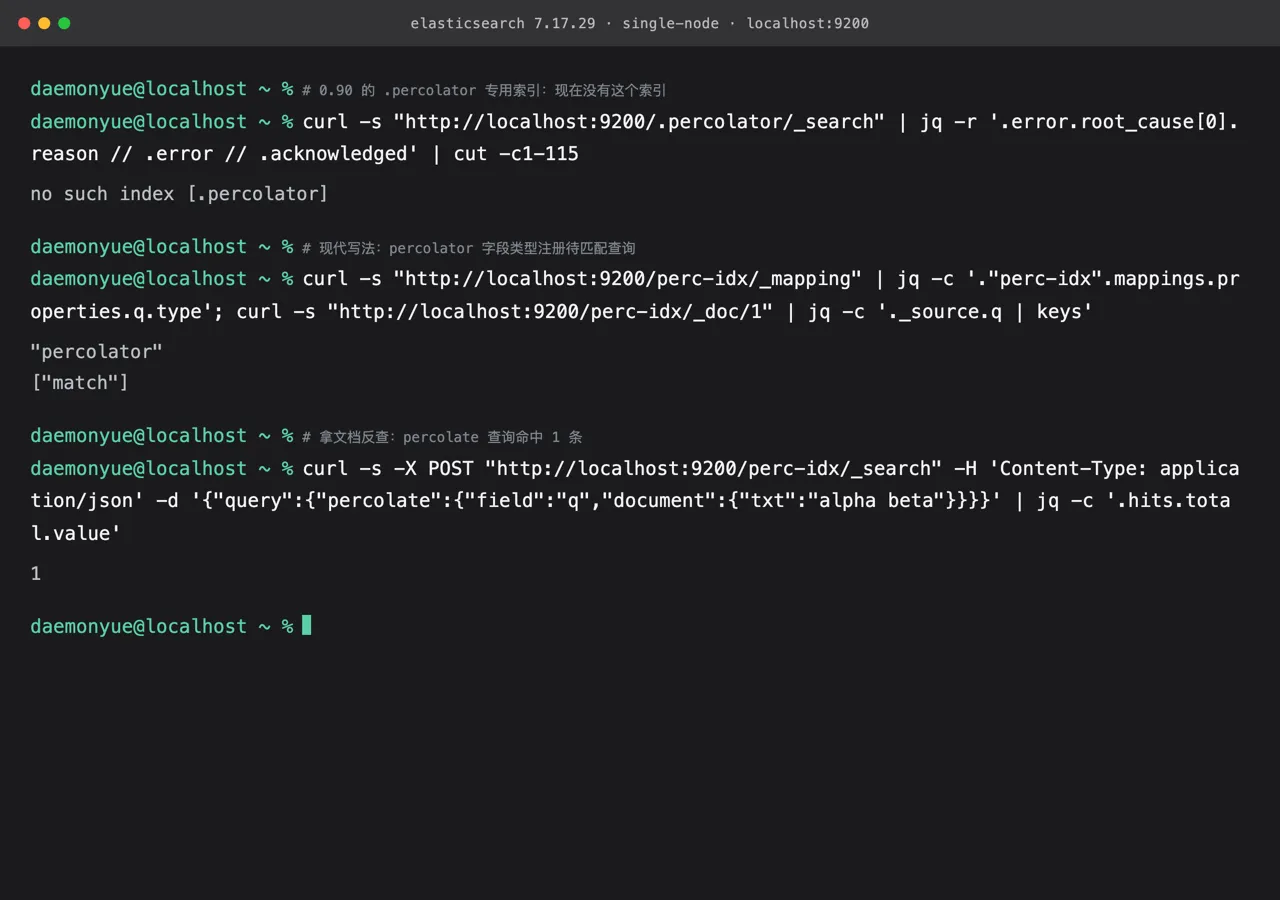
图 1:7.17.29 单节点实例的实测输出。GET /.percolator/_search 报 no such index [.percolator];现代写法用 percolator 字段类型把 match 查询注册进普通索引,percolate 查询拿文档反查命中 1 条。
curl -s 'http://localhost:9200/.percolator/_search' | jq -r '.error.root_cause[0].reason'
# no such index [.percolator]
curl -s 'http://localhost:9200/perc-idx/_mapping' | jq -c '."perc-idx".mappings.properties.q.type'
# "percolator"
curl -s -X POST 'http://localhost:9200/perc-idx/_search' -H 'Content-Type: application/json' -d '{"query":{"percolate":{"field":"q","document":{"txt":"alpha beta"}}}}' \
  | jq -c '.hits.total.value'
# 1
图 1 把「反查」这件事做成了可复现的对照:专用索引没了,查询改存进普通索引的 percolator 字段,用 percolate 查询拿文档去匹配。本机是 7.17.29,0.90 当年的注册与执行流程无实例可对照。
边界:
- 图 1 出自 7.17.29 单节点实例,没有 0.90 / 1.x / 2.x 二进制;
- 验的是旧写法在当前版本是否被接受,当年的执行过程与性能未测;
其余同类旧写法未逐个枚举。
只测了一个
match查询与一条文档,规模与性能未测。
写在最后
0.90 的 percolator 语义很清楚:注册查询、拿文档去问、返回命中的查询名。它的特殊之处在于承载方式——查询是 _percolator 索引里的文档,业务索引名由 type 表示,请求由分片轮转处理。
这套写法今天已经不再适用,但理解它有助于解释后续实现为什么改变。维护老系统时,重点是先确认查询归属、过滤条件与权限边界,再决定怎么搬,不是照抄这些 URL。
参考
- Percolate API @ v0.90.13
- Percolator 在 1.0 的重新设计
本文逐节核对了固定标签文档,引文取自该文档。「在 7.17.29 上跑一遍」里已实际查到
.percolator索引不存在,并用percolator字段类型注册match查询、percolate查询反查命中 1 条。本机无 0.90 二进制,当年的注册流程与规模性能未实测。