0.90.3 加入的 completion suggester 把提示数据结构写进索引文件,查询时直接读取;0.90.4 又支持了模糊查询。本文按固定标签核对 mapping 参数、写入字段、查询与响应、删除延迟,并说明升级前要核对什么。
说明
实测环境:本地另起一个 Elasticsearch 7.17.29 单节点实例(官方 tar 包,端口 9200,独立 path.data);本机没有 0.90 / 1.x / 2.x 二进制,所以这里验的是这些旧写法在较新版本上的当前行为,不是当年的执行过程。文末「在 7.17.29 上跑一遍」里的命令与响应均取自该实例。
本文只讨论 0.90 的历史实现,不表示当前云服务支持这些旧接口。示例用于准备隔离的旧版本验证环境,不得在生产集群执行,也不要对外开放旧版本服务。文末实测小节里的命令与响应取自本机 7.17.29 实例;0.90 当年的执行过程无实例可对照。
它解决的是前缀补全,不是拼写纠正的全部
文档开篇标注 added[0.90.3],并说明它是 prefix suggester:不像 term 或 phrase suggester 那样做拼写纠正,而是提供基础的自动补全,见补全提示文档。
但“不做纠错”不能扩展到整个 0.90 系列。同一份文档里有独立的 Fuzzy queries 一节,标注 added[0.90.4],说明它支持模糊查询,即输入有拼写错误仍能返回结果,见第 190–196 行。
两者并不矛盾。它的定位是前缀补全:先按前缀命中,再在这个范围内允许有限的编辑距离。term/phrase suggester 的做法是先在索引里找相似的词项再给建议,适用场景不同,不能只按“能不能纠错”区分。
因此维护老代码时,看到 completion 就认定“不能容错”,可能会错过已经可用的 fuzzy 选项;反过来,把它当成通用的拼写纠正器,也会误判需要多少编辑距离。判断依据应是具体版本的参数与预期行为。
为什么要在索引期建结构
文档用一节回答“既然有 prefix query,为什么还要它”,答案是速度,见第 18–32 行:
The data structures are internally backed by Lucenes
AnalyzingSuggester, which uses FSTs to execute suggestions. Usually these data structures are costly to create, stored in-memory and need to be rebuilt every now and then to reflect changes in your indexed documents. Thecompletionsuggester circumvents this by storing the FST as part of your index during index time.
要点是:这类结构通常构建成本高、放在内存、需要定期重建;completion suggester 把 FST 作为索引的一部分在索引期写入,从而让加载和执行更快。
这不等于“查询时零内存成本”或“永不重建”。数据在索引期写入,查询时仍要读取并用于匹配;段发生变化、合并发生,读取的内容也会随之变化。把它理解成预计算结构更准确,不宜理解成完全不需要运行时资源。
代价也来自这个设计:字段必须专门声明类型,删除不会立刻反映到提示数据,升级时可能需要重建。文档开头的 experimental 提示就是针对这一点:
IMPORTANT: This feature is marked as experimental. This means, that the API is not considered stable, and that you might need to reindex your data after an upgrade in order to get suggestions up and running again.
正确的处理方式是:升级前核对兼容性,并准备好可重建的数据来源,不要把“可能需要重建”直接写成“升级必然失效并必须重建”。是否需要重建取决于实际版本间的结构变化。
mapping 参数
字段类型必须是 completion。文档给出的示例与分析器说明见第 33–90 行。
| 参数 | 默认值 | 作用 |
|---|---|---|
index_analyzer |
simple |
写入时使用的分析器 |
search_analyzer |
simple |
查询时使用的分析器 |
payloads |
false |
是否保存附加数据 |
preserve_separators |
true |
是否保留分隔符;关闭后 foof 可匹配 Foo Fighters |
preserve_position_increments |
true |
是否保留位置增量;关闭后配合停用词分析器,b 可匹配 The Beatles |
max_input_len |
50 |
单条输入的长度上限,按 UTF-16 code points 计 |
max_input_len 的文档原文写的是 50 UTF-16 code points,且说明它只在索引期生效,用于避免超长输入撑大底层结构,见第 84–90 行。
默认分析器选 simple 而不是 standard,文档给的理由是行为更好理解:若用 standard,索引 At the Drive-in 时输入 a 或首个非停用词 d 都得不到提示,见同节说明。补全场景下这确实反直觉。
preserve_position_increments 那节还给了替代做法:也可以直接写入两条 input(Beatles 与 The Beatles),不必改分析器参数,见第 76–82 行。改分析器影响整个字段,加一条 input 只影响这条数据,两者取舍应按数据可控程度决定。
写入字段与响应
写入时可以给出四个字段,input 必填,其余可选:
{

    "name" : "Nevermind",
    "suggest" : {

        "input": [ "Nevermind", "Nirvana" ],
        "output": "Nirvana - Nevermind",
        "payload" : {
    "artistId" : 2321 },
        "weight" : 34
    }
}
input:用于匹配的字符串或字符串数组。output:匹配后返回的内容。文档说明它适合做输出归一化,并且多条文档的output相同时会去重,只返回一条,见第 114–119 行。payload:任意 JSON 对象,原样返回。文档建议的用途是存文档标识,这样拿到提示后可直接取数据,不必再发一次搜索。weight:正整数,用于排序。
去重这一点直接影响容量规划:多条文档共享同一个 output 时,返回的提示数量会少于文档数量。验收时应同时记录写入条数与返回条数,不能假定两者相等。
文档给出的查询响应也说明了 score 与 text 的来源:配置了 weight 时它作为 score;text 使用 output,未配置时用匹配到的 input 部分,见第 183–187 行。
payload 只适合放定位信息,不应存放敏感内容。它随提示原样返回,可能出现在前端日志与埋点里;拿到标识后仍要按业务权限校验目标对象是否可读,不能因为提示存在就允许访问。
文档还提到一种简写 { "suggest" : "Nirvana" },代价是不能使用多 input、output、payload 与 weight,见第 131–134 行。是否使用它取决于是否需要排序与归一化输出。
查询与模糊选项
查询需要指定 suggest 类型,本文示例使用 _suggest 端点:
{

    "song-suggest" : {

        "text" : "n",
        "completion" : {

            "field" : "suggest"
        }
    }
}
这里的说明只针对本例使用的 _suggest 入口。是否存在其他可发起建议请求的入口,本文没有逐一核对,不据此断言。
模糊查询在 completion 里加 fuzzy 对象,例如 "fuzzy" : { "edit_distance" : 2 }。支持的参数与默认值见第 213–239 行:
| 参数 | 默认 | 作用 |
|---|---|---|
edit_distance |
1 |
最大编辑距离 |
transpositions |
true |
交换算一次还是两次改动 |
min_length |
3 |
输入达到该长度才返回模糊建议 |
prefix_length |
1 |
开头多少长度不参与模糊比较 |
unicode_aware |
- | 按 unicode code points 而非字节度量 |
文档还说明,若接受默认值但仍要启用模糊,可以写 fuzzy: {} 或 fuzzy: true。
模糊查询会扩大匹配范围,也可能带来不相关的提示。上线前应在真实输入样本上比较开启前后的提示集合,而不是只看有没有结果。
删除延迟与更新检查表
文档明确说明:提示数据结构可能不会立刻反映删除,需要执行一次 optimize,见第 143–145 行。
原文只给出“可能需要 optimize”的表述,没有展开完整请求形式。因此本文不提供未核实的请求模板;实际验证时应按对应版本的 optimize API 文档补齐方法、路径与参数,并确认 only_expunge_deletes 的写法。
由此带来的实际影响是:已删除的内容可能在一段时间内仍被提示出来。涉及下架商品、已注销用户等场景时,不能把“文档已删除”当成“提示已消失”,应在业务层再做一次有效性校验。
更新与删除的验收可以按下表逐项执行,每次只改一个变量:
| 步骤 | 动作 | 观察项 |
|---|---|---|
| 初次写入 | 写入带 input/output/payload/weight 的文档并 refresh | 能否按前缀查到,score 是否等于 weight |
| 同 ID 更新 | 改 input、output、payload、weight 后重新写入并 refresh | 旧提示是否消失,是否有重复 |
| 删除 | 删除文档并 refresh | 提示是否仍返回 |
| 段合并 | 满足条件后观察 | 旧提示是否被清除 |
| 升级验证 | 升级后先跑一次查询 | 提示为空或报错时如何重建 |
refresh、段合并与同 ID 更新不是同一件事。refresh 让新文档可见,段合并改变底层文件,同 ID 更新则替换文档内容。把三者混为一谈,容易把“还没 refresh”误判成“提示结构不生效”。
容量与取舍
max_input_len 限制单条输入长度,避免超长输入撑大结构;多 input、payload 大小与输入条数都会影响索引体积与构建成本。文档说明这个限制只在索引期生效,见第 84–90 行。
本文不给未实测的性能数字或条数上限。评估方式应是:用真实提示条目构建测试索引,记录索引体积、构建耗时与查询耗时,再按业务提示条数估算。
选择它还是 term/phrase suggester,取决于需求:需要用户输入前缀即时出提示,用 completion 更直接;需要基于索引内容的拼写建议,则应使用另外两个 suggester。两者职责不同,0.90 把它们做成不同的 suggest 类型。
从写入到查询,数据经过哪些阶段
理解路径有助于判断问题出在哪一步。按文档描述整理,流程可以简化为:
flowchart TD
    A[写入 input/output/payload/weight] --> B[按 index_analyzer 处理]
    B --> C[索引期构建 FST 并写入段]
    C --> D[查询时按 search_analyzer 处理输入]
    D --> E[在 FST 上按前缀匹配,必要时应用 fuzzy]
    E --> F[按 weight 排序并输出 text 与 payload]
这张图是按文档说明简化的,不表示内部实现的完整调用过程。它的作用是区分责任边界:写入侧决定索引里有什么,查询侧决定输入如何被解释。
由此也能看出几类问题的归属。提示查不到,可能是 input 没写入、分析器处理掉了关键词、或者查询输入的前缀与索引内容不一致;提示顺序不对,通常与 weight 有关;提示内容不对,则要看 output 与去重行为。
段合并也要纳入考虑。它改变底层文件,可能影响删除何时生效,也可能改变读取的内容。观察“删除后仍出现提示”时,应先确认是否发生过合并,再判断是不是结构未更新。
分析边界要用对照样本
分析相关参数不能只靠推理,应准备固定的对照样本。每次只改一个参数,比较提示结果:
| 输入 | 关注的问题 |
|---|---|
Foo Fighters |
preserve_separators 关闭后 foof 能否匹配 |
The Beatles |
preserve_position_increments 关闭后 b 能否匹配 |
At the Drive-in |
默认 simple 与 standard 的差异 |
| 一条文档带多个 input | 多个输入是否都能命中 |
接近 max_input_len 的输入 |
超长部分是否被截断 |
同时写入两条 input(Beatles 与 The Beatles)是文档给出的替代方案,适合数据可加工的情况。改分析器会影响整个字段,加 input 只影响这条数据,选择依据是可控范围而非实现复杂度。
多语言内容也要单独准备样本。默认 simple 按非字母字符切分,对中文等不使用空格分隔的文本,匹配行为与英文不同。是否需要更换分析器,应由样本结果决定,而不是按语言名称推断。
完整的验证脚本怎么组织
下面把前面的要点串成一份可执行的顺序,供隔离的旧版本环境使用。旧版本没有现代 Dev Tools 配套,需要通过受控的 HTTP 客户端发送对应方法、路径与 JSON。
第一步建索引并声明 completion 字段。这里保留默认分析器,便于先观察默认行为:
PUT /suggest_lab_090
{
  "settings": {
    "number_of_shards": 1,
    "number_of_replicas": 0
  },
  "mappings": {
    "song": {
      "properties": {
        "name": { "type": "string", "index": "not_analyzed" },
        "suggest": { "type": "completion", "payloads": true }
      }
    }
  }
}
第二步写入两条文档,其中一条使用多 input 与 output,另一条使用相同的 output,用来观察去重:
PUT /suggest_lab_090/song/1
{"name":"Nevermind","suggest":{"input":["Nevermind","Nirvana"],"output":"Nirvana - Nevermind","payload":{"artistId":2321},"weight":34}}

PUT /suggest_lab_090/song/2
{"name":"Other","suggest":{"input":["Nirvana"],"output":"Nirvana - Nevermind","weight":10}}

POST /suggest_lab_090/_refresh
第三步用 _suggest 查询前缀 n,记录返回的 options 数量、每条的 text、score 与 payload。若两条文档都写入成功,返回条数少于写入条数就体现了文档描述的去重行为。
第四步只改一个变量,分别测试:把 weight 改为不同值看排序是否变化;把 payloads 关掉后重建索引看响应是否还有 payload;加入 fuzzy 后比较提示集合。每次只改一项,才能把差异归因到具体参数。
第五步做删除验证:删除其中一条文档并 refresh,再查询,记录旧提示是否仍返回。这一步的观察结果不能直接推广到所有版本,需按实际环境确认。
升级与回退要准备什么
experimental 提示的实际含义是接口可能变化,因此升级前要确认两件事:目标版本的 mapping 参数是否一致,以及旧索引能否继续提供提示。两者都可能变化,不能只查其中一个。
准备工作的重点是保留可重建的数据来源。提示数据由业务数据生成,只要来源仍在,就可以在新索引上重建;若只保留索引而没有来源,一旦结构不兼容就没有补救手段。
回退同样依赖这一点。回到旧版本并不自动恢复提示数据,需要按来源重新生成。验证回退是否有效,应跑一次真实前缀查询并比较提示集合,而不是只看索引是否可打开。
这一步也说明了为什么不建议把提示索引当成唯一数据源。它应从业务数据派生,并保留重新生成的流程。这样无论是升级、回退还是参数调整,都有可执行的恢复路径。
在 7.17.29 上跑一遍
旧的 _suggest 端点和现在的 suggest 子句,各发一次。
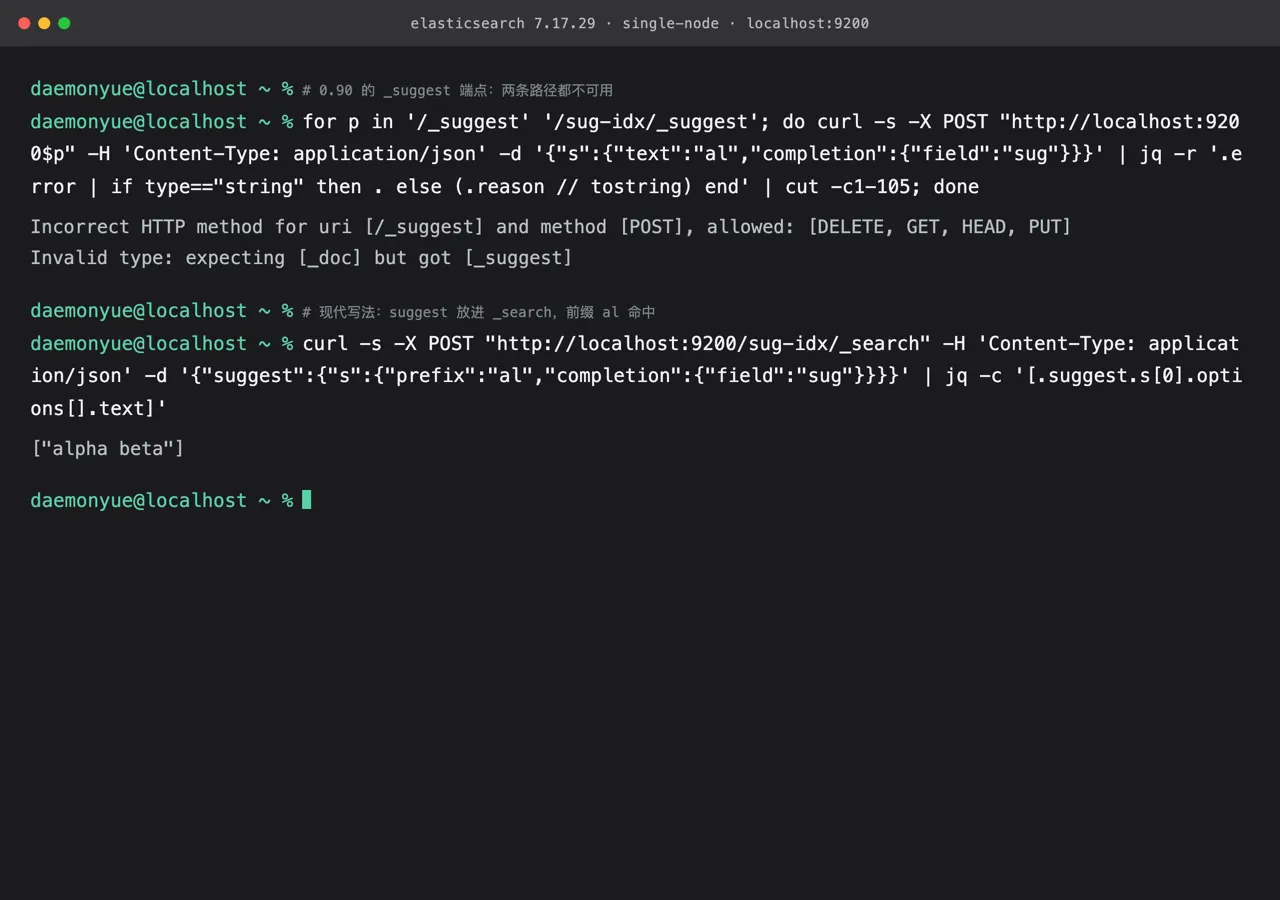
图 1:7.17.29 单节点实例的实测输出。POST /_suggest 报方法不允许,POST /sug-idx/_suggest 报 Invalid type: expecting [_doc] but got [_suggest];把 suggest 放进 _search 后前缀 al 命中 alpha beta。
for p in '/_suggest' '/sug-idx/_suggest'; do \
  curl -s -X POST "http://localhost:9200$p" -H 'Content-Type: application/json' \
    -d '{"s":{"text":"al","completion":{"field":"sug"}}}' \
    | jq -r '.error | if type=="string" then . else (.reason // tostring) end' | cut -c1-105; done
# Incorrect HTTP method for uri [/_suggest] and method [POST], allowed: [DELETE, GET, HEAD, PUT]
# Invalid type: expecting [_doc] but got [_suggest]
curl -s -X POST 'http://localhost:9200/sug-idx/_search' -H 'Content-Type: application/json' -d '{"suggest":{"s":{"prefix":"al","completion":{"field":"sug"}}}}' \
  | jq -c '[.suggest.s[0].options[].text]'
# ["alpha beta"]
图 1 说明前缀提示能力还在,入口已经合并进 _search。本机是 7.17.29,0.90 当年 optimize 与模糊选项的具体效果无实例可对照。
边界:
- 图 1 出自 7.17.29 单节点实例,没有 0.90 / 1.x / 2.x 二进制;
- 验的是旧写法在当前版本是否被接受,当年的执行过程与性能未测;
其余同类旧写法未逐个枚举。
只测了一个前缀与一条候选;
optimize与模糊查询效果未测。
写在最后
completion suggester 的取舍是用“索引期构建 FST”换查询速度,代价是专门的 mapping、删除有延迟、升级要核对兼容性。0.90.4 起它还支持模糊查询,所以不能简单说它完全不做容错。
维护老代码时,先确认实际版本的参数集合与执行形态,再按写入、更新、删除、段合并、升级这条顺序验证。这样得到的结论比照抄一段旧文档可靠。
参考
本文逐节核对了固定标签文档的 mapping 参数、写入字段、查询响应、模糊选项与删除说明。「在 7.17.29 上跑一遍」里已实际验证旧
_suggest端点两条路径分别报方法不允许与Invalid type: expecting [_doc] but got [_suggest],把suggest放进_search后前缀al命中alpha beta。本机无 0.90 二进制,optimize的具体请求形式与模糊查询效果均未核实。