1.0 的迁移说明记录了一批移除:
text查询、field查询、_boost文档级加权、custom_score系列。本文按固定标签核对这些条目,说明替换写法、不等价的地方,以及一组可复现的验收数据。
说明
实测环境:本地另起一个 Elasticsearch 7.17.29 单节点实例(官方 tar 包,端口 9200,独立 path.data);本机没有 1.x / 2.x 二进制,所以这里验的是这些旧写法在较新版本上的当前行为,不是当年的执行过程。文末「在 7.17.29 上跑一遍」里的命令与响应均取自该实例。
本文讨论 1.0 的历史实现,不表示当前云服务支持这些旧接口。示例用于准备隔离的旧版本验证环境,不得在生产集群执行。文末实测小节里的命令与响应取自本机 7.17.29 实例;1.0 当年的执行过程无实例可对照。
迁移说明写了哪些移除
v1.0.0 的迁移说明在 Deprecations 一节列出以下条目:
- The
textquery has been removed. Use thematchquery instead.- The
fieldquery has been removed. Use thequery_stringquery instead.- Per-document boosting with the
_boostfield has been removed. You can use thefunction_scoreinstead.- The
pathparameter in mappings has been deprecated. Use thecopy_toparameter instead.- The
custom_scoreandcustom_boost_scoreis no longer supported. You can usefunction_scoreinstead.
原稿引用的是这些原文。它们说明的是 1.0 迁移时要求的改写方向,不自动等于“该版本解析器一定拒绝旧写法的全部形式”。实际行为应按运行版本核实。
还有一个容易混淆的点:后续版本的发布说明里仍能看到与 _boost、custom_score 相关的移除条目。这说明清理可能分阶段进行,也可能只是移除兼容层。不能因为后一份说明出现相同名字,就断定前一版没有移除。排查时应以实际运行的版本与解析器为准。
因此本文的标题强调“验收”,而不是给一个统一的移除版本号。维护老系统时,先确认目标版本对每个旧名字的处理方式,再决定改哪些。
text 与 field 是查询名被移除,不是能力新增
把 text 查询改写成 match,容易被理解成“1.0 才有 match”。这不准确。0.90 的文档里已经有 match 查询,并且包含 operator、minimum_should_match、analyzer、zero_terms_query,以及 match_phrase、match_phrase_prefix 等形态。
所以这次变化的核心是查询名的收敛:text 这个名字不再使用,统一到 match。排查老代码时应关注查询名是否仍被接受,而不是假设能力是新的。
同理,field 查询改为 query_string,也不代表之前没有字段限定的查询方式。改写时要比较的是语法与默认行为,不是“能不能查询某个字段”。
query_string 会解析查询语法,这一点需要单独评估。若原查询里的用户输入包含特殊字符,改写后可能出现解析错误或匹配范围变化。验收时应包含带特殊字符的输入。
_boost 换成了什么
_boost 是文档级加权:mapping 里声明某个字段的值控制该文档的 boost 级别。1.0 的boost 字段文档标注 deprecated[1.0.0.RC1],并给出替代做法。
替代示例是用 function_score 包住原查询,再用 script_score 返回该字段的值:
{

    "function_score": {

        "query": {
    "match": {
    "title": "quick brown fox" } },
        "functions": [{

            "script_score": {
    "script": "doc['my_boost_field'].value" }
        }]
    }
}
文档对这个示例的说明是:脚本返回 my_boost_field 的值,再与查询的 _score 相乘,见第 66–70 行。
这里有三点要留意。
第一,脚本返回的是字段值,最终仍会与查询得分相乘。若原脚本或原语义不希望这样,需要按版本确认对应的合并方式,例如设置 boost_mode,参见 function_score 文档。
第二,字段必须可取。若文档缺少该字段,脚本取值的行为需要按版本实测,不能假定为 1。
第三,索引时加权与查询时相乘不等价。旧 _boost 影响的是索引期的 boost;改成查询时脚本后,doc 的 norms、字段配置都可能不同。是否等价要实测,不能只比较公式。
另外,修改查询侧公式不等于修改已写入的数据。若旧索引里已经保存了加权效果,重建索引前后的排序可能不同,这一点应在迁移方案中说明。
path 与 copy_to 不是等价替换
迁移说明写的是 path 参数废弃,改用 copy_to。但两者语义不同:path 描述对象字段的路径策略,copy_to 是把字段值复制到另一个字段。
因此不能把 "path": "full" 直接改写成 "copy_to": "full" 就认为等价。前者影响对象字段如何被引用,后者会生成一个目标字段。目标字段是否有自己的 mapping、用什么分析器,都要重新确认。
改写后应验证:目标字段是否真的包含复制过来的值、分析行为是否符合预期、以及旧查询里对该路径的引用是否还能命中。
custom_score 系列的名字
迁移说明写的是 custom_score 与 custom_boost_score 不再支持。这里有一个名字需要注意:0.90 的查询文档里有 custom_boost_factor,而 1.0 迁移说明写的是 custom_boost_score。
本文不假定两者是同一个查询,也不把迁移说明里的名字改掉。核对时应分别查看对应版本的解析器和文档,确认实际存在过哪些名字。
替代方向是一致的:用 function_score。具体写法参见0.90 打分查询那篇对迁移对照与脚本相乘问题的说明。
准备一组能暴露打分差异的数据
下面使用 1.0 时代的 REST 记法,供隔离的 v1.0.0 环境验证。旧版本没有现代 Dev Tools 配套,需要通过受控 HTTP 客户端发送;不要提交给当前生产版本。
索引显式声明字段类型,避免动态 mapping 的类型差异影响对照。1.0 的字符串字段使用 string 类型:
PUT /boost_lab_100
{
  "settings": {
    "number_of_shards": 1,
    "number_of_replicas": 0
  },
  "mappings": {
    "item": {
      "properties": {
        "title": { "type": "string", "index": "analyzed" },
        "status": { "type": "string", "index": "not_analyzed" },
        "my_boost_field": { "type": "double" }
      }
    }
  }
}

PUT /boost_lab_100/item/a
{"title":"quick brown fox","status":"published","my_boost_field":3.0}

PUT /boost_lab_100/item/b
{"title":"quick brown fox","status":"published","my_boost_field":1.0}

PUT /boost_lab_100/item/c
{"title":"quick brown fox","status":"draft","my_boost_field":3.0}

POST /boost_lab_100/_refresh
写入后逐项确认成功。数据有意让 a、b 标题相同但权重不同,c 状态不同,这样可以分别观察加权与筛选的作用。
按文档给出的替代写法验证加权:
GET /boost_lab_100/item/_search
{
  "size": 20,
  "query": {
    "function_score": {
      "query": { "match": { "title": "quick brown fox" } },
      "functions": [
        { "script_score": { "script": "doc['my_boost_field'].value" } }
      ]
    }
  }
}
预期检查是三条文档都命中,且 a 的得分高于 b。本文没有运行这个查询,不给出假定的分数值。
再做一次只改合并方式的对照:显式设置 boost_mode 后重新查询,比较得分与排序是否不同。这能把“加权是否按预期生效”从假设变成可观察的事实。
还要准备一条缺少 my_boost_field 的文档,观察脚本取不到值时的行为。这是迁移后最容易出问题的地方:老代码里可能允许该字段缺失,新写法下未必得到相同的分数。
同一份迁移说明里的响应格式变化
升级 1.0 不只影响查询。同一份迁移说明在 Return values 一节列出多项响应变化,见第 303–324 行。
首先是 ok 返回值:文档写明它已从所有响应体中移除,理由是它不提供有用信息。老代码里判断 ok 的地方都要改,参见0.90 percolator 那篇对这类写法的说明。
其次是 found、not_found、exists 被统一为 found。依赖具体返回值的分支逻辑要重新检查。
fields 参数的变化也需要留意:返回的字段值一律是数组,只有 routing 这类元数据仍为标量。文档还说明 fields 用于取已存储的字段,不再支持返回整个对象,也不再接受 _source.fieldname 这种形式,这类需求应改用 _source 过滤参数。
索引设置接口的返回结构也变了:设置以嵌套 JSON 对象返回,需要扁平格式时可以加 ?flat_settings。解析响应时按扁平结构取值的代码需要调整。
最后是 analyze API 不再支持 text 响应格式,只支持 JSON 与 YAML。调试脚本若按文本解析输出,要改成解析 JSON。
这些变化与查询改写属于同一次升级,但容易被分别处理。建议把响应格式的检查放进同一份升级清单,避免只改查询而漏掉解析逻辑。
排查顺序与回退
升级后如果结果异常,建议按顺序排查:先确认旧查询名是否仍被接受;再确认替换后的查询语义是否一致;然后检查加权方式;最后检查 mapping 层面的改动。
每一步只改一类问题。同时修改查询名、加权与 mapping,出现异常时无法归因。
回退方案要分别考虑查询与数据。改回旧查询名只影响查询侧;若已经重建索引或改过 mapping,数据侧的恢复要单独安排。不能假定切回旧版本就能得到与升级前完全一致的结果。
保留旧查询模板与其适用版本,是回退的前提。只保留改写后的查询,回退时就只能凭记忆重建,风险不可控。
验收矩阵
| 测试组 | 必测边界 |
|---|---|
text / match |
布尔、短语、短语前缀;显式分析器;全停用词;空输入 |
field / query_string |
简写与对象写法;非法语法;特殊字符转义;显式字段前缀 |
| 脚本加权 | 原分数不为 1;脚本是否引用 _score;默认合并与 replace;缺失值;多值 |
| 多函数 | 多个过滤器同时命中;全部不命中;顺序变化;封顶位置 |
_boost 迁移 |
原权重能否恢复;字段 norms 配置;旧索引与重建索引的差异 |
path / copy_to |
同名字段;目标字段分析器;旧数据是否重新索引 |
矩阵里的每一项都应保留可解释的差异记录。若只比较“有没有报错”,很多语义差异会被漏掉。
业务数据也要参与验收。用真实文档的一个子集,分别在新旧写法下查询,比较命中集合与排序。完全一致的得分不现实,若前几条大面积变化,应回到公式检查,而不是当作正常漂移。
什么时候不该按默认替换
若旧查询依赖的是索引期 boost,且重建索引不可行,那么改成查询时脚本未必能复现原排序。这种情况下应先评估排序变化对业务的影响,再决定是否迁移。
若用户输入直接进入 query_string,语法解析会带来额外风险。更稳妥的做法是限定可查询字段,或对输入做转义,而不是把所有字段查询都改写成 query_string。
若 custom_score 场景里的脚本本身就依赖旧的行为(例如脚本结果直接作为最终分),迁移时必须明确合并方式。默认行为可能与旧行为不同,只比较“能否执行”是不够的。
两组查询名的对照写法
用前面的测试索引再验证两组替换。第一组是 text 到 match:
GET /boost_lab_100/item/_search
{
  "size": 20,
  "query": {
    "match": {
      "title": {
        "query": "quick brown fox",
        "operator": "and"
      }
    }
  }
}
与旧的 text 查询比较时,要确认默认算子是否一致。旧写法默认的匹配要求需要按原版本文档核对,不能假定与 match 的默认行为相同。显式写出 operator 能减少这类差异。
第二组是 field 到 query_string:
GET /boost_lab_100/item/_search
{
  "size": 20,
  "query": {
    "query_string": {
      "default_field": "title",
      "query": "quick AND fox"
    }
  }
}
这里显式指定 default_field,避免依赖默认字段配置。若原 field 查询的内容来自用户输入,还要测试特殊字符与非法语法,确认错误是否可接受。
两组替换都应准备同一批数据,分别执行并比较命中集合。集合相同不代表排序相同,排序相同也不代表得分相同,三者要分别记录。
为什么不能假设等价
替换文档给的是方向,不是等价证明。旧查询的默认值、分析行为、加权时机、以及响应格式都可能不同。把这些差异当成“正常漂移”,往往会在业务指标异常时才被发现。
正确的态度是把每次替换都当成一次需要验收的变更:固定输入、固定数据、逐项比较。差异出现时先定位到具体类别,再决定是调整写法还是接受变化。
这也解释了为什么本文不给出“改完就一定一样”的结论。没有实测,等价性就无法确认;而实测需要提供环境、数据与运行记录,本文两者都没有。
同一次升级里的 mapping 变化
查询之外,迁移说明还记录了 mapping 层面的改动。其中一项是 multi_field 类型被移除,改为让核心字段类型(除 object 与 nested 外)直接接受 fields 参数,见第 223–227 行。
这项改动与前文的 path 废弃同属 mapping 调整。它们的共同点是:改写方式相对明确,但目标字段是否有自己的 mapping、用什么分析器,都需要重新确认。
升级时把 mapping 改动与查询改动分开验证更省事:先确保索引结构与字段行为正确,再比较查询得分。否则字段行为异常会被误判成查询改写错误。
旧代码里怎么认出这一代写法
| 特征 | 说明 |
|---|---|
查询名是 text 或 field |
1.0 前需要改写为 match 或 query_string |
mapping 里有 _boost |
文档级加权,需改为查询时加权 |
mapping 里用 path |
已废弃,改用 copy_to,语义不同 |
查询名是 custom_score、custom_boost_score |
迁移说明写明不再支持 |
响应里判断 ok |
1.0 起该返回值已移除 |
mapping 用 multi_field |
已移除,改用 fields |
认出之后按类别处理,不要一次性全局替换。每类改动都应有对应的验收数据,避免改完之后无法判断是哪一处引入了差异。
升级检查清单
- 列出代码中所有旧查询名、
_boost、path、multi_field的使用位置。 - 确认目标版本对每个名字的处理方式:拒绝、废弃警告还是仍可使用。
- 改写查询名,保持数据与查询不变,比对命中集合与排序。
- 处理加权方式,明确合并模式,并比较新旧得分。
- 处理 mapping 改动,确认目标字段的 mapping 与分析行为。
- 检查响应解析逻辑:
ok、found、fields、设置结构、analyze输出。 - 保留旧查询模板与适用版本,作为回退依据。
清单的顺序遵循“先确认、再改写、后验收”。跳过第 2 步直接改写,最容易在后续排查中失去方向。
在 7.17.29 上跑一遍
1.0 移除的几条查询和 _boost,在较新版本里各发一次。
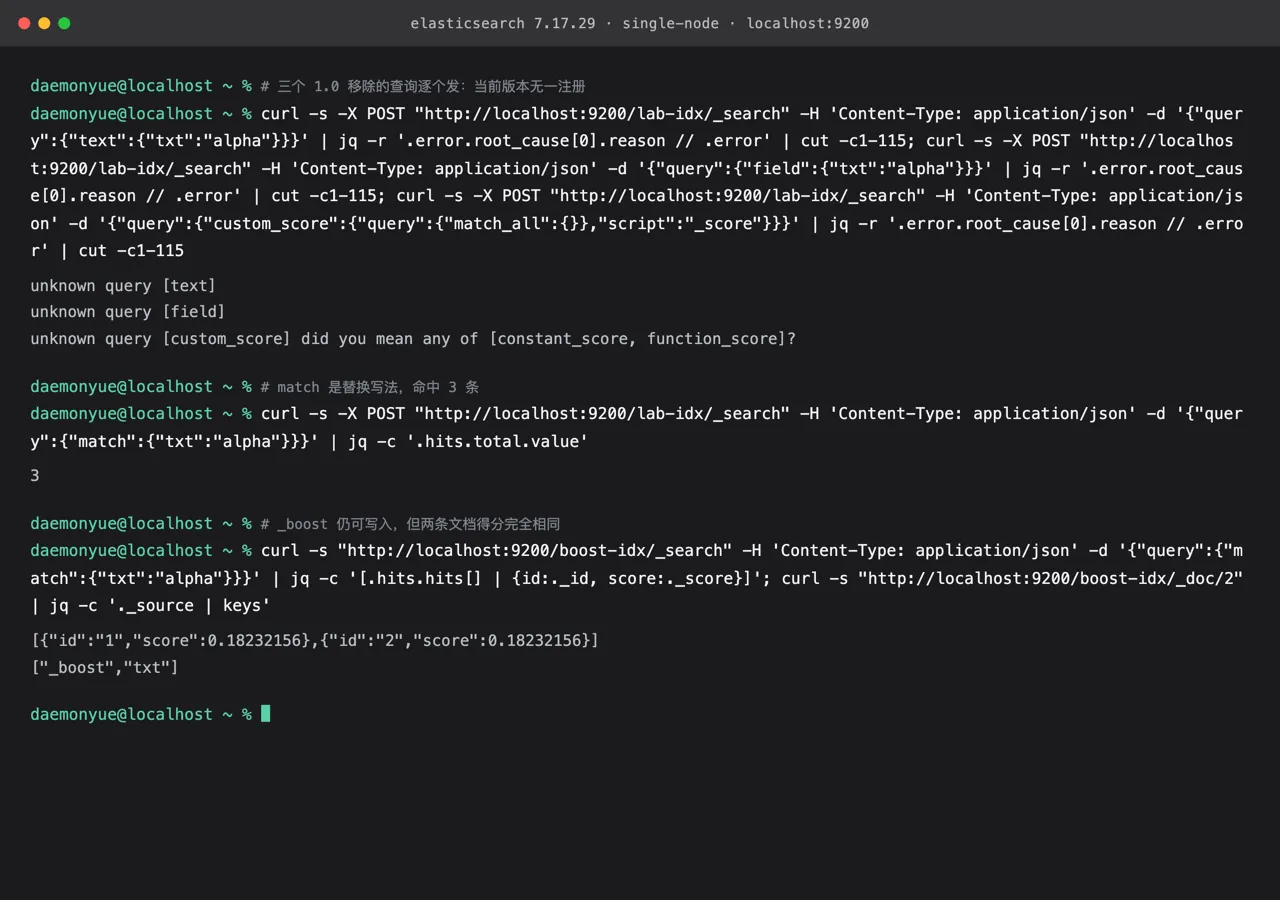
图 1:7.17.29 单节点实例的实测输出。text / field / custom_score 三个旧查询都报 unknown query,match 命中 3 条;带 _boost:8 的文档与不带的两条得分完全相同(0.18232156),_source 里只是多了一个普通字段。
curl -s -X POST 'http://localhost:9200/lab-idx/_search' -H 'Content-Type: application/json' -d '{"query":{"text":{"txt":"alpha"}}}' \
  | jq -r '.error.root_cause[0].reason'
# unknown query [text]
curl -s -X POST 'http://localhost:9200/lab-idx/_search' -H 'Content-Type: application/json' -d '{"query":{"field":{"txt":"alpha"}}}' \
  | jq -r '.error.root_cause[0].reason'
# unknown query [field]
curl -s -X POST 'http://localhost:9200/lab-idx/_search' -H 'Content-Type: application/json' -d '{"query":{"match":{"txt":"alpha"}}}' \
  | jq -c '.hits.total.value'
# 3
curl -s -X POST 'http://localhost:9200/boost-idx/_search' -H 'Content-Type: application/json' -d '{"query":{"match":{"txt":"alpha"}}}' \
  | jq -c '[.hits.hits[] | {id:._id, score:._score}]'
# [{"id":"1","score":0.18232156},{"id":"2","score":0.18232156}]
curl -s 'http://localhost:9200/boost-idx/_doc/2' | jq -c '._source | keys'
# ["_boost","txt"]
图 1 把「替换写法」和「不等价」两件事都验了:三个旧查询在当前版本连注册都没有,match 照常工作;_boost 仍能写进文档,但对得分毫无影响,只是 _source 里多一个普通字段。文档级加权确实没有了。
边界:
- 图 1 出自 7.17.29 单节点实例,没有 1.x / 2.x 二进制;
验的是旧写法在当前版本是否被接受,当年的执行过程与性能未测。
只测了一个
match查询与一组得分;path参数与copy_to替换未测。
写在最后
1.0 迁移说明给出的是替换方向,不是等价保证。text、field、_boost、path、custom_score 系列各有不同的改写代价,其中 _boost 到查询时加权的差异最大。
迁移顺序可以按先改查询名、再改加权方式、最后处理 mapping 的路径走,每一步用固定数据比对集合与排序。这样即使出现差异,也能定位到具体是哪一类改动造成的。
参考
- 1.0 迁移说明(移除条目)@ v1.0.0
_boost字段与 function_score 替代 @ v1.0.0- function_score 合并模式 @ v1.0.0
- 0.90 打分查询的合并
本文核对了固定标签的迁移说明、
_boost文档与 function_score 文档。「在 7.17.29 上跑一遍」里已实际发送text/field/custom_score三个旧查询:均报unknown query,match命中 3 条;写入_boost:8的文档与不带的两条得分完全相同,_source里只是普通字段。本机无 1.0 二进制,得分等价性的其它场景未逐个实测。