2.0 把查询与过滤器合并成一套查询子句,差别只剩上下文。本文按 2.0 迁移说明核对上下文定义、
filtered改法、and/or的处置、缓存变化和数字字段打分,并给出可自己跑的对照数据和查询。
说明
实测环境:本地另起一个 Elasticsearch 9.4.2 单节点实例(官方 tar 包,端口 9200,独立 path.data),安全特性与机器学习均关闭;另用三个 JDK 各编译运行同一份 Java TLS 探针(项目自带的 JDK 8u504、ES 8.19.8 内置 JDK 25.0.1、ES 9.4.2 内置 JDK 26.0.1),探针打印 SSLContext 的 supported / default 协议与套件列表。文末「在 9.4.2 上跑一遍」里的命令与响应均取自该实例与这三个 JDK。
合并前是两套类型
在那之前,查询与过滤器是两个体系:查询负责匹配并计算相关性,过滤器负责筛选且不打分。0.90 的文档里 term、range、bool 等都有 query 版与 filter 版两份页面,过滤器目录下还有 and、or、not、limit、missing、script、indices 等多个条目。
要把两者组合,需要 filtered 查询把查询与过滤器绑在一起,还要用专门的布尔过滤器做组合。那段历史见 filtered 查询与 and/or/not 过滤器。
这种结构带来的负担是:使用者必须先判断每个条件是“算分的”还是“筛选的”,再选对应的类型与组合语法。缓存行为也逐条写进文档,成为需要理解的一部分。
合并后的定义
2.0 迁移说明第 3–19 行写明:所有 filter clause 都变成 query clause,区别改为上下文。
Query context:计算相关性得分,且不可缓存;只要没有进入 filter context,就按 query context 处理,见第 9–12 行。
Filter context:不计算得分,可以被缓存。文档列出的入口包括:
constant_score查询bool查询里的must_not,以及 2.0 新加的filter参数function_score查询的filter与filters参数- 任何名为
filter的 API 入口,例如搜索的post_filter、聚合里的 filter、索引别名里的 filter
最后一条容易被忽略:filter context 不只存在于查询 DSL。聚合与别名里的 filter 同样按“不打分、可缓存”处理,见第 18–25 行。
filtered 改成 bool
最常见的动作是把 filtered 拆开:原来的 query 进 bool 的 must,原来的 filter 进 bool 的 filter。
{

  "query": {

    "bool": {

      "must": [
        {
    "match": {
    "text": "quick brown fox" } }
      ],
      "filter": [
        {
    "term": {
    "status": "published" } }
      ]
    }
  }
}
query filter 也被废弃。既然所有查询都能在两种上下文中使用,把查询包装成过滤器就没有意义,见第 42–45 行。
改写时要注意:must 里的条件参与打分,filter 里的不参与。原来用 and 过滤器表达的“只筛选不算分”,如果改成 bool.must,语义就变了。
and / or 变成语法糖
1.x 里 and、or 过滤器与 bool 过滤器的执行方式不同,因此当时有“某些子句用 and/or、某些用 bool”的经验。
2.0 取消了这个区别:bool 查询能够最优处理两种情况,or 与 and 变成语法糖,内部按 bool 查询执行,见第 31–40 行。
同一段文档还写明这些过滤器“may be removed in the future”。本文只记录这句话,不推断它们在哪个版本被移除;实际可用性应按对应版本核对。
迁移时不必刻意保留 and / or。直接写成 bool 更清楚,也能避免依赖一个文档已提示可能移除的写法。
接口变了,缓存没有消失
1.x 可以用 _cache 开关与自定义 _cache_key 控制哪个过滤器进缓存。2.0 里这两个参数被废弃,传入时忽略,改为在合适时自动缓存,见第 95–103 行。
判断依据是使用频率、查询执行成本、构建 filter 的成本三者的权衡,而不是人工标记。
变化的是控制方式与决策位置,不是“缓存被移除”;也不能把自动缓存理解成所有 filter context 子句一定被缓存。是否缓存仍由实现按上述因素决定。
terms filter 的 lookup 机制不再缓存那份包含词项的文档内容,改为依赖文件系统缓存。若 lookup 索引不大,文档建议设置 index.auto_expand_replicas: 0-all 复制到所有节点以省掉网络开销,见第 105–109 行。
迁移后如果发现某条查询变慢,不能直接归因到缓存策略。分片布局、数据分布、mapping、段状态与并发都可能变化,应先固定输入再逐项排除。
数字字段的打分也变了
这项改动不在“query/filter 合并”标题下,但同属 2.0 查询语义调整,混在一起最容易让人困惑。
此前对数字字段的 term 查询被刻意排除在常规 Lucene 打分逻辑之外,且这一行为没有写在文档里,见第 111–118 行。
2.0 起,数字字段的单个 term 查询与字符串字段一样按 IDF 与 norms(若启用)打分。不希望打分就把子句放进 filter context,例如 bool 的 filter 或用 constant_score 包一层,见第 120–122 行。
{

  "query": {

    "bool": {

      "must":   [ {
    "match": {
    "numeric_tag": 5 } } ],
      "filter": [ {
    "match": {
    "count": 5 } } ]
    }
  }
}
上例中 numeric_tag 参与打分,count 只做筛选。这正是合并之后表达“算不算分”的标准方式。
位置决定语义,不只是少写几个字
同一条子句放在不同位置,含义不同。must 与 should 参与打分,filter 与 must_not 不参与。因此改写老查询时,不能只把结构搬过来,而要逐个确认每个条件是否需要影响得分。
must_not 也需要注意:它处于 filter context,不打分,但语义是排除。把原来的 not 过滤器改到这里通常最接近原意;若改成 should 加取反,语义就变了。
constant_score 是另一种表达:它把内部查询整体放进 filter context,并给所有命中文档一个固定分数。适合“只要匹配、不关心相关性”的场景,例如精确筛选后按其他字段排序。
post_filter 则作用在查询之后,用于在不影响聚合结果的前提下过滤返回文档。它与 bool.filter 的执行阶段不同,混用时要注意聚合统计的是哪个集合。
关于 should 与 must、filter 共存时的匹配要求,不同版本与不同结构下的默认行为需要按实际文档确认,本文不作断言。写复杂布尔组合时,显式写出 minimum_should_match 比依赖默认行为更稳妥。
聚合与别名里的 filter
聚合里的 filter 聚合和索引别名里的 filter,迁移时要检查的位置比查询更多。别名上的过滤器决定了该别名可见的数据范围,聚合里的过滤器决定了统计口径,两者都不会出现在搜索请求的 query 部分。
排查“数据少了”这类问题时,应同时检查:查询里的 filter、别名上的 filter、以及角色或权限层面的限制。只看其中一处,容易把别名过滤误判成查询写错。
准备一组能验证上下文的数据
下面在支持 bool.filter 的版本上验证。示例使用现代 Dev Tools 记法,需在已认证的测试环境中执行;先确认索引名空闲,不要覆盖已有数据。
PUT ctx_migration_lab
{
  "settings": {
    "number_of_shards": 1,
    "number_of_replicas": 0
  },
  "mappings": {
    "properties": {
      "title": { "type": "text" },
      "status": { "type": "keyword" },
      "count": { "type": "integer" }
    }
  }
}

PUT ctx_migration_lab/_doc/a
{"title":"quick brown fox","status":"published","count":5}

PUT ctx_migration_lab/_doc/b
{"title":"quick brown fox","status":"draft","count":5}

PUT ctx_migration_lab/_doc/c
{"title":"slow turtle","status":"published","count":5}

POST ctx_migration_lab/_refresh
先确认三次写入成功。数据有意让 a、b 的标题相同、状态不同,c 的标题不同,这样可以分别观察筛选条件与打分条件的作用。
第一轮把状态条件放在 filter 里:
GET ctx_migration_lab/_search
{
  "size": 10,
  "query": {
    "bool": {
      "must": [ { "match": { "title": "quick brown fox" } } ],
      "filter": [ { "term": { "status": "published" } } ]
    }
  }
}
第二轮只把 filter 换成 must,其他不变。两轮的命中集合可能相同,但得分可能不同,因为状态条件在第二轮参与了打分。
预期检查项是文档 ID 集合与得分是否变化。本文没有运行这些请求,不给出具体分数值。重点是掌握比较方法:固定数据、只改上下文、比较集合与排序。
同一批数据的三种写法
用前面的数据继续验证,每次只改一处。第二轮把状态条件放进 must:
GET ctx_migration_lab/_search
{
  "size": 10,
  "query": {
    "bool": {
      "must": [
        { "match": { "title": "quick brown fox" } },
        { "term": { "status": "published" } }
      ]
    }
  }
}
比较两轮的 _score 与排序。
第三轮用 constant_score 把打分条件整体转为固定分:
GET ctx_migration_lab/_search
{
  "size": 10,
  "query": {
    "constant_score": {
      "filter": {
        "bool": {
          "must": [ { "match": { "title": "quick brown fox" } } ],
          "filter": [ { "term": { "status": "published" } } ]
        }
      },
      "boost": 1.0
    }
  }
}
预期是所有命中文档得分相同。适合只关心匹配、后续按其他字段排序的场景。
三轮的区别:第一轮按相关性排序且状态不打分,第二轮状态参与打分,第三轮完全不打分。选择哪一种取决于排序需求,不是语法偏好。
must 还是 filter 的判据
判据只有一条:这个条件要不要参与相关性打分。
- 要,例如“标题包含关键词”——放
must或should; - 不要,例如“状态是已发布”、“时间在某区间”——放
filter。
filter 的两个效果是不打分、结果可被复用。因此默认能用 filter 就用 filter,把 must 留给真正需要影响排序的条件。
这条判据从 2.0 到现在没有变过。它保留的是“区分要不要算分”这件事本身,变化的是表达方式:不再需要两套类型,只需要选上下文。
这次改动为什么保留下来
合并之前,使用者必须知道哪些子句能缓存、缓存键是什么、怎么写才能命中;这些是实现层面的考虑,却暴露成了必须掌握的概念。合并之后,使用者只需要决定“这个条件要不要影响得分”。
判断一个抽象是否合适,可以看新需求来时是“加一项”还是“改结构”。这套上下文模型后续基本只增加了入口与优化方式,语义没有再变,说明当初的抽象是成立的。
这不代表使用者可以完全不了解缓存。自动缓存改变了调参方式,但没有消除对查询成本的理解需求;性能问题仍需按数据、mapping 与负载排查。
迁移检查清单
| 检查项 | 要确认什么 |
|---|---|
filtered 与 and/or/not |
是否都已改写为 bool |
must 与 filter |
条件是否按“要不要打分”放对位置 |
| 区间写法 | from/to 是否改为 gte/lt,端点语义是否一致 |
| 数字字段 | 是否依赖过“不算分”的旧行为 |
terms lookup |
是否配置了 auto_expand_replicas |
| 聚合与别名 | 其中的 filter 是否仍按预期工作 |
| 得分 | 迁移前后是否用真实查询比对过排序 |
前几项可以通过搜索代码完成,最后一项必须运行查询。功能测试通常只能验证集合一致,排序变化容易被漏掉。
三类旧写法的对照
下面把 1.x 常见写法与 2.0 之后的写法放在一起。每组只改一处,便于逐项验证:
| 旧写法 | 新写法 | 要注意的点 |
|---|---|---|
filtered + filter |
bool 的 filter |
保持“不算分”的语义 |
and 过滤器 |
filter 数组中的多项 |
不要改成 must |
or 过滤器 |
should + 显式 minimum_should_match |
明确匹配要求 |
not 过滤器 |
must_not |
确认缺失字段是否应命中 |
range 的 from/to |
gte / lt |
端点是否闭合 |
missing 过滤器 |
bool.must_not + exists |
语义一致 |
数字字段 term |
视需要放入 filter context | 打分行为已变 |
not 与 missing 这一类取反写法,都要明确“字段缺失”是否算命中。业务上“没有这个字段”和“字段值不是 X”通常是两件事,改写时应显式表达,而不是依赖默认行为。
区间端点也容易出错。旧写法 from/to 默认包含两端,改成 gte/lt 会把上界变成开区间。准备等于边界值的文档单独验证,参见 filtered 查询与过滤器的历史。
升级后怎么排查慢查询
合并之后缓存决策方式变了,理论上部分查询会更快,但不能假定全部变快。若某条查询反而变慢,应按数据变化、mapping 变化、查询语义变化、资源变化的顺序排查,而不是先改缓存相关配置。
需要记录的信息包括:迁移前后的分片与副本、段数量、数据量、并发,以及查询本身的命中规模。单次耗时只能反映一次执行,应多次采样并看分布。
若确认与打分有关,可以先检查是否有条件被放进了 must 而非 filter。多算分不仅改变排序,也可能增加计算量。这类问题通过对比得分与耗时都能发现。
老代码里怎么找这些写法
可以在代码库里按模式搜索,但要结合上下文判断:
# 找 filtered 查询
grep -rn '"filtered"' --include=*.json --include=*.java --include=*.py . | head -20

# 找 and/or 过滤器(注意别误伤 bool 里的同名键)
grep -rn '"and"[[:space:]]*:[[:space:]]*\[' --include=*.json . | head -20

# 找 from/to 老式区间写法
grep -rn '"from"[[:space:]]*:' --include=*.json . | head -20
搜索结果需要人工确认:and、or、from、to 这些键在其他结构里也会出现。把它们放进查询 DSL 的上下文里看,才能判断是否是需要迁移的旧写法。
搜索也替代不了运行验证。找出候选位置后,仍要用真实查询比对迁移前后的结果。
在 9.4.2 上跑一遍
query 与 filter 合并之后,两种上下文靠 bool 的子句区分,跑一次搜索就能看到评分差别。
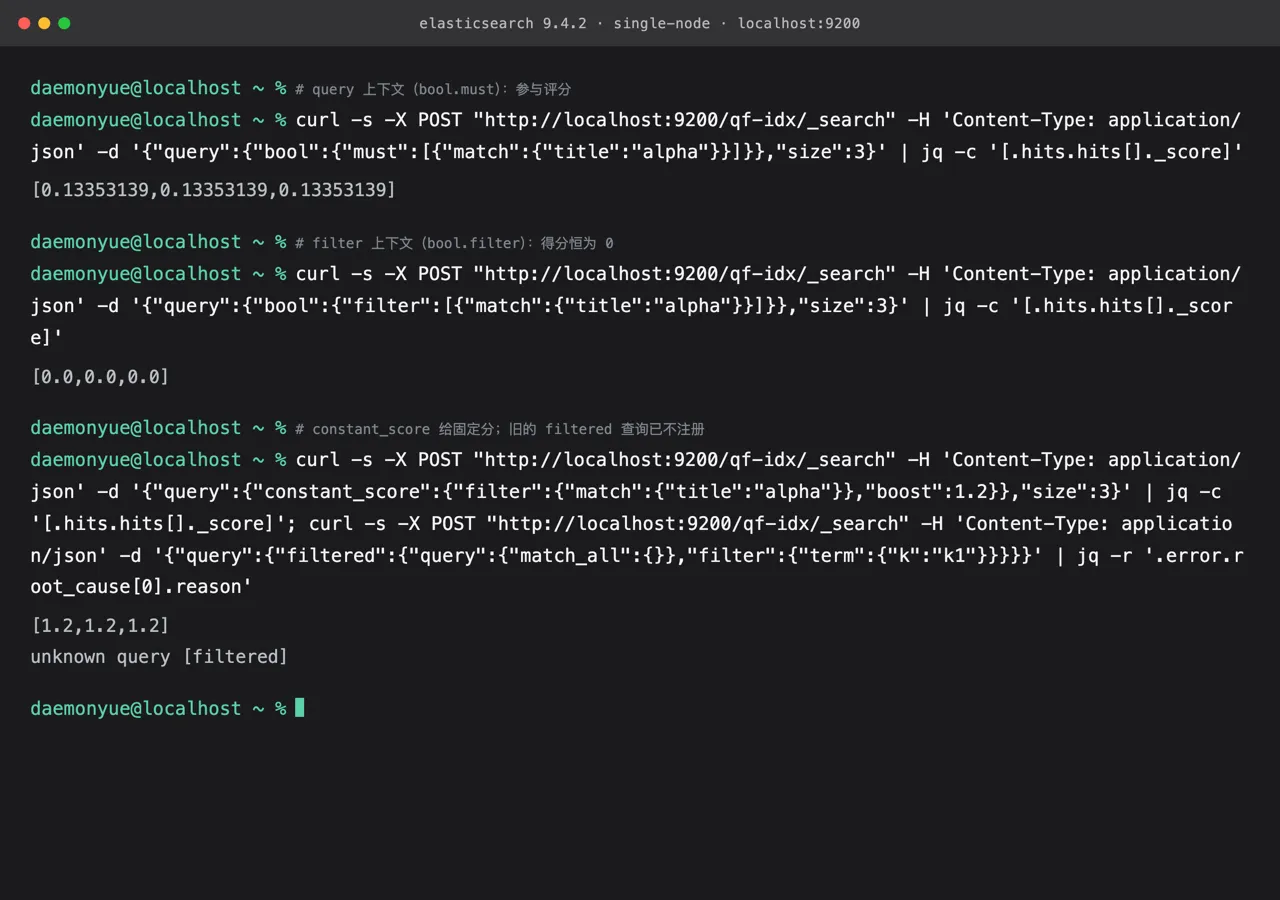
图 1:9.4.2 单节点实例的实测输出。同一条 match 查询放在 bool.must 里得分为 0.1335,放在 bool.filter 里恒为 0.0;constant_score 给固定 1.2;旧的 filtered 查询报 unknown query [filtered]。
curl -s -X POST 'http://localhost:9200/qf-idx/_search' -H 'Content-Type: application/json' \
  -d '{"query":{"bool":{"must":[{"match":{"title":"alpha"}}]}},"size":3}' \
  | jq -c '[.hits.hits[]._score]'
# [0.13353139,0.13353139,0.13353139]
curl -s -X POST 'http://localhost:9200/qf-idx/_search' -H 'Content-Type: application/json' \
  -d '{"query":{"bool":{"filter":[{"match":{"title":"alpha"}}]}},"size":3}' \
  | jq -c '[.hits.hits[]._score]'
# [0.0,0.0,0.0]
curl -s -X POST 'http://localhost:9200/qf-idx/_search' -H 'Content-Type: application/json' \
  -d '{"query":{"constant_score":{"filter":{"match":{"title":"alpha"}},"boost":1.2}},"size":3}' \
  | jq -c '[.hits.hits[]._score]'
# [1.2,1.2,1.2]
curl -s -X POST 'http://localhost:9200/qf-idx/_search' -H 'Content-Type: application/json' \
  -d '{"query":{"filtered":{"query":{"match_all":{}},"filter":{"term":{"k":"k1"}}}}}' \
  | jq -r '.error.root_cause[0].reason'
# unknown query [filtered]
图 1 把「老写法要重新验」做成了具体数字:同一个条件在 query 上下文参与评分,在 filter 上下文不评分,需要固定分就用 constant_score。旧 filtered 查询在 9.4.2 里连注册都没有,所以迁移不是把字段名换掉那么简单,得先确认原来依赖的是匹配还是打分。
边界:
- 图 1 出自 9.4.2 单节点实例,本机没有 1.x / 2.x 二进制,验的是合并之后的行为;
- 只测了
match一种查询与三条文档; - filter 缓存、性能差异与 2.0 当年的迁移过程未实测。
写在最后
2.0 这次合并的核心是把“算不算分”从两套类型变成上下文选择,同时把缓存决策从手工开关改为实现自动判断。缓存这个概念并没有消失。
迁移时最容易出错的是把原来的筛选条件放进 must,以及数字字段打分语义变化。用固定数据比较集合与排序,比只看查询能否执行可靠。
参考
- 2.0 查询 DSL 迁移说明 @ v2.0.0
- filtered 查询与过滤器的历史
本文逐段核对了固定标签的 2.0 迁移说明,引文取自该文档。「在 9.4.2 上跑一遍」里已实际对照:
bool.must得分 0.1335、bool.filter恒为 0.0、constant_score固定 1.2,旧filtered查询报unknown query [filtered]。得分与排序已有本机实测;本机无 1.x / 2.x 二进制,验的是合并之后的行为;filter 缓存、性能差异与 2.0 当年的迁移过程未实测。