上一篇讲了短期记忆的三要件,thread_id、checkpointer 与 state 容器各管什么。这一篇往下走一层,讲怎么用。挂载是三行代码的事,真正决定能不能上生产的是后面这几件事,数据库选型、字段扩展、事后修正、动态注入和上下文压缩,每一件都有具体的参数和坑。
一、最小可用,三行代码
给 Agent 装记忆,第一步是在 create_agent 里多传一个参数。
from langchain.agents import create_agent
from langgraph.checkpoint.memory import InMemorySaver

agent = create_agent(
    model="openai:gpt-5.5",
    tools=[get_user_info],
    checkpointer=InMemorySaver(),
)
第二步是调用时带上会话坐标。
config = {
   "configurable": {
   "thread_id": "1"}}

resp = agent.invoke(
    {
   "messages": [{
   "role": "user", "content": "Hi! My name is Bob."}]},
    config,
)["messages"][-1].content

resp = agent.invoke(
    {
   "messages": [{
   "role": "user", "content": "What's my name?"}]},
    config,
)["messages"][-1].content
# "You are Bob!"
两次 invoke 是两次独立的函数调用,第二次能答对,靠的是 checkpointer 在第一次调用结束后把消息列表存了下来,第二次开始前又原样读回去。注意一个顺序问题,checkpointer 不挂,thread_id 传得再讲究也没有效果,存取通道本身是 checkpointer 提供的。
顺带一句,stream 和 astream 与 invoke 吃同一份 config,同一个 thread_id 下混用三种调用方式不会破坏记忆的连续性。流式只改变输出侧的体验,存取节奏完全一样,每个执行步骤结束都会落一次快照。
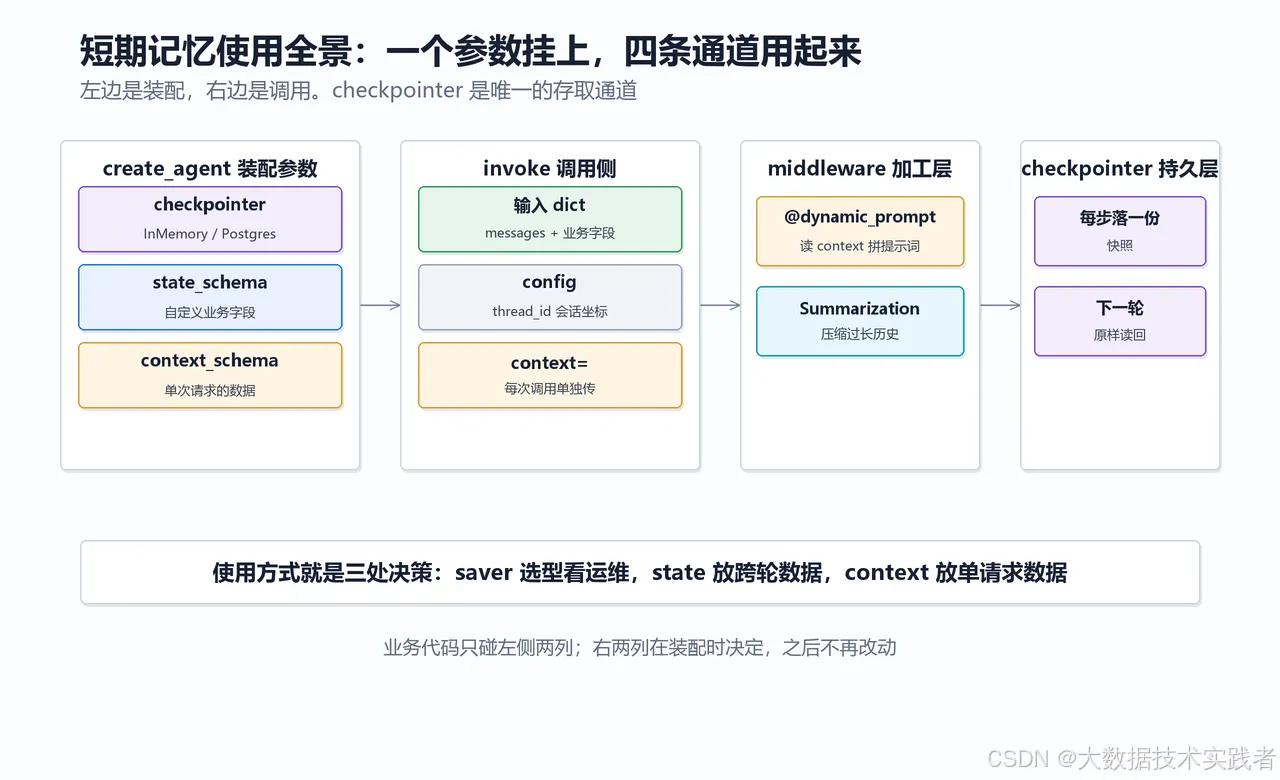
InMemorySaver 把快照放在进程内存里,本地验证够用,进程一重启就清零。它和生产环境的差距,就是下一节的内容。
二、生产环境换库,PostgresSaver 完整流程
生产环境用数据库做持久层,官方推荐 Postgres。安装两个包。
pip install -U langgraph-checkpoint-postgres "psycopg[binary]"
连接与建表。
from langgraph.checkpoint.postgres import PostgresSaver

DB_URI = "postgresql://postgres:postgres@localhost:5432/postgres?sslmode=disable"

with PostgresSaver.from_conn_string(DB_URI) as checkpointer:
    checkpointer.setup()  # 建表,带索引,只需执行一次

    agent = create_agent(
        "openai:gpt-5.5",
        tools=[get_user_info],
        checkpointer=checkpointer,
    )
setup() 做 DDL,建 checkpoint 相关的表和索引,首次部署执行一次,之后重复执行也安全。
这里有个容易被忽略的细节。with 语句罩住的是数据库连接的生命周期,agent 的所有调用必须发生在 with 块内部。见过一种写法是把 create_agent 放进 with 里,把 invoke 写在 with 外面,结果跑起来报连接已关闭。连接对象借给 agent 用,块一退出连接就还了。长驻服务里更常见的做法是用连接池,或者干脆把 agent 的构建和调用都圈在同一个生命周期里。
单机开发或演示场景,SqliteSaver 是更轻的选择,from_conn_string 传一个本地文件路径就能用,接口和 Postgres 版完全一致。除了这两个,官方生态还有 Redis 版实现,适合已有 Redis 基础设施且要低延迟读写的团队。选型看现成的数据库运维能力,哪家熟用哪家,checkpoint 的表结构都不复杂,运维成本可以忽略。
还有一条经验。saver 的切换对业务代码零侵入,import 和构造两行一改就完事,所以测试环境用内存版、生产用数据库版不构成任何负担。反过来,发布脚本里保留内存实现就是事故,别这么做。
三、扩展业务字段,state_schema 的正确姿势
默认的 state 只有一个 messages 字段。业务上要记的东西往往不止对话,比如用户 ID、偏好设置。做法是继承 AgentState 加字段,再通过 state_schema 参数挂上去。
from langchain.agents import create_agent, AgentState
from langgraph.checkpoint.memory import InMemorySaver


class CustomAgentState(AgentState):
    user_id: str
    preferences: dict


agent = create_agent(
    "openai:gpt-5.5",
    tools=[get_user_info],
    state_schema=CustomAgentState,
    checkpointer=InMemorySaver(),
)
写入的方式是调用时直接带上。
result = agent.invoke(
    {

        "messages": [{
   "role": "user", "content": "Hello"}],
        "user_id": "user_123",
        "preferences": {
   "theme": "dark"},
    },
    {
   "configurable": {
   "thread_id": "1"}},
)
这些字段会跟着 thread 一起被 checkpointer 存下来,下一轮调用原样可读。
上一篇提过的坑这里再钉一次,没在 state_schema 里声明的字段,调用时传了也会被静默丢弃,不报错。排查这类问题先查 schema 声明,再查传参拼写,顺序反了会白忙半天。
四、事后查看与修正
上线之后难免要回答两个问题,某个 thread 里现在到底存了什么,以及存错了能不能改。LangGraph 给了两个方法。
snap = agent.get_state({
   "configurable": {
   "thread_id": "1"}})

print(snap.values["messages"])   # 全部字段当前值
print(snap.next)                 # 下一轮要执行的节点,非空表示中断中
print(snap.tasks)                # 挂起中的任务
print(snap.created_at)           # 快照时间
get_state 返回 StateSnapshot,values 是完整 state,next 有值说明流程停在中断处(比如等人工确认),这两个字段做客服后台和调试面板都够用。
修正用 update_state,比如上一轮抽取出的 user_id 抽错了。
agent.update_state(
    {
   "configurable": {
   "thread_id": "1"}},
    {
   "user_id": "user_456"},
)
改完立即生效,下一次 invoke 读到的就是新值。配合 get_state_history 还能看到这个 thread 的全部历史快照,每一步执行都对应一份快照,定位某个时刻的状态从哪一步开始变坏,比翻日志直观得多。time travel 的能力也建在这上面,拿历史快照里的 checkpoint id 重新跑一遍,就能复现当时的世界线。
五、动态注入不落盘,context 与 state 的分工
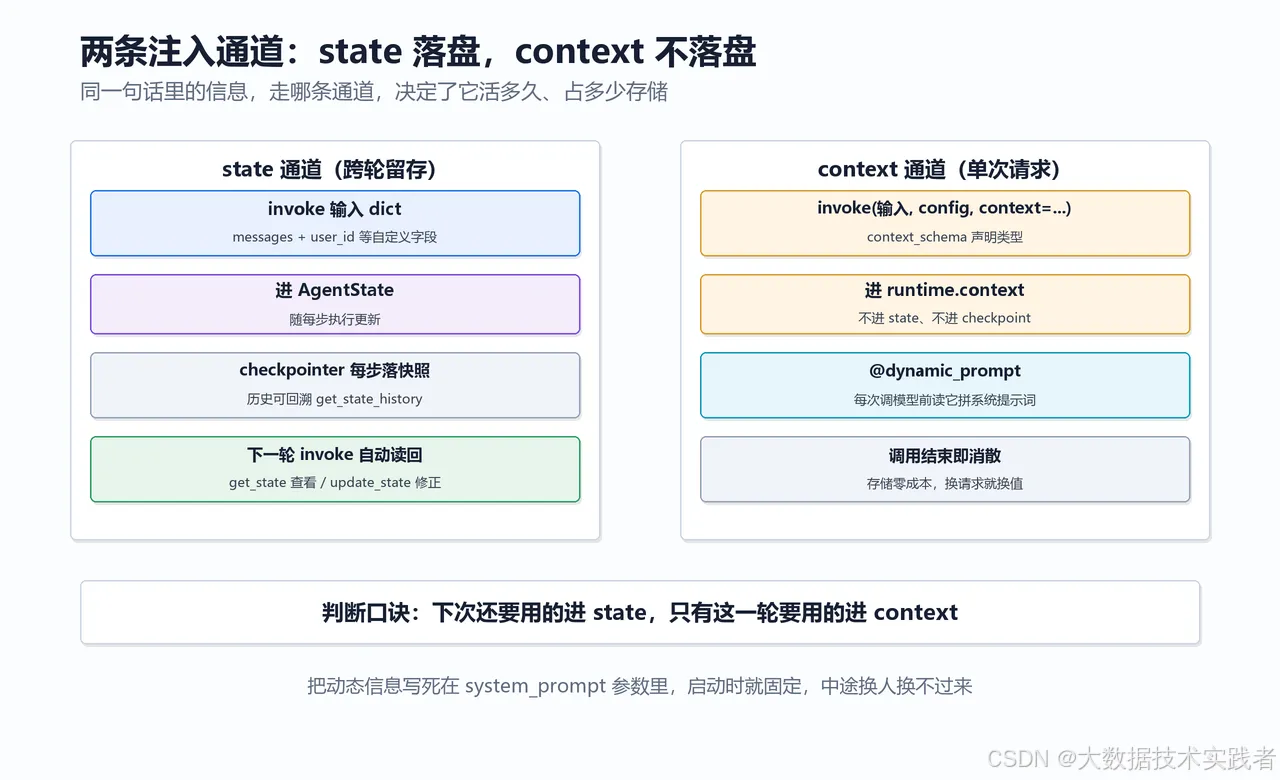
有一类信息不适合写进 state,比如本次请求的用户身份、灰度开关、租户标记。它们每次调用都可能不同,写进 state 会永久留存,还会跟着每个步骤的快照一起膨胀存储。LangChain 为这类数据留了另一条通道,context。
from typing import TypedDict
from langchain.agents.middleware import dynamic_prompt, ModelRequest


class CustomContext(TypedDict):
    user_name: str


@dynamic_prompt
def dynamic_system_prompt(request: ModelRequest) -> str:
    user_name = request.runtime.context["user_name"]
    return f"You are a helpful assistant. Address the user as {user_name}."


agent = create_agent(
    model="openai:gpt-5-nano",
    tools=[get_weather],
    middleware=[dynamic_system_prompt],
    context_schema=CustomContext,
)

result = agent.invoke(
    {
   "messages": [{
   "role": "user", "content": "What is the weather in SF?"}]},
    context=CustomContext(user_name="John Smith"),
)
context 在 runtime 上下文里流动,dynamic_prompt 在每次模型调用前读它拼系统提示词,全程不碰 state,也就不进 checkpoint。注意求值时机,提示词是每次调模型都重新拼一遍,运行中改 context 的值,下一次模型调用立刻跟着变。要是把这类动态信息写死在 create_agent 的 system_prompt 参数里,启动时就固定了,中途换用户就换不过来。
分界线一句话可以记牢,跨轮次要留存的进 state,单次请求要用的进 context。用户名这种换个人提问就变的数据,放 context 才是对的。
六、自动压缩,SummarizationMiddleware 参数拆解
对话变长,messages 会逼近模型上下文窗口。上一篇给过四种压缩策略的总览,这一篇把工程上最省心的一种拆开讲,官方内置的 SummarizationMiddleware。
from langchain.agents import create_agent
from langchain.agents.middleware import SummarizationMiddleware
from langgraph.checkpoint.memory import InMemorySaver

agent = create_agent(
    model="openai:gpt-5.5",
    tools=[...],
    middleware=[
        SummarizationMiddleware(
            model="openai:gpt-5.4-mini",
            trigger=("tokens", 4000),
            keep=("messages", 20),
        )
    ],
    checkpointer=InMemorySaver(),
)
三个参数各管一件事。
model 负责生成摘要的模型,用小模型就行,摘要任务用旗舰模型是浪费。
trigger 是触发条件,元组第一个元素选单位。("tokens", 4000) 表示历史超过四千 token 就触发,也可以写 ("messages", 50) 按条数算。阈值建议压到模型窗口的三分之一以下,给工具结果和回复留余量。
keep 是触发后保留多少条原始消息。("messages", 20) 表示最近二十条原样保留,更早的压成一条摘要消息放在列表头部。调模型时看到的列表就是摘要加最近二十条,模型既知道前情的梗概,又不为远古对话付费。
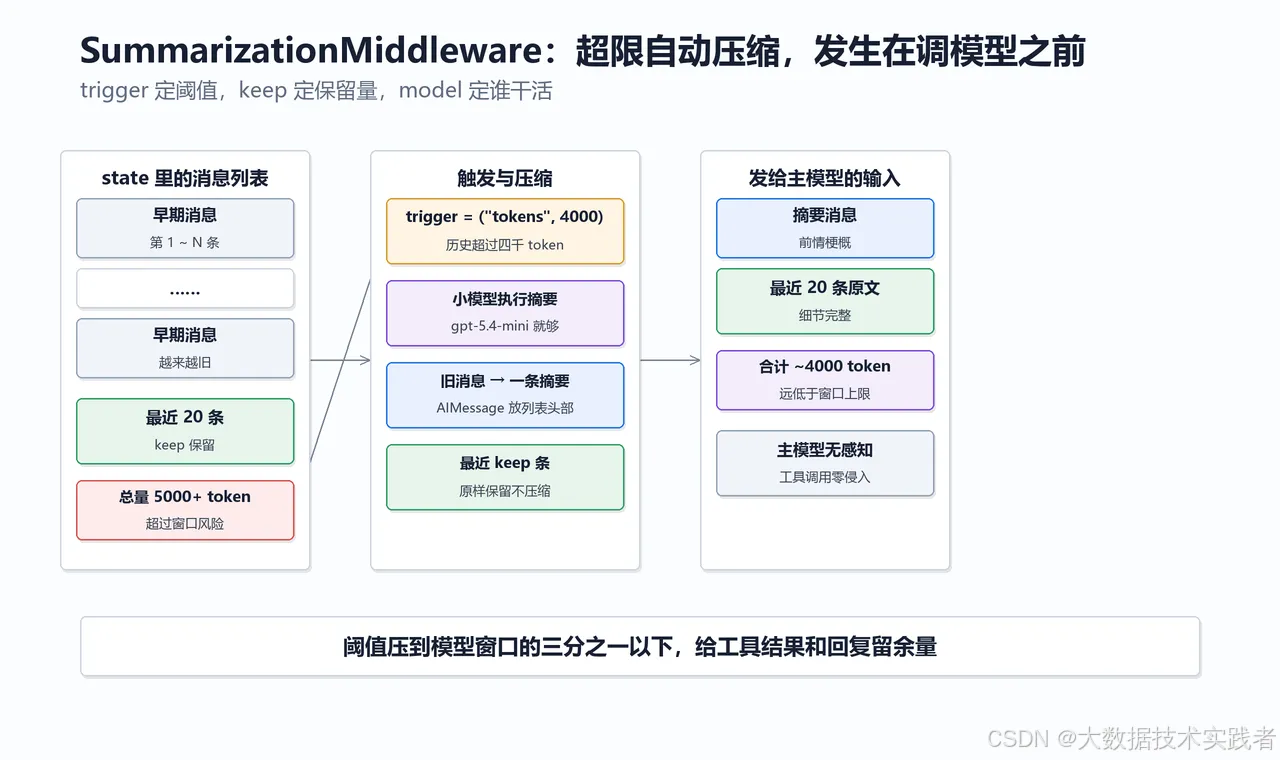
一个常被问到的点,摘要用的模型和主模型可以是两个。压缩发生在调模型之前,对工具调用和输出格式零侵入,这是它比自己写截断逻辑省心的根本原因。
七、上线前排障清单
四个高频问题,上线前逐条过一遍。
第一,thread_id 长度。PostgresSaver 的 thread_id 列有长度上限,超过 255 字符直接报数据库错误。业务键拼接太长就先做哈希再当 thread_id 用。
第二,InMemorySaver 不能上生产。重启全丢是设计行为,不是 bug。测试环境用内存、生产用 Postgres,切换只改 import 和构造那两行,别在发布脚本里保留内存实现。
第三,checkpoint 膨胀。每个执行步骤后都会落一份快照,十几轮工具调用的会话就是几十行记录。加个定时任务清理超过保留期的 thread,官方文档明确建议这么做。
第四,同一个 thread 别并发写。两个请求同时写一个 thread_id,后写的会覆盖前写的,消息凭空丢一条还不报错。按 thread 维度加锁,或者保证一个 thread 同一时刻只有一个请求在跑。
八、使用方式速查表
| 用法 | 关键参数 | 一句话 |
|---|---|---|
| 挂载记忆 | checkpointer=InMemorySaver() | 本地验证够用,重启即失 |
| 生产持久 | PostgresSaver.from_conn_string + setup() | 调用必须在连接生命周期内 |
| 扩展字段 | state_schema=CustomAgentState | 未声明字段静默丢 |
| 事后查看 | get_state(config).values | next 非空表示中断中 |
| 事后修正 | update_state(config, values) | 立即生效 |
| 单次注入 | context_schema + invoke(context=...) | 不落盘,不进 checkpoint |
| 自动压缩 | SummarizationMiddleware(model, trigger, keep) | 小模型做摘要,大模型干活 |
短期记忆的使用方式,说到底是在三个地方做决策。存储层选什么 saver,state 里放哪些字段,调用时哪些东西走 context。这三处定了,剩下的都是参数填写。下一篇讲长期记忆的 Store,跨 thread 的用户偏好和事实记忆怎么存怎么取,和本篇的使用方式正好衔接。