JeecgBoot AI专题研究 | Images 2.6 动图实战清单、提示词写法,以及"图片→动图→视频"的商业路径分析
写在前面:动图能力出来以后,真正的问题是"拿它干什么"
OpenAI 在 11 月 4 日更新了 Images 2.6,最引人注意的变化是可以把静态图直接做成循环 GIF。速度、模型分工、API 的帧数参数这些内容,功能和 API 细节见上一篇,这里只简单交代一句:在 ChatGPT 网页端上传一张图,说"做成循环 GIF",再描述想要的动作,就能拿到一段几秒钟的循环动图;官方说该功能正在逐步开放,实测网页端已可用,Codex 端暂时还不行。
官方演示里,一只小猴子提起灯笼、抬头、再放下,首尾衔接成一个干净的小循环。不过官方精选只能说明上限,日常用起来效果如何,还得拿普通素材自己试。
这篇换个角度,不再罗列参数,主要回答两件事:
- 动图到底能用在哪:按游戏 sprite 动作、美食和产品展示、表情包玩梗三类,分别讲提示词怎么写、哪些场景合适、哪些不合适;
- OpenAI 为什么要做动图:从图片到动图再到视频,这条路背后是一门已经被验证过的生意。
玩法一:游戏角色 sprite 动作,先把"手感"试出来
能做到什么程度
拿一张角色的持剑站立图试一下:让角色双手握剑、剑尖朝前,做一次带残影的冲刺。结果里压低重心、向前突进、头发和衣摆向后甩、身后拖出残影,这些都有,模型明显理解了"冲刺"该是什么样。再试一个必杀技:起手、挥剑、剑光划出弧线、收招,一张站立图就能出个大概。
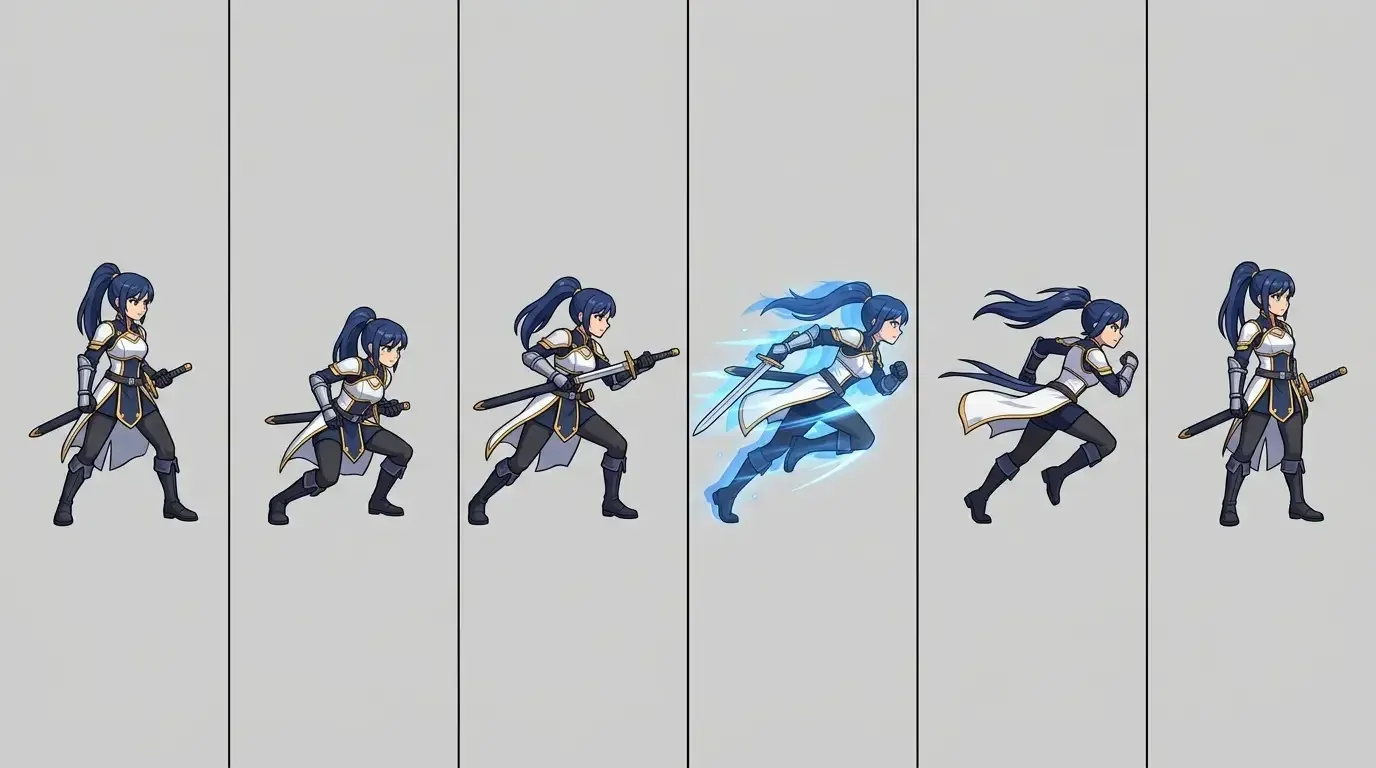
对独立开发者和小团队来说,这个能力最大的价值是验证动作。以前想看一个新技能在游戏里"帅不帅",要么手绘关键帧,要么找动画师排期,现在可以先让图动起来,觉得方向对了再精修。
提示词写法:原地动作,位移交给引擎
做游戏素材时,最关键的一句是"角色在原地做动作,不要发生位移"。原因很简单:游戏里角色往哪跑、跑多快,是引擎按输入和物理计算的;如果素材自带位移,角色就会出现"滑步",或者在循环的接缝处瞬移回原点。
一个可用的提示词结构:
- 主体与保持:保持角色造型、服装配色和画风不变;
- 动作分解:双手持剑,剑尖朝前,压低身体,向前冲刺,头发和衣摆向后飘,带残影;
- 约束条件:角色始终在画面中心原地动作,不平移,背景纯色;
- 循环要求:首帧和末帧姿态一致,可以无缝循环。
帧数与循环的几个要点
- 待机、呼吸类动作:帧数少一点就够,重点是首尾衔接,避免每循环一次就"抖"一下;
- 攻击、冲刺类动作:这类动作本身不一定要循环,可以让模型按"起手—发力—收招"生成,再在引擎里只播一次;
- 背景尽量纯色:方便后期抠图,导出 PNG 序列或拼成 sprite sheet 后再进 Unity、Godot、Cocos 之类的引擎;
- 逐帧检查一致性:最常见的问题是中间某几帧武器长度、发型细节变了,正式用之前一定要逐帧过一遍。
需要说明的是,动图更适合做原型和占位素材。像素级对齐、精确的判定帧、多方向动作统一,目前还是要美术手工收尾。
玩法二:美食与产品图,让展示"活"起来
能做到什么程度
拿一张普通的美食照片,让模型加一个试吃的人物:拿起来咬一口,满意地点头比赞。食物本身没变,但画面从"摆拍"变成了"有人在吃",代入感强了很多。同样的思路可以用在产品图上:杯子冒热气、口红旋出膏体、包装盒打开再合上。
提示词写法
- 明确哪些不能变:保持食物外观、摆盘和光线不变;
- 明确谁来做什么:一位年轻女性坐在桌前,夹起一块,咬一口,露出满意表情并比赞;
- 控制动作幅度:动作简单、节奏放慢,避免手部和餐具扭曲;
- 加一句循环收尾:最后回到初始姿态。
尺寸与体积要注意
电商和自媒体用动图,最容易踩的坑是体积。GIF 是逐帧存储的,尺寸一大、帧数一多,文件很容易到几 MB,平台可能压缩,也可能直接拒收。几条经验:
- 先定投放位置再定尺寸:商品详情页、公众号正文、社交平台配图对宽度和体积的要求各不相同,发布前按平台规则裁一遍,不要直接上传原图;
- 能短就短:展示类动图 2~3 秒、一个完整动作就够,多余的帧只会增加体积;
- 压缩后再看一遍:减色、抽帧压缩之后,渐变和皮肤容易出现色带,要确认效果还能接受;
- 注意真实性:给食物、产品加"试吃""试用"效果,用在商业宣传时要避免让人误以为是真实测评,必要时标注 AI 生成。
玩法三:表情包与玩梗,好玩但要守边界
能做到什么程度
给同事拍一张工位照,让他"撕开衬衫变身超人,从办公室飞走",几秒钟的动图就成了群聊里的专属表情包。熟人之间斗图,现场定制比翻表情库有意思得多。
提示词写法
- 夸张但简单:一个动作讲清楚一个梗,比如"变身、飞走",不要塞三四个情节;
- 保留辨识度:保持人物面部特征和服装不变,否则就不像本人了;
- 留出文字位置:如果要配文案,建议生成后自己加字,模型直接写字容易出错。
肖像权提醒
这一类玩法最需要注意边界:
- 拿别人照片之前先征得同意。同事、同学的照片属于个人肖像,未经允许做成恶搞动图并传播,可能引发矛盾,甚至涉及肖像权、名誉权纠纷;
- 只在熟人小范围用,不要发到公开平台,更不要用于商业用途;
- 不碰公众人物和敏感题材,避免丑化、软色情、冒充等内容,这既是平台规则,也是法律风险;
- 未成年人的照片尤其不要随便拿来改。
三类玩法速查:适合与不适合
| 玩法 | 适合 | 不适合 |
|---|---|---|
| 游戏 sprite 动作 | 动作原型验证、占位素材、独立游戏小角色 | 需要精确判定帧、像素级对齐的正式美术资产 |
| 美食 / 产品展示 | 社交平台配图、详情页点缀、文章插图 | 需要严格还原真实效果的测评、带明确卖点承诺的广告 |
| 表情包玩梗 | 熟人群聊、团队内部氛围 | 未经同意的他人照片、公开传播、商业使用 |
GIF 和视频模型怎么分工
既然动图能"动"了,那还需要视频模型吗?我们团队做 AI 漫剧,日常用的是 Seedance 2.5 和 MiniMax-H3,两边都用下来,我们的判断是:动图适合 2~3 秒的循环小动作,叙事镜头还得交给视频模型。
具体来说:
- 动图的强项:单一主体、单一动作、可循环、无声音、体积可控,适合嵌在网页、文章、聊天里自动播放;
- 视频模型的强项:多镜头叙事、运镜、人物对白和音效、更长的时长,这些是 GIF 这种格式本身就做不到的;
- 两者可以串起来用:先用动图快速试角色动作和表情,确定"这个角色这样动是对的",再把设定和参考图交给视频模型去拍完整镜头,能省掉不少试错成本。
可灵这类视频模型也在同一个赛道里。动图和视频模型并不是谁替代谁,更像是同一条素材生产线上的上下游。
OpenAI 为什么做动图:图片→动图→视频的商业路径

把动图放到更大的背景里看,就能理解 OpenAI 的动作。
视频生成已经是一门大生意
据媒体报道,6 月有消息称字节的 Seedance 年化收入已达约 20 亿美元;快手财报披露,可灵在 3 月的年化收入运行率接近 5 亿美元。需要注意,这两个数字都是按当时的收入速度折算全年的口径,并不等于实际年收入。另据媒体 11 月 3 日报道,Seedance 的海外收入占比已经达到 50%。
这说明两件事:一是用户愿意为 AI 视频付费,而且规模已经到了数十亿美元的量级;二是这门生意并不局限在国内,海外市场同样在买单。
动图是一块低成本的"台阶"
OpenAI 的 Sora 网页端和 App 今年 4 月已经停止服务,在视频赛道上暂时没有面向大众的主力产品。这时候在生图里加入动图,有几层现实的考虑:
- 成本低:几秒钟、无声音的动图,算力消耗远低于完整视频,可以放进现有的生图入口,不必单独再做一个产品;
- 用户现成:ChatGPT 生图已经有庞大的用户基础,加一个"做成 GIF"的选项,几乎不需要额外教育用户;
- 数据和反馈:用户怎么描述动作、哪些动作最受欢迎、哪里最容易崩,这些反馈对后续的视频能力很有价值;
- 付费路径清晰:先用好玩的表情包把人吸引进来,再在游戏素材、电商展示、广告物料这些工作场景里变成刚需,最后自然会有人愿意为更长、更高清的版本付费。
会不会重新回到视频赛道
从产品节奏看,"静态图→循环动图→短视频"是一条很自然的升级路线,每一步都建立在上一步的用户和技术积累上。OpenAI 是否会重启 Sora 或推出新的视频产品,目前没有官方消息,不宜下结论。但可以肯定的是,图像生成正在从"出一张图"走向"出一段动态内容",视频生成市场的竞争也会因此更加激烈。
总结
Images 2.6 的动图能力,好玩之外也能落到工作里:游戏开发者可以用它试 sprite 动作,记住"原地动作、位移交给引擎、首尾帧一致";电商和自媒体可以做展示动图,提前按平台控制尺寸和体积;表情包玩梗要先征得本人同意,只在小范围使用。
在定位上,动图负责 2~3 秒的循环小动作,叙事镜头仍然要靠 Seedance、MiniMax、可灵这类视频模型。从商业角度看,据媒体报道视频生成已是数十亿美元量级的市场,OpenAI 借生图入口切入动图,很可能是它重新进入视频竞争的一级台阶,后续动向值得持续关注。
本文为 JeecgBoot AI 专题研究系列文章。