JeecgBoot AI专题研究 | 基于 Remotion 的开源视频技能包解读,附我们用代码渲染宣传片的实践对照
为什么 AI 做出来的视频总像幻灯片
让大模型写文章、写代码已经很顺手,可一旦让它"做个视频",结果往往不太理想:画面单独生成了一堆,拼起来像自动翻页的 PPT;配音念到第三句,字幕还停在第一句;想改一句台词,后面所有镜头的节奏全乱,只能整条重做。
我们自己做产品宣传片时也碰到过同样的情况。后来想明白了,毛病不在模型画得好不好,而在流程。视频是好几个环节接力完成的:文案、配音、字幕、画面、音效、渲染,环环相扣。指望一次生成全部搞定,本身就不现实。
GitHub 上的开源项目 liangdabiao/video-skills-toolkit(fork 自 bozhouDev/video-skills-toolkit)给出了另一种做法:AI 不直接"生成视频",而是把制作流程拆成一个个能单独调用的技能(Skill),交给 Agent 按分工执行,底层用 Remotion 渲染。本文先讲它的核心思路和六个技能,再结合我们团队的实践,聊聊这条路线的成本、边界和适用场景。
核心思路:以声音为轴的时间线
这个项目 README 里最值得记住的一句话,大意是:视频本质上是一条以声音为轴的时间线。
很多人的习惯顺序是先做画面,最后补配音、对字幕。这样做的问题在于,画面没有可以对齐的基准,每个镜头的时长都是凭感觉定的,配音一进来,节奏就全对不上。
项目推荐的顺序正好反过来:
| 步骤 | 做什么 | 产出 |
|---|---|---|
| 1 | 写逐字稿,口语化也没关系 | 文案 |
| 2 | 用 TTS 生成配音 | 音频 |
| 3 | 把音频转成字幕 | SRT / VTT / JSON 时间轴 |
| 4 | 按字幕时间点制作画面和动画 | 画面轨 |
| 5 | 叠加音效和背景音乐 | 音频轨 |
| 6 | 低清出样片调试 | proof 预览 |
| 7 | 确认无误后高清出片 | 成片 |
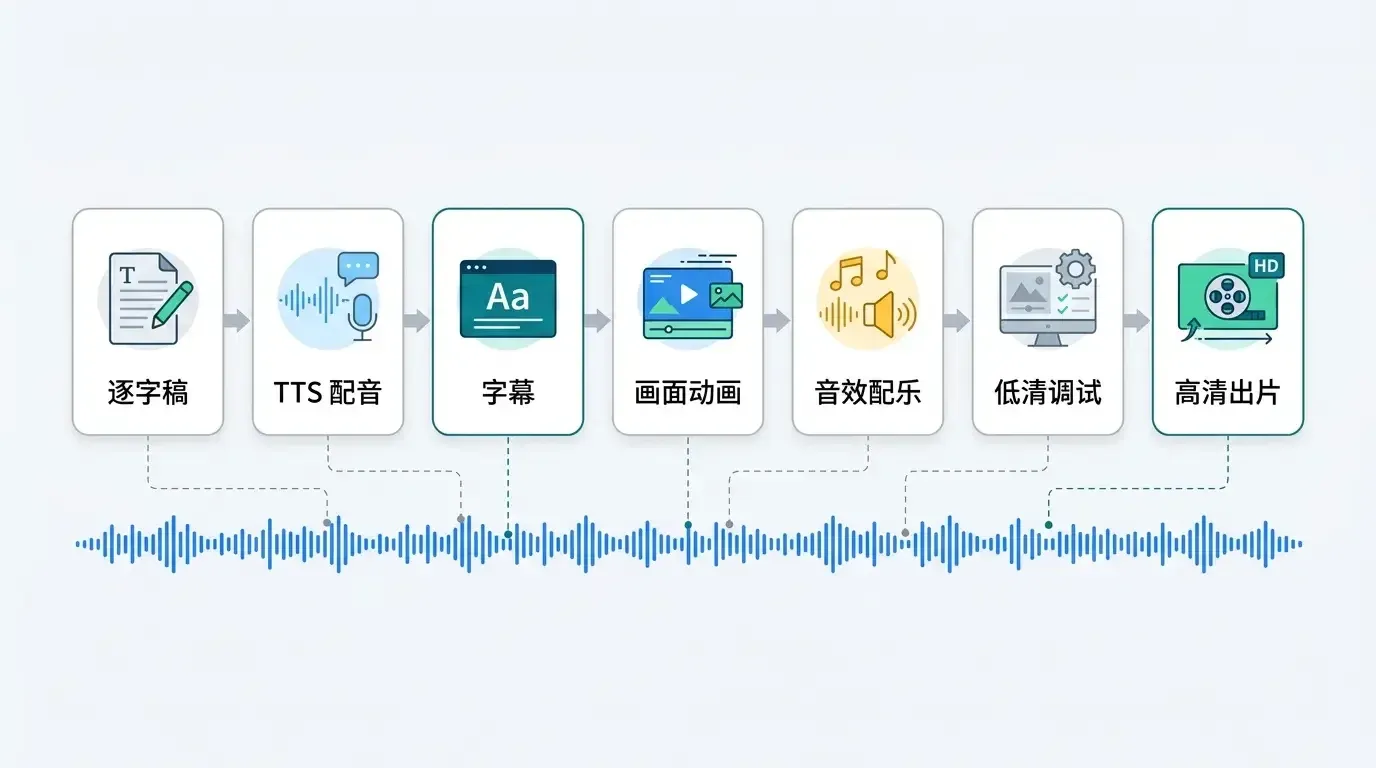
关键在第 3 步:字幕文件是整条视频唯一的时间基准。每个画面何时出现、动画何时开始、音效落在哪一拍,都对着字幕里的时间戳来定。这样一来,改一句文案只需重新配这一句、重新生成字幕,后面的画面会跟着新时间轴自动移位,不必推倒重来。
六个技能分别管什么
项目目前沉淀了六个 Skill,五个是视频模板,一个是基础工具:
| Skill | 定位 | 特点 |
|---|---|---|
talking-head-remotion |
口播视频 | 16:9 演播室风格,顶部章节进度,右下角圆形画中画,预留字幕安全区,带音效/BGM 规划和脚手架 |
wechat-article-remotion |
公众号文章转视频 | 输入 mp.weixin.qq.com 文章链接,原文图片按 contain 方式完整保留、不裁切 |
geometry-math-proof-remotion |
数学证明与几何动画 | 深色背景配高饱和色,SVG 绘图、公式逐步揭示,适合勾股定理、欧拉公式、算法可视化 |
paper-cutout-remotion |
纸片风分层动画 | 画面拆成背景、后排、主体、前景四层 PNG,各层按不同节奏运动,适合历史人物、科普 |
sketch-story-remotion |
手绘故事 | 火柴人、手绘箭头等图形全部由代码绘制,不依赖图片素材 |
audio-to-subtitles |
音频转字幕/逐字稿 | 输出 SRT、VTT、JSON,也支持先 TTS 再转字幕 |
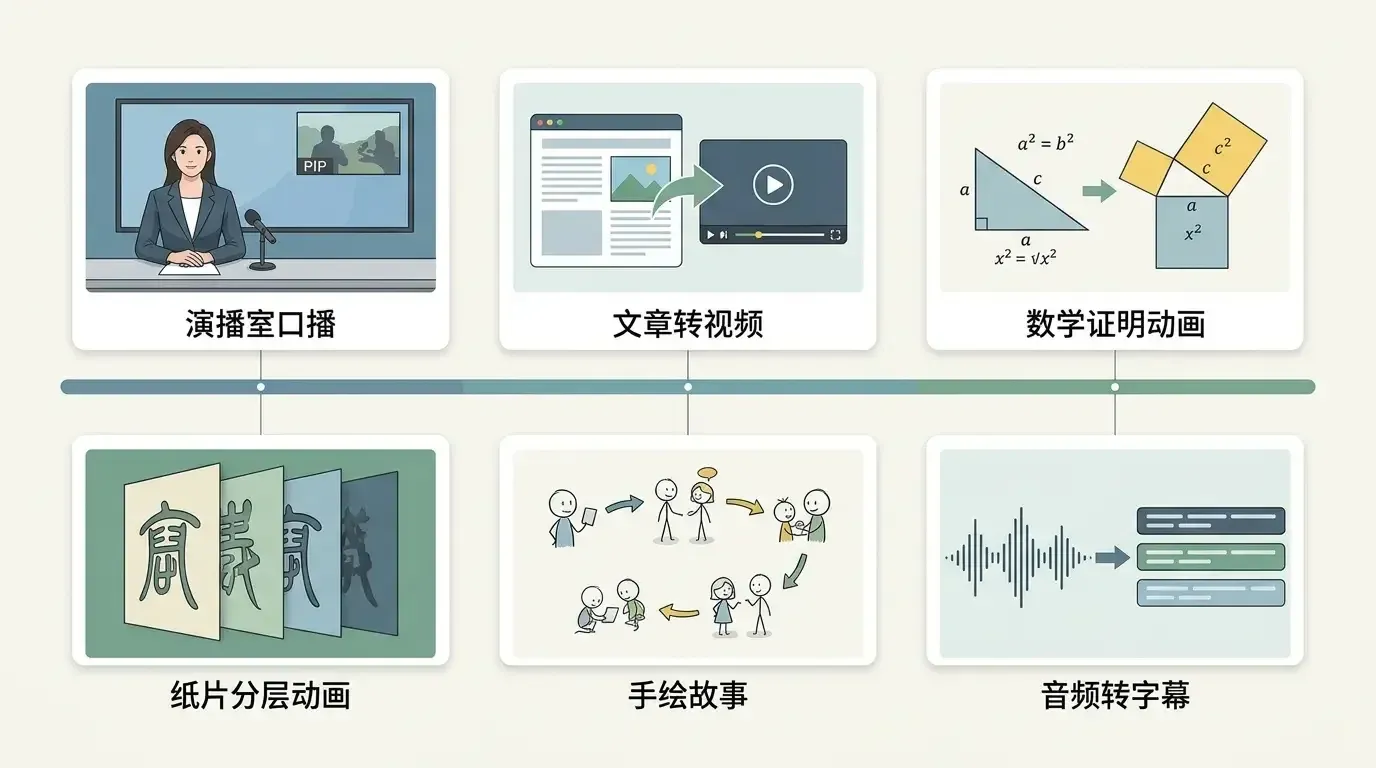
这几个技能可以单独用,也可以串成流水线。audio-to-subtitles 是整套方案的地基:它产出的字幕文件,正是其他五个模板驱动画面的时间轴。换句话说,模板决定"长什么样",字幕决定"什么时候动"。
上手:一条命令起工程
运行环境是 Node.js(原文介绍为 18 以上)加 Python 3。配音默认走 MiniMax,需要先按仓库里的 .env.example 配好 Key;audio-to-subtitles 还会调用外部服务,需要自己准备 MediaKit、R2 或 MiniMax 等 API 的环境变量,仓库里不含真实密钥。
以口播模板为例,先用脚手架生成工程,再装依赖、出一张静帧检查画面:
python3 skills/talking-head-remotion/scripts/scaffold_talking_head_remotion_project.py \
  --project-dir ./demo-talking-head \
  --title "Demo Talking Head"

cd demo-talking-head
npm install
npm run still
公众号转视频更直接,把文章链接交给抓取脚本:
python3 skills/wechat-article-remotion/scripts/fetch_article.py \
  --url "https://mp.weixin.qq.com/s/xxxxx" \
  --out-dir ./demo-wx-article
数学证明和手绘故事两个模板是复制模板工程后用 Remotion 出静帧:
cp -R skills/geometry-math-proof-remotion/templates/remotion-project ./demo-math-proof
cd demo-math-proof
npm install
npx remotion still src/index.ts Proof out/check.png
字幕工具则用 bun 运行:
SKILL_DIR="$(pwd)/skills/audio-to-subtitles"
npx -y bun "$SKILL_DIR/scripts/main.ts" audio.mp3 --language zh-CN --out-dir subtitles
注意每个模板都先 still 出一张图再说,这本身就是"先低成本验证、再正式渲染"的习惯。作者在 README 里也放了 B 站成片,包括公众号转视频、√2 是无理数的证明动画、苏东坡《赤壁怀古》的纸片动画,可以先看效果再决定要不要用。
Remotion 是什么,商用前要看什么
Remotion 是一个用 React 写视频的框架:每一帧就是一个 React 组件在某个时间点的渲染结果,动画写成"帧号到样式"的函数,最后由它调用浏览器逐帧截图、再编码成 MP4。好处是画面完全可编程,文字百分之百准确,改起来就是改代码;而且天生适合交给 AI Agent,因为 Agent 最擅长的正是写代码。
需要提醒的是授权问题。Remotion 不是常见的 MIT 这类宽松协议,个人和小团队可以免费使用,但达到一定规模的公司商用需要购买许可。商用前请看 Remotion 官方许可条款,按自己公司的情况判断。另外,video-skills-toolkit 仓库本身的许可证请以根目录的 LICENSE 文件为准。
我们的实践:同一套思路,不同的工具链
读到"以声音为轴"时,我们挺有共鸣,因为团队内部做产品发布宣传片,走的几乎是同一条路,只是没有用 Remotion。
我们的做法是让 Claude Code 写代码逐帧渲染:画面是 canvas 动画,用 Playwright 打开页面并行截帧,再用 ffmpeg 合成视频和音轨。整条流程大致是:
- 从发布文章里提炼 5~8 个卖点,写成分镜表,每句旁白都对应一个画面动作,而不是一页文字卡片;
- 用 edge-tts 配音,同时拿到逐字时间戳;遇到 edge-tts 不可用时换 MiniMax TTS,时间戳格式保持兼容;
- 根据旁白时长自动排时间轴,生成每一段的起止时间;
- 逐字时间戳同时驱动两件事:字幕气泡念到哪个字就点亮哪个字,讲解员小人的嘴型跟着音节开合;
- 场景代码里的动画时间全部引用段落时间(例如"第三段开始后 0.2 秒"),不写死秒数;
- 配乐的拍点对齐切场点,音效挂在关键动作上,人声出现时自动压低背景音乐。
第 5 条和 video-skills-toolkit 的思路是一回事:时间只从声音里来。实际效果是,改一句文案只要重配这一段、重排时间轴,动画会自动跟着走,前后的镜头都不用动。我们早期试过先做画面再配音,每次改词都要手工挪关键帧,后来就彻底改成了这种做法。
两套方案的对照:
| 维度 | video-skills-toolkit | 我们的代码渲染流程 |
|---|---|---|
| 渲染底座 | Remotion(React) | canvas + Playwright + ffmpeg |
| 时间基准 | 字幕文件(SRT/VTT/JSON) | TTS 逐字时间戳 |
| 配音 | MiniMax | edge-tts,备选 MiniMax |
| 模板方向 | 口播、文章转视频、数学、纸片、手绘 | 卡通讲解员宣传片,横竖屏两版 |
| 授权 | 需关注 Remotion 许可 | 全部开源组件,无额外授权费 |
低清调试再高清出片,省的是什么
项目建议先低清出样片、确认后再高清渲染,这条经验看着朴素,对 AI 参与的流程却格外重要。
一是渲染时间。逐帧渲染的耗时和分辨率、帧数近似成正比。一支一分钟的片子,30 帧就是 1800 帧,高清全量渲染一次要几分钟到十几分钟;而 AI 写出来的动画第一版几乎不可能完美,通常要改好几轮。每轮都全量高清渲染,时间成本会翻好几倍。
二是判断成本。我们的经验是,大部分问题在低清样片甚至几张抽帧截图里就能看出来:元素有没有遮挡、字够不够大、动作有没有踩在对应的字上。我们会先按时间点抽十几帧拼成一张联系表来检查,确认前两幕没问题再出完整片,方向错了也只损失几分钟。
三是接入付费服务时的费用。如果流程里用到了按次计费的 TTS 或生图接口,先把文案和分镜在低成本阶段定稿,可以避免反复调用带来的额外开销。
适合谁,不适合谁
这条"Skill 化 + 代码渲染"的路线有明确的长板和短板。
比较适合的场景:
- 批量、同构的内容:系列课程、产品功能讲解、内部培训、公众号文章二次分发,一套模板反复套用;
- 对文字准确性要求高:数学公式、代码、产品名、版本号,代码绘制不会出现 AI 生图常见的错字;
- 需要频繁修改:文案常调整,以声音为轴的结构能把返工限制在局部;
- 团队有一点前端能力:出了问题能看懂 React 或 canvas 代码,自己修。
不太适合的场景:
- 写实画面或真人表演:代码渲染做的是图形、动画、版式,做不了电影质感的实拍镜头,这类需求更适合视频生成模型;
- 流畅的角色动作戏:多角色、连续肢体动作的动画剧,靠代码一帧帧写成本很高,效果也很难自然;
- 一次性、无复用的短片:只做一条的话,搭模板的投入未必划算。
总结
video-skills-toolkit 本身不算复杂,六个 Remotion 模板加一个字幕工具,但它示范了两件值得借鉴的事:一是把视频制作拆成 AI 可以逐个执行的技能,让 Agent 真正动手,而不是只给出"如何制作视频"的说明;二是用字幕或逐字时间戳作为整条时间线的唯一基准,所有画面、动画、音效都对着它来排。
我们在自己的宣传片流程里走的也是同一条路,体会最深的是:以声音为轴之后,改文案不再意味着重做。如果你所在的团队需要批量产出讲解类、培训类视频,可以把这个仓库克隆下来跑一遍,挑一个最接近需求的模板改起来;如果打算商用,记得先确认 Remotion 的许可条款。
本文为 JeecgBoot AI 专题研究系列文章。