JeecgBoot AI专题研究 | 可验证推理(Provable Inference)原理、实测数据与开发者自检指南
一个绕不开的问题:你买到的真是那个模型吗
做 AI 应用的团队,十有八九都通过第三方渠道调用过大模型:聚合平台、API 中转站、云厂商的托管服务。价格便宜、支付方便、网络稳定,这些都是实打实的好处。但随之而来的是一个很难回答的问题——页面上写着旗舰模型,后台跑的到底是不是它?
在实际开发中,我们碰到过不少"玄学"现象:
- 同一段提示词,官方控制台一次就做对,换成中转接口却反复卡壳;
- 平时表现稳定的模型,某段时间突然"变笨",过几天又恢复;
- 输出风格、长度、拒答率和官方明显对不上,但又拿不出证据。
请求链路是"用户 → 中转站 → 上游服务商 → 模型",中间任何一环不透明,用户都只能看到最终一段文字。换成便宜的小模型、旧版本模型,或者偷偷压低精度,单看回答几乎没法下结论。
这不是凭空猜测。斯坦福的研究项目《Model Equality Testing》在 2024 年抽查了四款 Llama 模型的 31 个商业 API 端点,发现其中 11 个端点的输出分布与 Meta 发布权重的参考分布存在统计意义上的差异。
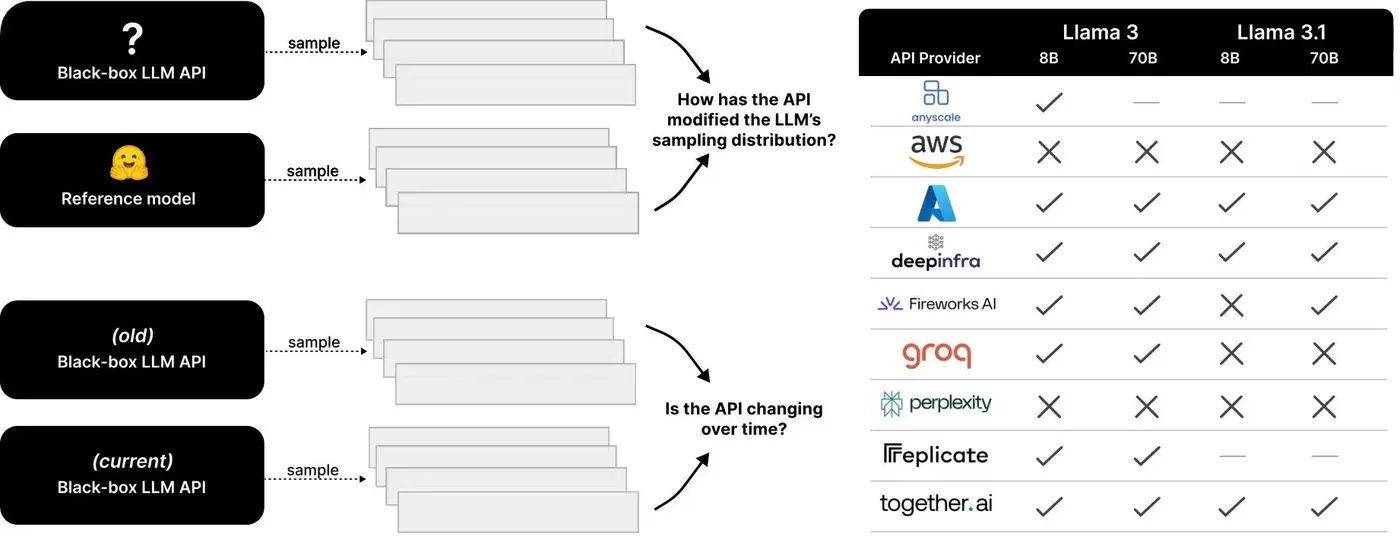
以往大家鉴别模型,靠的是"考题法":问一个只有新模型才知道的知识点,答不上来就判定是假货。但这种方法很脆弱——碰巧答错、采样参数不同、上下文被截断、厂商自己做了路由,最后都表现成一句"怎么变笨了",根本定位不到原因。
Anthropic 最近公开的一项研究,想把这个靠口碑和截图争论的问题,变成一个可以用数学验证的问题。研究地址:https://www.anthropic.com/research/provable-inference
FlashProve 是什么
FlashProve 是 Anthropic 开源的研究原型,目标是为大模型推理生成密码学证明:服务商给出回答的同时附上一份证明,用户不需要拿到模型权重,也不需要自己再跑一遍大模型,就能确认"这段输出确实是那套指定权重算出来的"。
它的底层技术是 zkSNARK(零知识简洁非交互式知识论证)。名字很长,拆开理解就是三件事:证明体积小、验证速度快、验证过程不泄露秘密。
工作流程:承诺、证明、验证
整个过程可以分成三步:
- 权重承诺(离线一次):服务商对模型权重计算出一个"承诺",相当于一枚密码学指纹,能唯一锁定这套权重,但不会暴露权重本身;
- 生成证明(在线):针对用户的输入和模型给出的输出,服务商生成一份证明,说明"这些输出符合事先承诺的那套模型的计算";
- 本地验证:用户手里有模型承诺、提示词、回答和证明文件,在自己电脑上就能核验——被锁定的权重处理这段输入,是否确实会得到这段输出。
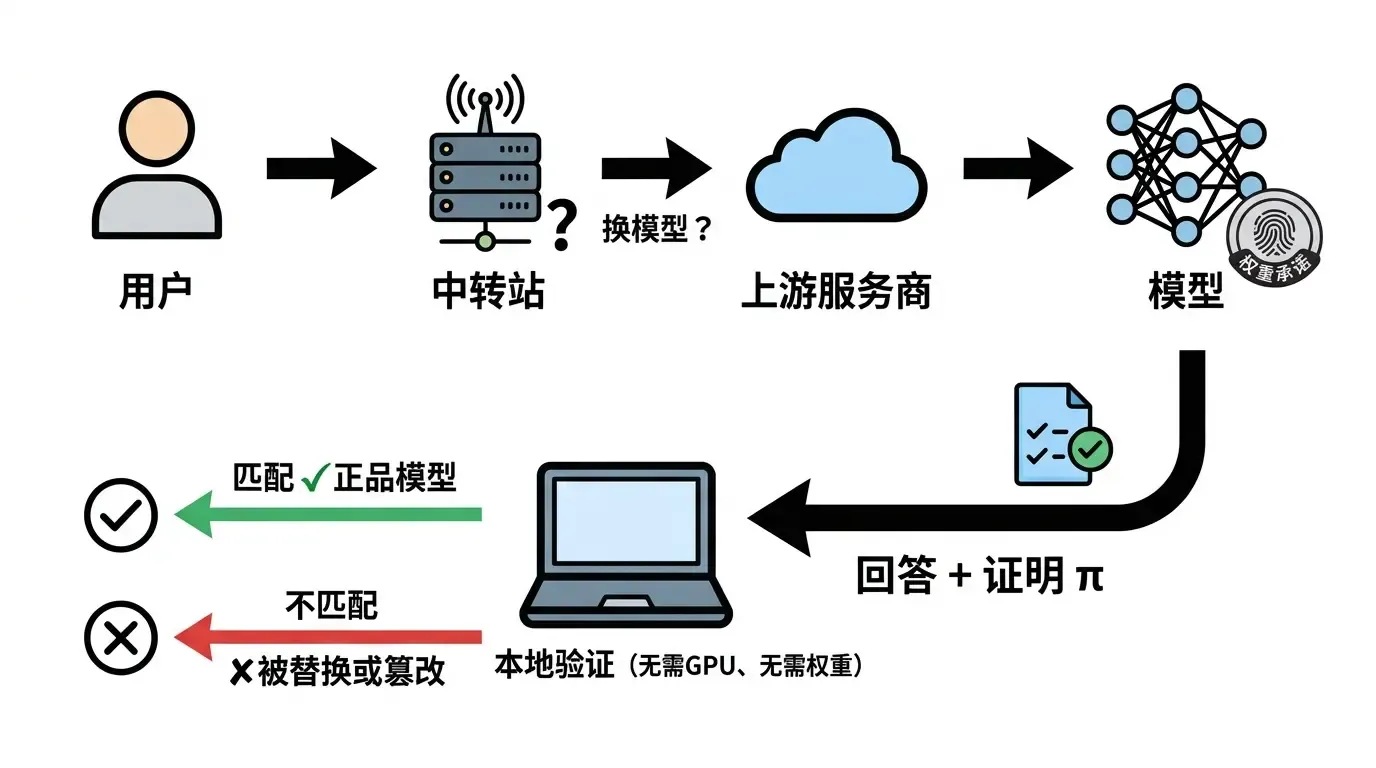
如果中转站把模型换掉了,或者有人篡改了输出,证明就无法与原来的模型承诺对上,验证直接失败。
四个关键性质
一套合格的证明系统需要同时满足四个条件:
| 性质 | 含义 |
|---|---|
| 完备性 | 诚实的证明者对真实结果给出的证明,一定能通过验证 |
| 可靠性 | 伪造的证明除了可忽略的概率外,必然被识破 |
| 简洁性 | 证明很小、验证很快,不需要权重也不需要 GPU |
| 零知识 | 证明不会泄露任何权重信息 |
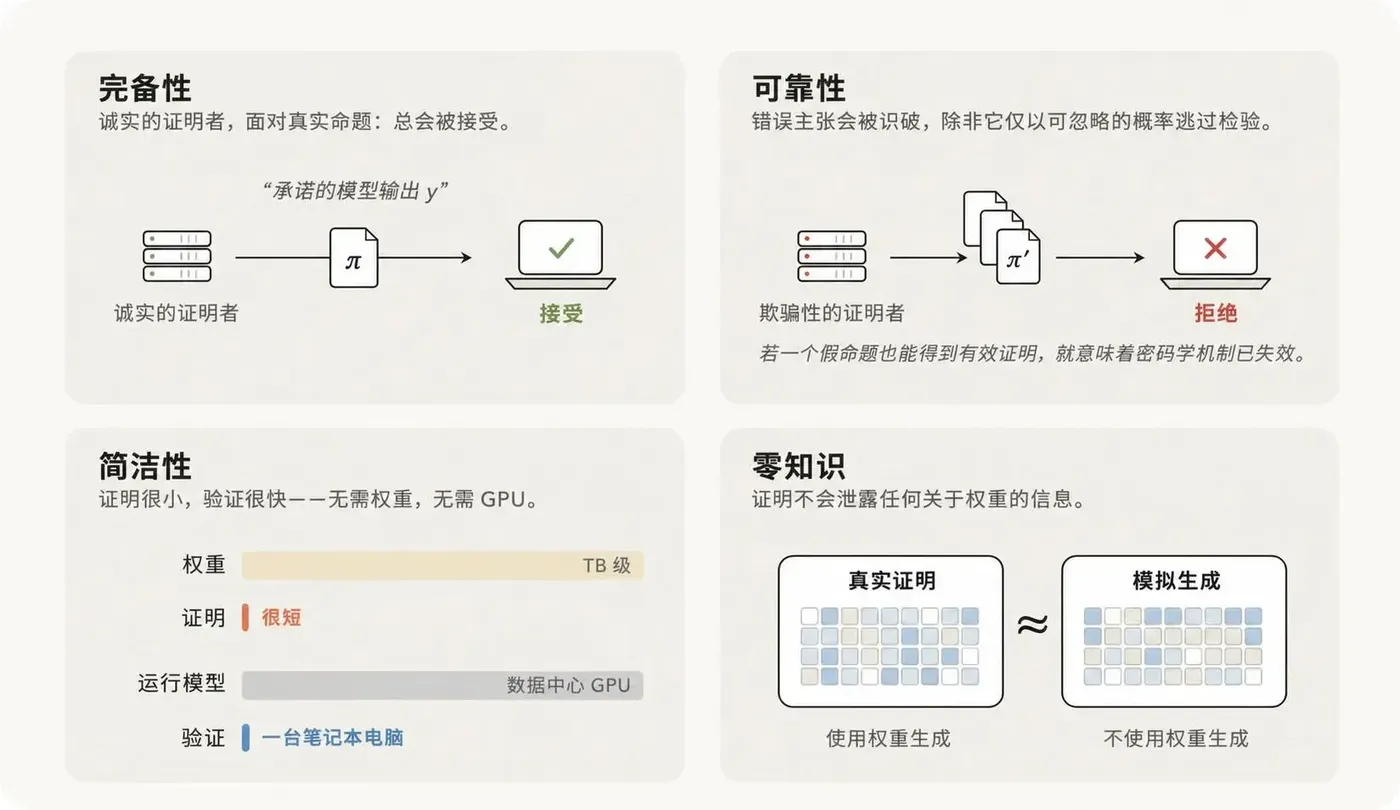
其中"零知识"对模型厂商尤其关键:验证者确认了计算结果,却拿不到权重、中间激活值,对于 MoE 模型也看不到每一层到底路由到了哪些专家。这让闭源模型厂商也有可能参与进来,而不必担心核心资产外泄。
这也是它比"让模型自报家门"靠谱的根本原因——回答里自称什么模型不再重要,验证的是输出与指定权重之间的计算关系。
实测数据:一台笔记本就能验
过去零知识证明用在大模型上,最大的障碍是成本:生成证明比正常推理慢几个数量级,证明文件动辄巨大。FlashProve 的实验把这个门槛拉低了很多。
Anthropic 选用公开 4-bit 权重的 Llama 4 Maverick 做实验,这是一个 4000 亿参数的混合专家模型,每个 token 实际激活约 170 亿参数。公布的数据如下:
| 指标 | 数值 |
|---|---|
| 证明生成吞吐(单张 H100) | 约 110 tokens/秒 |
| 证明大小(每个 1,024-token 请求) | 约 19 MB |
| 验证耗时(24 线程 CPU) | 约 17 秒,不需要 GPU |
| 验证耗时(单线程) | 约 21 秒 |
| 权重初始承诺 | 只需生成一次,约 39 分钟 |
| 证明的 GPU 时间成本 | 约为普通 vLLM 推理的 70~95 倍 |
需要注意:110 tokens/秒指的是证明生成速度,不是用户聊天时看到的出字速度。
事后证明:不拖慢用户
如果每生成一个 token 就同步做一次证明,证明者会和推理引擎争抢显存和带宽,用户要等很久才能看到回复。FlashProve 的思路是把证明移出关键路径:推理 GPU 照常生成并立即返回回答,然后由独立的证明 GPU 对整段回复一次性生成证明。
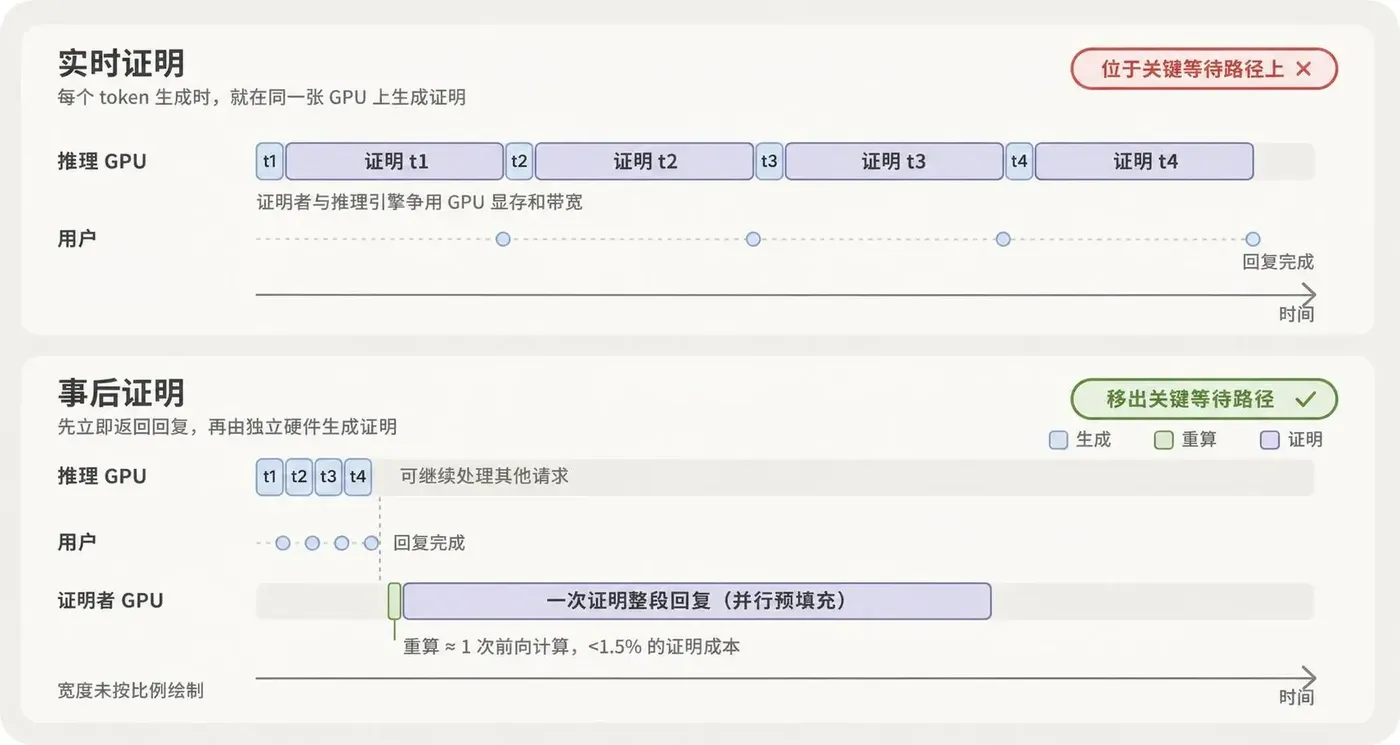
这样用户体验基本不受影响,代价是证明会晚一些才拿到。对于审计、抽检、争议仲裁这类场景,晚几分钟拿到证明完全可以接受。
70~95 倍的 GPU 成本当然不便宜,现阶段不可能给每一次调用都附带证明。但从"根本做不了"到"花钱能做、普通电脑能验",这已经是质的变化。
冷静看待:它解决不了什么
前提:你得知道正品的指纹
FlashProve 能证明的是"这段输出来自承诺 X 对应的模型"。如果中转站拿出一份有效证明,但证明对应的是它自己挑的模型 B,而你无法确认 B 就是你买的 A,那这份证明并不能解决身份问题。
所以真正落地需要一个可信的模型承诺发布机制:由模型厂商、第三方机构或公开的登记系统发布官方指纹,用户验证时固定比对这个指纹。只有这样,验证的含义才能从"某次计算确实发生过"升级为"我付费买的那次计算确实发生过"。
"降智"不只是换模型
即便权重确认无误,体验变差仍可能有别的原因:
- 系统提示词被修改或追加了限制;
- 安全策略调整,拒答变多;
- 上下文被截断、检索内容不同;
- 量化方式、解码参数(temperature、top_p 等)被改动。
这些都不在"权重是否一致"的范围内。Kimi 团队在介绍 Kimi Vendor Verifier 时就提到,K2 Thinking 发布后社区反馈的不少跑分异常,排查下来相当一部分来自解码参数误用,后来他们在 Thinking 模式下约束了相关参数,并检查思考内容是否被正确回传。
换句话说,一份绑定权重的证明,回答不了所有产品层面的问题。
产业链要有人先迈步
对中转服务来说,接入证明需要上游配合:持有权重的厂商或运营方先建立可信承诺、生成证明,中转平台再把证明转交给用户。在成本降下来、上下文支持更长、覆盖真实推理配置之前,这还停留在研究阶段。
和其他方案比一比
验证"远端到底跑了什么"并不是只有零知识证明一条路,几种思路各有侧重:
| 方案 | 思路 | 优点 | 局限 |
|---|---|---|---|
| 考题 / 指纹问答 | 用特定问题探测模型知识 | 零成本、随手可做 | 易受采样和路由干扰,结论不可靠 |
| 统计分布检验 | 大量采样,与参考模型的输出分布对比 | 不需要服务商配合 | 需要大量调用,只能发现差异、难以定责 |
| 可信执行环境(TEE) | 推理在硬件隔离环境中运行,并出具远程证明 | 性能损耗相对小 | 需要信任硬件厂商,依赖特定硬件 |
| 零知识证明(FlashProve) | 为每次计算生成密码学证明 | 数学上可验证,不泄露权重 | 证明成本高,需要可信的承诺发布机制 |
这几种手段并不互斥。现实中更可能出现的是组合方案:日常用统计检验和抽样监控发现异常,出现争议时再调取密码学证明。
写给开发者:在证明普及之前怎么自检
FlashProve 离大规模商用还有距离,但通过中转渠道调模型的团队,现在就可以做一些低成本的防护:
- 建立基线:挑 20~50 道覆盖代码、推理、长文本的固定测试题,分别在官方接口和中转接口上跑,记录正确率、平均输出长度和耗时;
- 固定参数:测试时显式指定 temperature、max_tokens 等参数,排除默认值不同带来的干扰;
- 定期回归:把基线测试做成定时任务,每周跑一次,指标明显下滑就报警;
- 核对用量:对比接口返回的 token 用量与本地分词估算,差距过大要警惕;
- 关键业务走官方:涉及生产数据、合规要求的核心链路,优先直连官方或有正规合同的云厂商,中转只用于开发调试。
这些方法证明不了什么,但能让"感觉变笨了"变成一组可以比较的数字,出了问题也有据可查。
总结
Anthropic 这次同时开源了代码、技术报告和 Lean 形式化证明,据介绍 Claude 还参与了系统的构建与优化,部分协议文档和代码也由 AI 生成。FlashProve 把"模型有没有被掉包"从凭感觉吵架,推进到了可以拿证明说话的阶段:单张 H100 约 110 tokens/秒生成证明,19 MB 的证明文件在普通 CPU 上十几秒就能验完。
它不会立刻终结"是不是偷偷降智"的争论——系统提示词、解码策略、产品设计的变化,依然需要别的手段去核查;高昂的证明成本和缺位的承诺发布机制,也决定了它短期内只会出现在审计、评测和监管场景。但方向已经很清楚:我们花钱买指定模型的服务,确认自己拿到的确实是它,本来就不该靠猜。
对正在构建 AI 应用的团队来说,眼下能做的是把模型质量监控纳入工程体系;等到主流厂商开始提供可验证推理,再把证明校验接进来,就是水到渠成的事。
本文为 JeecgBoot AI 专题研究系列文章。