摘要:Hive 支持 ARRAY、MAP、STRUCT、UNIONTYPE 四类复杂数据类型,是存储 JSON、嵌套日志、用户画像等半结构化数据的关键。本文用一个「用户画像」案例,讲清它们的声明方式、取值语法、加载与展开查询,并给出使用边界与避坑建议。
关键词:Hive 复杂数据类型, ARRAY, MAP, STRUCT, UNIONTYPE, LATERAL VIEW explode, JSON SerDe, 嵌套结构
在 Hive 里,除了 INT、STRING、DOUBLE 这类基本类型,还有一类容易被忽视但极其好用的复杂数据类型:ARRAY、MAP、STRUCT,以及极少用到的 UNIONTYPE。当我们要落地 JSON、埋点日志、用户画像这类半结构化数据时,它们能让我们少建很多表、少写很多 ETL。
本文用一个贯穿全篇的「用户画像」案例,把四种类型的声明、取值、加载、展开查询一次讲透。
一、四大复杂类型速览
先建立整体印象,后面再逐个拆解。
| 类型 | 声明示例 | 取值方式 | 典型场景 |
|---|---|---|---|
| ARRAY | ARRAY<STRING> |
arr[0](0 基) |
标签、多值字段(爱好、分类) |
| MAP | MAP<STRING,STRING> |
m['key'] |
稀疏属性、维度 KV |
| STRUCT | STRUCT<name:type,...> |
s.field |
嵌套对象(地址、联系人) |
| UNIONTYPE | UNIONTYPE<int,string> |
极少用 | 异构值(支持有限) |
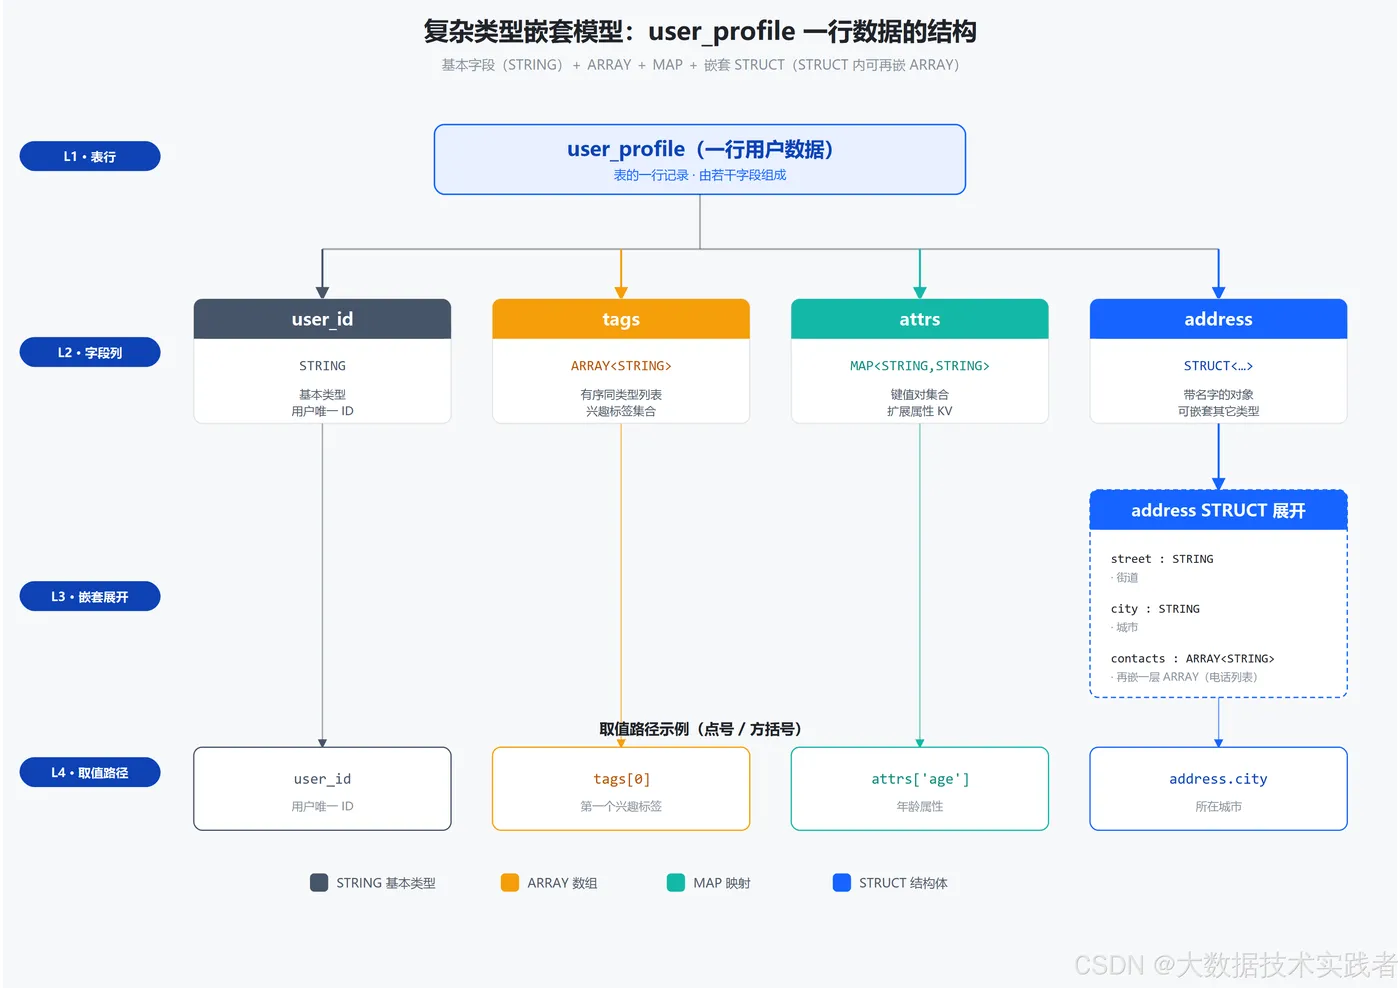
一句话记忆:ARRAY 是有序列表、MAP 是键值对、STRUCT 是带名字的对象,三者都能任意嵌套。
二、ARRAY:有序的同类型列表
ARRAY 存放「同一类型的多个值」,按下标访问,下标从 0 开始,越界返回 NULL。
CREATE TABLE user_tags (
  user_id STRING,
  tags    ARRAY<STRING>
)
ROW FORMAT DELIMITED
FIELDS TERMINATED BY '\t'
COLLECTION ITEMS TERMINATED BY ',';   -- 集合内元素用逗号分隔

-- 取第一个标签、统计标签数
SELECT user_id, tags[0] AS first_tag, size(tags) AS tag_cnt
FROM user_tags;
常见场景:用户的兴趣标签、商品类目、近 N 天的访问日期。注意 COLLECTION ITEMS TERMINATED BY 默认是 ^B(ASCII 2),生产里常改成逗号、竖线等可读分隔符。
三、MAP:灵活的键值对
MAP 存「键到值的映射」,键必须是基本类型,值任意。适合字段稀疏、列不固定的属性,比如用户扩展维度。
CREATE TABLE user_attrs (
  user_id STRING,
  attrs   MAP<STRING,STRING>
)
ROW FORMAT DELIMITED
FIELDS TERMINATED BY '\t'
COLLECTION ITEMS TERMINATED BY ','
MAP KEYS TERMINATED BY ':';          -- 键值之间用冒号分隔

-- 取年龄、列出所有键
SELECT user_id,
       attrs['age']        AS age,
       map_keys(attrs)     AS all_keys
FROM user_attrs;
取值时键不存在返回 NULL,不会报错——这正是 MAP 比「堆一堆 col1/col2/col3 列」更安全的地方。
四、STRUCT:带字段名的嵌套对象
STRUCT 像一个「内嵌的小表」,字段各有自己的名字和类型,用点号访问。最适合表达地址、联系人这种「成组出现」的对象。
CREATE TABLE user_addr (
  user_id STRING,
  addr   STRUCT<street:STRING, city:STRING, zip:STRING>
);

SELECT user_id, addr.city, addr.zip
FROM user_addr;
五、综合案例:一张用户画像表
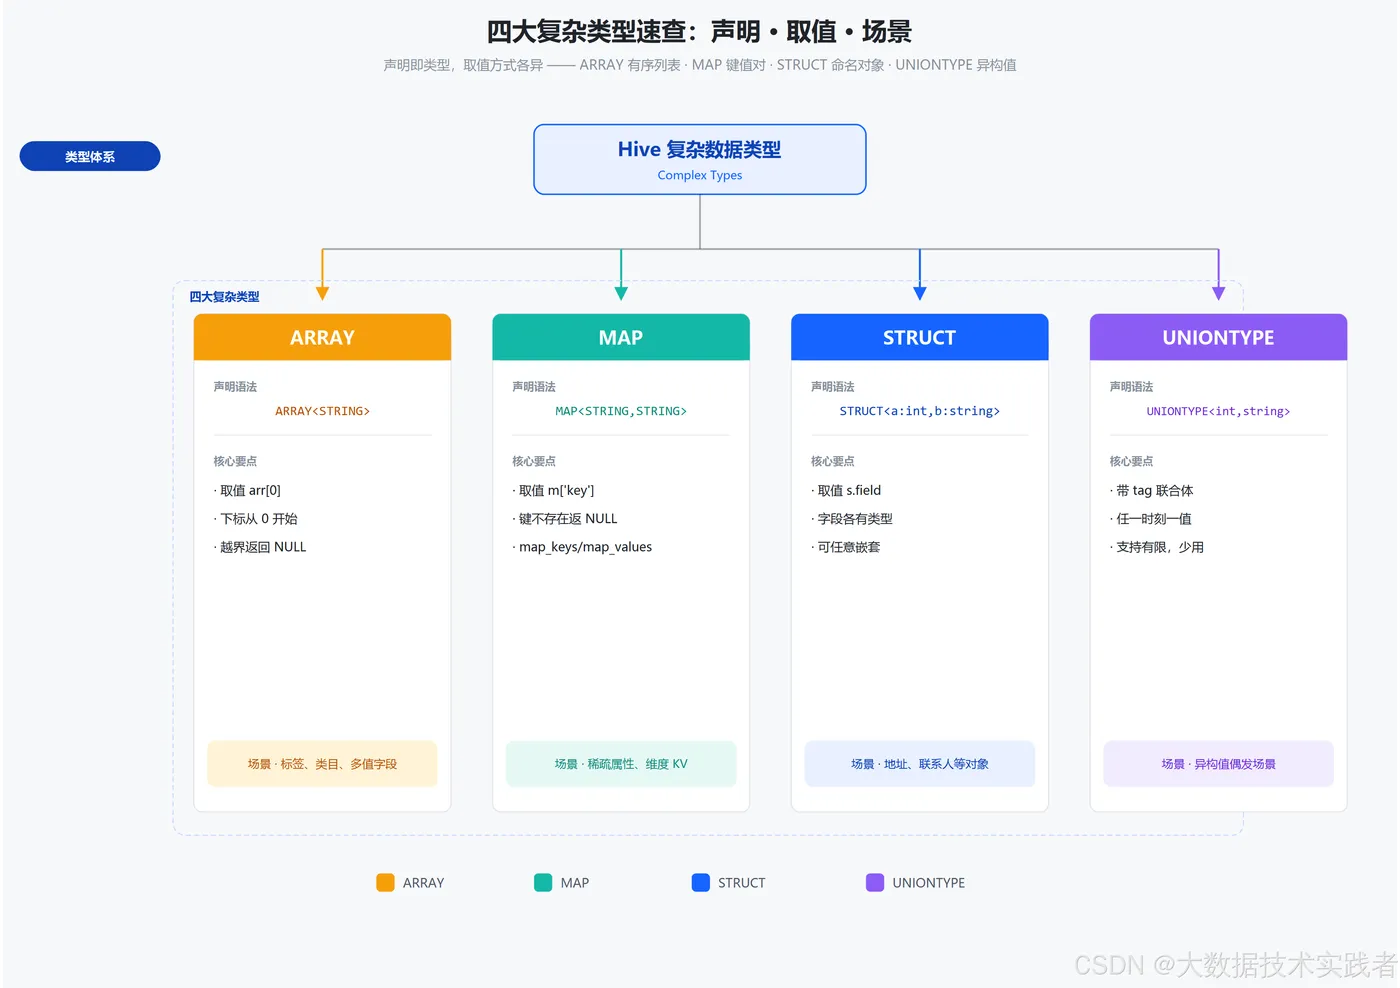
把上面三种类型组合起来,就是真实世界里最常见的「用户画像」结构——基本字段 + 标签数组 + 扩展 MAP + 嵌套地址 STRUCT,而地址里还能再嵌一个电话数组。
CREATE TABLE user_profile (
  user_id  STRING,
  name     STRING,
  tags     ARRAY<STRING>,                     -- 兴趣标签
  attrs    MAP<STRING,STRING>,                -- 扩展属性
  address  STRUCT<                            -- 嵌套对象
             street:STRING,
             city:STRING,
             contacts:ARRAY<STRING>>           -- STRUCT 里再嵌 ARRAY
)
ROW FORMAT DELIMITED
FIELDS TERMINATED BY '\t'
COLLECTION ITEMS TERMINATED BY '|'
MAP KEYS TERMINATED BY ':';
对应的嵌套结构与取值路径如下,建议对照图理解:
取值示例:
tags[0]→ 第一个兴趣标签attrs['age']→ 年龄属性address.city→ 所在城市address.contacts[1]→ 第二个联系电话
六、怎么把数据写进去:文本 vs JSON
上面用 ROW FORMAT DELIMITED 处理「扁平分隔文本」,靠一堆分隔符拼出嵌套结构,可读性差、容易错。
更推荐的写法是用 JSON SerDe——源数据本来就是 JSON,一行一个对象,Hive 自动映射嵌套层级:
CREATE TABLE user_profile_json (
  user_id  STRING,
  tags     ARRAY<STRING>,
  attrs    MAP<STRING,STRING>,
  address  STRUCT<street:STRING, city:STRING,
                  contacts:ARRAY<STRING>>
)
ROW FORMAT SERDE 'org.apache.hive.hcatalog.data.JsonSerDe';
导入原始 JSON 即可,无需关心分隔符。第三方还有 org.openx.data.jsonserde.JsonSerDe,功能更全(支持把 NULL、坏数据映射成 NULL)。
七、怎么查出来:LATERAL VIEW explode
复杂类型把多值「挤」进了一行,但分析时往往要拍平。ARRAY / MAP 用 explode 配合 LATERAL VIEW 展开成多行:
-- 把每个用户的标签拆成多行
SELECT u.user_id, t.tag
FROM user_profile u
LATERAL VIEW explode(u.tags) t AS tag;

-- MAP 展开:一行变「键、值」两列
SELECT u.user_id, kv.key, kv.value
FROM user_profile u
LATERAL VIEW explode(u.attrs) kv AS key, value;
explode 会「炸开」集合;LATERAL VIEW 让炸出的行与原表的其它列横向关联,不丢上下文。没有 LATERAL VIEW 时,一个 explode 无法直接和原表其它普通列共存。
八、实践建议
- 能扁平就扁平:纯分析型宽表优先用基本类型拆列,复杂类型会拖慢谓词下推和列式存储压缩比。
- 半结构化才上复杂类型:JSON 日志、动态属性、稀疏字段——这些场景复杂类型能省大量 ETL。
- 取值要防 NULL:ARRAY 越界、MAP 缺键都返回 NULL,统计前用
nvl()兜底。 - UNIONTYPE 谨慎用:支持有限、语义晦涩(带 tag 的联合体),仅在确需「一字段多类型」时考虑。
- 优先 JSON SerDe:源是 JSON 时,SerDe 比手工分隔符更稳、更易维护。
小结
ARRAY/MAP/STRUCT 三兄弟让 Hive 能原生表达嵌套与半结构化数据:ARRAY 管有序列表、MAP 管 KV、STRUCT 管命名对象,三者可任意嵌套。配合 JSON SerDe 加载、LATERAL VIEW explode 展开,再也不用为了一个 JSON 拆出十几张表。掌握它们,你的 Hive 表设计会从容很多。