
一文打通从模型选型到生产上线的全链路,让你在阿里云百炼大模型服务平台页面上,以最优成本撬动最强 AI 生产力。
一、为什么是 Qwen3.8-Max?为什么必须看这篇文档?
当 AI 应用从"玩具级问答"迈入"工程级生产力"时代,普通模型已难堪大任。你需要的,是一款能吞下百万字长文档、能看懂截图视频、能自主拆解复杂任务、能连续调用数十轮工具而不跑偏的旗舰基座。Qwen3.8-Max,正是为此而生。
它采用第三代稀疏混合专家 MoE 架构,总参数 2.4 万亿,推理时仅激活 950 亿参数——既有擎天之力,又有绣花之巧。原生支持百万 Token 上下文窗口,原生多模态输入输出,内置深度思考链路,覆盖编程、科研、法律、金融、视频分析、长周期 Agent 任务全场景。
而这一切,都可以通过阿里云百炼大模型服务平台页面一站式接入。本文将从核心功能拆解、Agent 能力详解、计费体系精算、API 配置实操、业务落地避坑五大维度,为你铺就一条从零到生产的完整路径。
二、模型核心功能与技术架构深度拆解
2.1 MoE 架构:大而不慢的秘密
Qwen3.8-Max 采用稀疏混合专家 MoE 架构搭配自研混合注意力机制,总参数量高达 2.4 万亿,却在推理阶段通过路由控制器动态选择相关专家网络参与计算,单次推理仅激活 950 亿参数。这意味着——你获得了万亿级模型的推理质量,却只承担百亿级模型的推理开销。
对比前代版本,三大模块完成重大升级:
- 混合注意力机制优化:长文本跨段落关联理解能力提升 40%;
- 专家路由算法迭代:复杂任务场景专家模块匹配准确率提升 25%;
- 推理引擎重构:推理速度提升 30%,同等任务 Token 消耗下降 30%。
模型调用 ID 固定为 qwen3.8-max,同时提供快照版本 qwen3.8-max-0902 用于版本锁定。生产环境务必指定快照版本,防止后台模型迭代引发业务逻辑异常。这些模型详情均可在阿里云百炼大模型服务平台页面上查阅和配置。
2.2 百万 Token 上下文:一页不拆,全篇通读
原生支持最高 100 万 Token 上下文窗口,等效约 75 万字文本。你可以一次性载入 300 页 PDF 合同、百万行完整项目源代码、数十小时视频字幕文本。完整加载原始素材,无需人工拆分文档片段,规避分段带来的信息丢失与逻辑断裂。
依托超大上下文能力,长文档事实幻觉错误率下降 60%,能够追踪跨章节、跨多份文档之间的逻辑关系,完美适配法律卷宗审核、完整项目代码库分析、整本专业技术书籍解读等高要求业务。打开阿里云百炼大模型服务平台页面,在模型广场即可查看 Qwen3.8-Max 的完整参数规格。
2.3 双推理模式:快慢随心,成本可控
模型内置深度思考/极速双推理模式,reasoning_effort 参数可选 none/minimal/low/medium/high/xhigh 六档:
| 模式 | 特点 | 适用场景 |
|---|---|---|
| 极速模式(low) | 响应速度提升 50%,Token 消耗下降 30% | 简单问答、内容摘要、批量轻量化生成 |
| 深度思考模式(xhigh) | 输出完整内部思考过程,推理严谨度大幅提升 | 复杂数学推导、多步骤业务拆解、法律条文分析 |
关键提醒:开启思考模式会额外消耗大量输出 Token(深度思考模式最大思维链长度 262144 Token),直接拉高计费开销。简单对话业务建议关闭,仅复杂任务按需开启。在阿里云百炼大模型服务平台页面的模型详情页中,可以清晰看到各档位的 Token 消耗对比。
2.4 原生多模态:看图、读视频、解文档
Qwen3.8-Max 不依赖外部辅助模型,直接接收图片、视频、PDF、Excel 等多种格式输入:
- 图像:解析截图、工程图纸、报表图表、手写文档,UI 截图直接转前端代码;
- 视频:解析长视频内容,提取关键帧,输出视频摘要、事件梳理;
- 文档:直接解析 PDF、Word、Excel,提取表格、文本,完成合同审阅、报表分析;
- 视觉反馈闭环:生成代码/方案后,再次传入截图校验,识别偏差自动迭代优化。
2.5 全套工具能力:不只是"会说",更会"会做"
- Function Calling 函数调用
- 强制结构化 JSON 输出
- 内置代码解释器、网页提取工具、联网检索
- 前缀续写、上下文缓存
- Batch 批量异步推理
上下文缓存是该模型非常关键的成本优化特性:针对重复不变的系统提示词、知识库公共前缀做缓存,缓存命中后输入 Token 计费仅原价的 10%(缓存命中读取输入 1.5 元/百万 Tokens),在 Agent 循环对话、知识库问答场景可显著减少推理开销。但请注意,如果每轮请求全部内容都在变化,缓存几乎无法命中,开启缓存反而会产生创建开销。生产环境判断缓存是否生效,不要只看 API 返回字段,以百炼控制台账单缓存计费明细为准。这些配置参数均可在阿里云百炼大模型服务平台页面的 API 文档区详细查看。
三、多模态 Agent 能力详解:让 AI 成为你的"数字员工"
3.1 长周期自主 Agent:从规划到执行的完整闭环
Qwen3.8-Max 原生支持 MCP 多智能体协作协议,收到复杂业务目标时,可以自主拆解多级子任务,形成 "规划→执行→校验→优化" 闭环:
- 任务拆解:将复杂目标分解为可执行的子步骤;
- 工具调用:自主调用联网搜索、代码执行、文件读写等工具;
- 结果校验:评估执行结果是否符合预期;
- 迭代修正:不符合则自动调整策略重新执行。
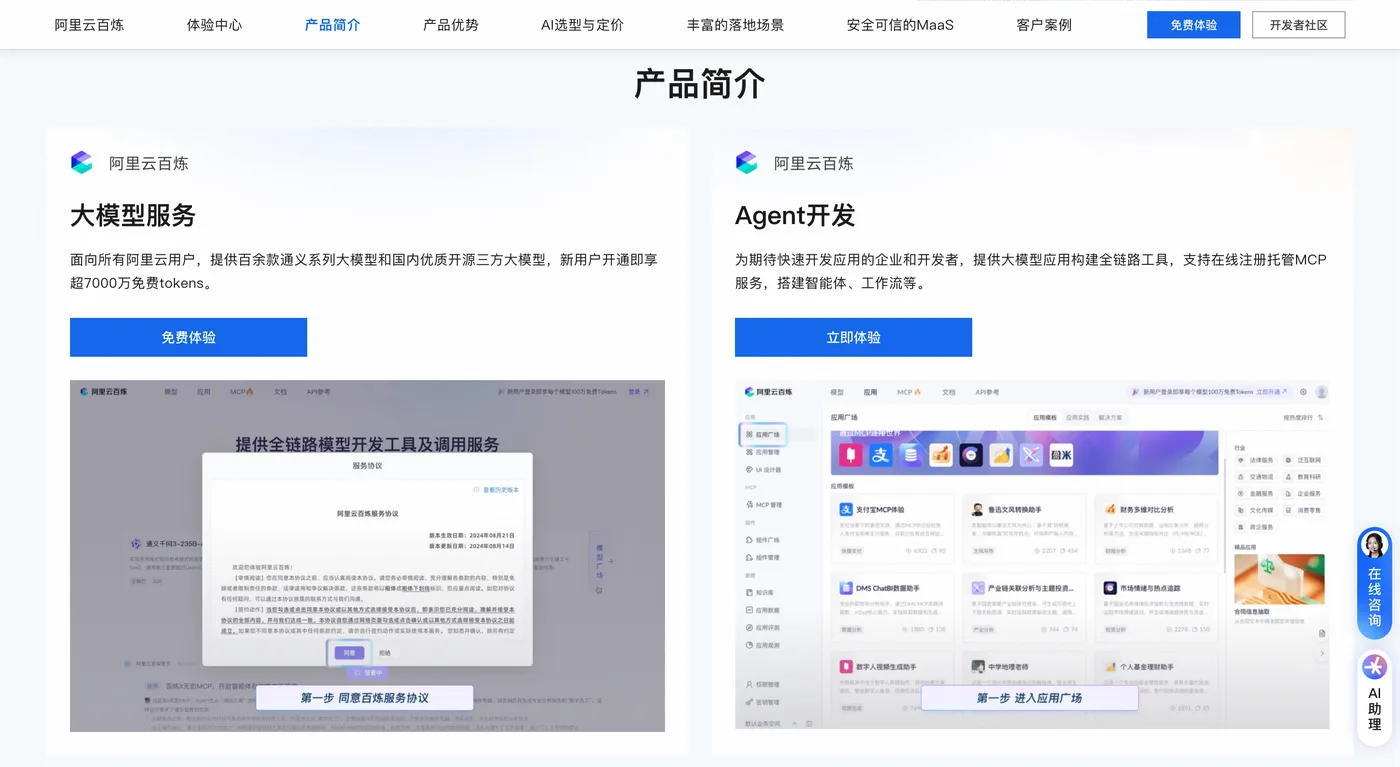
支持数十轮连续工具循环调用而不出现目标漂移,支持数千轮工具调用稳定运行。这在论文复现、大型系统搭建、多维度市场调研等长周期复杂任务中价值巨大。通过阿里云百炼大模型服务平台页面的 Agent 智能体模块,可以零代码构建并部署此类智能体。
3.2 工程级代码开发:不只是写片段,而是建项目
Qwen3.8-Max 内置 127 种编程语言语法解析能力,能够:
- 从零生成完整多文件项目
- 百万行仓库级代码理解重构
- 报错日志自动定位修复
- 单元测试编写、跨模块工程调试
- 结合截图完成 Vibe Coding 视觉辅助编程
官方实测可以无人工干预连续运行十数天,完成完整开源项目开发,产出数百次代码提交,达到主流 Agent 框架同级开发能力。适配 SWE 类 Agent 开发场景,可直接接入各类 AI 编程工具作为底层推理基座。在阿里云百炼大模型服务平台页面上,还可结合 Coding Plan 订阅,以极低成本享受代码生成服务。
3.3 多工具联动:稳定性是关键
工具调用 JSON 格式返回的稳定性优于同系列 Flash 模型,降低业务流程因格式异常中断的概率。支持 Hermes Agent、OpenClaw 等复杂智能体框架,适合需要多工具联动的自动化业务流程。
四、计费体系精算:三套模式叠加,省钱有道
Qwen3.8-Max 存在三套计费体系,不同模式可叠加生效,选错模式账单翻倍。以下是完整拆解:
4.1 按量计费(Pay-as-you-go)
以国内区域价格为参考(实际以控制台明细为准):
| 计费项 | 单价 |
|---|---|
| 普通输入 Token | 12 元/百万 Tokens |
| 普通输出 Token | 36 元/百万 Tokens |
| 缓存命中读取输入 | 1.5 元/百万 Tokens |
| 显式缓存创建 | 15 元/百万 Tokens |
重要说明:
- 开启深度思考模式,思考内容同样计入输出 Token;
- 快照版本
qwen3.8-max-0902每次请求固定消耗额外输入 Token; - 深度思考模式最大输出 131072 Token,思维链最长 262144 Token。
4.2 Token Plan 订阅套餐
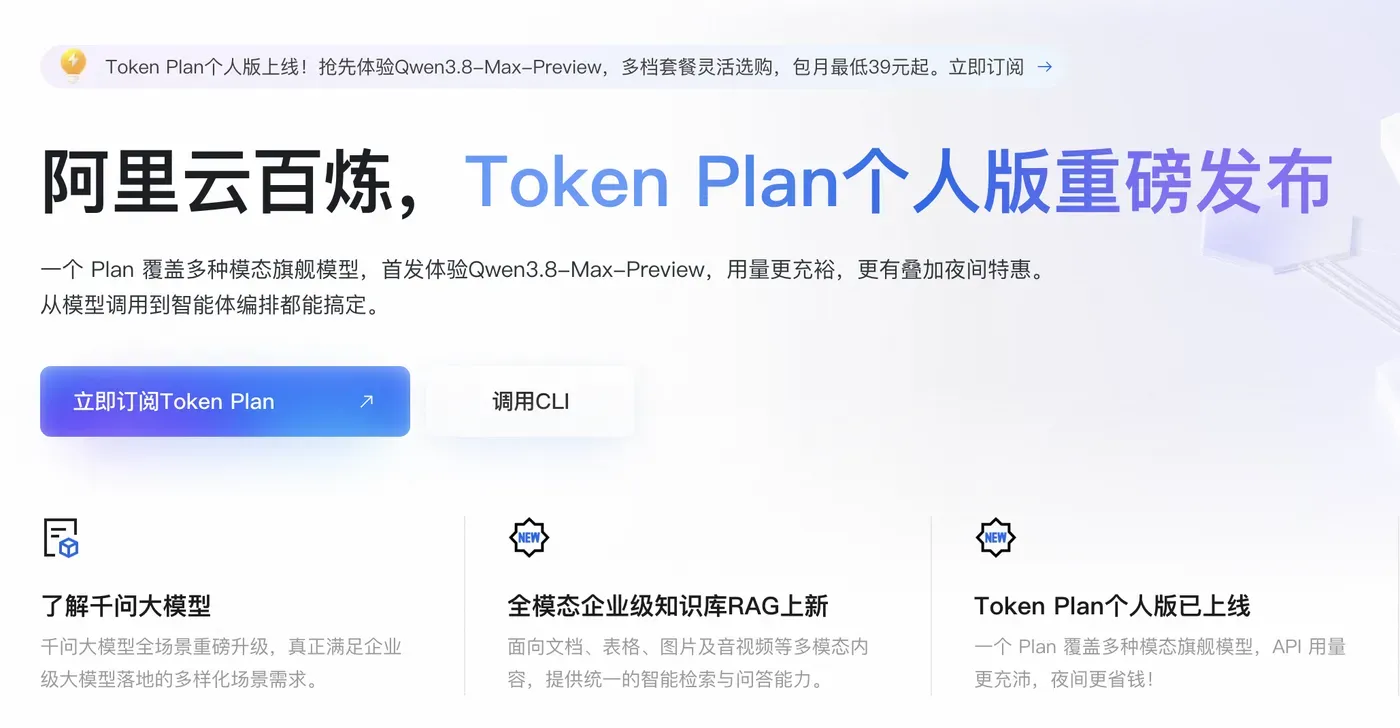
预购 Credits 额度,调用时优先消耗订阅 Credits,相比按量原价具备明显折扣。双十一期间,Token Plan 全模态 AI 订阅正式开放:
| 档位 | 限时月价(原价) | 月 Credits 额度 | 并发 Agent | 核心权益 |
|---|---|---|---|---|
| Lite | 39 元/月(60 元) | 11,500 | 1-2 个 | 轻量使用入门 |
| Essential | 79 元/月(120 元) | 25,500 | 2-3 个 | 日常 AI 编程 |
| Standard | 139 元/月(180 元) | 45,000 | 3-4 个 | 含 Agent Harness,88 折 |
| Pro | 499 元/月(600 元) | 180,000 | 6-8 个 | 超额 88 折,旗舰全覆盖 |
高频踩坑点:Token Plan 有专属 API 访问地址,不能使用普通按量计费的 API-Key 和接口地址,否则不会抵扣套餐额度,依旧产生按量账单!务必在阿里云百炼大模型服务平台页面核对接口地址与密钥。
团队版采用座席订阅:
| 档位 | 限时月价 | 月 Credits/席 | 定位 |
|---|---|---|---|
| 标准座席 | 150 元(198 元) | 25,000 | 常规团队 |
| 高级座席 | 550 元(698 元) | 100,000 | 中等规模 |
| 尊享座席 | 1,398 元 | 250,000 | 大型企业统一管控 |
4.3 NightPlan 夜间折扣权益
面向已开通 Token Plan 的客户,生效时间为每晚 22:00 至次日早上 8:00,该时段调用享受折扣。适合离线批量处理文档、夜间批量知识库处理、非实时异步任务。注意:该权益只针对模型推理本身,缓存相关计费项不参与折扣。
4.4 新人免费额度
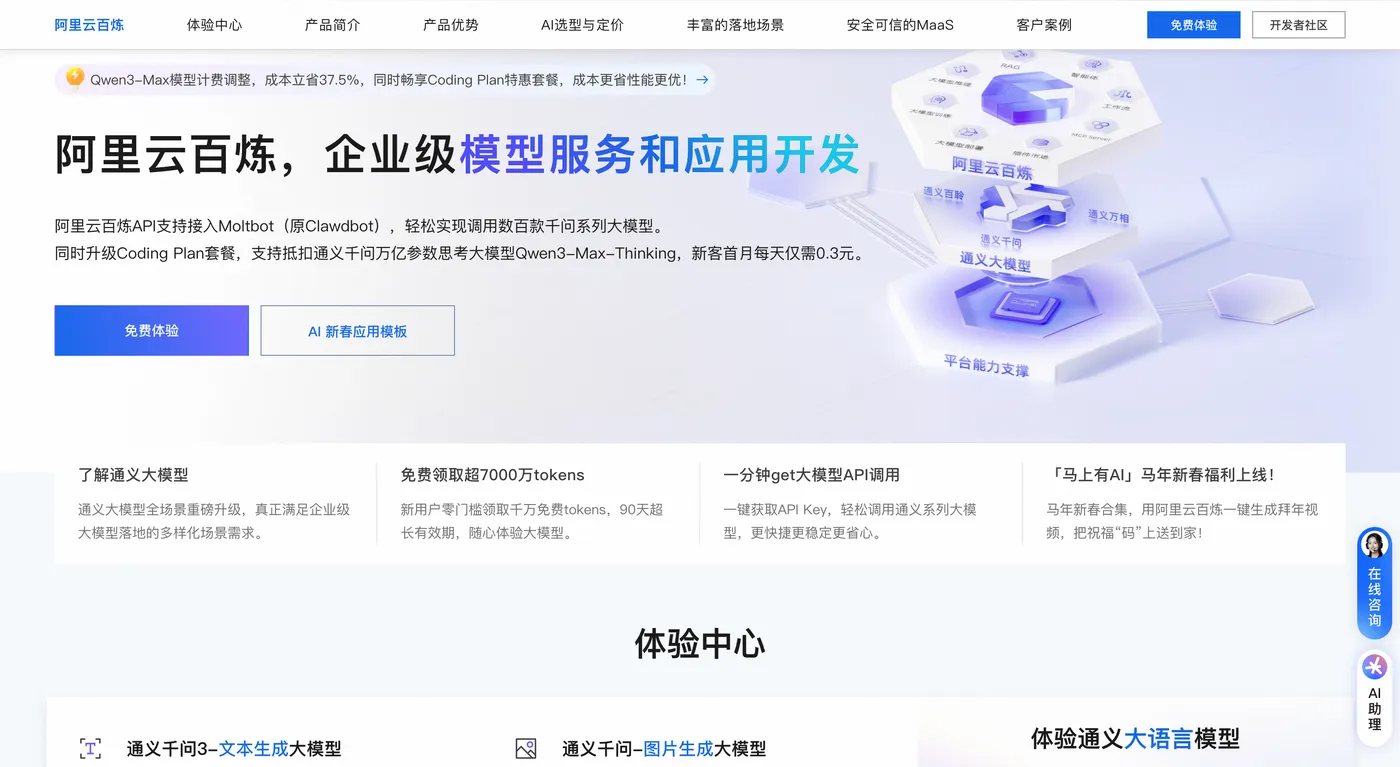
新用户开通即享超 7000 万 Tokens 免费额度,有效期 90 天,仅限华北 2(北京)地域,仅支持推理调用,模型微调训练、批量调用等场景不在抵扣范围内。
4.5 成本优化策略总结
| 策略 | 具体做法 |
|---|---|
| 分层路由 | 简单任务分发轻量模型,复杂任务才调用 Qwen3.8-Max |
| 上下文缓存 | 重复前缀做显式缓存,后续读取享受极低单价 |
| 夜间批量 | 非实时任务利用 NightPlan 夜间 2 折权益 |
| 订阅先行 | 日均请求稳定后切换 Token Plan,折扣最高达 4.5 折 |
| 用量告警 | 配置额度告警,防止 Credits 耗尽后按量产生高额账单 |
所有计费明细、用量统计均可在阿里云百炼大模型服务平台页面的费用控制台实时查看。
五、API 配置与代码实操:复制即跑
5.1 接入前提
- 登录阿里云百炼控制台,完成实名认证,开通服务;
- 前往阿里云百炼大模型服务平台页面的密钥管理页面,创建 sk- 开头的 API Key;
- 配置环境变量(Linux/macOS):
export DASHSCOPE_API_KEY="sk-你的APIKEY"
5.2 Python 完整示例
import os\import dashscope\
\dashscope.api_key = os.getenv("DASHSCOPE_API_KEY")\
\messages = [\{"role": "system", "content": "你是资深后端工程师,输出代码附带详细注释"},\{"role": "user", "content": "编写Python脚本读取csv日志,统计错误日志并输出markdown统计报告"}\]\
\resp = dashscope.Generation.call(\model="qwen3.8-max",\messages=messages,\reasoning_effort="xhigh", # 深度思考模式\max_tokens=8192\)\
\print("模型输出结果:")\print(resp.output.text)
5.3 curl 调用示例
curl https://dashscope.aliyuncs.com/api/v1/services/aigc/text-generation/generation \\-H "Authorization: Bearer $DASHSCOPE_API_KEY" \\-H "Content-Type: application/json" \\-d '{
\"model": "qwen3.8-max",\"input": {
\"messages": [{"role": "user", "content": "你好"}]\}\}'
5.4 OpenAI 兼容接口迁移
如果你的项目基于 OpenAI SDK 开发,只需修改 base_url 和 model 名称即可迁移:
from openai import OpenAI\
\client = OpenAI(\api_key="sk-你的APIKEY",\base_url="https://dashscope.aliyuncs.com/compatible-mode/v1"\)\
\response = client.chat.completions.create(\model="qwen3.8-max",\messages=[{"role": "user", "content": "你好"}]\)
所有 SDK 文档、接口规范均可在阿里云百炼大模型服务平台页面的开发者文档区获取。
六、业务落地实战:从 POC 到生产的避坑指南
6.1 业务选型策略
| 业务类型 | 推荐方案 |
|---|---|
| 个人 POC 验证 | 新人免费额度 + 按量计费 |
| 中小企业稳定业务 | Token Plan 订阅(Standard 档起步) |
| 企业级智能体项目 | Token Plan 团队版 + 专属部署 |
| AI 编程工具 | Coding Plan 订阅(新客首月每天 0.3 元) |
| 离线批量处理 | NightPlan 夜间权益 + Batch 批量推理 |
6.2 生产环境六大避坑要点
- 锁定快照版本:指定
qwen3.8-max-0902,避免模型迭代导致输出变动; - 配置用量告警:防止 Credits 耗尽后按量产生高额账单;
- 增加异常捕获与重试逻辑:网络波动、限流(国内 RPM 30000、TPM 500 万)时自动重试;
- 不要全部流量跑旗舰模型:采用分层路由,简单任务用 Flash/Plus 模型;
- 正式上线前充分测试:用真实业务数据集验证输出质量、接口延迟、Token 消耗;
- 缓存以账单为准:不要只看 API 返回字段,以百炼控制台账单缓存计费明细作为真实结算依据。
6.3 限流指标参考
| 区域 | RPM | TPM |
|---|---|---|
| 国内区域 | 30,000 | 500 万 Token/分钟 |
| 国际部署区域 | 15,000 | 200 万 Token/分钟 |
消费档位提升后限额会自动上调,属于动态限流。
七、结语:在阿里云百炼大模型服务平台页面上,开启你的 AI 新纪元
Qwen3.8-Max 不是一个"模型",而是一把开启复杂 AI 业务的钥匙——百万 Token 上下文让长文档不再是障碍,原生多模态让图文视频信手拈来,MoE 架构让旗舰能力不再高不可攀,深度思考让复杂推理精准可靠。
而阿里云百炼大模型服务平台页面,正是将这一切能力整合为一站式体验的枢纽。从模型调用到智能体编排,从知识库构建到模型微调,从新人免费额度到 Token Plan 4.5 折,从 API 一行代码到可视化零代码搭建——你需要的,不过是登录阿里云百炼大模型服务平台页面,点下第一个按钮。
现在就行动。打开阿里云百炼大模型服务平台页面,让 Qwen3.8-Max 成为你业务腾飞的引擎。
本文所有模型参数、计费数据均以阿里云百炼大模型服务平台页面最新公示为准,生产部署前请务必在阿里云百炼大模型服务平台页面核对最新配置与价格。
