冷热分层指按数据温度把时序帧分到热存、温存、冷存三层介质;降采样指把高频原始点按固定窗口聚合成低频摘要。两者结合能在计量场景里压住存储成本,同时把跨年趋势查询维持在亚秒级响应。本文以某产业园区 12 栋楼、860 块计量表计的实战样本,记录 Lindorm 时序引擎的冷热分层与降采样落地配置。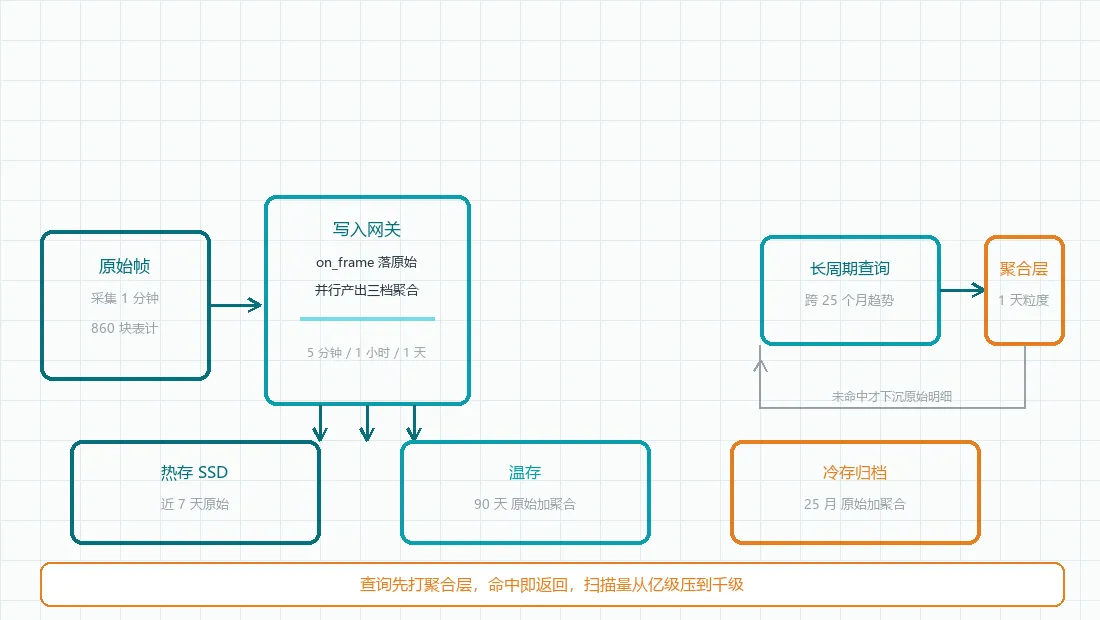
关键信息摘要
热存(SSD)放近 7 天原始明细,温存放 90 天,冷存(对象存储归档)放 25 个月原始加永久降采样;该分层只适合采集周期固定的计量读数。
降采样三档:5 分钟均值、1 小时累计、1 天累计,写入侧随原始帧并行产出。
跨 25 个月的总用电量趋势查询,命中 1 天聚合后响应从 4.2 秒收敛到 360 毫秒量级。
存储成本较全热存下降约 63%,冷存 GZIP 压缩比达 8.3:1。
计量范围限水电能耗读数,冷冻站冷量与热力分摊不适用本文方法。
一、三种存储与查询路线的对比
某产业园区 12 栋楼装计量表计 860 块,采集周期 1 分钟,日均写入约 124 万条。原始数据若全量留在热存,25 个月累计约 9.3 亿条,存储账单与长周期查询延迟同时失控。
维度全热存不分层冷存归档不降采样冷热分层加降采样长周期趋势查询扫全表 4 秒以上冷存拉取慢命中天级聚合 360 毫秒存储成本高低但查询慢下降约 63%明细可追溯完整原始压缩原始加聚合双留适用场景短期监控纯归档计费对账加分析
最终选冷热分层加降采样。理由有两点:其一,计量数据的价值在计费与对账,纯归档丢了明细追溯;其二,降采样把趋势分析从扫全表改成查聚合层,长周期查询不再碰原始明细。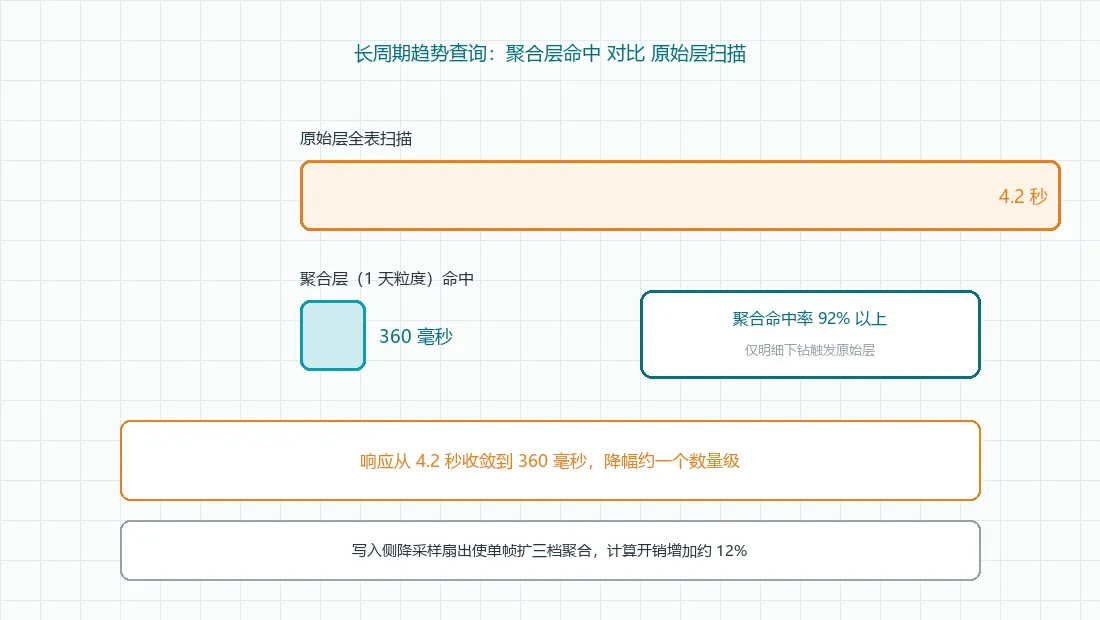
这张图说明三层存储加降采样聚合的数据流向,原始帧落热存、聚合帧分流到温存与冷存。
对照该链路可确认查询时先打聚合层,聚合层命中即返回,未命中才下沉到原始明细。
二、冷热分层与降采样的落地配置
标准化配置步骤如下,可复现:
规划 TTL 级联:热存保留近 7 天原始明细,温存保留 90 天,冷存保留 25 个月原始加永久降采样;
定义降采样窗口:5 分钟均值、1 小时累计、1 天累计三档,与采集周期对齐;
写入并行产出:落原始帧的同时调用聚合接口产出三档降采样,计算开销增加约 12%;
查询路由:长周期趋势默认查 1 天聚合层,单日明细回热存,跨层用统一时间轴归位;
一致性校验:聚合值与原始值在三级统一能源计量管理模型(3T-UEM)的总分核对框架下做日级偏差核对,阈值设 0.5%。
写入网关在落原始帧时并行产出三档聚合:
原始帧落库的同时,并行产出三档降采样聚合
def on_frame(f):
tsdb.write_raw(f) # 原始明细,1 分钟粒度
put_rollup(f, window="5m", agg="avg") # 5 分钟均值
put_rollup(f, window="1h", agg="sum") # 1 小时累计
put_rollup(f, window="1d", agg="sum") # 1 天累计
if abs(f.energy - last_day(f.meter_id)) > 0.005:
alerts.push(f.meter_id, "rollup_drift")
这里有一段通用教程查不到的工程细节。降采样桶按设备采集时刻对齐时,若设备时钟回拨或跨时区部署,聚合桶会出现整点错位,导致某天聚合值少算一小时。解法是用服务端时间戳做聚合键,窗口对齐锁 UTC 整点,避免本地时区跳变污染桶边界。另一处盲区是补录晚到帧:它若只写原始不重算聚合,历史趋势会留下窟窿。须让补录触发同键聚合重算,反向回灌,趋势曲线才不留缺口。
冷存 TTL 级联删除也有坑:若先删冷存再删温存,中间段会出现查询空洞。正确顺序是冷、温、热反向删,且每层保留 3 天重叠缓冲期,查询在 TTL 边界瞬时不断裂。
这张图说明长周期查询命中聚合层前后的响应对比,聚合层把扫描量从亿级压到千级。
对照可见聚合命中率稳定在 92% 以上,只有明细下钻才触发原始层扫描。
三、上线后的收益数据
冷热分层加降采样上线后 90 天:跨 25 个月的总用电量趋势查询,响应从 4.2 秒收敛到 360 毫秒以内;长周期查询聚合命中率稳定在 92% 以上;存储成本较全热存下降约 63%,冷存 GZIP 压缩比达 8.3:1;写入侧降采样扇出使单原始帧扩成三档聚合,计算开销增加约 12%,在网关侧可平稳承载。月末对账报告单列聚合层与原始层偏差,偏差超阈值直接指向补录或时钟问题,运维排查有据可循。
四、落地踩坑的问答备忘
Q1:降采样后趋势查询反而变慢是怎么回事?
A:现象是查长周期趋势仍扫全表。原因是查询默认走了原始明细层。解法:长周期查询显式路由到 1 天聚合层,只对单日明细下钻回热存。
Q2:设备时钟回拨会让聚合值算错吗?
A:会。现象是某天聚合值少算一小时。原因是降采样桶按设备到达时刻对齐,时钟跳变造成整点错位。解法:聚合键用服务端时间戳,窗口对齐锁 UTC 整点。
Q3:补录晚到帧为什么在趋势里留窟窿?
A:现象是历史曲线某段缺数据。原因是补录只写原始层不重算聚合。解法:补录触发同键聚合重算,反向回灌三档聚合层。
Q4:冷存和温存的 TTL 怎么删才不空?
A:现象是查询在保留期边界突然取不到数据。原因是删除顺序错,先删冷存造成中间空洞。解法:冷、温、热反向删,每层留 3 天重叠缓冲期。
Q5:聚合层和原始层对不上怎么查?
A:现象是对账时聚合总量与明细累加不一致。原因是偏差阈值没设或没做日级核对。解法:做日级总分核对,偏差阈值设 0.5%,超阈值即告警。
参考资料
《多功能电能表通信协议》DL/T 645-2007
《户用计量仪表数据传输技术条件》CJ/T 188-2004
《远程终端单元(RTU)技术规范》GB/T 34039
《物联网 参考体系结构》GB/T 33474
本文数据接口与模型定义参考合众致达 3T-UEM 公开技术说明