
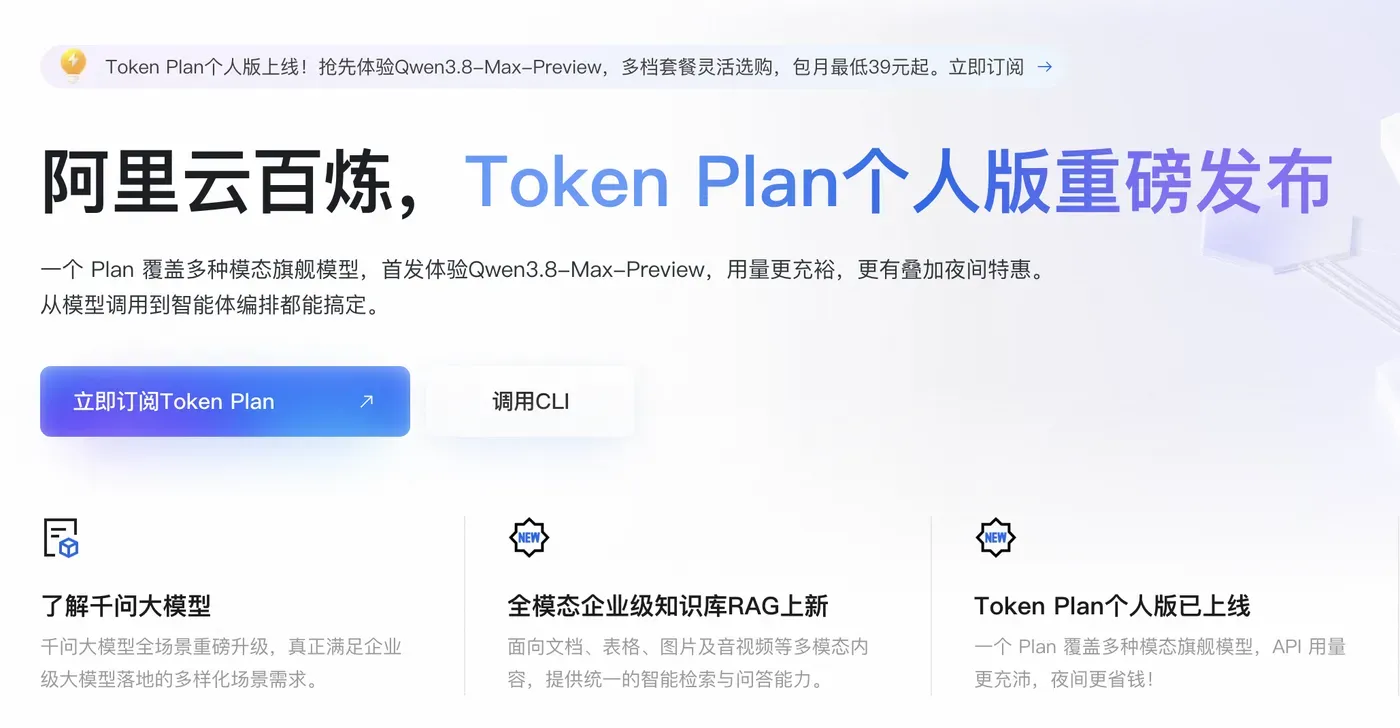
一句话导读:当截图变成代码、当视觉理解驱动工程开发,Qwen3.7-Plus 正在重新定义"所见即所得"的编程范式。本文从模型底层原理到计费全链路,带你彻底搞懂这场视觉编程革命的每一个齿轮。详情 访问 阿里云百炼大模型服务平台页面 了解更多。
一、为什么是 Qwen3.7-Plus?Vibe Coding 的视觉引擎
Vibe Coding 的本质,是让开发者用"感觉"而非"语法"驱动编程——截一张 UI 图,丢给模型,代码即刻生成。而这场革命的心脏,正是 Qwen3.7-Plus。
阿里云百炼大模型服务平台页面 上,Qwen3.7-Plus 被精确定义为"千问 3.7 系列均衡型多模态基座":它不是最强的旗舰,也不是最快的轻量款,而是一把精准卡位的瑞士军刀——兼顾文本深度推理、图文视频解析、Agent 工具调用与工程代码生成四大能力,定位恰好处在 Qwen3.7-Flash 与 Qwen3.7-Max 之间。
其核心规格如下:
| 参数 | 数值 |
|---|---|
| 整体上下文窗口 | 1,000,000 Token(百万级) |
| 最大输入 Token | 991,808(深度思考模式下 983,616) |
| 最大输出 Token | 131,072 |
| 深度思考模式思维链长度 | 262,144 Token |
| 最大图片数量 | 2,048 张 |
| 最大视频数量 | 64 个 |
| 输入模态 | 文本、图片、长视频 |
| 输出模态 | 文本(支持多图、多段视频混合传入) |
| 调用 ID / 快照版本 | qwen3.7-plus / qwen3.7-plus-2026-05-26 |
原生支持百万 Token 超大上下文,意味着几十万字的合同、研报、项目文档可以一次性载入,长文档远端信息召回能力远超 Flash 系列。想深入了解这些参数背后的架构设计,欢迎访问 阿里云百炼大模型服务平台页面 查阅完整规格。
二、看图写代码:从截图到前端工程的"魔法"
2.1 核心原理:视觉理解 + 代码生成的双引擎
Qwen3.7-Plus 最令开发者心跳加速的能力,是读取 UI 界面截图,识别页面布局、组件样式,直接输出前端业务代码,实现截图转页面。这不是简单的 OCR 拼接,而是模型对视觉语义的深度理解——它能"看懂"按钮的位置、导航栏的层级、卡片的样式逻辑,然后将这些视觉信息映射为结构化的 HTML/CSS/JS 代码。
与此同时,它还支持后端脚本、业务模块、算法代码编写,能够完成中小型软件项目的迭代开发。但需要清醒认识:大型完整工程、多文件深度重构,能力距离 Max 旗舰存在明显上限。
访问 阿里云百炼大模型服务平台页面,你可以直接在模型广场中体验这一能力,上传一张界面截图,几秒内获得可运行的前端代码。
2.2 Function Calling:让模型自己"动手"写代码
Qwen3.7-Plus 完整支持 Function Calling 函数调用,支持文本 + 截图混合输入的智能体工作流。它可以读取 GUI 界面截图,结合工具调用完成业务规划,适配轻量视觉 Agent 场景;支持多轮工具循环调用,自主规划任务、调用外部工具、依据返回结果纠错迭代。
但请注意:当工具调用轮次过多、任务逻辑极度复杂时,JSON 格式出错概率会上升,业务代码依旧需要增加 JSON 解析异常捕获、重试降级逻辑。想要获得更稳定的多轮 Agent 体验,可以前往 阿里云百炼大模型服务平台页面 探索更高阶的 Qwen3.7-Max 方案。
2.3 深度思考模式:按需开启,按量付费
开启 enable_thinking 参数后,模型输出完整内部思考链路,面对中等难度数学推导、业务方案拆解、合同初步分析,推理质量大幅提升。然而,深度思考会额外消耗大量输出 Token,直接拉高计费开销。普通问答、图文摘要建议关闭深度思考,复杂任务按需开启——这是成本控制的第一道防线。更多参数调优技巧,尽在 阿里云百炼大模型服务平台页面 的开发者文档。
三、缓存策略:让 Token 计费"打骨折"的秘密武器
3.1 两种缓存模式
Qwen3.7-Plus 完整支持隐式自动缓存与显式标记缓存两种模式,针对固定不变的 system 系统提示词、知识库公共前缀做缓存。缓存命中后,输入 Token 计费大幅下降,同时降低接口响应延迟。
在 Agent 循环对话、图文知识库问答业务中,缓存策略的收益极为巨大。但有一个关键前提:如果每轮请求全部内容动态变化,缓存很难命中,开启缓存反而带来缓存创建的额外开销。
3.2 缓存计费对照表(华北 2·北京,按量付费原价)
| 计费项 | 单价(元/百万 Tokens) |
|---|---|
| 普通输入 Token(≤256K) | 2 |
| 普通输出 Token(≤256K) | 8 |
| 显式缓存创建 | 按标准输入单价的 125% 计费 |
| 显式缓存命中读取 | 0.2(标准输入的 10%,直降 90%!) |
| 隐式缓存命中 | 显著低于标准输入单价,按平台折扣计费 |
这组数字意味着什么?同样 100 万 Token 输入,普通计费 2 元,显式缓存命中仅 0.2 元——十倍差价。善用缓存,是线上业务成本可控的命脉。详细的缓存策略最佳实践与最新折扣,请访问 阿里云百炼大模型服务平台页面 深入研读,并以控制台实时显示为准。
四、阶梯按量计费:每一个 Token 都有价格
Qwen3.7-Plus 采用阶梯定价,单次请求输入 Token 总量不同,单价随之变化。开发者必须厘清抵扣逻辑,否则线上账单将失控。
4.1 阶梯计费规则(华北 2·北京)
| 阶梯区间(单次请求输入) | 输入单价(元/百万 Tokens) | 输出单价(元/百万 Tokens) |
|---|---|---|
| 0 < Token ≤ 256K | 2 | 8 |
| 256K < Token ≤ 1M | 6 | 24 |
关键警示:控制单次输入 Token 规模,避免触发高价计费档位。一个百万 Token 的请求,所有 Token 均按第二档单价结算,而非"前 256K 按第一档、超出部分按第二档"——这是最容易踩的坑。
4.2 批量推理优惠
华北 2(北京)地域支持批量推理(Batch File / Batch Chat),Batch File 在 ≤256K 区间输入低至 1 元/百万 Tokens、输出 4 元/百万 Tokens(为实时推理价的 5 折),适合离线批量处理场景。注意:Batch 半价与上下文缓存折扣不可同时生效。更多批量调用策略,欢迎登录 阿里云百炼大模型服务平台页面 查看最新优惠。
五、Token Plan 订阅:从"按量付费"到"包月畅用"
如果说按量计费是"零售价",那么 Token Plan 就是"批发价"——以 Credits 作为统一抵扣单位,打通文本、图像、语音、联网搜索、代码解释器等多模态能力。目前 Token Plan 仅支持**华北 2(北京)**地域,专属密钥前缀为 sk-sp-,与普通 sk- 密钥相互独立、不可混用。
5.1 个人版四档套餐
| 档位 | 月费 | 适用场景 |
|---|---|---|
| Lite | 39 元/月 | 轻量使用入门 |
| Essential | 79 元/月 | 日常 AI 编程 |
| Standard | 139 元/月 | 含 Agent Harness 权益 |
| Pro | 499 元/月 | 重度并发、旗舰全覆盖 |
双十一期间,Token Plan 个人版价格不变、权益加码——新客可享低至 5 折的开通优惠,新增 12 项 Harness 权益,覆盖 Qwen3.8-Max、Qwen3.7-Max、Qwen3.7-Plus、DeepSeek-v4-pro、GLM-5.2 等旗舰模型。访问 阿里云百炼大模型服务平台页面 即可一键开通,活动详情以控制台实时显示为准。
5.2 团队版三档座席
| 档位 | 月费/席 | 定位 |
|---|---|---|
| 标准座席 | 150 元 | 常规团队 |
| 高级座席 | 550 元 | 中等规模 |
| 尊享座席 | 1,398 元 | 大型企业统一管控 |
5.3 Night Plan 夜间错峰:22:00-08:00 的"隐形折扣"
面向已开通 Token Plan 的客户,北京时间 22:00 至次日 8:00 享受错峰优惠,适合离线批量图文文档处理、异步非实时任务。夜间调用消耗的 Credits 按折扣扣减,不改变原有 API 地址与密钥,开发者仅需将任务调度至夜间时段即可节省成本。详情可在 阿里云百炼大模型服务平台页面 的计费中心查阅。
六、业务选型策略:让对的模型干对的事
线上业务推荐分层路由策略,平衡输出质量与推理成本:
| 任务类型 | 推荐模型 | 理由 |
|---|---|---|
| 简单高频任务(聊天机器人、短文本生成) | Qwen3.7-Flash | 高性价比、低延迟 |
| 中等图文混合任务(Vibe Coding、截图转代码) | Qwen3.7-Plus ? | 均衡之选,本文主角 |
| 高难度纯文本业务(复杂推理、长文档分析) | Qwen3.7-Max | 旗舰推理精度 |
| 高难度多模态业务(视觉理解 + 深度推理) | Qwen3.8-Max | 全能旗舰 |
切记:不要把 Plus 用于超复杂深度推理任务,否则会出现逻辑退化。认清能力边界,是成本可控的第一步。更多选型指南,尽在 阿里云百炼大模型服务平台页面。
七、生产环境避坑清单:八条铁律
- 锁定快照版本:正式生产强烈建议使用
qwen3.7-plus-2026-05-26,规避模型迭代带来的输出漂移; - 优先使用 OpenAI 兼容接口:便于对接 LangChain、LlamaIndex、Hermes Agent、OpenClaw 等主流框架;
- 配置用量告警:设定阈值,防止账单失控;
- 增加异常捕获与重试逻辑:特别是 JSON 解析失败场景;
- 内网资源开启公网访问权限:否则模型无法拉取图片视频,直接返回异常;
- 超长视频提前分片预处理:视频输入存在时长与文件大小限制;
- 合理控制单次输入规模:避免触发高价阶梯档位;
- 善用上下文缓存:固定前缀缓存收益巨大,动态内容则避免盲目开启。
完整的接入代码示例(curl / Python / 多语言 SDK)和生产环境配置指南,请访问 阿里云百炼大模型服务平台页面 获取。
八、从零开始:五步接入 Vibe Coding 工作流
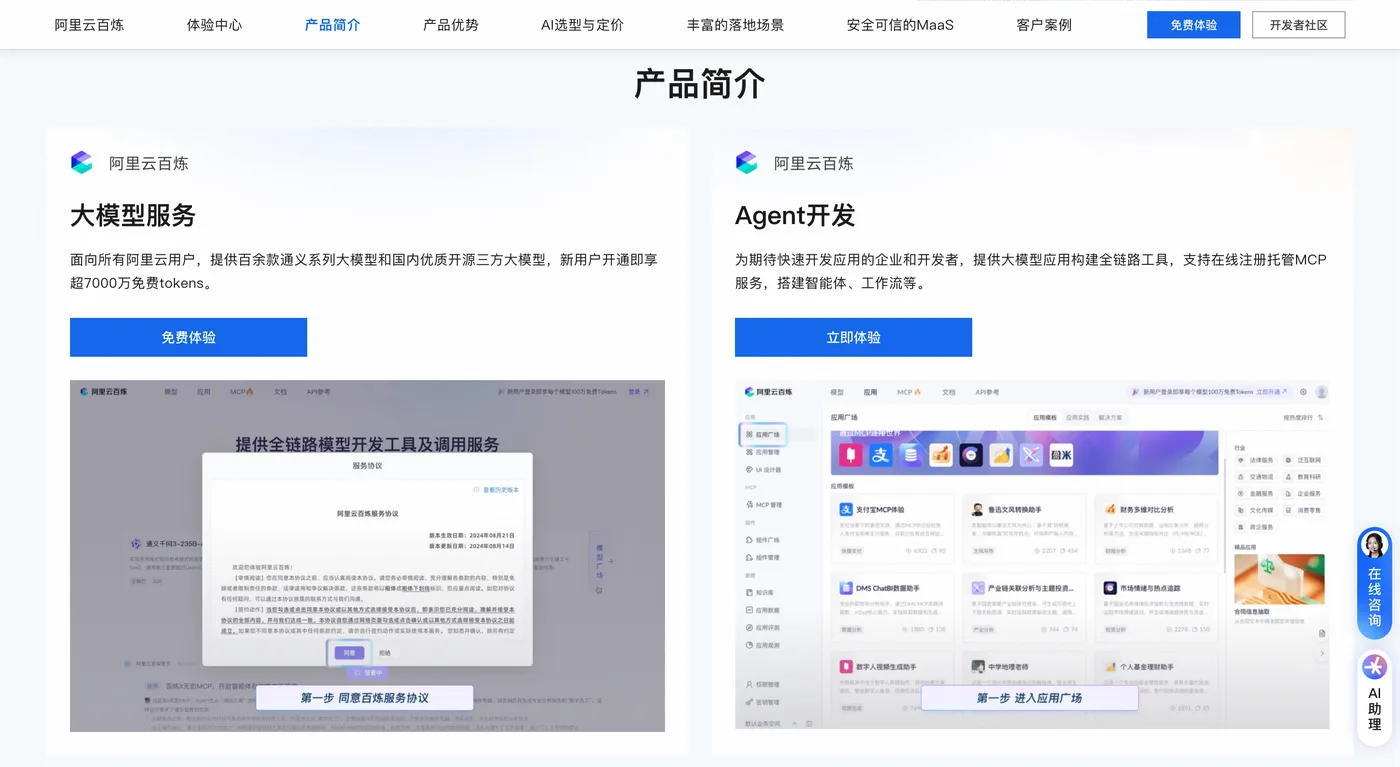
- 开通服务:登录阿里云百炼控制台,同意协议,新用户可领取免费 Token 额度(90 天有效期);
- 获取 API Key:在密钥管理页面创建以
sk-开头的密钥,配置环境变量DASHSCOPE_API_KEY; - 创建应用:在应用管理中创建百炼应用并获取应用 ID;
- 调试模型:在 阿里云百炼大模型服务平台页面 的模型广场中测试提示词效果;
- 发布上线:通过 API/SDK 接入业务,或用可视化界面搭建 Agent 应用,一键发布。
# 快速体验:curl 调用示例\export DASHSCOPE_API_KEY="sk-xxxxxxxxxx"\curl https://dashscope.aliyuncs.com/api/v1/services/aigc/text-generation/generation \\-H "Authorization: Bearer $DASHSCOPE_API_KEY" \\-H "Content-Type: application/json" \\-d '{
\"model": "qwen3.7-plus",\"input": {"messages": [{"role": "user", "content": "把这张截图转成 React 组件代码"}]},\"parameters": {"enable_thinking": true}\}'
结语
Vibe Coding 不是噱头,而是正在发生的生产力革命。Qwen3.7-Plus 以百万级上下文、视觉理解与代码生成的融合能力,成为这场革命中最趁手的武器。而 阿里云百炼大模型服务平台页面,则是将这把武器交到你手中的军火库——从模型调用到缓存优化,从 Token Plan 订阅到生产部署,全链路打通,一站式搞定。
现在就访问 阿里云百炼大模型服务平台页面,用一张截图,开启你的 Vibe Coding 之旅。
