摘要
GitHub 在 Universe 2026 上把模型路由服务 Copilot Fusion 正式开放:系统判断任务需要什么,再决定用一个还是多个模型执行。
路由把"换模型"从发布决策变成了每次请求的运行时决策,也把四类新的不确定性带进了测试范围。本文给出路由测试的四个抓手、一张测试矩阵,以及厂商 benchmark 数字的正确读法。
GitHub Universe 2026 上,去年以 HydraFusion 之名预览的模型路由服务,以 Copilot Fusion 正式开放。官方描述是:系统评估任务在推理、代码生成、调试和工具使用上的需求,再决定用一个还是多个模型来执行。
同场给出的数字很吸引人——在 Artificial Analysis 的 Coding Agent Index 上,Fusion Max 与 Claude Opus 5.5 Max 的得分相差不到两分,成本只有一半,单个任务耗时少40%。
先把口径说清楚:这三项都是厂商自报的 benchmark 结果,索引分数不是你的业务指标,也没有第三方独立复现。它们能证明"路由这条路可行",不能证明"你的功能不会退化"。
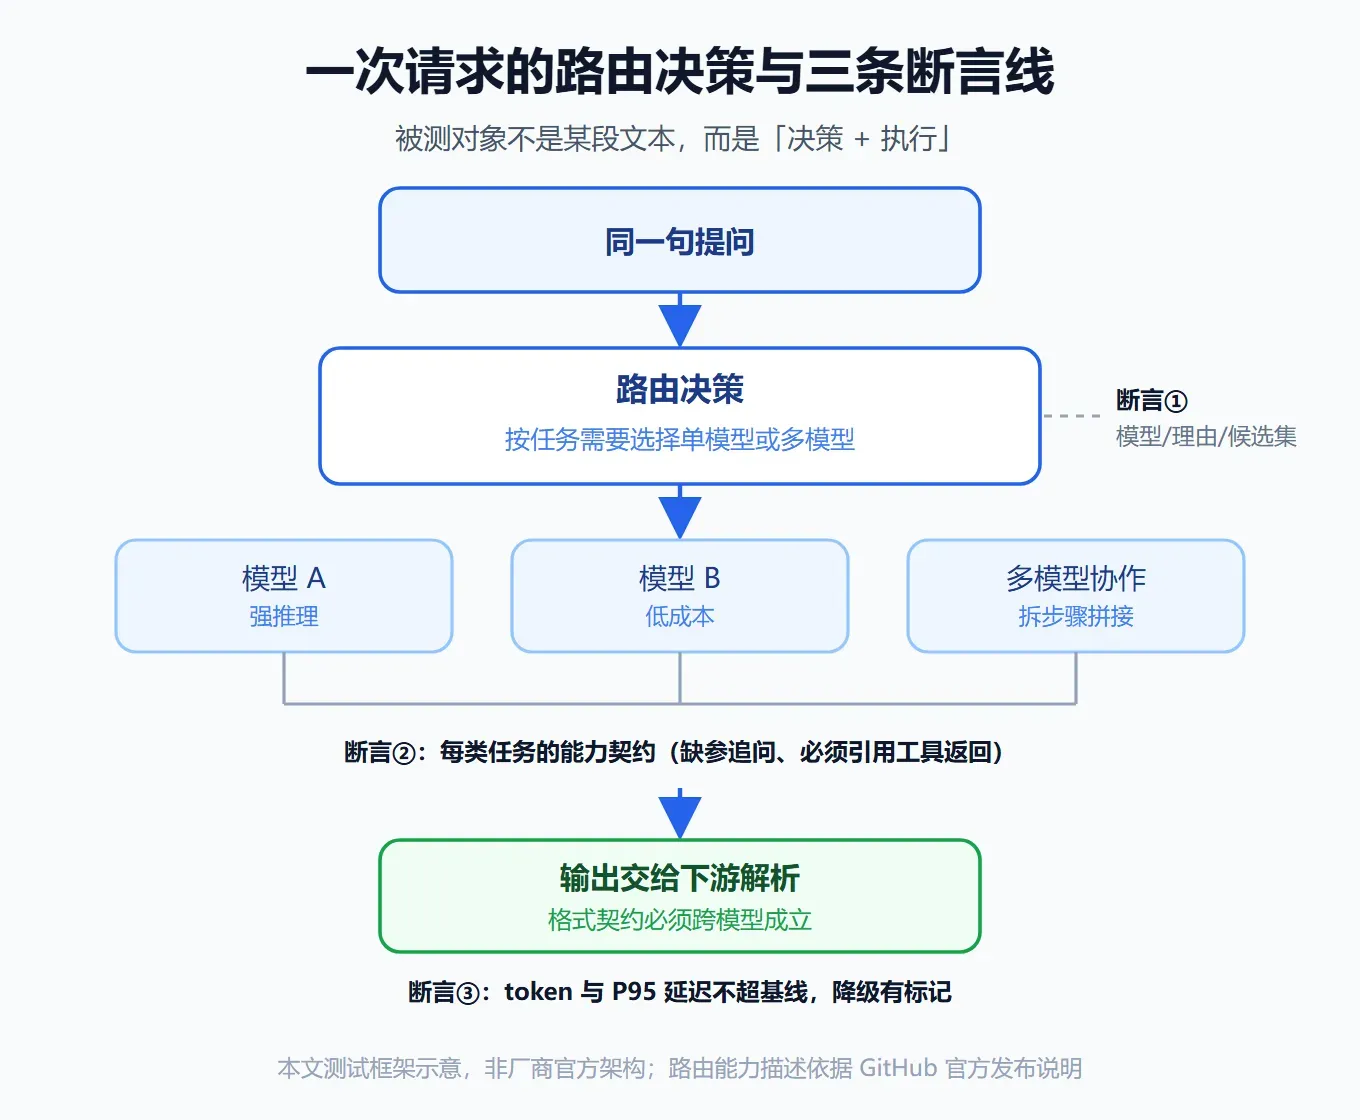
对测试工程师来说,真正变了的东西不是模型更强,而是决策发生的时间点。过去"换模型"是一次发布:选定、评测、上线、观察。现在路由是每次请求的运行时决策——同一句提问,这一次可能落到A模型,下一次落到B模型;在自动路由模式下,用户看不到、也控制不了自己拿到的是哪个模型。这一点在安全研究对 Copilot CLI 自动路由的观察里被明确提到。
四类被引入的不确定性
- 能力漂移:不同模型对"边界输入"的处理不一样。A模型会拒答的诱导,B模型可能照做;A模型会追问缺失参数,B模型可能直接猜一个。
- 成本与延迟波动:路由会跨模型、跨供应商调度,token 消耗与首字延迟的分布变宽。用固定超时和固定预算做断言,会在高峰期误报。
- 格式不一致:同一份提示,不同模型返回的 JSON 字段顺序、空值表达、markdown 包裹习惯都可能不同。下游解析器按A模型的输出写,换到B模型就崩。
- 静默降级:主模型限流或故障时切到备用模型,用户无感知。功能"还能用",但质量档位已经掉了。
旧办法为什么失效
把模型名写死在用例里、用固定期望输出做断言、只跑一条黄金路径——这三件事在单模型时代是效率,在路由时代是盲区。因为被测对象不再是"某个模型的输出",而是"一次路由决策加上它的执行结果"。你断言的应该是决策的合理性,而不是某段文本。
四个抓手,可以照着搭
| 变量 | 怎么造 | 断言什么 | 需要的证据 |
|---|---|---|---|
| 路由决策 | 同一提示重复发 N 次 | 选中的模型/路径被记录,且落在允许集合内 | 路由日志(模型、理由、耗时) |
| 能力契约 | 每类任务准备边界样本(缺参数、诱导、超长) | 该任务类型的最低能力不退化 | 用例结果 + 模型标识 |
| 降级行为 | 注入限流/超时,强制切备用 | 降级后用户可见行为符合约定(提示、重试、兜底) | 故障注入记录 + 用户侧输出 |
| 成本回归 | 固定数据集跑批 | token 与 P95 延迟不超基线阈值 | 批次报表 |
| 格式稳定 | 同提示跨模型对比 | 解析器在全部模型上都通过 | 契约测试结果 |
一、让路由可观测。没有日志就没有测试。至少要记录:这次选中了哪个模型、为什么、耗时多少。做不到这一点,后面三条都无法验证。
二、给每类任务写"能力契约"。不是比对完整输出,而是列出这类任务不可退让的几条:必须追问缺失参数、必须引用工具返回、不得编造单号。换模型时跑这套契约,而不是跑一段快照文本。
三、把降级当功能测。主动注入限流和超时,看系统是重试、切备用、还是直接报错;再看用户侧看到什么。降级路径平时不跑,出故障时才第一次执行,这是最典型的"上线才被测到"的模块。
四、把成本和延迟纳入门禁。路由的卖点是省钱省时,如果没人度量,退化了也不会有人发现。把每次发布的 token 均值与 P95 延迟和基线比,超阈值就拦。
一个最小的断言示意(伪代码,不是厂商配置):
resp = ask(prompt, route="auto")
assert resp.route.model in ALLOWED_MODELS          # 决策落在允许集合
assert resp.route.reason is not None              # 决策可解释
assert resp.usage.tokens <= BASELINE * 1.2        # 成本不超基线20%
assert parse(resp.text)                            # 格式契约仍成立
路由日志该记什么
没有日志就没有测试,但日志也不是越多越好。五个字段是底线:
- 选中模型:哪个厂商、哪个版本,不能只记"auto";
- 决策理由:是任务类型命中、成本优先、还是主模型不可用;
- 候选集:当时有哪些模型可用,避免"只有B可选所以选了B"被误读成"B最合适";
- 耗时与token:分路由阶段和执行阶段记,否则无法判断慢在决策还是慢在生成;
- 降级标记:这一次是否发生了静默降级。
少任何一个字段,都会在复盘时卡住。比如没有候选集,你无法区分"路由判断失误"和"当时没得选"。
一次跨模型拼接的失败样本
可以构造这样一条用例(推演场景,不是真实事故):一个需求描述被路由拆成两步——A模型负责生成接口定义,B模型负责补测试用例。两边各自都完成了任务,拼起来却对不上:A返回的字段叫 refundAmount,B按 refund_amount 断言;A用分为单位,B按元处理。单看任何一步的评测都是高分,合起来是一条跑不通的链路。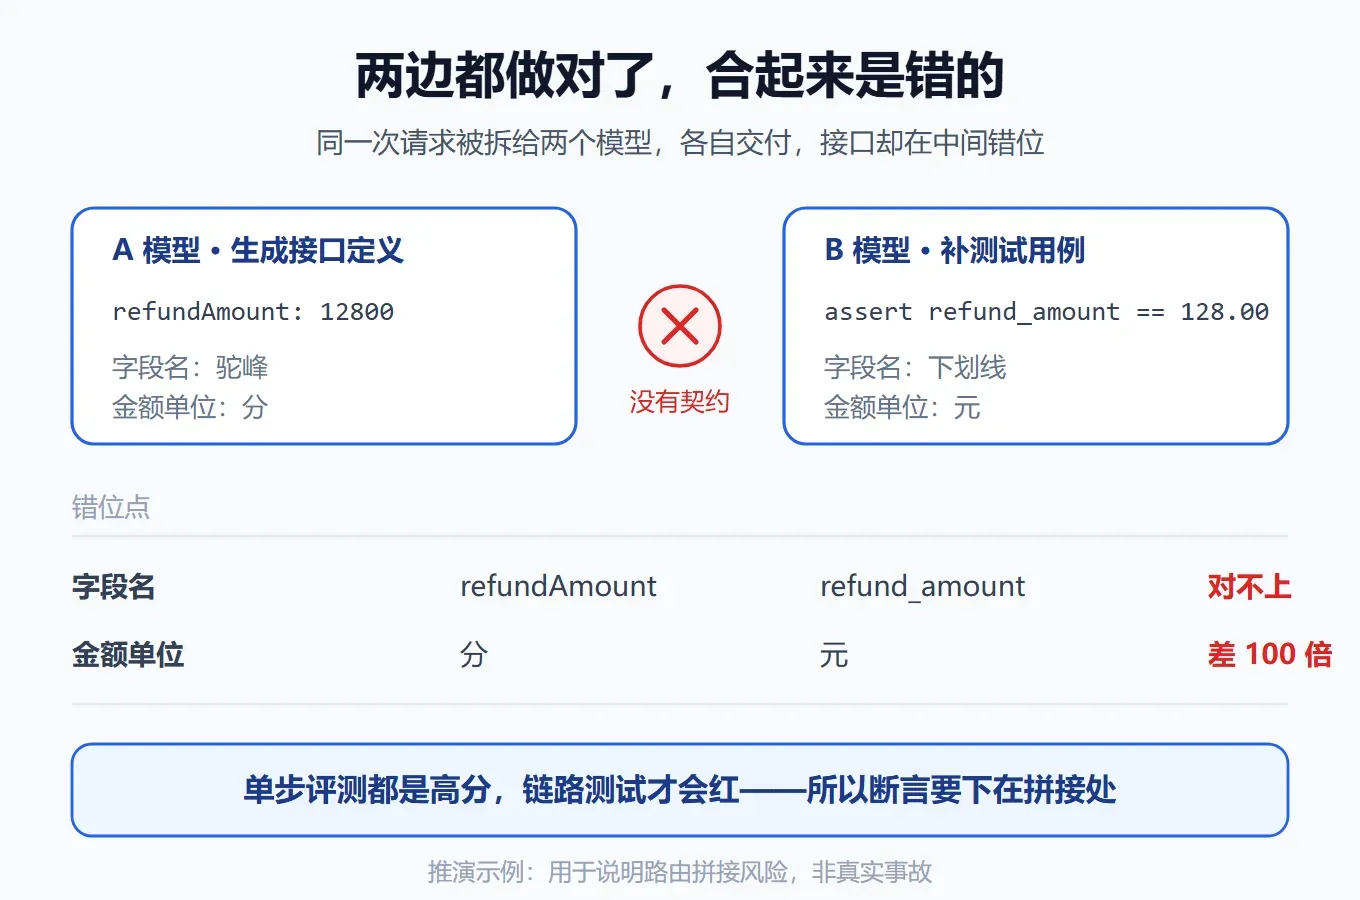
这类问题的特点是:它不在任何一个模型的评测里,只在拼接处。所以路由测试必须有一条"端到端任务"用例,专门验证多模型协作时的契约一致性,而不是只测单步能力。
策略变更也要灰度
路由策略本身是一次发布:新增一个模型、调整一次权重、改一条任务分类规则,都会改变线上行为。它应该像代码一样灰度。
可行的做法是三层:先按任务类型灰度(只让"代码补全"走新策略,不动"调试");再按租户或仓库灰度(内部项目先跑一周);最后按比例放量,同时盯三个指标——任务完成率、P95延迟、单位任务成本。任何一个指标连续两天劣化超过阈值,自动回退到旧策略。
回退条件要提前写死,不能等出事再讨论。因为路由出问题时,最典型的症状不是报错,而是"慢了一点、贵了一点、答得差了一点"——没有预设阈值,没人会为此叫停。
小团队如果只能做两件事,就做这两件:把选中模型记进日志,把任务完成率按模型分组统计。前者让你能复盘,后者让你能在模型被替换时第一时间发现异常。其余指标可以等调用量上来再补。
边界:不是所有团队都需要路由
如果你们的调用量小、任务单一,固定一个模型加人工切换更省心——路由带来的复杂度,只有在大规模、多任务类型时才能被收益抵消。另外,benchmark 差两分不等于业务可接受,索引衡量的是任务完成度,不衡量你的合规话术、你的拒答边界、你的品牌语气。厂商说"便宜一半",前提是路由判断准确;判断错了,重跑一次的成本会把这笔账吃回去。
测试在这件事上的价值,是把"系统自己做的决定"变成"可以被检查的决定"。这和你当年给推荐系统做策略测试、给风控做规则测试是同一种工作:不是替系统做选择,而是确保每一次选择都有据可查、有边界可守。
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。