摘要:Native 模式下,Flink 内置了 Kubernetes 客户端,自己创建自己需要的 Pod。于是出现一条不对称的分界线:JobManager 交给 Deployment 管理,TaskManager 却是一群不受控制器约束的裸 Pod。这条分界线决定了谁负责补 Pod、Pod 叫什么名字、删除集群时谁跟着一起消失。本文基于 Flink 2.3 官方文档,拆解 Native Kubernetes 的三层平面、对象拓扑、权限链与入口配置。
一、先看两种不一样的 Pod 名字
在一个 Native Kubernetes 集群里执行 kubectl get pods,输出大致是这样的:
$ kubectl get pods
NAME                          READY   STATUS    RESTARTS   AGE
my-cluster-7d9f8b6c4-x2vqn    1/1     Running   0          2d
my-cluster-1-0                1/1     Running   0          26h
my-cluster-1-1                1/1     Running   0          26h
第一行是 JobManager 的 Pod,名字里带着 ReplicaSet 的哈希和一段随机后缀——这是 Deployment 派生 Pod 的标准命名,说明它由 Kubernetes 控制器管理。
后面几行是 TaskManager 的 Pod,名字干净得反常:没有哈希,没有随机段,就是 集群名-数字-数字。这不是 Kubernetes 起的名字,是 Flink 自己拼的。
一个集群里,两种命名体系并存,本身就是线索:这个集群的 Pod 不全归 Kubernetes 管。要看懂 Native 模式,得先弄清楚"谁在创建 Pod"这个问题。
从名字入手不是雕虫小技。排查时,JobManager 的 Pod 名每次重建都会换,要靠 label 才能稳定定位;TaskManager 的名字反而能直接读出信息——属于哪个集群、第几次作业尝试、实例序号是多少,kubectl logs 跟上去就能对上故障时间线。名字是两边设计哲学的第一个断面:一边是 Kubernetes 的"实例无状态、可替换",一边是 Flink 的"实例有身份、有归属"。
二、Native 的坐标:Flink 自带一把 Kubernetes 的钥匙
Flink 上 Kubernetes 有三条路。Standalone 形态把 Flink 当普通容器应用,先手工搭好 Deployment 再启动进程,扩缩容全靠 K8s 侧操作;Flink Kubernetes Operator 引入自定义资源,由 Operator 控制器代管集群全生命周期;而 Native 模式是第三条路——Flink 进程自己内置 Kubernetes 客户端,直接调用 API Server 创建和删除所需的资源对象。
官方文档对 Native 模式有一句关键描述:Flink 能够根据所需资源动态地申请和释放 TaskManager,因为它可以直接和 Kubernetes 对话。这句话有两层含义:
- 不需要额外组件。不用装 Operator,不用定义 CRD,Flink 2.3 内置的 Fabric8 Kubernetes 客户端就是全部依赖。一条命令即可起一个集群:
# 以 Application 模式启动,main() 在集群内执行
$ ./bin/flink run \
    --target kubernetes-application \
    -Dkubernetes.cluster-id=my-cluster \
    -Dkubernetes.container.image.ref=custom-image-name \
    local:///opt/flink/usrlib/my-flink-job.jar
- 创建 Pod 的决策权在 Flink 手里。什么时候需要新 TaskManager、需要几个,由 Flink 的 ResourceManager 根据资源缺口计算;Kubernetes 只负责把"有人申请的 Pod"调度到节点上跑起来。
两种部署模式在 Native 下各有自己的入口。Application 模式的 main() 在集群内执行,用户代码必须能被 JobManager Pod 拿到——打进镜像的 usrlib 目录,或者走 artifact 上传,由 Flink 在部署时把本地 JAR 传到远端存储、再在 Pod 内拉取。Session 模式则用专门的启动脚本:
# 启动 Session 集群(默认 detached,部署完即退出)
$ ./bin/kubernetes-session.sh -Dkubernetes.cluster-id=my-cluster

# 向已存在的 Session 提交作业
$ ./bin/flink run \
    --target kubernetes-session \
    -Dkubernetes.cluster-id=my-cluster \
    ./examples/streaming/TopSpeedWindowing.jar

# 重新接管一个运行中的 Session(attached 模式)
$ ./bin/kubernetes-session.sh \
    -Dkubernetes.cluster-id=my-cluster \
    -Dexecution.attached=true
detached 与 attached 的区别值得留意:detached 下脚本提交完就退出,集群留在那里继续跑;attached 下脚本保持连接,可以输入 stop 主动停掉 Session 集群。无论哪种方式,客户端都只是"起点",不参与集群运行期的任何决策。
把两个角色放到一张图上,Native 模式就是三个平面加两条调用方向:
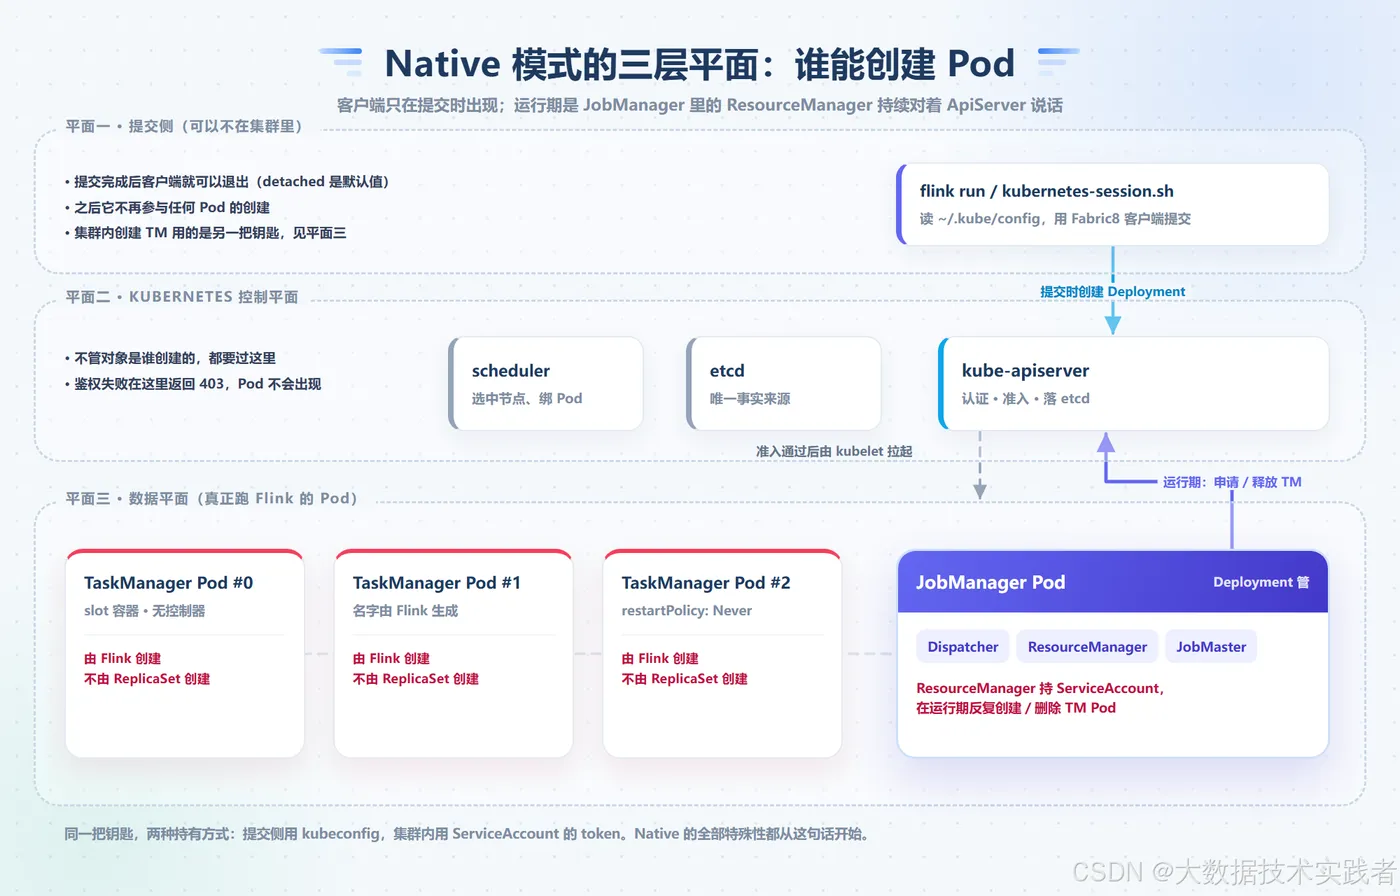
注意图中右侧那条紫色回路:运行期反复申请与释放 TaskManager 的,不是提交命令的客户端,而是 JobManager 进程里的 ResourceManager。两处调用走的是同一个 API Server,但网络路径和凭据完全独立。Flink 侧的客户端 IO 线程池默认只有 4(kubernetes.client.io-pool.size),大规模集群上 Pod 频繁启停时,还可以通过 JobManager 的 JVM 参数调大 Fabric8 客户端的最大并发请求数(kubernetes.max.concurrent.requests)。客户端在提交完成后就可以退出(detached 是默认值),后续所有 Pod 的创建都发生在集群内部。这解释了为什么 JobManager 的 Pod 需要被授予 Kubernetes API 的访问权限——它不只是个服务端,它同时还是一个控制器。
三、一条不对称的分界线
弄清了"谁在调 API",就能看懂 Native 集群的对象拓扑。它像一条分界线,把 Pod 分成了待遇完全不同的两半:
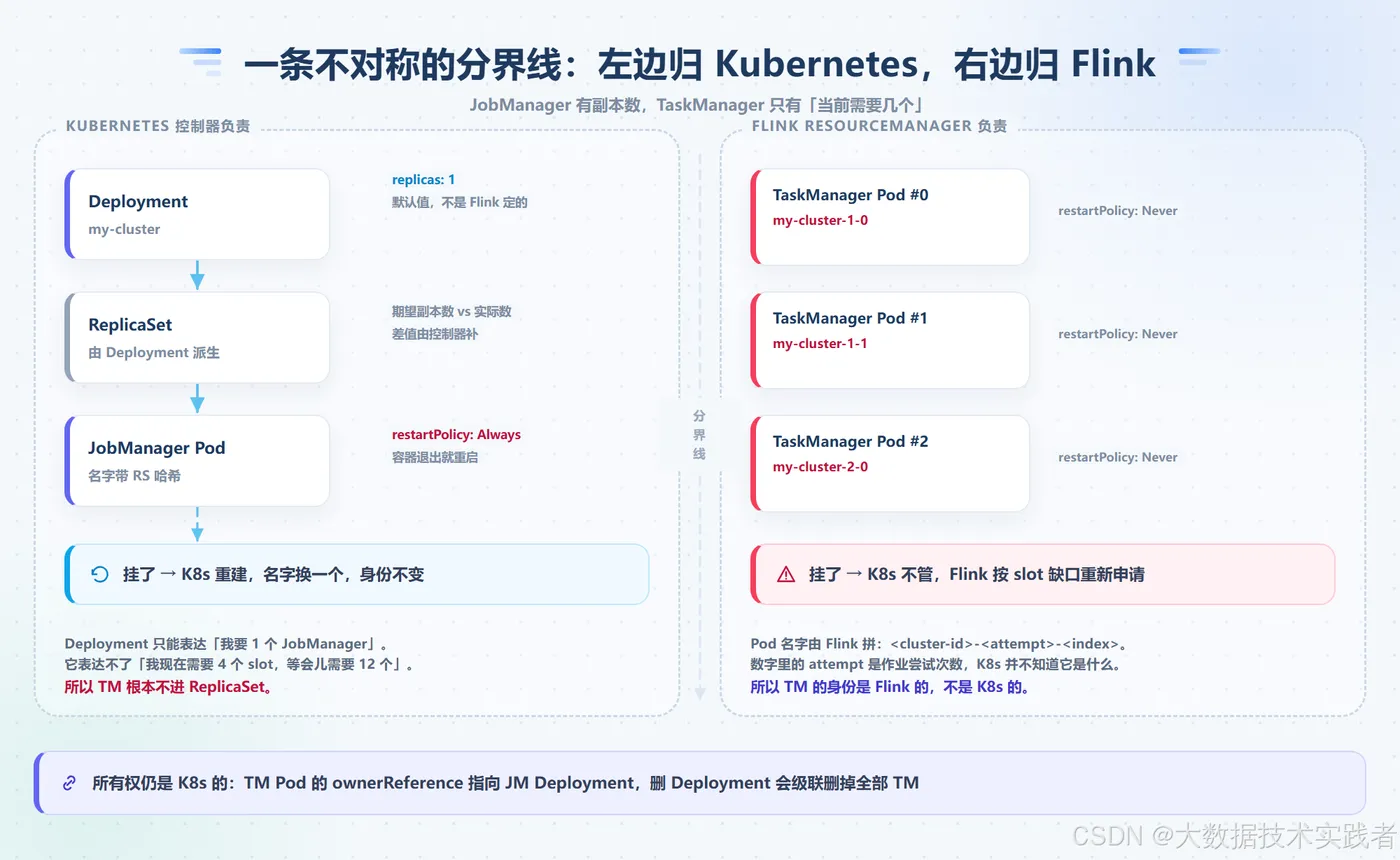
左边这一半归 Kubernetes 控制器。 JobManager 以 Deployment 形态部署,kubernetes.jobmanager.replicas 默认值为 1;Deployment 派生 ReplicaSet,ReplicaSet 保证始终有一个 JobManager Pod 在运行。Pod 的 restartPolicy 被硬性设为 Always,容器退出就重启。
右边这一半归 Flink。 TaskManager 是 ResourceManager 逐个调用 API 创建出来的裸 Pod——不经过 ReplicaSet,没有副本数概念,restartPolicy 被硬性设为 Never,容器退出后 Kubernetes 不会重启它。
为什么不让 TaskManager 也走 Deployment?因为副本数模型表达不了 slot 需求。Deployment 只能声明"我要 N 个一模一样的实例",这个 N 是静态期望;而 Flink 需要的是"根据当前作业的资源缺口动态决定起几个",这个数随时在变,甚至在作业结束后要主动缩回零。Native 模式的本质,就是把 TaskManager 的数量决策从 Kubernetes 的声明式模型手里拿回来,交给 Flink 自己的调度逻辑。
这个设计带来三个直接后果:
- TaskManager 挂了,Kubernetes 不会补,补位的是 Flink 的 ResourceManager(下一节展开)。
- Pod 名字里的数字是 Flink 的语义。命名格式为
<cluster-id>-<attempt>-<index>,其中 attempt 是作业的尝试次数,Kubernetes 完全不知道它是什么。Pod 的身份是 Flink 视角的,不是 Kubernetes 视角的。 - 所有权仍在 Kubernetes 手里。每个 TaskManager Pod 的 ownerReference 都指向 JobManager 的 Deployment,因此
kubectl delete deployment/my-cluster会级联删除所有 TaskManager Pod——集群的删除入口收敛在一个对象上,不会留下孤儿 Pod。
这条分界线在故障时刻最有存在感。JobManager 挂了,走的是 Kubernetes 的路:Deployment 发现实际副本数是 0,立即重建,通常秒级拉起,之后再由 HA 机制(如果启用了)完成状态接管;TaskManager 挂了,Kubernetes 毫无反应,要等 Flink 的 ResourceManager 走完"发现—补位"的链路。运维同学报障时说的"Pod 重启了"和"Flink 在重新申请资源",背后就是这两套不同的机器。分不清谁管谁,排障时就会对着一侧空等的日志干着急。
四、一个 TaskManager 消失之后
裸 Pod 意味着 Kubernetes 的自愈机制对 TaskManager 失效。那它挂了之后靠什么恢复?五步走完:
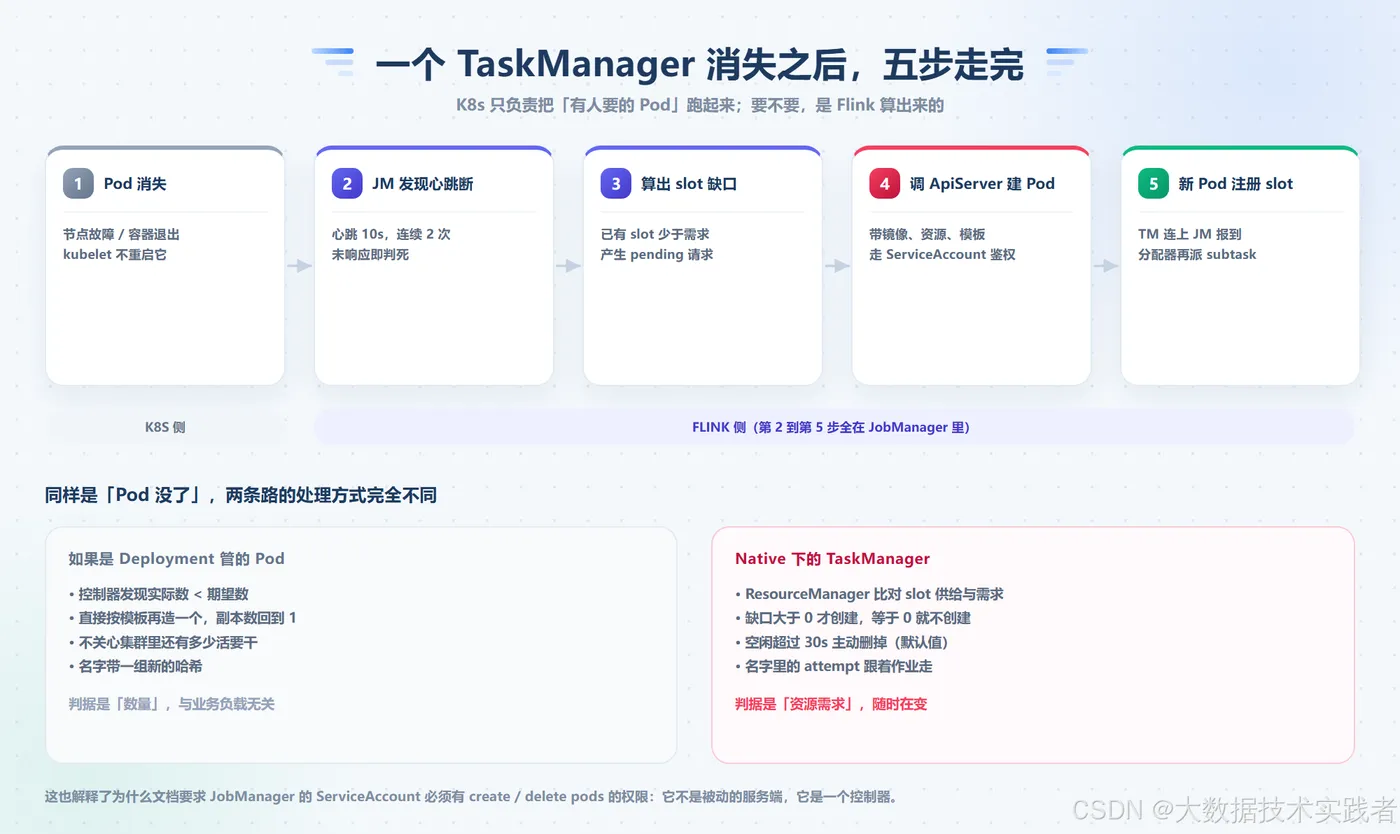
第 1 步,Pod 消失。节点故障或容器异常退出,restartPolicy: Never,kubelet 不会拉起它。
第 2 步,JobManager 发现心跳断。TaskManager 与 JobManager 之间的心跳间隔为 10 秒,连续 2 次未响应即判定失联。
第 3 步,算出 slot 缺口。失去的 slot 导致供给小于需求,ResourceManager 生成新的资源请求。
第 4 步,调 API Server 创建新 Pod。携带镜像、CPU、内存与 Pod 模板信息,走 JobManager 所挂 ServiceAccount 的鉴权。新 Pod 名字里的 attempt 递增,与旧 Pod 区分开。
第 5 步,新 Pod 注册 slot。TaskManager 启动后连上 JobManager 报到,slot 分配器再把 subtask 派下去。
同样是"Pod 没了",两条路径的判据完全不同:Kubernetes 控制器的判据是数量——实际副本数小于期望值就补,与业务负载无关;Flink 的判据是资源需求——缺口大于零才创建,等于零就不创建。反过来,当 TaskManager 空闲超过 resourcemanager.taskmanager-timeout(默认 30 秒),ResourceManager 还会主动删掉它释放资源。能伸能缩,这正是官方所说的 "dynamically allocate and de-allocate"。
这也顺带解释了一个故障排查经验:如果日志里出现创建 Pod 的 403 错误,问题不在 Kubernetes 调度,而在权限——这就引出下一节。
还有一个排查时容易扑空的场景:想看某个 TaskManager 的日志,kubectl logs 下去发现 Pod 已经不在了。原因正是动态回收——空闲的 TaskManager 超时后被 ResourceManager 删除,日志随之消失。文档给出的建议很直接:把 resourcemanager.taskmanager-timeout 调大,给排查留出足够的时间窗。平时它是省资源的功臣,排查时它是毁尸灭迹的帮凶,这个参数值得写进团队的排障手册。
五、ServiceAccount:Flink 的钥匙串
Native 模式下有两套凭据,不能混用:提交侧的客户端读 ~/.kube/config;集群内的 JobManager 用的是挂进 Pod 的 ServiceAccount token。线下能跑、线上 403,基本都是后者没配对。
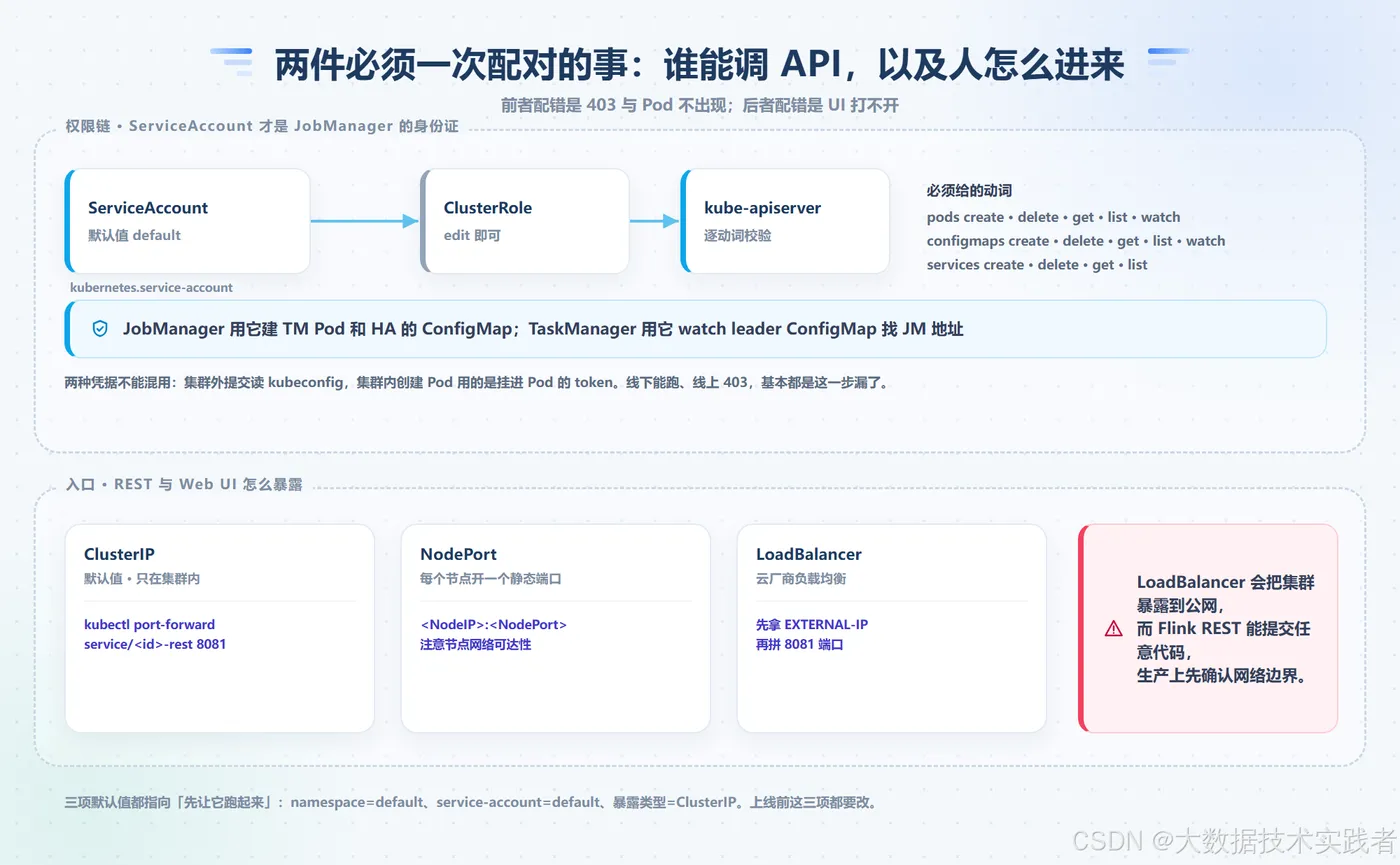
需要的权限动词很明确:对 pods 和 configmaps 的 create、delete、get、list、watch,外加 services 的增删查。JobManager 用这把钥匙创建 TaskManager Pod 和 HA 场景下的 leader ConfigMap;TaskManager 则要用它 watch leader ConfigMap,从中读取 JobManager 和 ResourceManager 的地址。默认的 ServiceAccount 是 default,多数生产命名空间里它并没有这些权限,需要显式绑定:
$ kubectl create serviceaccount flink-service-account
$ kubectl create clusterrolebinding flink-role-binding-flink \
    --clusterrole=edit \
    --serviceaccount=default:flink-service-account
然后把钥匙交给 Flink:
kubernetes.service-account: flink-service-account
入口侧同样要一次配对。REST 端点与 Web UI 通过 kubernetes.rest-service.exposed.type 暴露,默认值 ClusterIP 只在集群内可达,本地访问要借助 port-forward:
$ kubectl port-forward service/my-cluster-rest 8081
NodePort 在每个节点开静态端口,LoadBalancer 则由云厂商分配外部 IP。注意 LoadBalancer 会把 Flink 的 REST 接口暴露到集群外,而 REST 接口具备提交作业的能力——等于把任意代码执行权挂上了网络,生产环境务必先确认边界。
权限本身也可以再收紧一步。上面的示例用的是 edit 这个 ClusterRole,作用域是整个集群;更规范的做法是在 Flink 专用命名空间里建 Role 和 RoleBinding,把 Flink 的创建权限限制在自己的 namespace 内。多团队共用一个 Kubernetes 集群时,这一步不是洁癖,是必答题——毕竟这把钥匙的持有者可以在运行期无限制地创建和删除 Pod。
六、五个容易踩的配置点
第一,Pod 模板的字段分三类。 kubernetes.pod-template-file.default 允许用一份 YAML 定制 JobManager 与 TaskManager 的 Pod,但不是所有字段都听你的:Pod 名、ownerReference、restartPolicy、主容器名这四项由 Flink 硬性覆盖;镜像、ServiceAccount、nodeSelector、tolerations、resources 等由用户定义,且显式配置项的优先级高于模板;labels、env、volumes、容器端口则由 Flink 追加合并。按"显式配置项 > Pod 模板 > 默认值"的顺序解析,改模板不生效时先对照官方的覆盖清单。
第二,CPU 默认值的含义。 kubernetes.jobmanager.cpu.amount 默认 1.0;kubernetes.taskmanager.cpu.amount 默认 -1.0,表示等于 taskmanager.numberOfTaskSlots——slot 数既是内存隔离单元,也是默认的 CPU 申请数。这两个数在 requests 与 limits 上同时生效,还有 limit-factor 系列参数可以单独放大 limits。
第三,三项默认值都指向"先跑起来"。 namespace 是 default,ServiceAccount 是 default,暴露类型是 ClusterIP。学习时省事,上线前这三项都要替换成专属值。
第四,敏感信息与持久化有现成的路。 Secrets 可以以文件形式挂进 Pod,也可以注入为环境变量,数据库口令、访问凭证都不该打进镜像:
# Secret 挂载为文件:/opt/secrets 下会出现 username 与 password 两个文件
$ ./bin/kubernetes-session.sh \
    -Dkubernetes.secrets=mysecret:/opt/secrets

# Secret 注入为环境变量
$ ./bin/kubernetes-session.sh \
    -Dkubernetes.env.secretKeyRef=env:SECRET_USER,secret:mysecret,key:username
需要本地盘之外的真实持久化时,kubernetes.persistent-volume-claims 可以把 PVC 直接挂到 JobManager 与 TaskManager 的 Pod 上。
第五,日志配置是活的。 Flink 把 log4j-console.properties 与 logback-console.xml 以 ConfigMap 形式暴露给 Pod,改日志级别不用重建镜像、也不用重启集群:
$ kubectl edit cm flink-config-my-cluster
改完只对新启动的集群生效,所以要配合滚动重建窗口使用。同样不必改镜像的还有插件:containerized.master.env.ENABLE_BUILT_IN_PLUGINS 与 containerized.taskmanager.env.ENABLE_BUILT_IN_PLUGINS 设成 flink-s3-fs-hadoop-2.3.0.jar,即可在两侧 Pod 启用内置的 S3 文件系统插件。
七、裸 Pod 的代价与 Native 的边界
裸 Pod 还有一个隐性代价:状态恢复永远走远端。TaskManager 的本地恢复依赖"重建后的 Pod 还能用原来的节点与本地盘",而裸 Pod 重建后名字换了、节点未必相同、本地目录更是全新的,所以 Native 下的 TaskManager 恢复总是从远端 checkpoint 读取全量状态。作业越大,这个恢复窗口越长——这是动态伸缩用空间换来的灵活性,选型时要算进 RTO 里。
Native 模式把"创建与删除"做到了极致,但它刻意不做另外几件事:没有滚动升级编排,改镜像要删掉集群重建;没有 savepoint 触发与状态迁移的自动化;没有跨版本升级的回滚机制。这些"生命周期管理"的活,正是 Flink Kubernetes Operator 的职责范围——Operator 同样支持 Native 部署形态,在其之上补齐了声明式的升级、回滚与 savepoint 编排。
一句话总结 Native Kubernetes 架构:Flink 拿着 ServiceAccount 这把钥匙,把 Kubernetes 当成一个"按申请交付 Pod"的资源池。JobManager 交给 Deployment 保活,TaskManager 由自己的 ResourceManager 按需伸缩,Kubernetes 保留所有权与调度权,Flink 保留决策权。理解了这条不对称的分界线,后面无论是排查 403、解读 Pod 名字,还是评估要不要引入 Operator,都有了一个稳定的判断原点。
成一个"按申请交付 Pod"的资源池**。JobManager 交给 Deployment 保活,TaskManager 由自己的 ResourceManager 按需伸缩,Kubernetes