
1. 为什么升级?
在上一代架构中,Dataphin非结构化数据处理功能存在着如下几个问题:
- 依赖于一个Kubernetes相关的开源组件Argo,该组件需要运维同学额外部署,增添了部署成本的同时,也有部分客户本身就存在Argo,与Dataphin所需的版本存在冲突;
- 产品内部,用户在配置工作流时需要为每一个算子配置输入和输出数据集,这一限制会导致用户需要提前明确数据集的表结构、创建多个数据集等操作繁琐的问题;
- 用户如果想将某个算子的输出结果同时输出到多个数据集中,当前架构并不支持。
综上所述,Dataphin在V6.4对非结构化的产品架构进行全面升级,让部署更轻量、让操作更简单。
2. 新架构怎么用?
2.1 系统级别配置临时存储
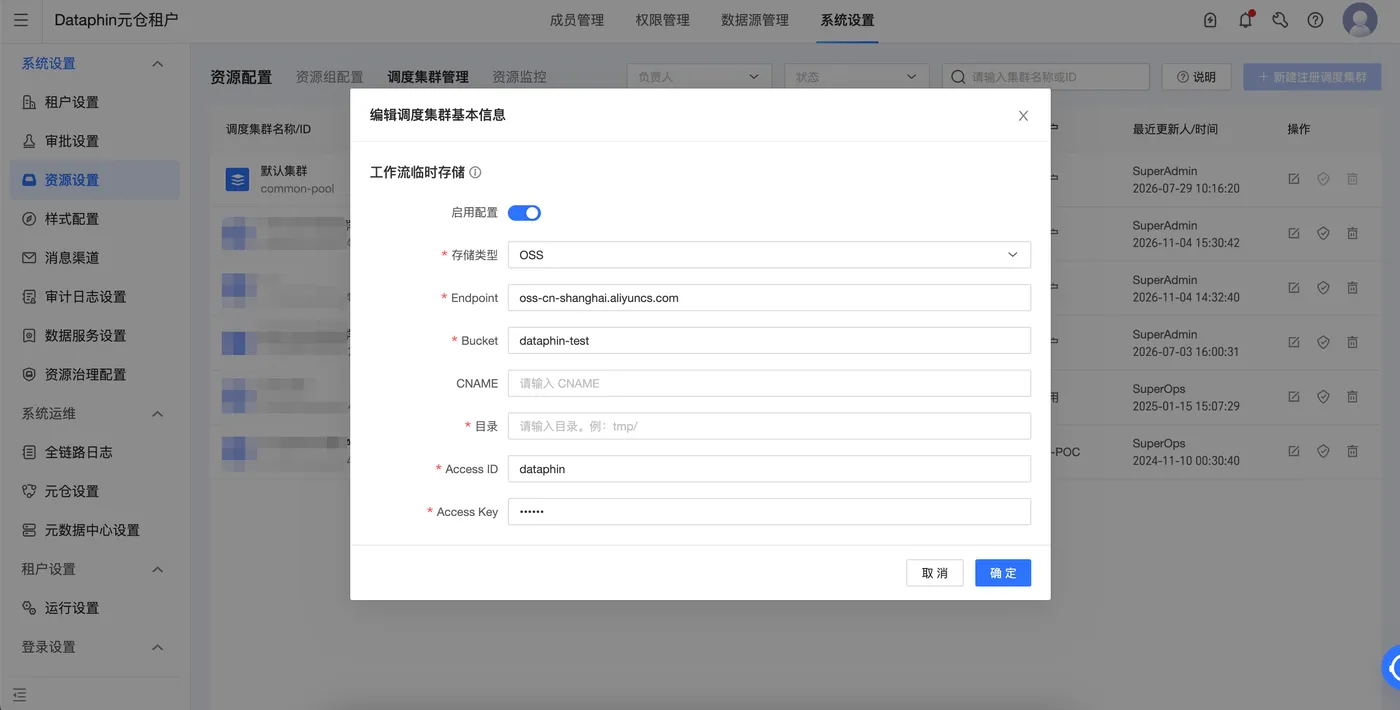
新架构中,管理员需要为Dataphin实例配置系统级别的临时存储地址。(如果您是公共云SAAS的环境,则无需配置,我们会在升级后统一操作。)
临时存储的主要作用是:存放工作流运行中不同算子加工产生的临时数据,从而突破之前老架构中,需要为每个算子配置输出数据集的限制。
操作入口:Dataphin元仓租户-系统设置-资源设置-调度集群管理
2.2 新版工作流
本次架构升级后,数据集的配置未产生任何变化。新版工作流与之前的最大差异是,增加了“读数据集”和“写数据集”两个算子。其中:
- 读数据集:创建工作流时默认存在,不可删除,不可增加;
- 写数据集:需要用户自行添加,一个工作流提交和运行时,至少要存在1个写数据集算子。
2.2.1 读数据集
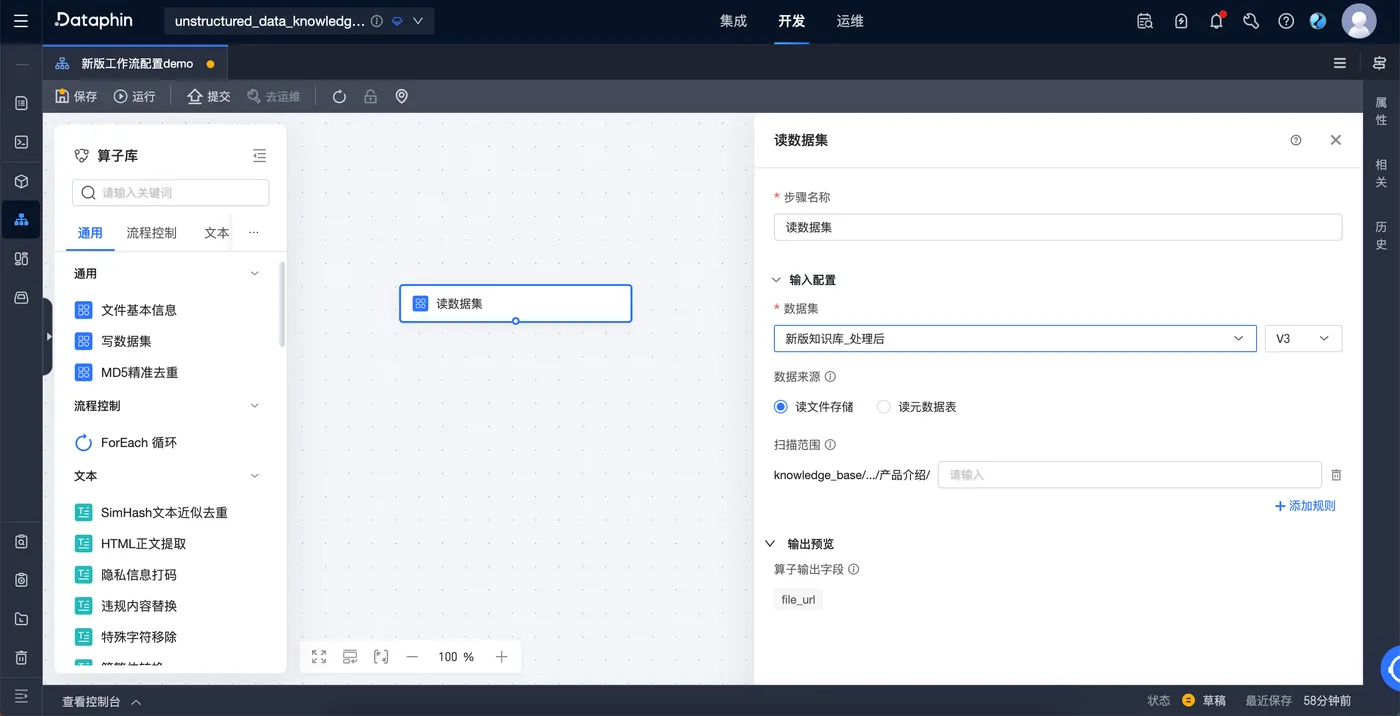
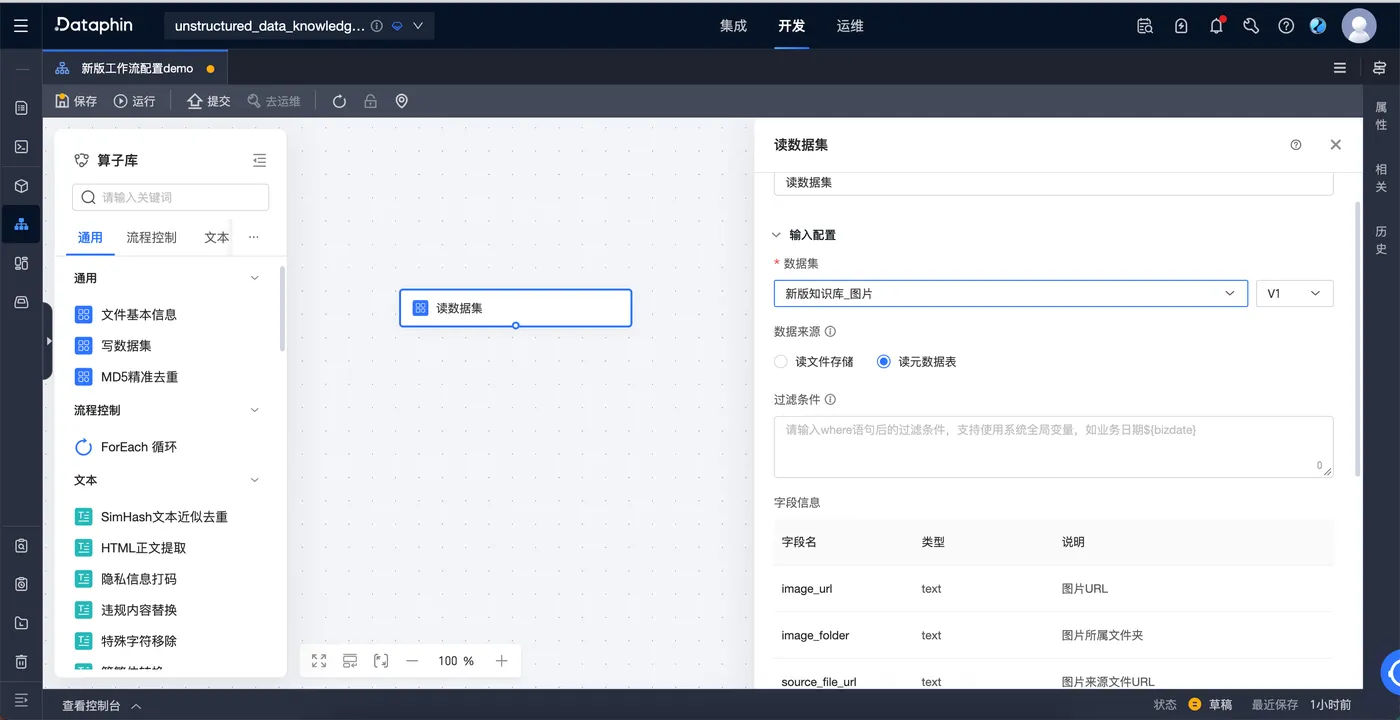
用户需要选择一个数据集作为输入,支持选择所有类型的数据集,包括文件、表和混合数据集。
系统会根据所选数据集的类型,提供数据来源的选项,一共包含“读文件存储”和“读元数据表”两种选项
- 选择【读文件存储】:
- 代表当前工作流的数据来源于所选数据集关联的文件存储系统,系统会根据当前算子配置的扫描范围对指定路径下的文件进行扫描,并获取所有文件的URL,效果等同于老版架构的“文件基本信息”算子;
- 但是与老版架构的“文件基本信息”算子不同的是,“读数据集”仅仅会输出文件的URL,文件的其他信息,比如名称、格式、大小等信息仍需要通过“文件基本信息”算子获取;
- 使用场景:初次对一批文件进行加工和处理,没有对应的元数据表。
-
- 选择【读元数据表】:
- 代表当前工作流的数据来源于所选数据集的元数据表,即不会对文件存储的文件进行扫描;
- 此时“读数据集”算子不会新增任何输出字段,下游算子仅可对所选元数据表的字段进行处理;
- 特殊说明:如果元数据表中的某个字段存储着文件的URL地址,而下游算子需要对指向的文件进行处理,请保证表中URL对应的文件在该数据集的文件存储中,否则系统将无法访问该文件;
- 适用场景:①已存在一张文件元数据表,通过读取表的URL对文件进行处理;②对表中的纯文本进行处理,例如评论情感分析等。
-
2.2.2 其余算子的改动
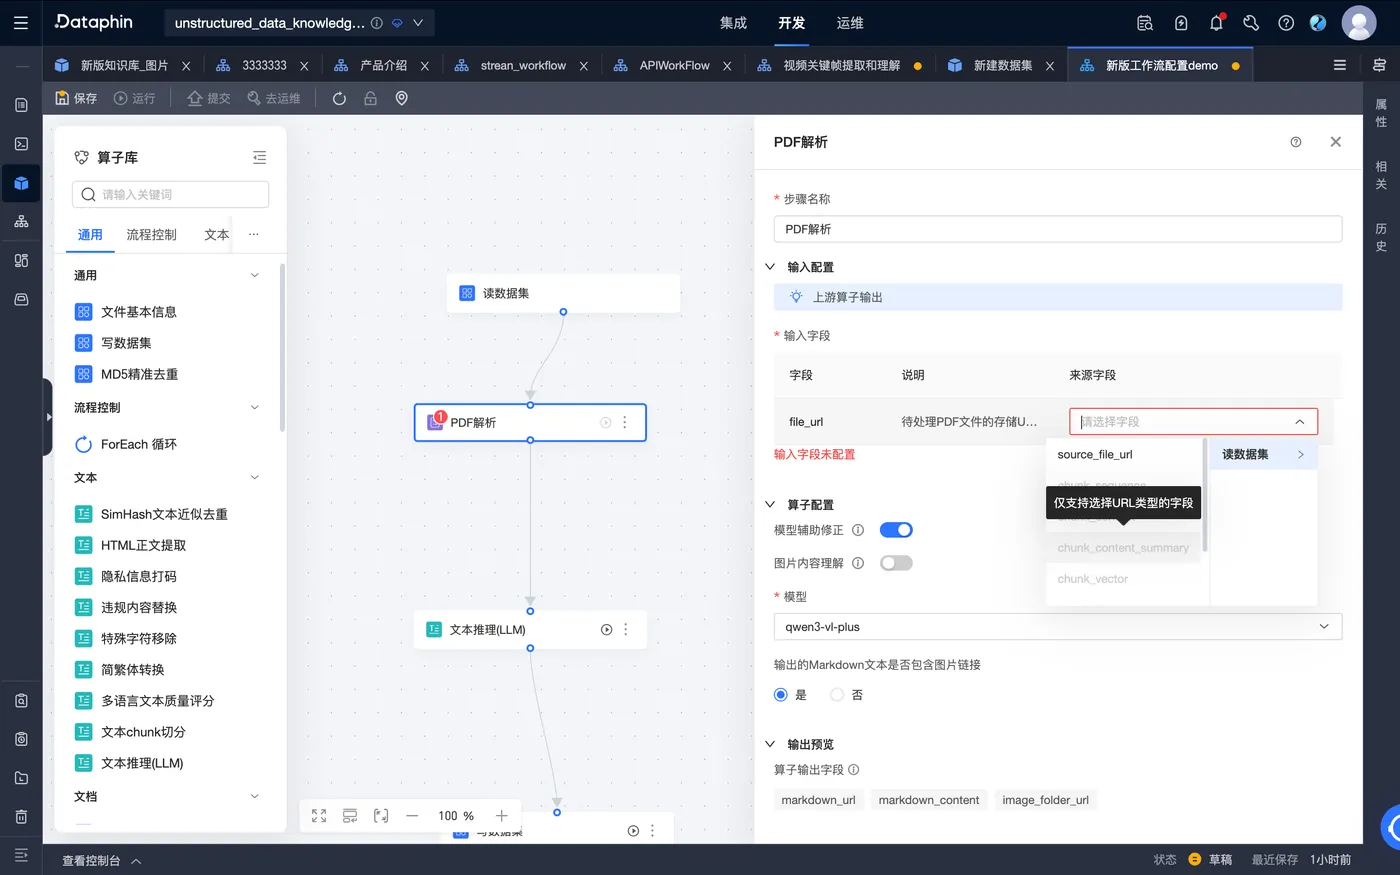
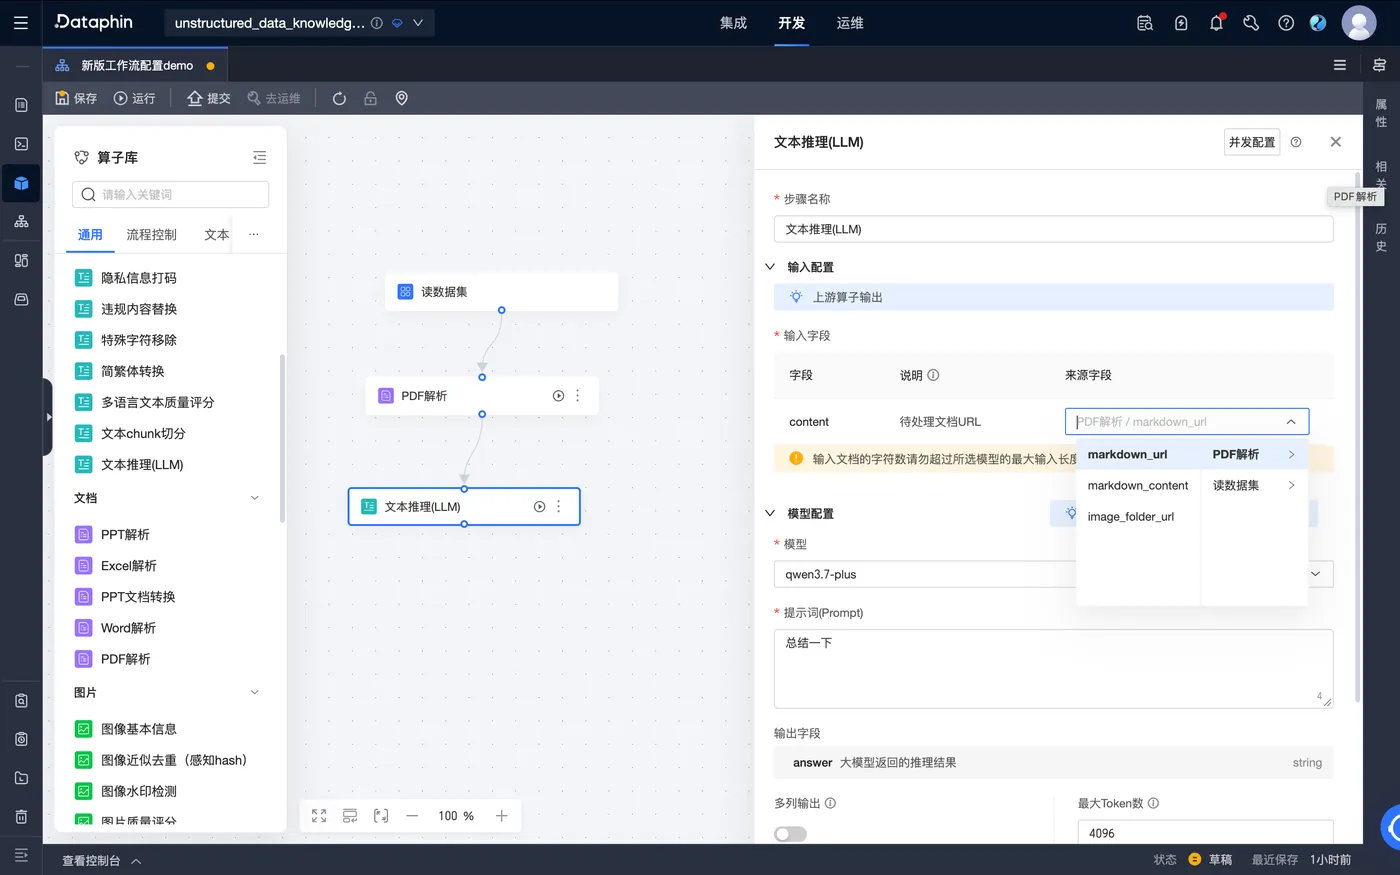
算子的输入字段来源于上游算子的输出字段,不再需要选择输入数据集,如下图:
说明 |
展示 |
“读数据集”算子选择“读文件存储” |
下游PDF解析算子仅可选择“读数据集”的输出字段“file_url”作为输入 |
“读数据集”算子选择“读元数据表” |
下游PDF解析算子可以选择上游算子所选数据集对应元数据表的所有字段(仅可选择URL类型的字段) |
“文本推理”算子 |
“文本推理”算子可以选择对读数据集算子的输出或PDF解析算子的输出进行处理 |
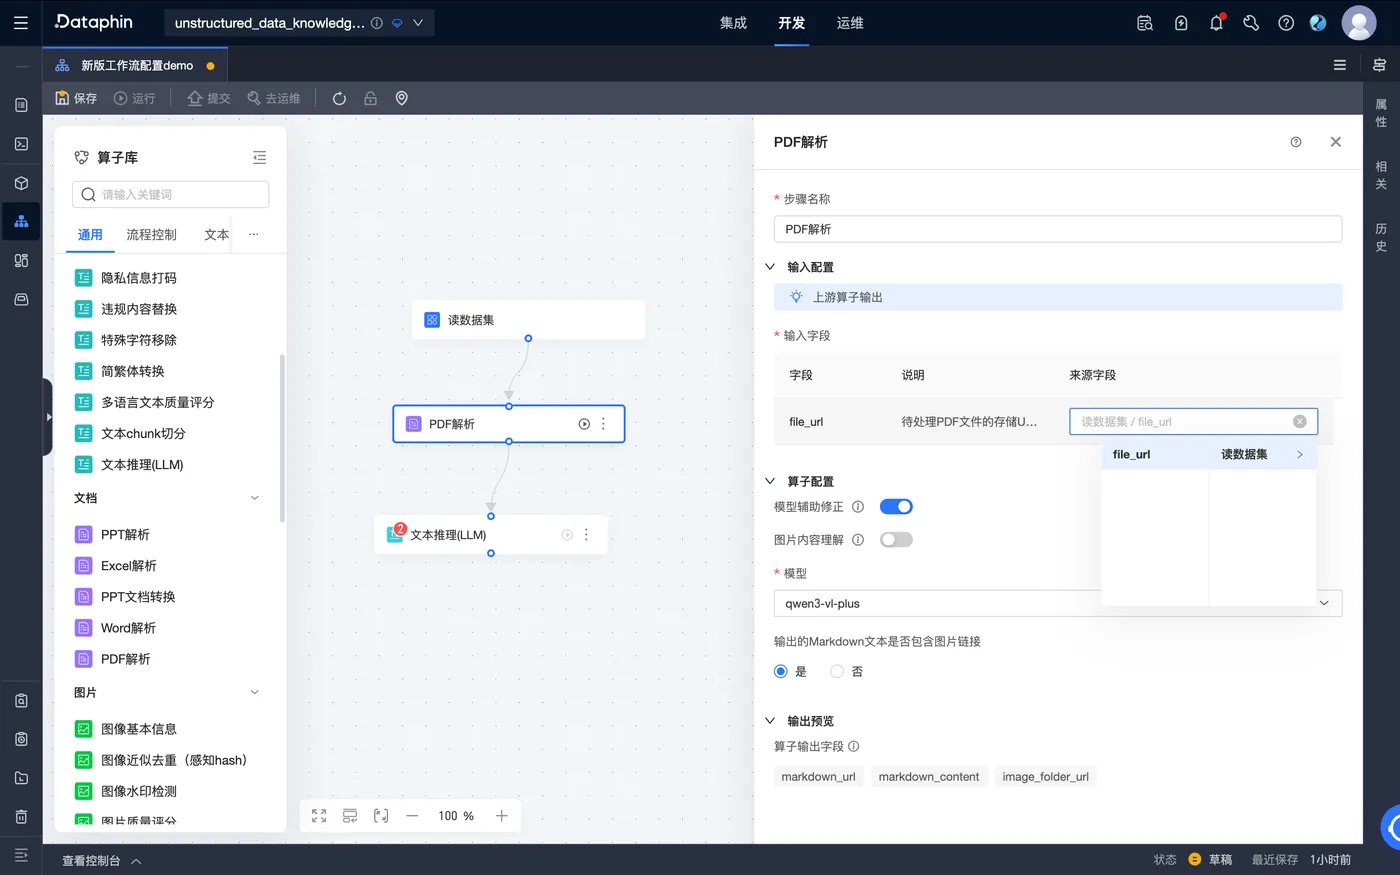
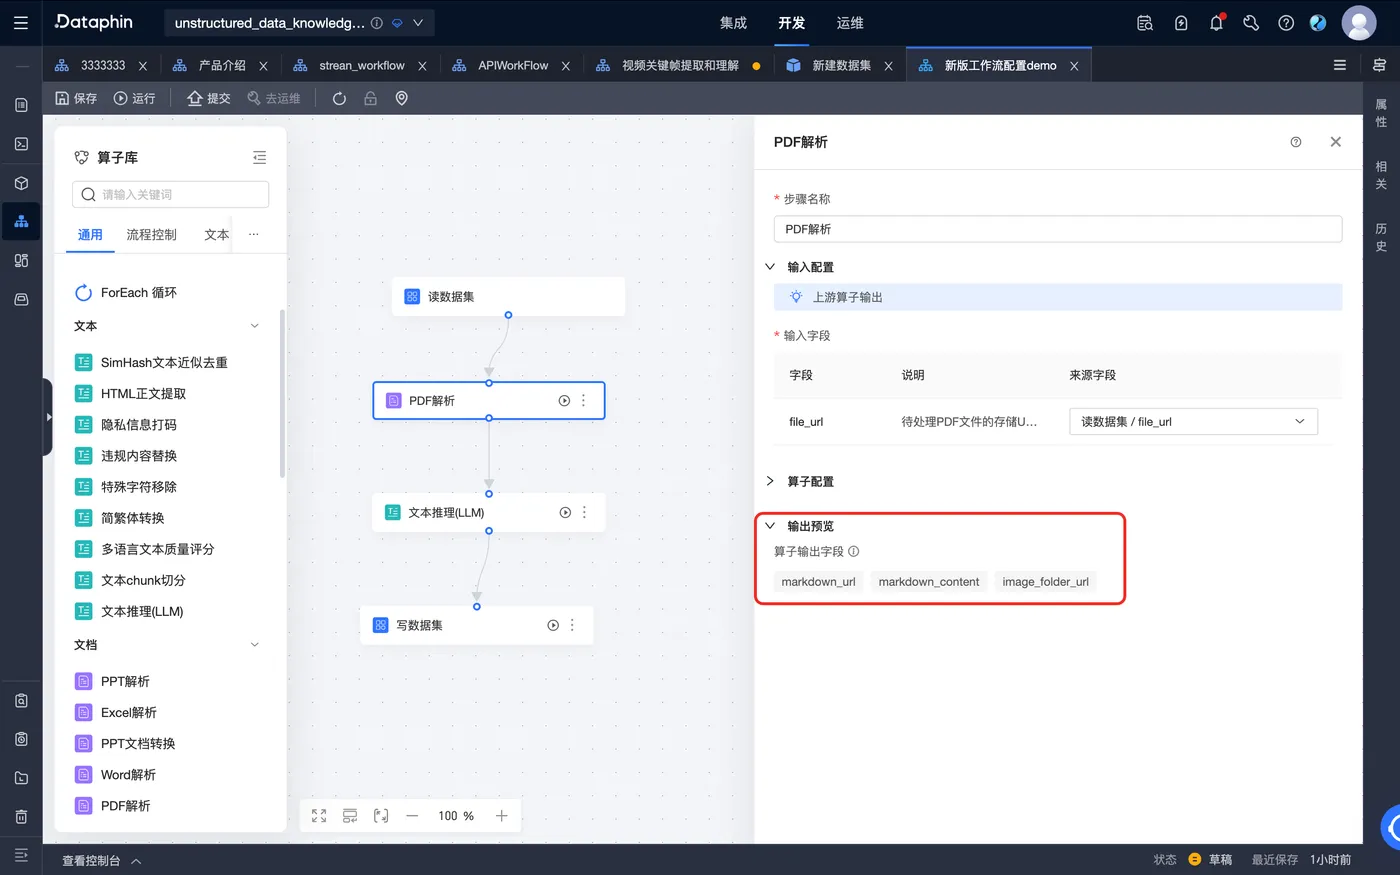
所有算子都增加了输出预览,用户可以通过该信息快速知道当前算子的输出内容,如下图的“PDF解析算子”,会输出三个字段:
- markdown_url:类型: string | 说明: Markdown文件的存储URL
- markdown_content:类型: string | 说明: Markdown文件的内容,过长文本不建议直接落库存储
- image_folder_url:类型: string | 说明: 图片文件夹的存储URL
2.2.3 写数据集
前面提到,一个工作流至少需要具备一个写数据集。本质上是因为,只有在“写数据集”算子中,系统才会真正地将结果输出,其它时候工作流产生的中间结果都是存储在2.1配置的临时存储中。
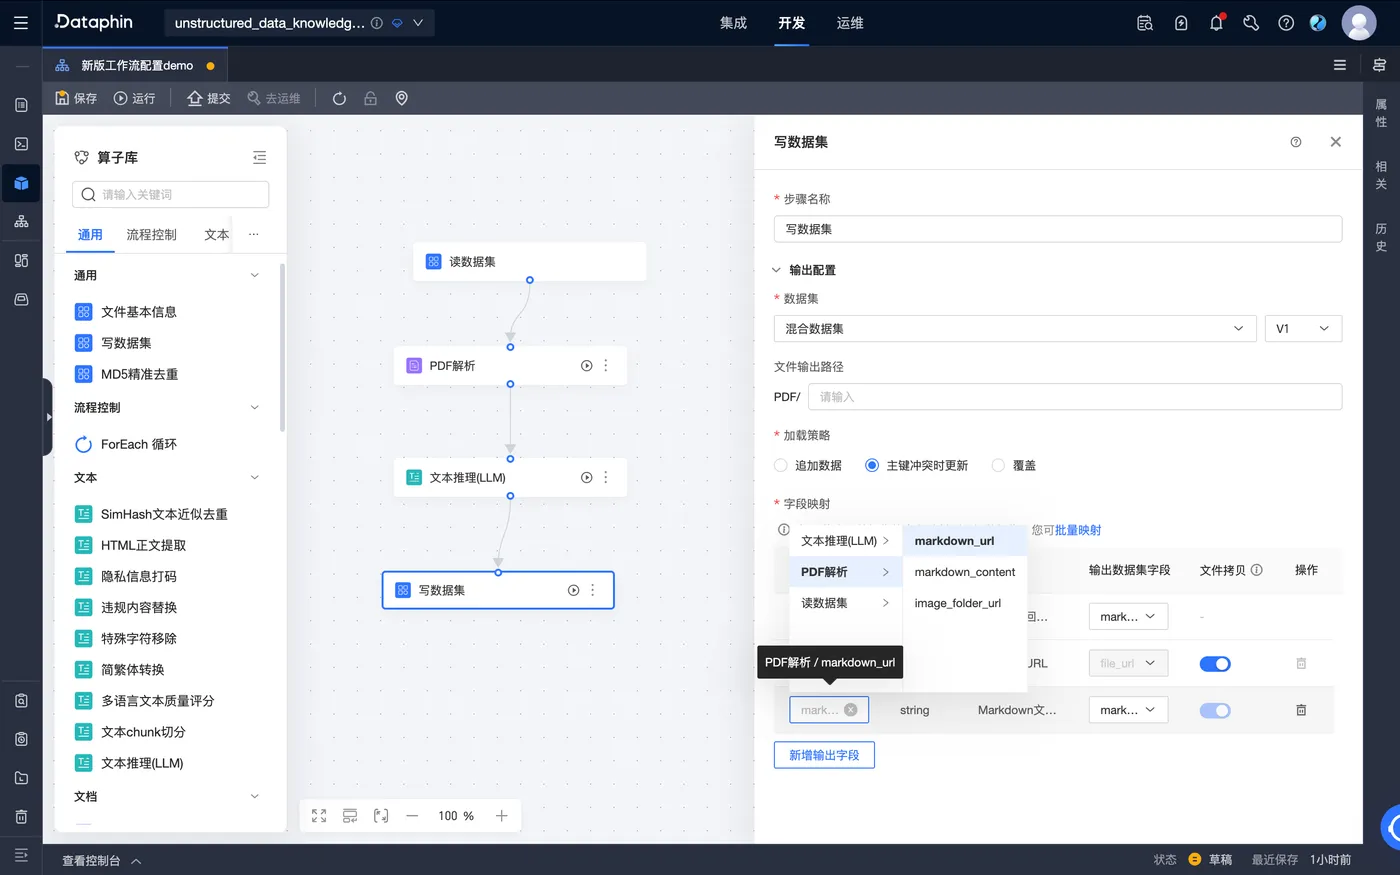
下图是一个常见的PDF解析工作流,首先对PDF进行解析,然后利用大模型对PDF解析后的markdown进行打标,最后将打标结果输出到一张表中。
此时,写数据集会强制输出与它相邻的上游算子的输出字段,不可删除,即文本推理的输出字段answer,用户需要选择输出数据集中哪个字段与answer进行映射。
又因为输出数据集的元数据表是主键表,所以您需要选择上游所有算子的输出字段来与当前输出数据集的主键file_url进行映射。
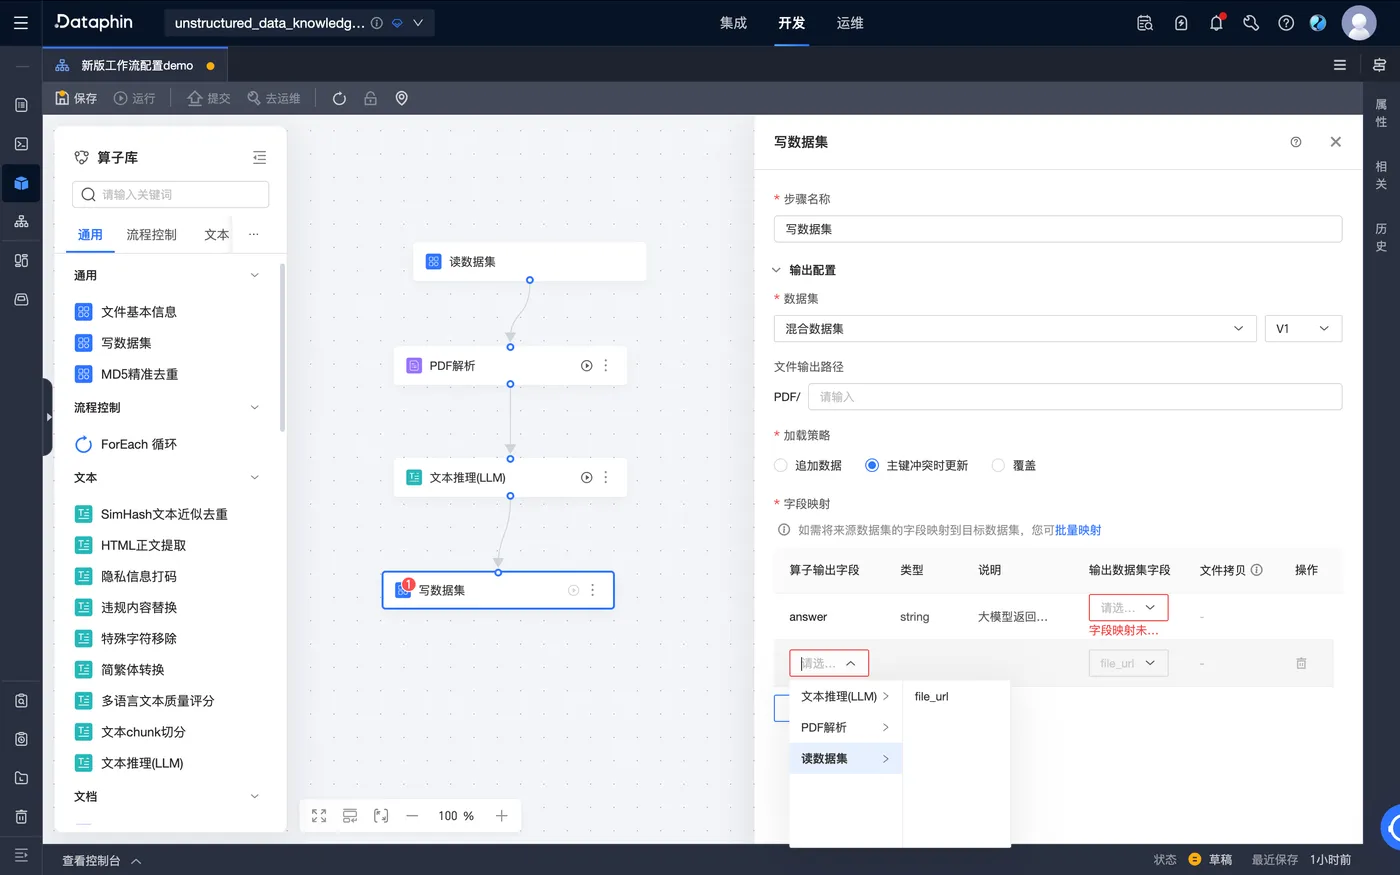
如果您想将中间算子的输出结果也存储到输出数据集中,可以点击“新增输出字段”进行添加。例如,将PDF的解析结果markdown_url及其解析后的markdown文件输出到当前数据集。
相信您一定注意到了,“文件拷贝”这个选项,该选项默认开启,开启后会将markdown_url对应的markdown文件同步拷贝到所选数据集中,同时生成新的markdown_url。
在拷贝前,这些生成的markdown文件是存在2.1所配置的临时存储中,在任务运行完成后就会被销毁,所以当用户选择将markdown_url输出到数据集时,系统会自动将文件拷贝到数据集的文件存储中,不支持关闭。因为一旦关闭了文件拷贝,存储的markdown_url将会指向临时存储中的地址,任务运行后就会被销毁。
2.2.4 一个特殊算子:ForEach 循环
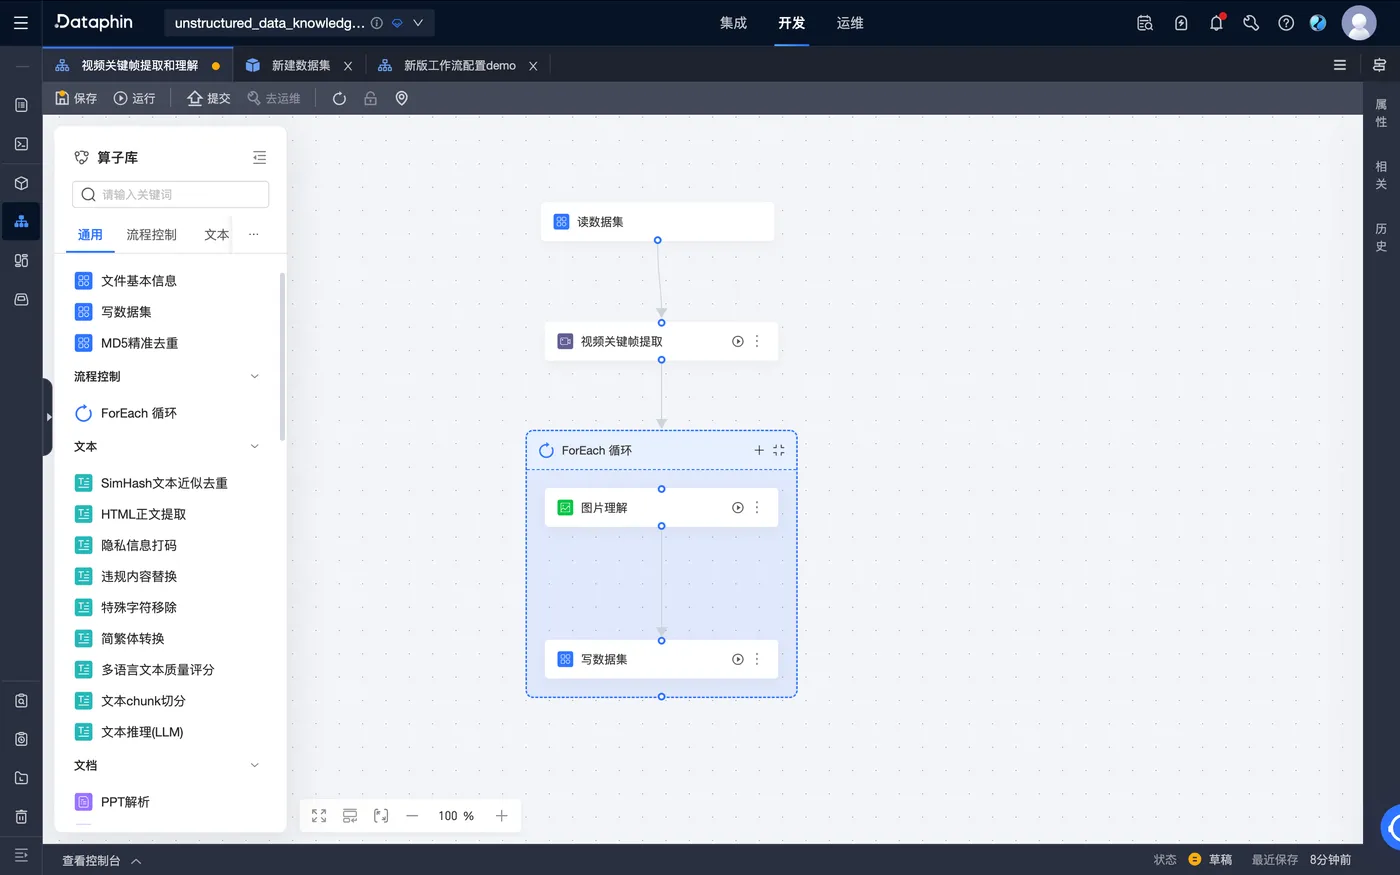
“ForEach循环”算子是本次架构升级引进的新算子,该算子只能用于输入一条输出多条的场景,比如:文本chunk切分、音频切片、视频切片、视频关键帧抽取、PPT文档转换(按页转PNG或按页拆分PPT)。
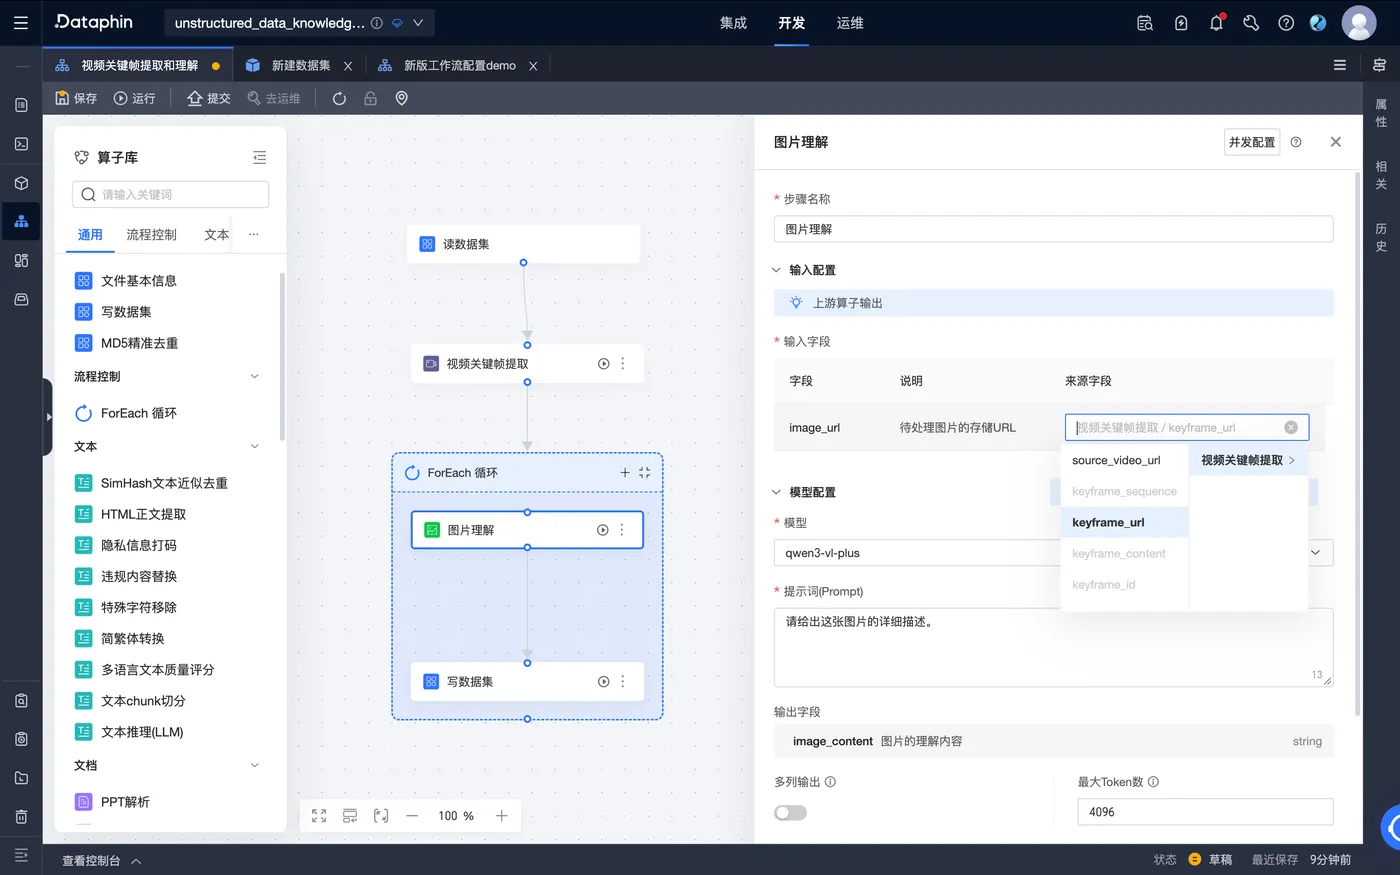
举个场景:您有一段视频,期望通过工作流对视频的关键帧进行处理,同时通过图片理解算子对提取到的每一帧图片进行内容理解。
因为视频关键帧提取算子会从一段视频中提取N张关键帧图片,如果需要对这N张图片进行处理,需要引入ForEach算子进行逐一处理。
说明 |
配置截图 |
右图是完整的工作流配置 |
|
图片理解算子的配置 |
|
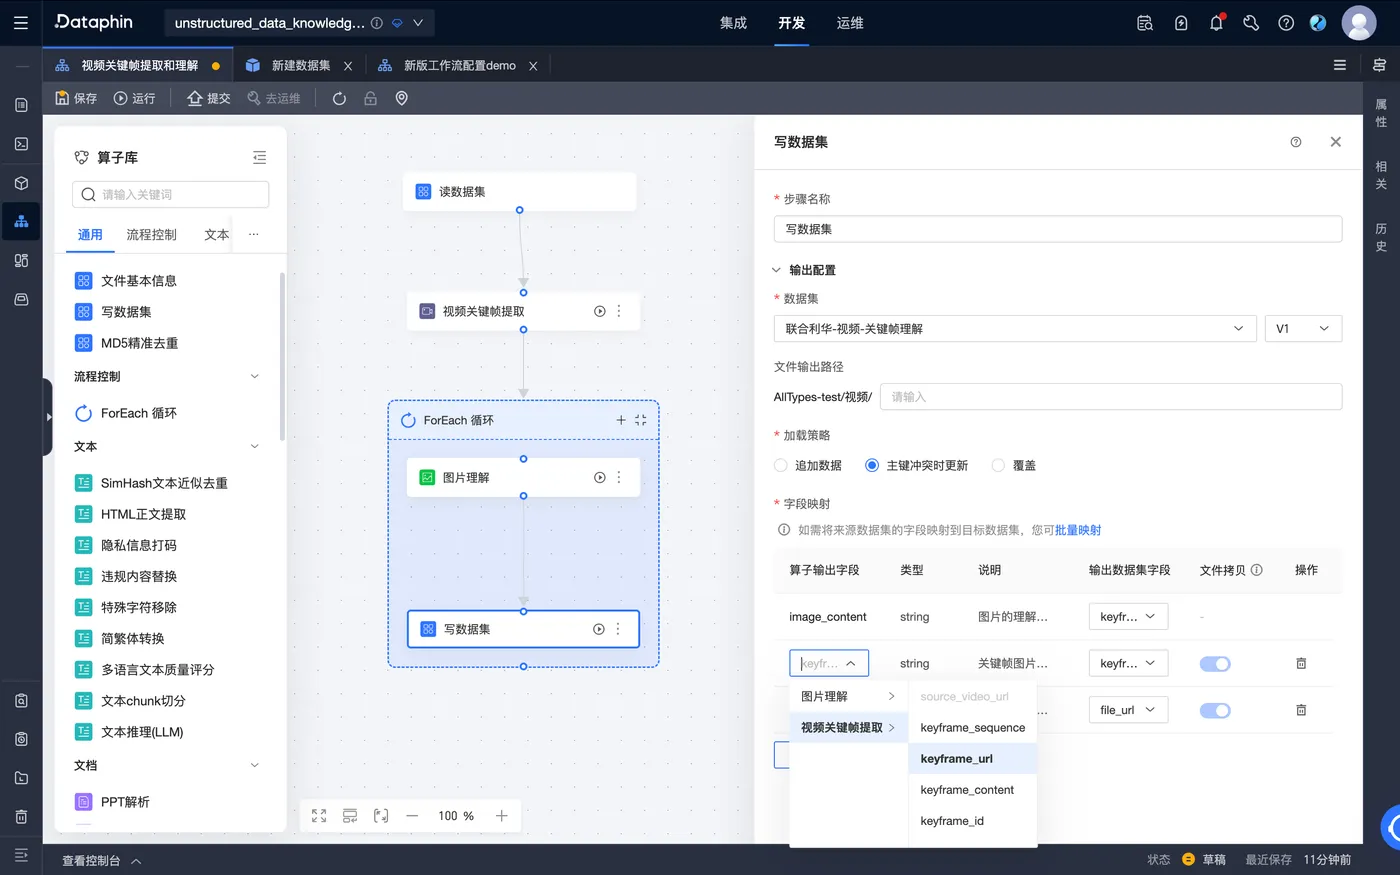
写数据集的配置 |
除了需要将 |
3. 对老架构任务的影响
本次升级后,历史架构的任务仍可正常运行,但不支持二次编辑。如需调整,请创建新任务完成迁移,很抱歉给您带来不便。
如果您是公共云SAAS的客户,建议您在2027年2月25日之前完成迁移,避免因为后续Argo下线导致业务受阻。
