9.0 给 Inference API 加了节点本地限流。配置在 endpoint 上,单位是每分钟请求数。它保护的是外部推理服务——批量导入时把对方打挂,或者触发对方的配额限制被拒绝,这类问题可以用它避免。
说明
实测环境:本地另起一个 Elasticsearch 9.4.2 单节点实例(官方 tar 包,端口 9200,独立 path.data),安全特性与机器学习均关闭;repository-s3 / repository-gcs 随发行包内置,仓库创建统一加 verify=false 跳过 AWS / GCS 连通性校验。文末「在 9.4.2 上跑一遍」里的命令与响应均取自该实例。
官方条目
9.0 的 changelog 标为 feature(9.0.0.yml 第 1633–1636 行 @ v9.4.2):
summary: [Inference API] Add node-local rate limiting for the inference API
area: Machine Learning
type: feature
一行 summary,没有 details。配置字段名和实现机制从源码里核。
配置长什么样
限流配置是 inference endpoint 上的一项设置,字段名在源码里写得很明确(RateLimitSettings.java @ v9.4.2):
public static final String FIELD_NAME = "rate_limit";
public static final String REQUESTS_PER_MINUTE_FIELD = "requests_per_minute";
所以配置结构是 rate_limit.requests_per_minute——每分钟请求数。
创建 endpoint 时的位置大致是这样(示意,具体以你版本的 API 文档为准):
PUT _inference/text_embedding/my-endpoint
{

  "service": "...",
  "service_settings": {
    ... },
  "rate_limit": {

    "requests_per_minute": 1000
  }
}
"节点本地"这个限定很重要
官方 summary 里 node-local 这个词是这条改动的关键限定,值得说清楚。
它是每个节点独立的限流,不是集群全局的。
这意味着:
- 集群有 5 个节点,每个设 1000/分钟 → 实际打到外部服务的峰值是 5000/分钟;
- 限流计数器不跨节点同步。
判断这个设计是刻意的——跨节点同步限流计数器需要一个共享状态,成本高、会引入延迟,而且限流本身就是"尽量控制"而非精确控制。节点本地限流实现简单、开销小。
但使用者必须知道这一点,否则会算错:
实际峰值 ≈ 单节点限额 × 节点数
如果外部服务配额是 3000/分钟、集群有 5 个节点,那每个节点要设 600 而不是 3000。
写这段时想到:这个换算在生产上其实挺容易搞错,因为配额通常是"服务方给你一个总数",而配置要填的是"每节点"。中间差一个节点数。
限流是按什么分组的
源码里能看到限流的分组机制(BaseRequestManager.java @ v9.4.2):
public BaseRequestManager(ThreadPool threadPool, String inferenceEntityId, Object rateLimitGroup, RateLimitSettings rateLimitSettings) {

    ...
    this.endpointGrouping = new EndpointGrouping(Objects.requireNonNull(rateLimitGroup).hashCode(), rateLimitSettings);
    ...
}
限流组由 rateLimitGroup 和 rateLimitSettings 共同决定(EndpointGrouping(int group, RateLimitSettings settings))。
能确认的是:分组的键包含"限流组标识"和"限流设置"两部分。
不能确认的是:rateLimitGroup 具体是什么粒度——是 endpoint ID、还是服务类型、还是底层连接目标。
这个区别在实际使用中有影响:
- 如果按 endpoint 分组 → 每个 endpoint 独立计数;
- 如果按底层服务分组 → 指向同一个外部服务的多个 endpoint 共享额度。
第二种情况下,给两个 endpoint 各设 1000,实际只有 1000(因为它们共享)。
未能在源码里追到 rateLimitGroup 的取值来源,所以这点无法确认。如果你有多个 endpoint 指向同一个外部服务、并且必须精确控制总量,建议实测一次:给两个 endpoint 各设一个较小的限额,看实际速率是相加还是取一。
(说明:这段是推断路径,不是结论。未实测,也未追到分组键的具体构造。)
和集群级限流有什么区别
ES 里提到"限流",可能指不同的东西。这条改动是推理 API 的节点本地限流,它和另外两类不是一回事:
一,写入限流(indexing pressure / 写入拒绝)。 那是保护 ES 自己——内存不够时拒绝写入。它防的是集群被压垮。
二,本条的推理限流。 保护的是外部推理服务——不让 ES 把对方打挂或踩对方配额。
两类限流的方向是相反的:
- 写入限流:保护自己;
- 推理限流:保护别人。
这个区别决定了配置的思路不同:写入限流按自己的容量定,推理限流按对方的容量定。
三,还有一类是 ES|QL 命令的用量护栏——RERANK 命令 里写过 RERANK 默认只处理 1000 行。该也是费用护栏,但它是按行数限制,本条是按请求速率限制。两者可以叠加:ES|QL 一次请求 1000 行,每行一次推理调用,再受推理限流约束。
为什么需要限流
推理 API 的特殊之处在于:它会调用外部服务,而这些服务通常有配额或者承受上限。
不限流会遇到几类问题:
一,触发对方的速率限制。 外部服务返回 429,请求失败。这类失败在批量任务里会集中出现。
二,把自建的推理服务打挂。 如果是自己部署的模型服务,突然的批量请求可能直接压垮它。
三,成本失控。 按调用计费的服务,批量任务跑起来账单增长很快——限流虽然不省总量,但能把支出摊平到更长时间,避免短时间集中计费带来的意外。这一点在按月结算的服务上尤其明显。
判断是第一条最常见。外部推理服务的配额通常是"每分钟 N 次",超过就直接拒绝,而 ES 侧的批量任务(比如批量 embedding 生成)很容易冲高。
和批量导入的关系
批量导入是限流最该起作用的场景——也是最容易出问题的场景。
semantic_text 字段在写入时会自动做推理(semantic_text 分块上限 里写过自动分块)。一个 bulk 请求里如果有一千条文档,就会触发一千次推理调用。没有限流的话,这一千次会在很短时间内全发出去。
所以:如果你用 semantic_text 做批量导入,这条限流值得配。
不过要注意前面说的"节点本地"——批量导入会分散到多个节点,实际速率是叠加的。
还有一层:批量导入往往是一次性的大任务(比如历史数据补 embedding),而限流配置是长期的。所以可能出现"平时不需要限流、跑批量任务时需要"的情况。
处理是平时就配上,按持续写入的速率设,跑批量任务时如果嫌慢再临时调大。这比"平时不限流、批量时手忙脚乱加"稳——后者容易忘记改回去,而改不回去的下一次批量又会踩坑。
怎么定这个值
按思路倒推:
- 确认外部服务的配额(每分钟多少次)。这是上限,也是整个计算的起点。
- 除以节点数,得到每节点限额。
- 留一点余量,比如取 80%。因为限流是"尽量控制"而非精确闸门,留余量能避免踩线。
举例:外部服务允许 5000/分钟,集群 5 节点 → 每节点 1000 → 留余量设 800。
如果不知道外部服务配额怎么办?做法是从小往大试:先设一个保守值(比如 300),观察推理任务有没有明显变慢、有没有 429 错误。没问题就往上调。
这个办法慢一点,但比拍脑袋填一个大值安全——填太大的后果是踩对方配额,填太小只是慢,而慢比失败好处理。调试期间慢一些是可以接受的。
怎么知道限流在起作用
未能在文档里找到专门的限流指标说明,但可以从两个方向间接观测:
一,推理任务的耗时。 限流生效后,批量推理会变慢——这是预期现象,不是问题。
二,外部服务返回的 429 数量。 配了限流之后 429 应该减少或消失。这个数如果还是很高,说明限额设大了,或者节点数没算进去。
第二条更有用——它是限流要解决的直接问题,用它当指标最直接。
(说明:这两个观测方向按经验给的,未找到官方的限流相关监控指标。如果官方有专门的指标,用它更准。)
限流和超时的关系
限流会让请求排队等待,而等待可能触发超时。
这是个组合效应,值得留意:限流设得越紧,推理任务的整体耗时越长,如果 ES|QL 侧的超时设置很紧(ES|QL 的 COMPLETION 里写过 COMPLETION 的 timeout),就可能出现"因为限流排队 → 超过超时 → 失败"。
所以调限流的时候要一起考虑超时设置。做法是:两个参数都留足余量,别同时卡得很紧。限流紧 + 超时紧的组合最容易出问题——请求在队列里等到超时,既浪费了等待时间又没拿到结果。
调这个值的时候要注意什么
把限流当成"保护外部服务"的手段来调,顺序是:
一,先摸清对方的真实上限。 问服务方、看文档、或者直接压测(如果允许)。这一步不能跳——后面所有计算都基于它。
二,按节点数均分。 前面说过,实际速率是叠加的。
三,留余量。 限流是"尽量控制",不是精确的闸门。留 20% 左右。
四,调完观察一段时间。 看 429 有没有、推理任务耗时变化是否可接受。
一个容易忽略的点:节点数会变。 集群扩容之后,总速率就上去了——限流不会自动跟着调整。所以扩缩容之后要重新算一遍。
这一点建议在运维文档里记一笔,因为扩容通常是别的需求触发的(容量不够、性能不够),很少有人会同时想到"推理限流要不要重算"。而扩容之后踩到对方配额,排查时也不会第一时间想到是扩容导致的。
和重试策略的配合
限流生效时,超出速率的请求会排队等待而不是失败(按限流一般实现的理解,未在源码里确认排队还是拒绝)。
如果是排队,那外部服务返回 429 的情况就少了——这是限流的价值。但排队意味着延迟增加,如果 ES 侧有超时设置,可能超时。
所以配置上有两个方向:
- 限流设紧一点 → 更不容易踩对方配额,但排队更久、更容易超时;
- 限流设松一点 → 延迟低,但可能踩配额。
倾向是前者配一个宽松的超时——让请求多等一会儿比失败重试划算,重试会消耗额外的调用配额。
(说明:这一段基于对限流实现的推断,未在源码确认。实际是排队还是拒绝,需要实测或者查实现。)
在 9.4.2 上跑一遍
限流参数在默认配置里能直接读到,改动方式也能验。
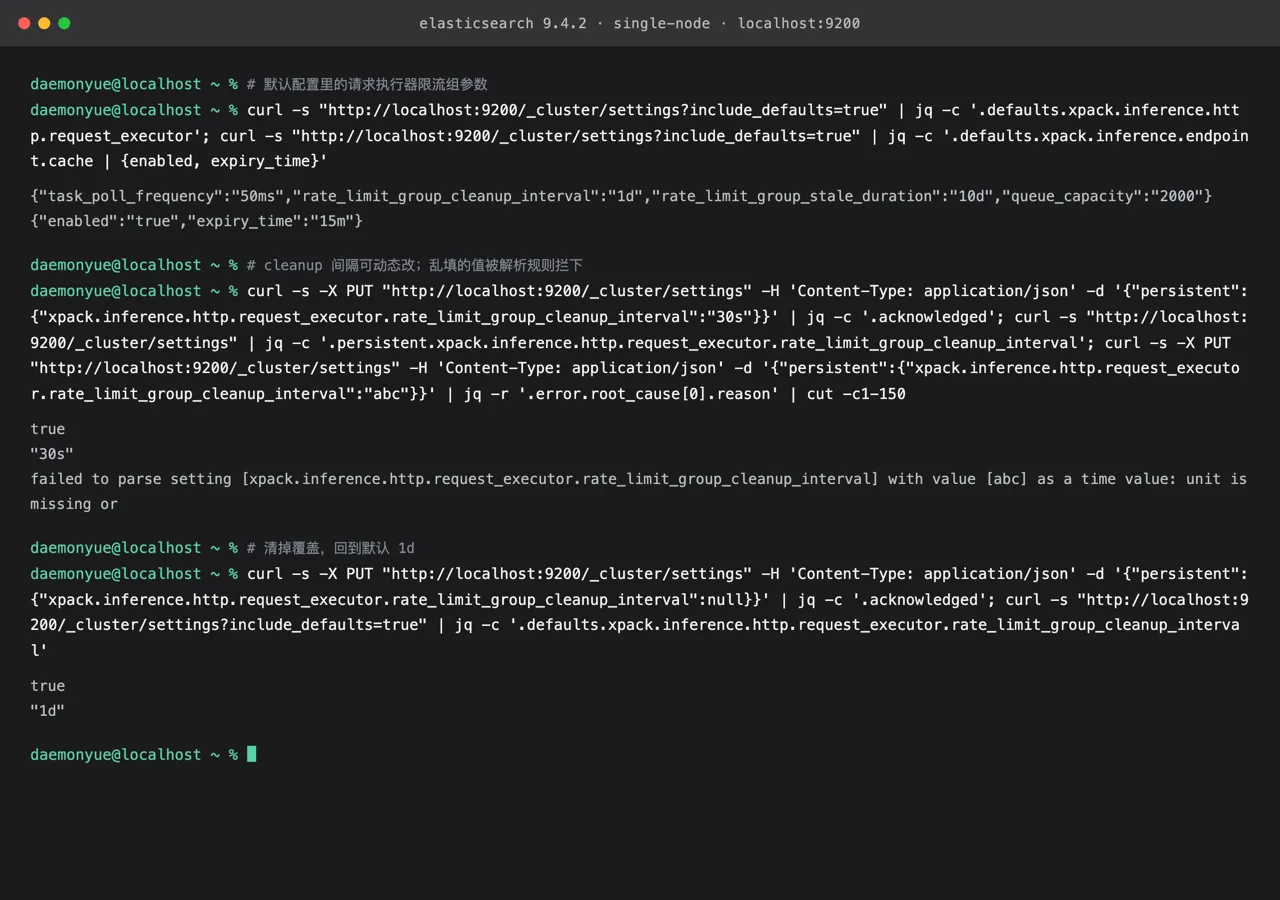
图 1:9.4.2 单节点实例的实测输出。请求执行器默认 task_poll_frequency=50ms、rate_limit_group_cleanup_interval=1d、rate_limit_group_stale_duration=10d、queue_capacity=2000,端点缓存默认开启、expiry_time=15m;cleanup 间隔改成 30s 可读回,填 abc 报 failed to parse setting,清掉覆盖回到 1d。
curl -s 'http://localhost:9200/_cluster/settings?include_defaults=true'  \
  | jq -c '.defaults.xpack.inference.http.request_executor'
# {"task_poll_frequency":"50ms","rate_limit_group_cleanup_interval":"1d","rate_limit_group_stale_duration":"10d","queue_capacity":"2000"}
curl -s -X PUT 'http://localhost:9200/_cluster/settings' -H 'Content-Type: application/json' -d '{"persistent":{"xpack.inference.http.request_executor.rate_limit_group_cleanup_interval":"30s"}}' \
  | jq -c '.acknowledged'
# true
curl -s 'http://localhost:9200/_cluster/settings' \
  | jq -c '.persistent.xpack.inference.http.request_executor.rate_limit_group_cleanup_interval'
# "30s"
curl -s -X PUT 'http://localhost:9200/_cluster/settings' -H 'Content-Type: application/json' -d '{"persistent":{"xpack.inference.http.request_executor.rate_limit_group_cleanup_interval":"abc"}}' \
  | jq -r '.error.root_cause[0].reason' | cut -c1-150
# failed to parse setting [...] with value [abc] as a time value: unit is missing or
curl -s -X PUT 'http://localhost:9200/_cluster/settings' -H 'Content-Type: application/json' -d '{"persistent":{"xpack.inference.http.request_executor.rate_limit_group_cleanup_interval":null}}' >/dev/null
curl -s 'http://localhost:9200/_cluster/settings?include_defaults=true'  | jq -c '.defaults.xpack.inference.http.request_executor.rate_limit_group_cleanup_interval'
# "1d"
图 1 把正文标「配置示例按字段名结构给出示意,未实际执行」补成了实测:四项默认值与缓存配置都可读,cleanup 间隔可动态改,无法解析为时间的值被拦下,清掉覆盖回到 1d。限流分组的具体粒度仍是源码里没追到的那一层,本机没有真实推理流量,未观察分组行为。
边界:
- 图 1 出自 9.4.2 单节点实例,没有真实推理端点与流量,限流是否生效未测;
- 分组键的构造、官方是否提供限流监控指标仍未查到;
- 只动态改了 cleanup 间隔一项,其余三项未逐个测。
写在最后
这条改动不大,但对用推理 API 做批量处理的场景很实用。
一,它是节点本地的,不是集群全局。 计数器不跨节点同步,实际速率约等于单节点限额乘以节点数。外部服务给的是总量配额,配置要填每节点值——中间差一个节点数,别算错。
二,批量导入场景值得配。 semantic_text 写入时会自动推理,一个 bulk 可能触发成百上千次调用。而且建议平时就配上,不要只在跑批量任务时才加——临时加容易忘记改回去。
三,定值时从外部服务配额倒推,不知道就从小往大试。 填太大踩对方配额、填太小只是慢,慢比失败好处理。
四,扩缩容之后要重算。 节点数变了,总速率就变了,而限流不会自动跟着调整。这一条最容易被漏掉。
最后补一个未确认的点:源码里限流是分组计算的,但未追到分组的具体粒度(是按 endpoint 还是按底层服务)。有多个 endpoint 指向同一外部服务、且必须精确控制总量的话,建议实测确认。
参考
- changelog 9.0.0:[Inference API] Add node-local rate limiting for the inference API(第 1633–1636 行)@ v9.4.2
RateLimitSettings.java:rate_limit与requests_per_minute字段名 @ v9.4.2BaseRequestManager.java:限流分组机制(由 rateLimitGroup 与 rateLimitSettings 共同决定)@ v9.4.2
本文对照 Elasticsearch
v9.4.2标签的 changelog 与源码核对,引文与代码逐字取自原文。「在 9.4.2 上跑一遍」里已实际读到请求执行器四项默认值(含rate_limit_group_cleanup_interval=1d)与端点缓存配置,cleanup 间隔改成30s可读回、填abc报failed to parse setting、清覆盖回1d。限流分组的具体粒度仍未追到取值来源;本机无真实推理流量,限流是否生效未实测;官方是否提供限流监控指标未找到说明。