
随着业务数据规模增长,数据清理成为数据库运维中的常见需求。例如,超过保留期限的历史订单、Web3 多链资产中的零余额记录,以及业务调整后不再需要的计量数据,都是典型的清理对象。
思考一下这个问题:如果你需要在一天内清理数十亿条历史记录,同时保持线上业务稳定运行,你会怎么做?
你可能会想到:“写个脚本,分批执行 DELETE,再提高并发,应该就能完成。”
一个客户就遇到了这样的任务。最初采用较高并发按行删除时,CPU 已达到满负载,但清理推进速度约 1 万条/秒,显然无法满足当天完成的要求。
后续该客户改用 PolarDB-X OMC 3.0 来完成数据清理,平均清理速度约 23.5 万条/秒,当天完成目标业务库所有表的清理,期间 CPU 稳定在 20%—40%,业务无感。
本文将介绍如何在 PolarDB-X 中使用 OMC 3.0,安全、高效地完成大规模数据清理。
1. 大表清理,执行 DELETE 就够了吗?
面对几十亿、上百亿条记录的大表,用户通常会编写脚本,分批执行 DELETE。但真正开始执行时,往往还要回答一系列问题:
每批删除多少条?批次太大可能形成大事务,太小又会拖慢整个清理过程。
开多少并发?并发提高后,CPU、I/O 和业务请求是否还能保持稳定?
删除语句是否走合适的索引?扫描与加锁范围有多大?与业务写入同时执行时,会不会产生锁等待或死锁?
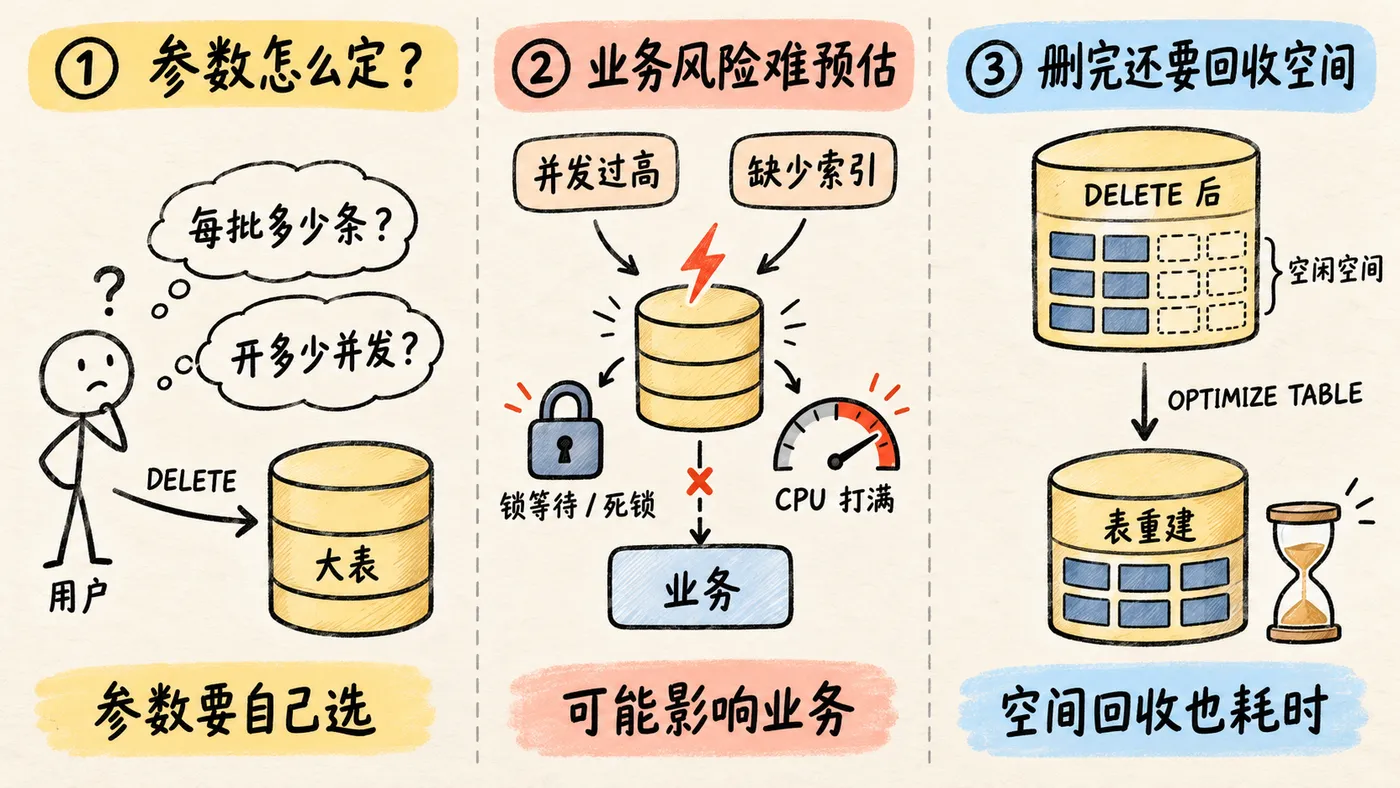
这些参数没有一个适合所有表的固定答案。缺少对数据分布、索引和业务访问方式的了解时,用户很难判断自己的设置是否安全。删除并发过高时,CPU 可能被打满;缺少索引还可能扩大扫描和加锁范围,造成更严重的业务影响。如果为了降低影响而限制并发,清理时间又会拉长。PolarDB-X 冷数据清理文档也介绍了按行删除带来的行锁及日志开销。
而且,删除记录后,原表中的空闲空间通常可以被后续写入复用,却不会自动按删除比例归还给文件系统。要进一步回收空间,往往还需要执行一次 OPTIMIZE TABLE。用户既要管理删除任务,也要安排后续的表重建。
2. OMC 3.0:从无锁变更到在线数据清理
OMC 是 Online Modify Column 的简称,最初用于在线修改列类型,支持变更期间继续处理业务 DML。在此基础上,PolarDB-X 进一步扩展了 OMC 的能力,将其升级到 OMC 3.0,支持添加索引、增删列等所有物理 DDL 操作。
OMC 3.0 还将在线重建表能力扩展到数据清理场景:在重建过程中按清理规则过滤待清理数据,将剩余存量数据分批复制到新物理表,增量同步也使用相同的过滤条件;完成数据校验和原子切换后,再删除旧物理表。业务访问的逻辑表保持不变,数据库在底层完成物理表切换。
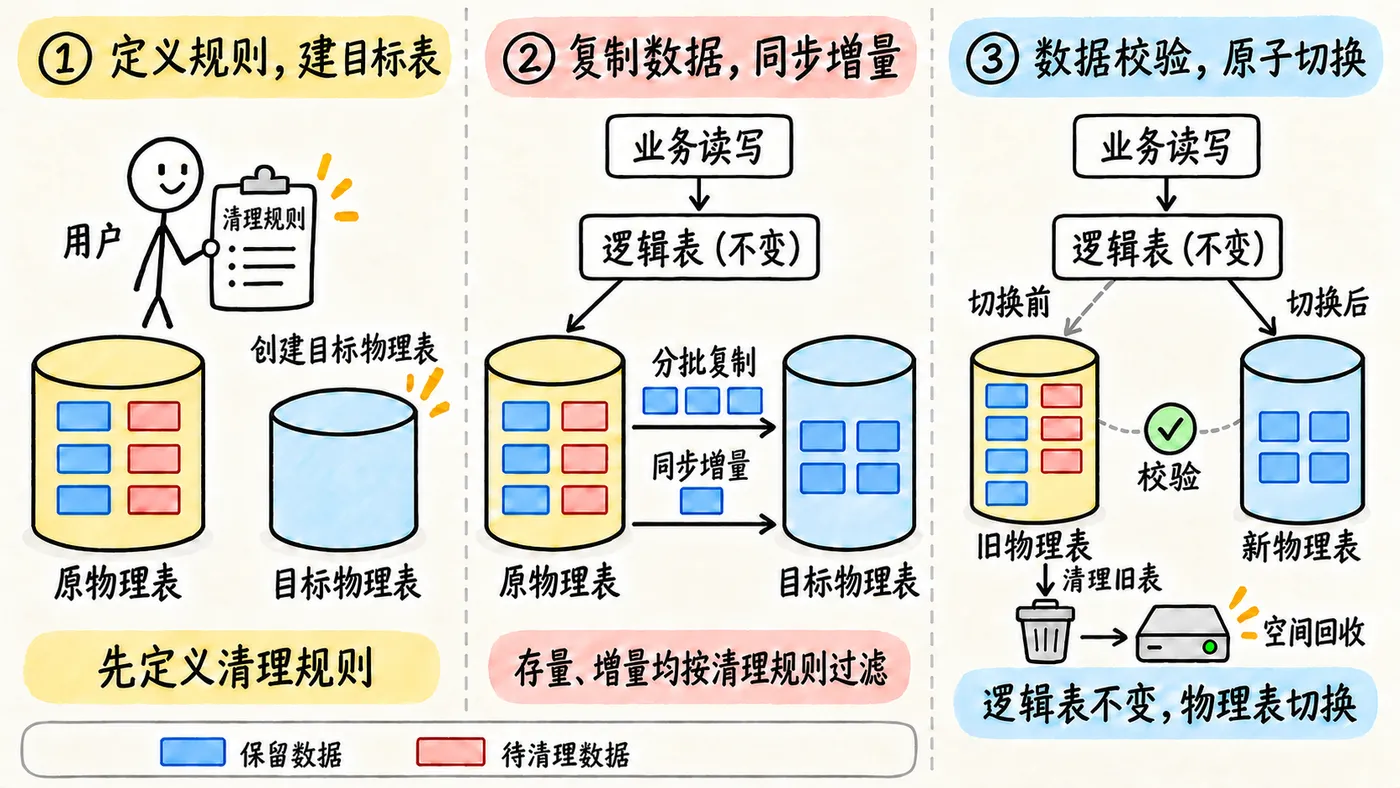
清理规则可以通过时间、记录状态或特定字段表达。例如,清理某个时间点之前的订单、符合业务条件的零余额记录,或者指定类型的计量数据。
用户只需定义清理规则,由数据库组织分批复制、增量同步和切换,不再需要自行编写逐行删除脚本。同时,数据清理与空间回收在同一次重建中完成,省去额外执行 OPTIMIZE TABLE 的时间。
在线重建仍然需要扫描原表,也会消耗 CPU、I/O 和额外存储空间;当需要保留的数据较少时,目标表的数据写入量可以减少。重建期间可以继续处理业务读写,最终切换仍有短暂的锁协调,因此需要结合业务负载评估执行窗口。关于 DDL 锁表判断、OMC 无锁变更及执行前的长事务检查,可参考PolarDB-X 无锁 DDL 操作指南。
此外,OMC 3.0 还可以降低 DDL 对备库、只读实例造成的复制延迟。对于需要重建大表的传统 DDL,主库执行完成后,备库还需要重新执行一次表重建,期间后续业务事务无法继续回放。OMC 将耗时的数据重建拆成分批 DML 事务,使备库可以在重建过程中持续回放,最后通过快速的物理表切换完成变更,从而减少长时间 DDL 重放造成的复制延迟。
3. 实际案例
已归档历史订单清理,释放存储空间
历史订单数据已完成 TTL 归档,业务库中仍保留着大量已归档记录,需要尽快清理并释放存储空间。
本次清理涉及 13 张业务表。此前统计的待清理记录合计约有 36.67 亿条。清理需要在当天完成,同时保持线上业务稳定运行。两种清理方式的执行情况如下:
清理方式 |
平均清理速度 |
完成情况 |
CPU 观察 |
按行删除 |
约 1 万条/秒 |
按该速度估算需约 102 小时,无法当天完成 |
达到满负载 |
OMC 重建清理 |
约 23.5 万条/秒(估算) |
4 小时 20 分钟完成目标业务库所有表的清理 |
稳定在 20%—40% |
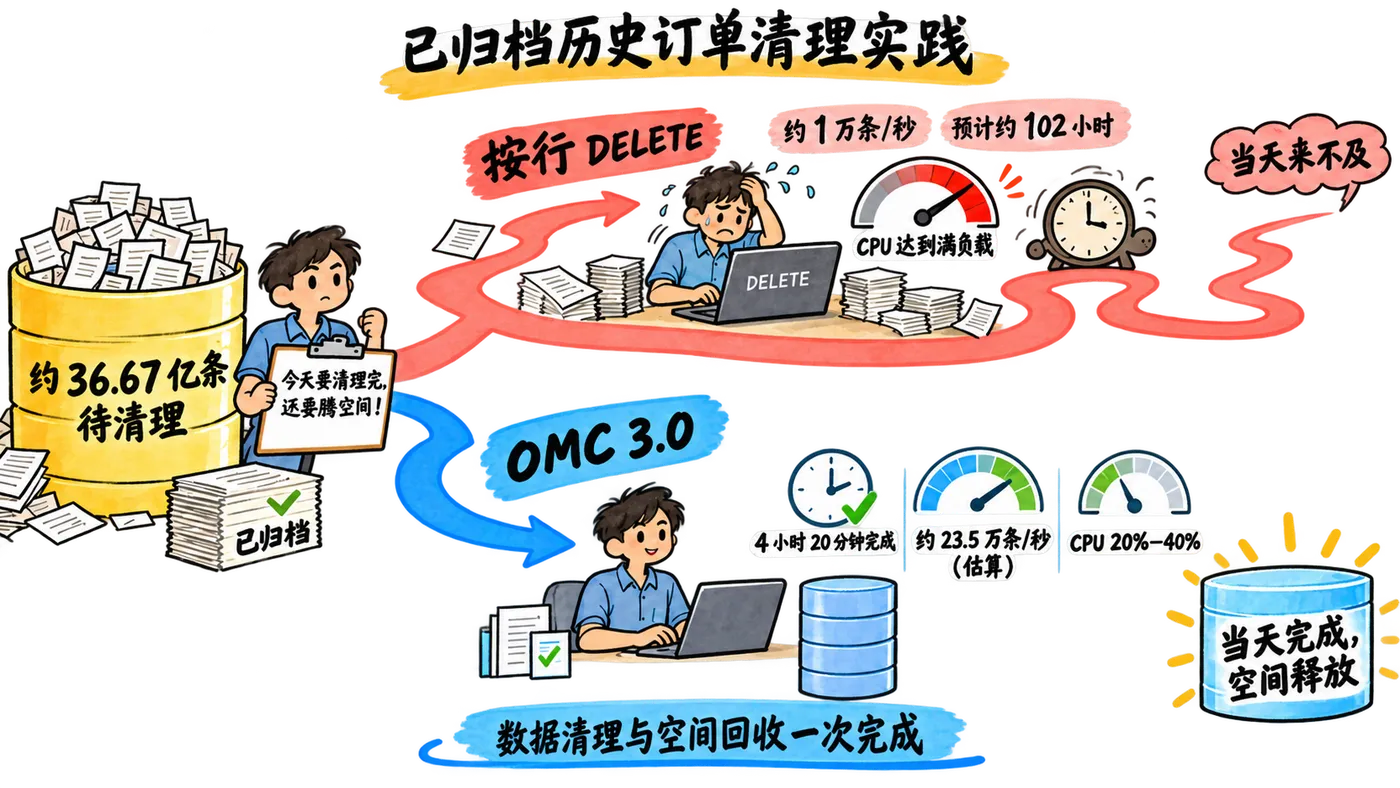
OMC 的清理收益与待清理数据占比有关。清理占比越高,需要复制到新物理表的存量数据越少,通常收益越明显。对于需要回收空间的大表,可将 清理占比超过 50% 作为优先评估 OMC 的参考条件。例如,清理 80% 的存量数据时,仅需将剩余 20% 写入新表。50% 是基于处理行数的选型参考,实际清理效率还受原表扫描、索引维护和业务负载影响。
Web3 多链资产余额清理,减少存储占用
Web3 业务通常在数据库中维护多链地址及资产余额。随着链上资产转出,部分余额记录归零,但仍长期保留在业务数据库中。本案例使用 OMC 清理符合业务条件的零余额记录,减少余额表的数据量并回收存储空间。
本次清理覆盖 4 张余额表,数据量合计从约 545.2 亿条降至 212.1 亿条,共清理约 333.1 亿条零余额记录。其中,一张余额表的清理比例达到 94%,耗时 7 小时。
整个清理过程中,业务全程无感,只读实例也未出现复制延迟。
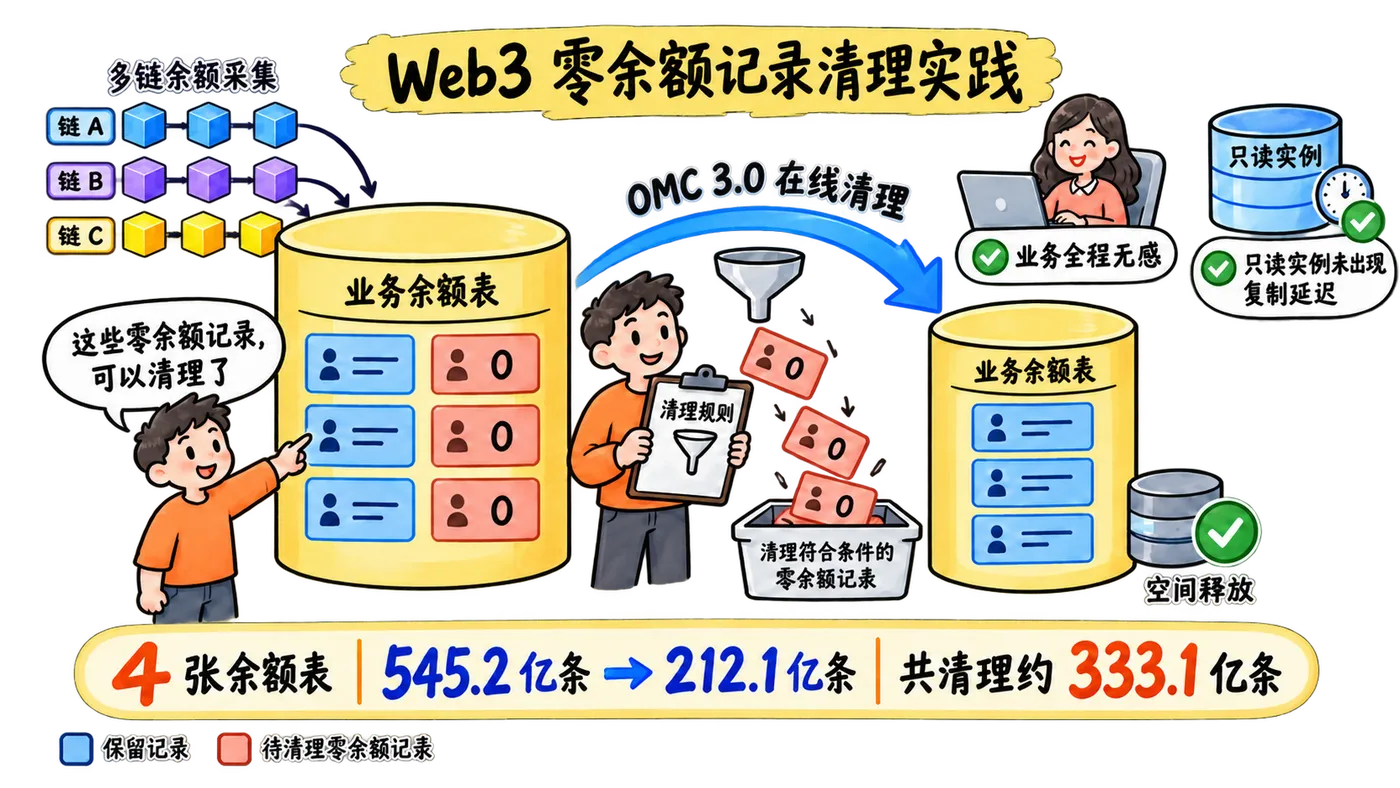
在清理比例最高的任务中,重建时仅需将剩余约 6% 的存量数据写入新表。对于这类待清理数据占比较高的余额表,OMC 可以减少重建过程中的数据写入量,并在完成物理表切换后回收旧表空间,一次完成数据清理与空间回收。
4. 语法说明
REBUILD CLEANUP 和 DRY RUN 语法支持 PolarDB-X 计算节点(CN)5.4.21-20260730 及 5.4.21 系列后续版本。
ALTER TABLE [schema_name.]table_name
REBUILD CLEANUP WHERE cleanup_condition
[DRY RUN];
语法项 |
说明 |
|
待清理的业务表;省略库名时,使用当前数据库。 |
|
必填,指定需要清理的记录条件。 |
|
可选,校验清理条件,并展示清理条件、保留条件及样本记录,不执行实际清理;省略时执行清理。 |
WHERE 指定的是待清理条件,而非保留条件。 只有条件计算结果为 TRUE 的记录会被清理;结果为 FALSE 或 NULL 的记录会被保留。
清理条件遵循以下规则:
可以使用本表字段的比较条件,以及 IN、BETWEEN、LIKE、IS NULL 等表达式,并通过 AND、OR 组合。
不支持子查询或 NOW()、RAND() 等非确定性函数。时间边界应写成固定值,例如 created_at < '2024-05-01 00:00:00'。
如需清理字段为空的记录,应显式加入 IS NULL 条件。例如,created_at < '2024-05-01 00:00:00' OR created_at IS NULL 会同时清理早于该时间和时间为空的记录。
5. 执行步骤与效果评估
下面以历史订单表为例,演示执行步骤和效果评估。示例库表、字段及日期需替换为实际业务规则。
记录执行前的表统计
对于大表,可以先查询 information_schema.tables,保存行数和数据、索引空间统计,作为清理前的基线:
SELECT
    table_schema,
    table_name,
    table_rows,
    ROUND(data_length / 1024 / 1024 / 1024, 2) AS data_gib,
    ROUND(index_length / 1024 / 1024 / 1024, 2) AS index_gib,
    ROUND((data_length + index_length) / 1024 / 1024 / 1024, 2) AS total_gib
FROM information_schema.tables
WHERE table_schema = 'demo_db'
  AND table_name = 'orders';
用 DRY RUN 查看清理规则
假设业务已确定清理 2024 年 5 月 1 日之前的订单:
ALTER TABLE demo_db.orders
REBUILD CLEANUP
WHERE created_at < '2024-05-01 00:00:00'
DRY RUN;
DRY RUN 会展示清理条件、由其推导的保留条件及示例记录,便于检查时间边界和业务字段是否符合预期,不执行实际清理。示例不能替代完整的业务规则确认;对于空值,也需要明确是否清理。本例中的比较条件对 NULL 不成立,这些记录会被保留。
执行清理并查看进度
确认规则后,移除 DRY RUN 执行清理:
ALTER TABLE demo_db.orders
REBUILD CLEANUP
WHERE created_at < '2024-05-01 00:00:00';
执行期间,可以在另一会话中查询 information_schema.ddl_progress 查看清理进度:
SELECT * FROM information_schema.ddl_progress;
同时,通过实例监控关注 CPU、I/O,通过业务监控观察请求延迟和错误率。确认 DDL 成功完成后,再进行清理后的统计对比。
刷新统计,再比较行数与空间
清理完成后,执行 ANALYZE TABLE 刷新统计信息:
ANALYZE TABLE demo_db.orders;
随后重新执行前面的 information_schema.tables 查询,比较清理前后的 TABLE_ROWS、DATA_LENGTH、INDEX_LENGTH 及其合计。
其中,TABLE_ROWS 是统计估算值,数据与索引长度也用于观察表级空间变化;它们适合评估大表清理效果,不等同于精确计数或实例磁盘已释放的字节数。若需要确认实例物理空间回收,还应结合存储节点的用户数据空间监控。PolarDB-X 统计信息文档与 MySQL TABLES 视图说明可用于了解这些统计字段。
对于持续写入的表,前后统计还会受到业务增量影响,应记录查询时间及清理规则,一并解释变化。
6. 注意事项
下游数据同步
OMC 重建清理与按行 DELETE 的差别,不仅体现在执行方式上,还体现在下游数据同步上。
对比项 |
按行 DELETE |
OMC 重建清理 |
数据处理 |
在原表中删除符合条件的记录 |
将需要保留的数据复制到目标表,完成切换后清理旧表 |
执行组织 |
用户通常自行管理批次、并发及重试 |
由 DDL 流程组织复制、增量同步和切换 |
空间回收 |
通常还需表重建或 OPTIMIZE TABLE |
在重建及旧表清理过程中完成 |
删除事件 |
在正常开启 Binlog 的行模式下,删除产生对应的行级事件 |
被清理记录不产生对应的逐行 DELETE Binlog 事件 |
下游影响 |
支持消费这些删除事件的同步链路可以更新下游 |
依赖逐行删除事件的下游可能感知不到记录已被清理 |
OMC 重建清理不会为被清理记录产生逐行 DELETE Binlog 事件。 如果下游是非 PolarDB-X 实例,并依赖这些删除事件维护数据,下游可能继续保留已经在源库清理的记录,造成两端数据不一致。
这里说的是被清理记录缺少逐行删除事件,不代表整个操作没有任何 DDL 或 CDC 标记,也不能推广为所有 DDL 都没有 Binlog。下游能否正确处理,需要结合具体产品和同步链路判断。
使用前,请通过阿里云提交工单,评估实例版本、表结构、复制链路及下游兼容性,确认风险和处理方案后再执行。 特别是存在非 PolarDB-X 下游、数据订阅或外部增量消费时,需要明确这些系统应如何处理源库清理。
带 GSI 或 CCI 的表
如果待清理表包含全局二级索引(GSI)或列存索引(CCI),需在执行前通过阿里云提交工单,评估表结构及索引兼容性,确认清理方案后再执行。
小结
无论是历史订单、Web3 资产余额,还是按特定业务条件清理的数据,OMC 3.0 都提供了一条利用在线重建完成清理与空间回收的路径。用户先定义业务规则、评估下游同步影响,再执行清理语句,无需自行编写和维护大规模删除脚本。清理完成后,对比清理前后的数据量和存储空间,确认清理效果。
