One self. One context. Every AI.
开源地址:https://github.com/ptonlix/OneSelf
在线实例:https://chenfudong.win/
一、又是从「你好,我是……」开始
不知道你有没有过这种感觉:每打开一个新的 AI 工具,第一件事都是做自我介绍。
「我是一个后端工程师,主要写 TypeScript,最近在做个人工具……」「我住在 XX,口味偏清淡,不吃香菜……」「我写文章喜欢口语一点,不要太多排比……」
在 ChatGPT 里说一遍,在 Claude 里说一遍,在 Cursor 里再写一份 rules,在某个新出的 Agent 里又从头来过。说多了,人会变得很「AI 友好」:我开始习惯把自己压缩成一段几百字的 prompt,存在备忘录里,到处复制粘贴。
后来我意识到,问题不在于哪个 AI 记性不好。很多产品其实都在做「记忆」,而且做得越来越好。问题在于:这些记忆都长在别人的平台上。我在 A 里被记住的那个我,B 不认识;哪天我不用 A 了,那个「我」也就留在了那里,导不出来,也删不干净。
所以我想换个思路:
记忆可以属于 Agent,但「你是谁」必须属于你。
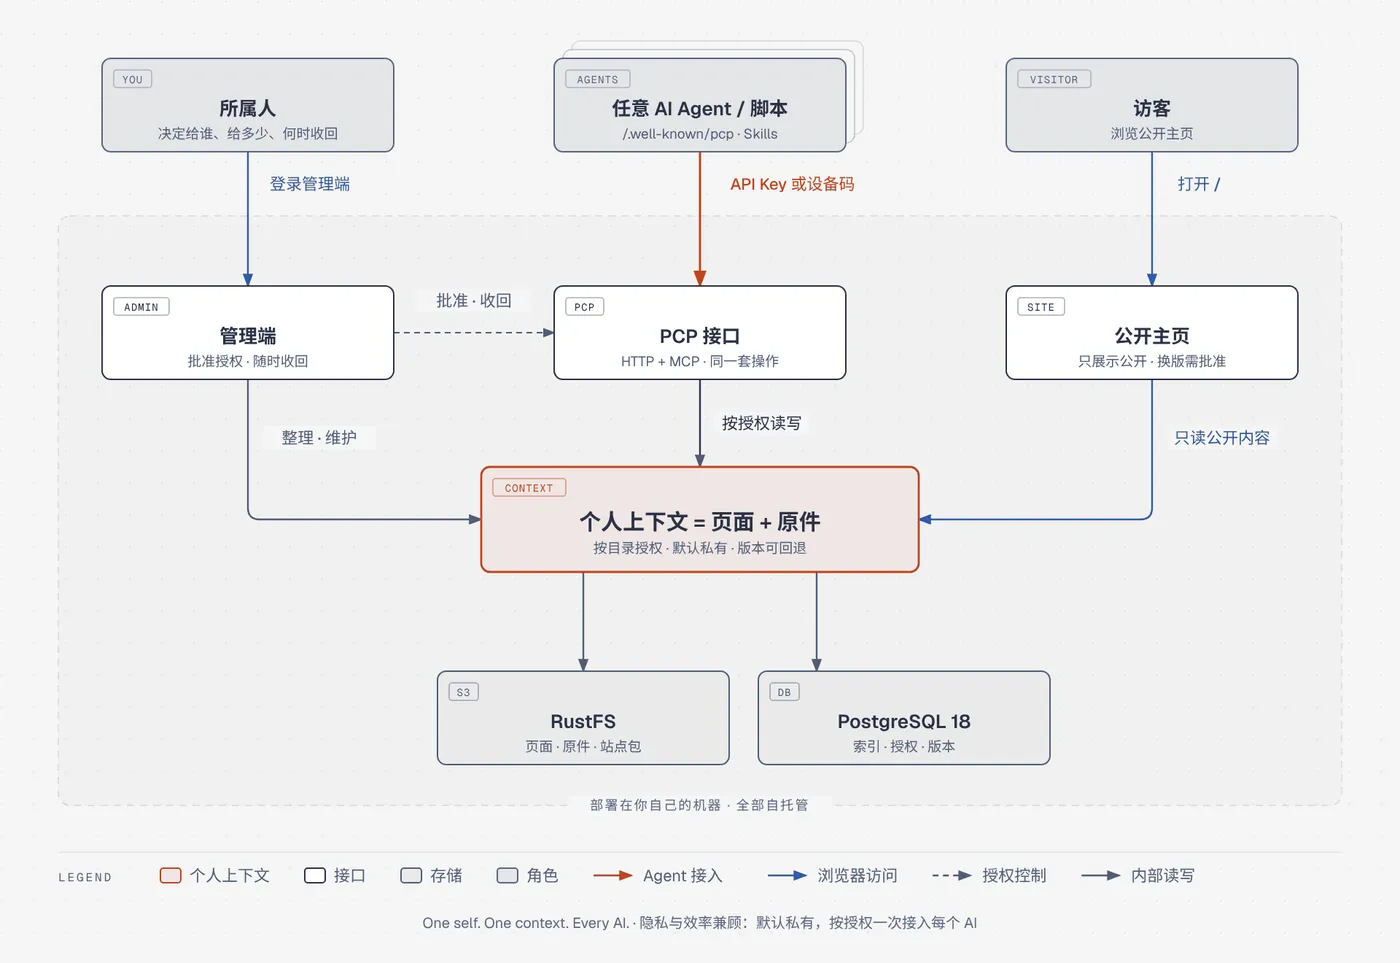
你的经历、知识、作品、偏好,应该像身份证一样由你自己持有。哪个 AI 想了解你,向你申请;你批准了,它才能读,读多少由你定;你不想给了,随时收回。
这就是我做 OneSelf 的出发点:一个开源、自托管的「个人上下文」管理系统。一份关于你的资料,所有 AI 共用。在隐私和效率之间找一个平衡点。
下面我会把它的设计思路完整讲一遍:我怎么拆这个问题、定了哪些原则、协议和授权怎么设计、数据怎么组织,以及——它目前做不到什么。
二、把问题拆成三层
「让 AI 了解我」听起来是一件事,拆开看其实是三层问题。
第一层:存在哪?——所有权问题
你的上下文放在哪里,决定了谁说了算。
放在某个 AI 平台里,它就是平台的数据:格式由平台定,能不能导出由平台定,换个模型能不能用也由平台定。放在自己的笔记软件里,倒是归你了,但 AI 读不到,你还得手动复制。
我想要的是:数据放在我自己的机器上,但 AI 能通过标准接口读写它。 所有权在我,可用性也不打折。
第二层:给谁、给多少?——授权问题
就算数据在自己手里,也不意味着可以一股脑全给出去。
我可以让写代码的 Agent 知道我的技术栈和项目经历,但它没必要知道我的体检报告;我可以让帮我规划旅行的 Agent 知道我的饮食偏好,但它不需要看我的简历。
更麻烦的是「收回」。现在很多工具的授权是一次性的:你把一段资料贴进对话框,它就出去了,没有任何办法撤回。我希望授权是逐个的、有范围的、可以随时作废的。
第三层:谁来维护?——效率问题
前两层解决了,还有一个很现实的问题:谁来整理这些资料?
如果每次换工作、搬家、学了新东西,都要我自己打开后台一条条改,那这个系统大概用不过三个月。我自己就是这样的人。
所以维护这件事,应该尽量交给 AI。它在和我聊天、帮我干活的过程中,发现了新的事实,就写回去;发现旧的事实过期了,就标记或者忘掉。我划边界,Agent 干活。
但「交给 AI 维护」又会带来新问题:AI 会写错。所以改动必须可追溯、可回退,事实要带置信度和有效期。
这三层叠在一起,基本就勾勒出了 OneSelf 要做的事。
三、几条设计原则
动手之前,我给自己定了几条原则,后面所有设计基本都是从这里推出来的。
1. 默认私有,公开要明确决定。
所有页面默认是 private。没有权限的调用方,看到私有页和看到一个不存在的页,返回的结果是一样的——它甚至不应该知道「这里有东西但你看不了」。
2. 每一次授权都要人来批准。
不管是 API Key 还是 OAuth 设备码,都必须由所属人(也就是你)在批准页上确认。
3. Agent 不能给自己发钥匙。
这一条我想得最久。Agent 可以在被授权的范围里读写资料,但它不能创建、管理密钥,不能替你批准授权,也不能自己把公开主页推上线。权限的源头永远在人手里。
4. Agent-first,但人有最终控制权。
接口设计优先考虑 Agent 怎么用:怎么发现、怎么接入、怎么读写。管理端则只做人必须亲自做的事:批准、作废、同意上线、删除或恢复。
5. 改动可追溯、可回退。
AI 会犯错,人也会。所以每一次写入都应该能看到历史、能退回去。
6. 数据留在你的机器上。
自托管,Agent 只走接口,不直接碰数据库。
四、让 Agent 自己找上门:/.well-known/pcp
原则定了,第一个具体问题是:一个 Agent 第一次见到你的 OneSelf 实例,它怎么知道该怎么用?
我不想让用户去给每个 Agent 写一大段接入说明——那又回到了「到处自我介绍」的老路,只不过这次是在介绍系统。
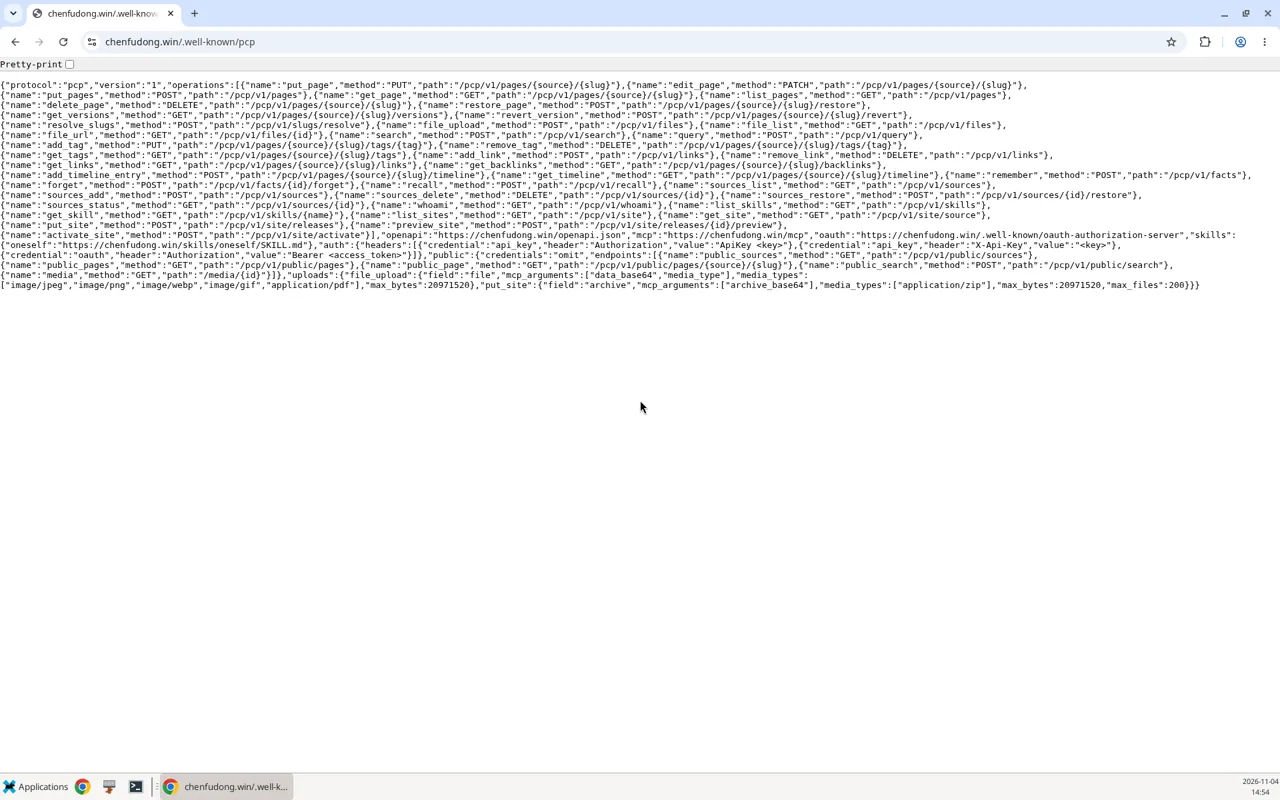
我的做法是借鉴 Web 上已经很成熟的 /.well-known/ 约定,提供一个发现文档:
GET https://你的站点/.well-known/pcp
PCP(发现文档里的 protocol: "pcp")是我给这套接口起的名字,目前它只是 OneSelf 自己的协议,不是什么行业标准。这个发现文档里写清楚了一个 Agent 需要知道的所有东西:
- 协议版本和操作清单
- 认证头怎么带
- 哪些是公开接口
- 上传限制
- OpenAPI 文档地址、MCP 端点地址
- OAuth 相关地址
- Skill 地址
也就是说,Agent 只要拿到一个站点地址,读一下 /.well-known/pcp,就能知道这里有什么、怎么接、要什么凭证。
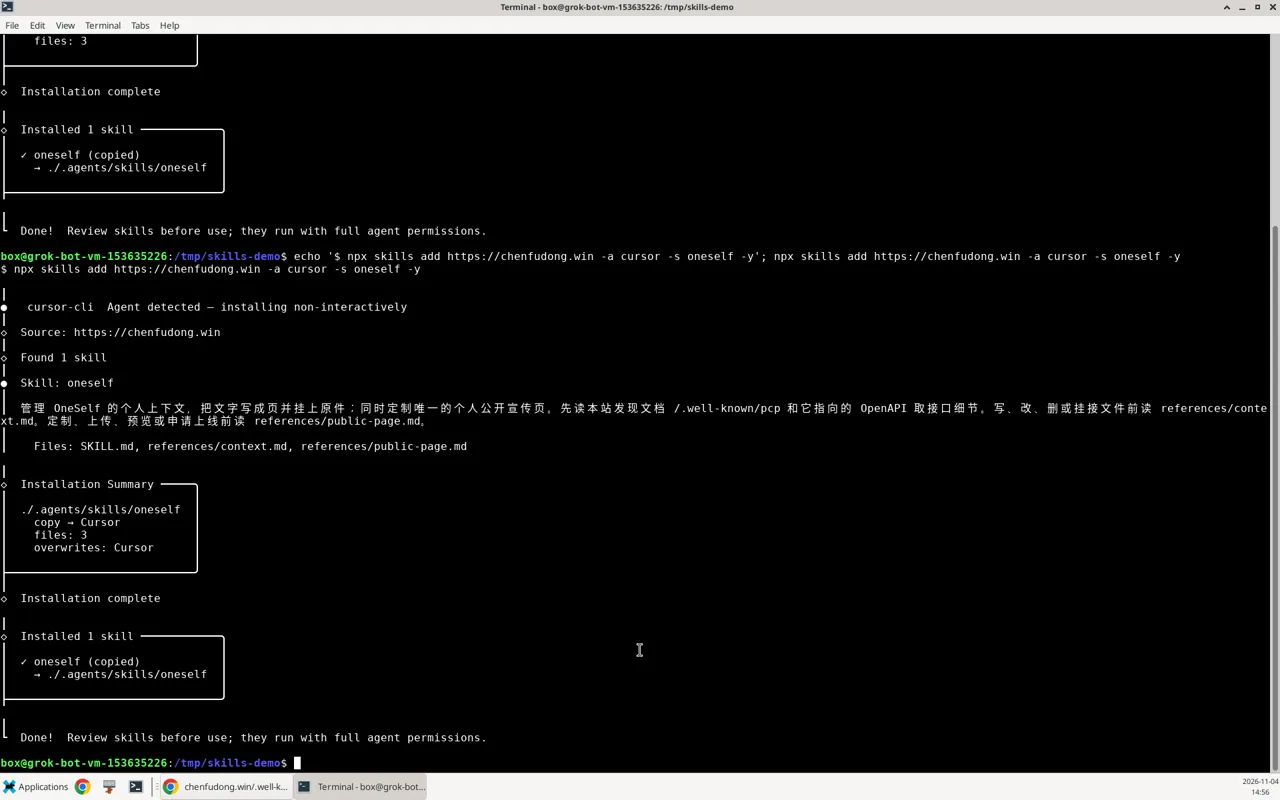
除了机器可读的发现文档,我还写了一个给 Agent 读的产品 Skill,叫 oneself。它告诉 Agent 这套系统的规矩:写页面之前该读哪份参考,改公开页之前又该读哪份。安装只要一行:
npx skills add https://你的站点 -a <agent> -s oneself -y
把 https://你的站点 换成你自己实例的地址,<agent> 换成你用的 Agent 名字就行。
这样,「教会一个 Agent 用我的上下文」这件事,从写一页文档,变成了一行命令。
 ---
五、一张操作表,同时生成 OpenAPI 和 MCP
接下来是接口本身。
现在 Agent 接入外部系统,主流有两条路:一条是普通的 HTTP API(配一份 OpenAPI 文档),另一条是 MCP。不同的 Agent 偏好不同,我两边都想支持。
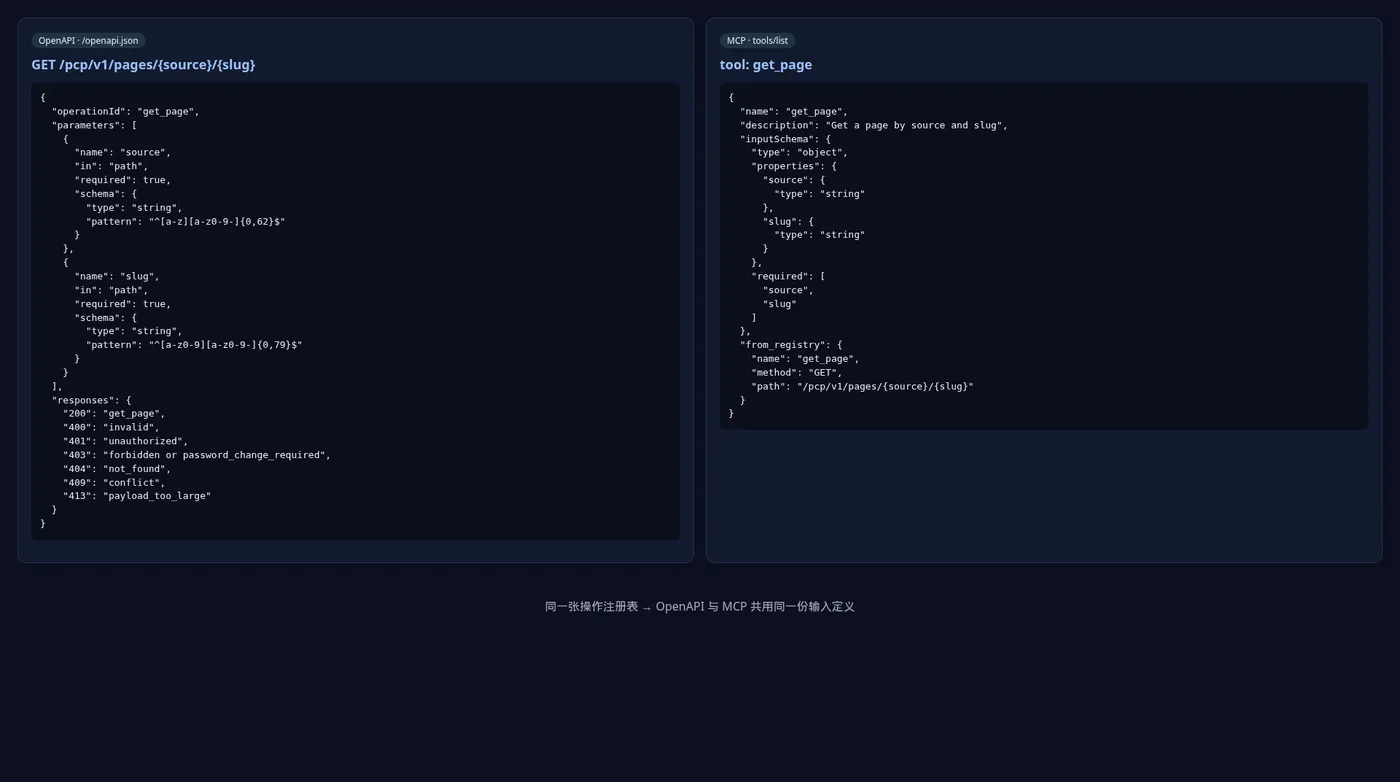
但我很怕一件事:两套接口慢慢长歪。HTTP 这边加了个参数,MCP 那边忘了改;MCP 这边多了一个校验,HTTP 这边没有。到最后两边行为不一致,权限检查也不一致,那就是安全隐患。
所以我在代码里只维护一张操作注册表(packages/operations/src/registry.ts)。每个操作在这里定义一次:名字、输入 schema、需要什么权限。然后:
- HTTP 路由从这张表来,OpenAPI 文档(
/openapi.json)也由这张表和 MCP 共用的同一份输入 schema 生成; - MCP 工具(
POST /mcp,Streamable HTTP 传输)也从这张表来,认证头和 HTTP 一样。
再往下一层,HTTP 和 MCP 这两个入口只负责认证和返回结果,真正的用例逻辑放在应用层,业务规则放在独立的 domain 包里。规则不写在路由里,两个入口就不可能各写各的。
目前这张表里的操作大致分几组:
| 分组 | 举例 |
|---|---|
| 页面 | put_page、edit_page、get_page、list_pages、delete_page、restore_page、get_versions、revert_version |
| 原件 | file_upload、file_list、file_url |
| 检索 | search、query、recall |
| 结构回写 | add_tag、add_link、get_backlinks、add_timeline_entry、remember、forget |
| 目录与身份 | sources_list、sources_add、whoami、get_skill |
| 站点 | put_site、preview_site、activate_site |
| 仅 HTTP | create_api_key、list_api_keys、revoke_api_key |
注意最后一行:和密钥相关的操作只在 HTTP 上存在,不暴露成 MCP 工具,而且需要所属人身份。这是「Agent 不能给自己发钥匙」这条原则在接口层面的落地——Agent 手里的工具清单里,压根就没有这把锤子。
六、授权:像登录电视 App 一样批准一个 Agent
接口有了,下一个问题是:Agent 拿什么凭证来调?
我提供了两种方式,二选一:
- API Key:
Authorization: ApiKey <key>或X-Api-Key头。适合脚本和简单场景。 - OAuth 2.1 设备码:
Authorization: Bearer <token>。适合 Agent。
两种方式都要所属人批准。这里重点讲一下设备码,因为我觉得它特别适合 Agent 这个场景。
你应该在电视上登录过视频 App:电视上显示一串码,让你用手机打开某个网址、输入这串码、点确认,电视那边就登录上了。这就是设备码流程(Device Authorization Grant)。它的好处是:需要授权的设备,从头到尾碰不到你的密码。
放到 Agent 上,流程是这样的:
- Agent 向
/oauth/device/auth申请一个设备码; - Agent 把批准地址和用户码告诉你(比如在对话里说「请打开这个链接确认授权」);
- 你登录 OneSelf 管理端(
/admin),看到这条申请,确认它要什么、给它什么,然后点批准; - Agent 那边轮询
/oauth/token,拿到访问令牌,之后可以刷新。
整个过程里,Agent 拿不到你的管理员密码,也没有办法自己完成「批准」这一步。批准页只有你能进。
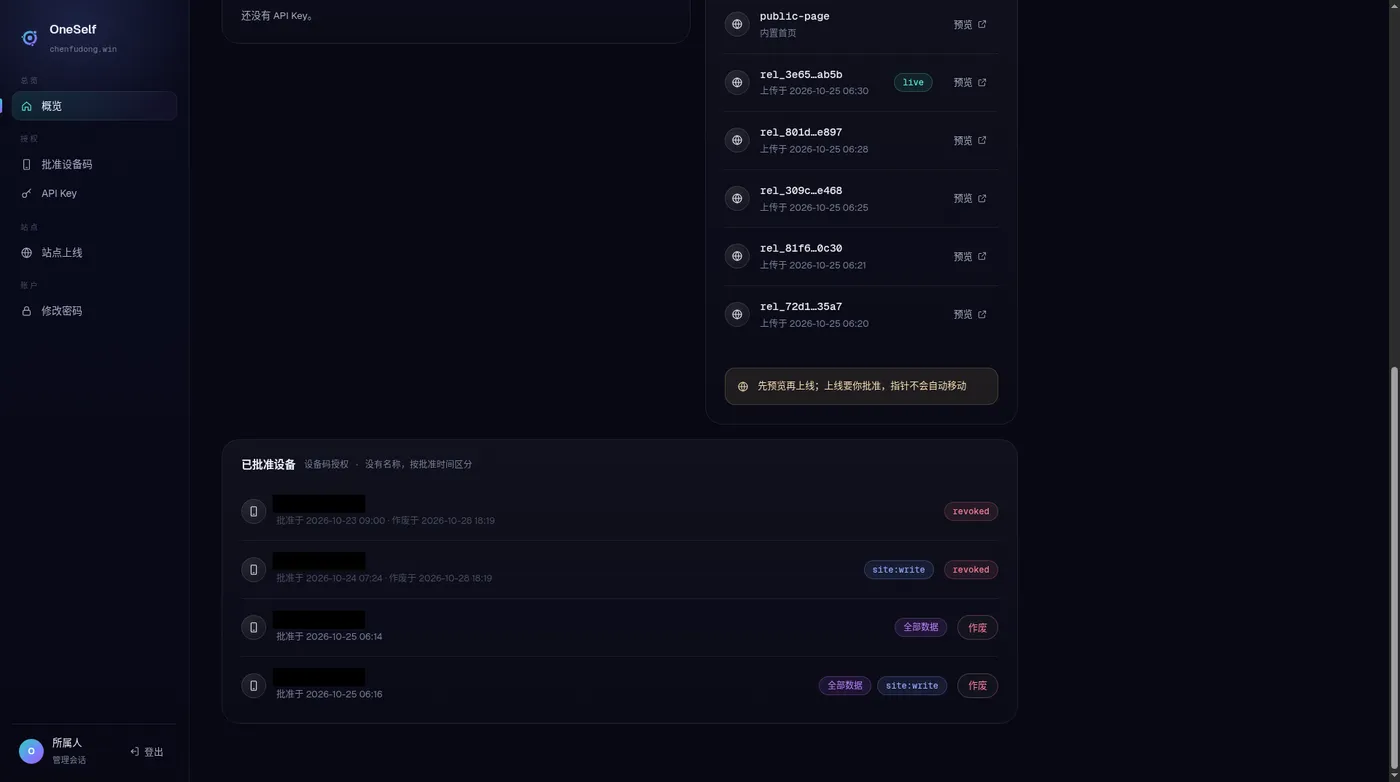
收回同样简单:在管理端里,每一把 API Key、每一个设备码授权都可以单独作废。作废一个,不影响其他。今天我不想让某个 Agent 再看我的资料了,点一下就完事,不用改密码,也不用重新配置别的 Agent。
授权范围则按目录(source)来划。比如我把资料分成 profile、career、health 几个目录,可以分别控制某个调用方在每个目录上能不能读、能不能写、能不能改可见性。写代码的 Agent 只给 profile 和 career,health 它就看不到——而且如前面所说,它看到的结果和「这里什么都没有」一样。
还有一个细节:公开主页。OneSelf 可以把你标成 public 的内容发布成一个对外的个人主页(访客只能读到公开内容)。有 site:write 权限的 Agent 可以帮你改主页、生成预览,但上线必须你批准。Agent 只能「申请上线」,不能「直接上线」。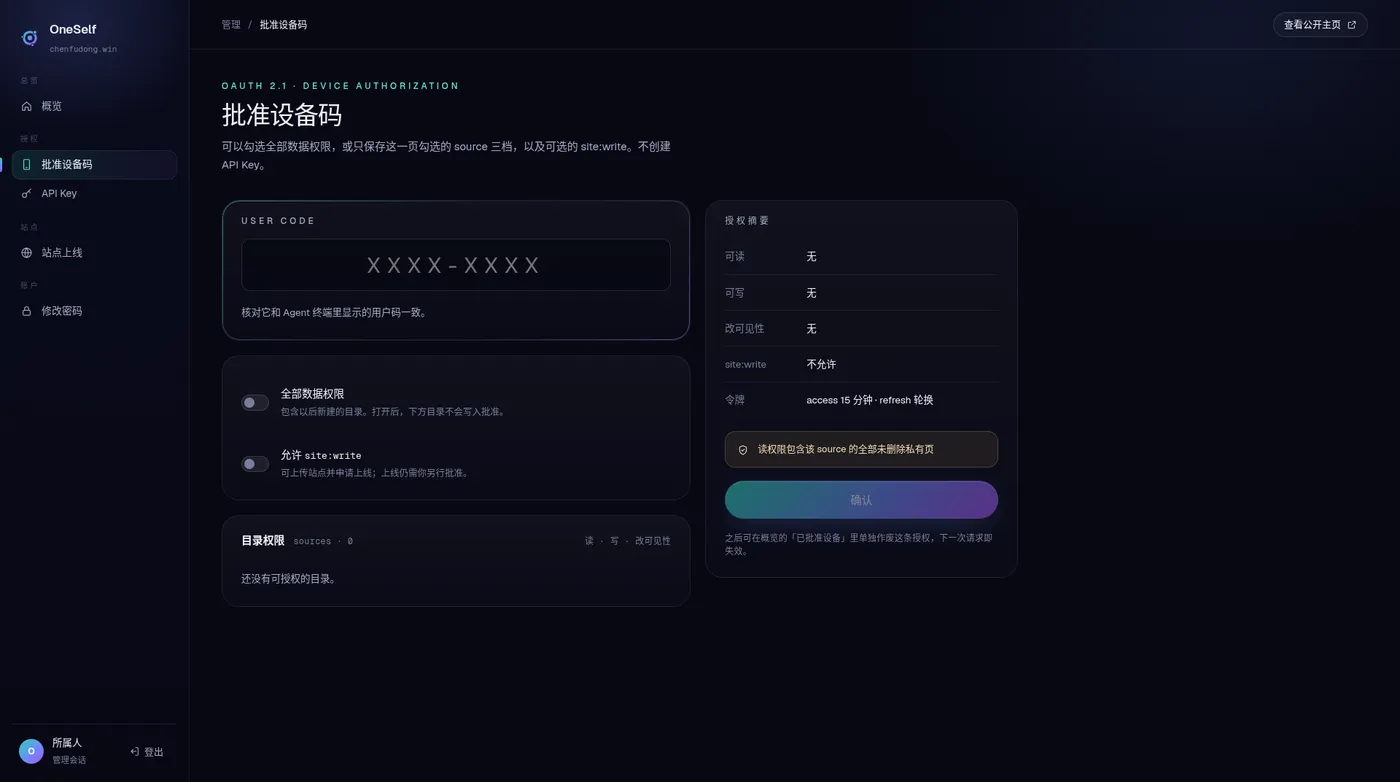
七、数据模型:页面、原件,以及会过期的事实
授权讲完,再看数据本身怎么组织。我花了不少时间在这里,因为它决定了 AI 维护起来顺不顺手。
页面 + 原件
一份上下文由两种东西组成:
- 页面:就是 Markdown 文件,用
(source, slug)唯一标识。type、title、visibility、tags这些元信息写在 frontmatter 里。 - 原件:照片、PDF 这种原始文件(目前支持 JPEG、PNG、WebP、GIF、PDF,单个最大 20 MiB),用
file_upload上传,然后挂到页面的files字段里。只有挂接的页面是公开的,原件才能匿名访问。
我选 Markdown,是因为它对人和 AI 都友好:人能直接读、直接改,AI 写起来也最自然,不需要学一套私有格式。
会过期的事实:Facts
关于一个人的陈述,大多数是有时效的。「现居上海」可能明年就不对了;「在学 Rust」可能三个月后就变成「放弃了 Rust」。
如果把这些都当成永久成立的句子写进去,时间一长,AI 读到的就是一个过时的你。所以页面里有一个专门的 ## Facts 区块,每条事实带上置信度和有效期:
---
type: profile
title: 工程师
name: 张三
visibility: public
tags: [public-profile]
files: []
---

# 张三

做个人工具和开发者产品。

## Facts

- id: fact_01
  entity: 张三
  statement: 现居上海
  confidence: 0.9
  valid_until: 2027-01-01

## Timeline

- 2024-06-01 | 加入某公司 | 做后端
confidence 让 AI 知道这条信息有多可靠——是我亲口说的,还是它从某份文档里推测的。valid_until 让它知道什么时候该怀疑这条信息、该来问我一下。Agent 可以通过 remember 和 forget 两个操作来记住或忘掉事实。
经历:Timeline
另一类信息是经历:哪年做了什么。这类信息不会「过期」,但有先后顺序。它们放在 ## Timeline 区块里,一行一条,日期 | 事件 | 补充。Agent 也可以通过 add_timeline_entry 往里补。
原文与投影
在存储上,我做了一个区分:页面原文和原件,以对象存储(RustFS)里的为准;PostgreSQL 里存的正文、标签、链接、事实、时间线,都是从原文解析出来的投影,用来做检索和结构化查询。
这样做的好处是,真正的「源数据」永远是一份份人能读懂的 Markdown 和原始文件,数据库坏了可以重建投影,不会把你的资料锁死在某个表结构里。
版本与软删除
前面说过,AI 会写错。所以:
- 编辑是增量的,带版本校验,避免两个 Agent 同时改一页时互相覆盖;
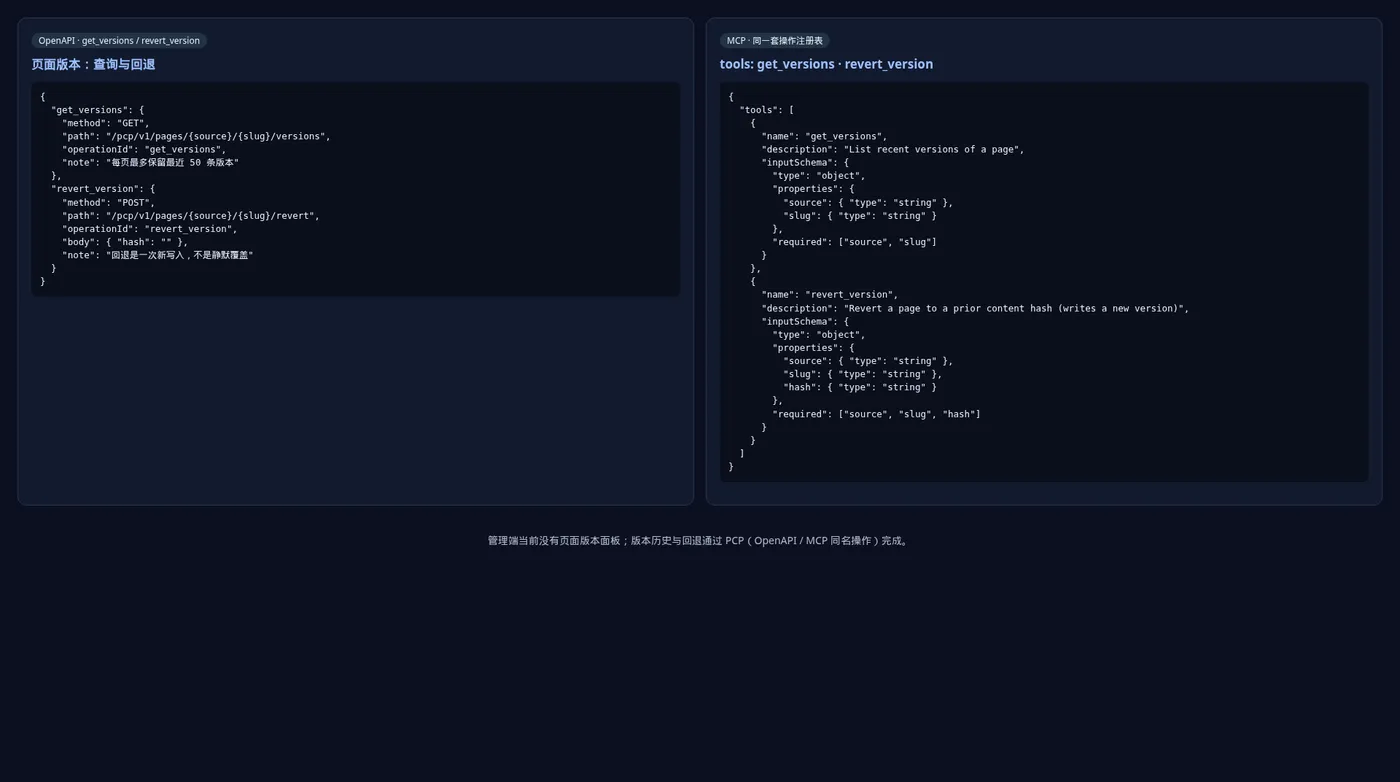
- 每一页保留最近 50 个版本;查看与回退不在管理端面板里,而是通过 PCP 上的同名操作完成——OpenAPI 与 MCP 共用
get_versions/revert_version(回退会写成一次新版本,而不是静默覆盖); - 删除是软删除,30 天内可以恢复(
restore_page)。目录也一样可以删除和恢复。
我自己用下来的感受是:有了这层兜底,才敢真的放手让 Agent 去整理资料。
八、技术栈与部署
技术栈很朴素:
- TypeScript(strict 模式)+ Node.js 24
- Hono 4 做服务端,React 19 做管理端
- PostgreSQL 18 存投影,RustFS(S3 兼容)存原文和原件
- MCP 用 Streamable HTTP 传输
整个服务是一个 Node 进程:PCP 接口、MCP、OAuth、管理端、已发布的公开站点,都由同一个 Hono 应用提供。对个人自托管来说,进程越少,出问题的地方越少。
部署用 Docker Compose,README 里提供了一行安装命令(macOS / Linux):
curl -fsSL https://github.com/ptonlix/OneSelf/releases/latest/download/oneself.sh | sh
Windows 也有对应的 PowerShell 一行命令,见仓库 README。安装器会一步步问你:管理员账号、对外地址、走什么入口(默认本机/局域网,也可以选 Cloudflare Tunnel、Caddy 或 Tailscale)。装好之后:
- 打开首页;
- 到
/admin登录并修改初始密码; - 给你的 Agent 装上
oneselfSkill,然后在管理端批准它的授权申请。
之后的更新、体检、备份、恢复,都有对应的命令(update、doctor、backup、restore)。
九、欢迎来试试
如果你也受够了在每个 AI 面前从头介绍自己,欢迎试一试:
- 源码:https://github.com/ptonlix/OneSelf(MIT 协议)
- 在线实例:https://chenfudong.win/,可以看看一个公开主页长什么样,也可以读一下它的
/.well-known/pcp - 演示视频:见仓库 README
几种参与方式:
- 装一个给自己用。 一行命令装好,把你最常被问到的那些信息——技术栈、写作偏好、饮食习惯——写成几页,然后让你的 Agent 装上 Skill、申请授权。下次换一个 AI,看看它是不是一上来就认识你。
- 提 Issue。 用起来哪里别扭、哪里不安全、哪里缺了什么,都欢迎告诉我。安全问题请按仓库里的 SECURITY.md 走,不要把密钥、口令或导出包贴到 Issue 里。
- 提 PR。 改动之前先读一下 CONTRIBUTING.md 和 PRD,操作名、权限或错误码有变化时,先改文档和操作注册表。
最后再说一次我做这个项目的那句话:
记忆可以属于 Agent,但「你是谁」必须属于你。
One self. One context. Every AI.