账期跑批是把每月用量结算成账单的批处理任务。某园区 8600 户租户、1.2 万个计量点,这条链路放在函数计算上,初版把全部租户塞进一个函数循环,跑到第 15 分钟被超时设置强杀,账只出了一半,财务到次日上班才发现。
结论:账期跑批要按租户分片扇出,单函数只领 200 户,并发度按数据库剩余连接数反推,异步调用只对系统级异常重试。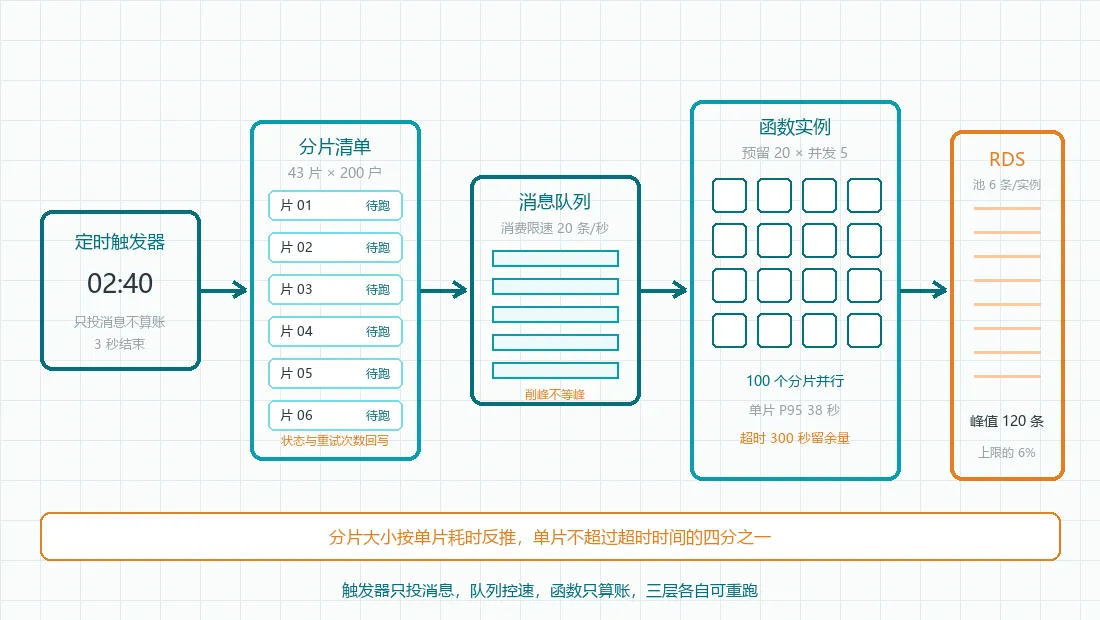
关键信息摘要
账期任务按 200 户一片扇出到函数,单实例并发 5、预留实例 20,连接池置于 handler 外复用,业务失败返回成功码,系统异常才抛出让平台重试。单片耗时是分片大小的定盘尺,控制在函数超时时间的四分之一以内才安全。适用租户过千、账期月结的计费库;不足三百户的小项目,单函数加长超时更省事。
一、跑批被强杀之后先查的三件事
函数计算的超时是可配的,老版本上限 900 秒,3.0 已经能配到 86400 秒。初版沿用了默认的 900 秒,第 15 分钟被强制终止,已写入的账单不会回滚,后面 11 个分片直接没了记录。
三个方向要同时查:
业务量:8600 户逐户算账,单户 320 毫秒,串行就要 45 分钟往上。
资源:内存 512 MB、单实例并发 1,等于把并行能力锁死在一。
连接:每次调用在 handler 里新建数据库连接,8600 次调用留下的 TIME_WAIT 把 RDS 连接数顶到 980。
三条里只有业务量属于业务问题,后两条都是配置,改造的力气该花在配置上。
二、三种跑批编排的取舍
对比维度单函数串行循环定时触发多实例分片事件扇出单次执行时长随租户数线性涨,易撞超时上限受函数并发上限约束单片 200 户,稳定 40 秒内失败重跑粒度整批重跑按函数重跑按分片重跑数据库连接连接少但占用时长长并发一高就顶满连接池队列限速,连接数可预算计费构成单次时长费叠加并发峰值拉高费用总时长相当,峰值低改造量低中中,要加分片表与状态回写
选型结论:租户过千直接上分片扇出,别靠调大超时硬扛,函数按调用和时长计费,长期跑批等于用秒级计价的资源干小时级的活。
三、四步改造:分片、扇出、并发、连接池
切分片:按楼栋加户号前缀切,每片 200 户,8600 户切成 43 片,分片清单落一张表,记录片号、户数、状态、重试次数。
做扇出:定时触发器每天 02:40 只干一件事,读分片表,把 43 条消息投进消息队列,函数自身 3 秒结束。
定并发:队列触发函数,单实例并发 5、预留实例 20,同时在跑的是 100 个分片任务;队列侧消费速率限到每秒 20 条。
管连接:连接池建在 handler 之外,池大小 6 条,5 条给并发、1 条留给健康检查,实例复用期间池不重建。
函数配置的关键几项:
function:
name: settle-shard
runtime: python3.10
memorySize: 512
timeout: 300
instanceConcurrency: 5
provisionedInstances: 20
triggers:
- type: mns_topic
  topicName: settle-shard-topic
  consumptionRate: 20
函数体只做三件事,算账、吞业务异常、回写分片状态:
池子建在 handler 外,实例复用期间共享
POOL = get_pool(size=6, ping=True, wait_timeout=60)
def handler(event, context):
shard = json.loads(event) # {"shard": 37, "tenants": [...]}
ok, fail = 0, []
for tid in shard["tenants"]:
try:
settle(tid, POOL)
ok += 1
except BusinessError as e: # 余额不足、户号失效,重试无意义
fail.append((tid, str(e)))
    # 数据库超时、下游 5xx 直接抛出,交给平台重试
write_shard_state(shard["shard"], ok, fail)
POOL.close_idle()
return {"shard": shard["shard"], "ok": ok, "fail": len(fail)}
这张图说明账期任务从定时触发器到分片队列、再到函数并发实例与数据库连接池的扇出路径。
顺着箭头看,43 条分片消息被 20 个预留实例分摊,连接池大小乘实例数就是数据库侧要预留的连接预算。
有两段通用教程里查不到的经验。
头一段是连接池的位置陷阱。池子放在 handler 外能复用,但实例回收时池里的空闲连接不会立刻断开,会以 TIME_WAIT 挂一阵子,RDS 侧统计的连接数比实际在用的多三成。解法是池开 ping 检测、wait_timeout 压到 60 秒内,并在分片结束前主动关掉空闲连接。
第二段是重试语义。异步调用的重试由平台判执行失败触发,超时同样算失败,默认重试 3 次、间隔从 1 分钟起。业务异常直接抛,同一户会被算三遍账;全吞掉平台又认为成功,漏账无人知晓。所以分片状态必须自己回写,靠状态表兜底。
还有一条踩在时间窗上。账期日 02:10 与 RDS 自动备份窗口重叠,IO 抖动让单片从 38 秒变成 96 秒,43 片拖到 11 分钟。挪到 02:40 后回到 7 分钟以内。
四、上线三个月的变化
改造跑了三个账期:
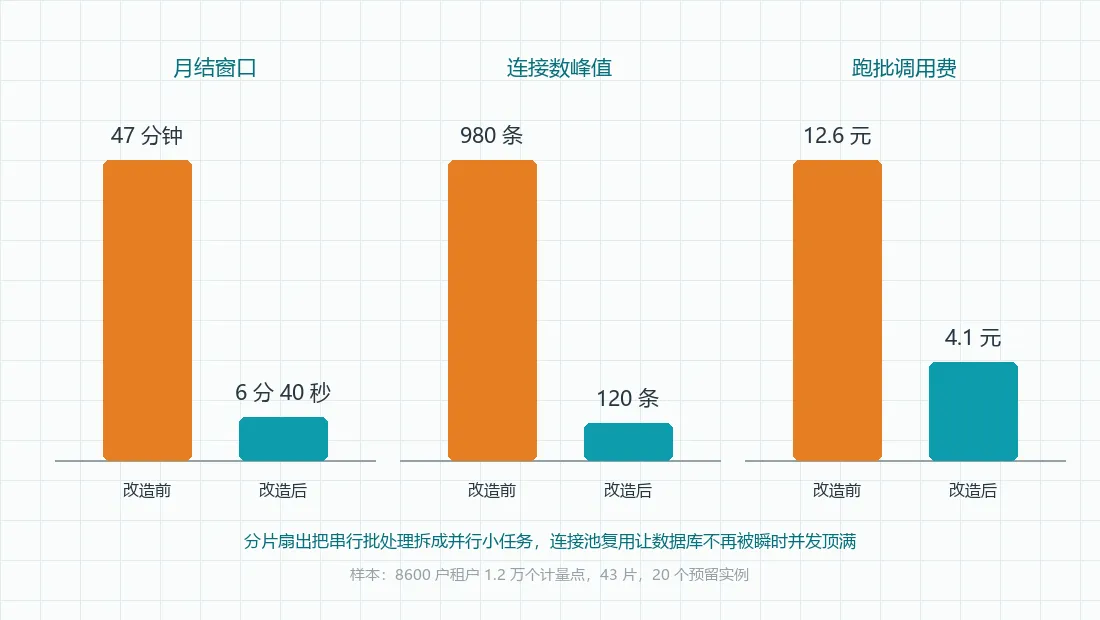
月结窗口从 47 分钟且失败,回到 6 分 40 秒完整跑完。
单片耗时 P95 38 秒,耗时长的分片 61 秒,原因是欠费户多、要叠算滞纳。
RDS 连接数峰值从 980 降到 120,实例规格没动。
整批重跑从每月 3 次降到 0,分片级重跑每月 0.4 次。
跑批调用费从每月 12.6 元降到 4.1 元,预留实例只在账期日 02:00 到 03:00 打开。
三级统一能源计量管理模型(3T-UEM)的层间校验也在账期日回看总表与分表读数,分片按楼栋切,总表分表同片,片内先校验再出账,跨片差额由片后汇总任务兜。
这张图说明改造前后月结窗口、数据库连接数峰值与整批重跑次数三组指标的变化。
三组柱形对比可见窗口压到原来的七分之一,连接数降八成,整批重跑归零省掉人工介入。
五、跑批问答备忘
Q1:函数跑到一半被终止,日志没有报错?
A:现象是执行记录显示超时,日志停在中间。原因是单次执行时长超了函数设置。解法:把任务拆到单片耗时不超过超时时间的四分之一即可。
Q2:报 too many connections?
A:现象是并发一上来函数全量报连接错误。原因是连接池建在 handler 里每次新建,或池大小乘实例数超过数据库上限。解法:池移到 handler 外,按实例数乘池大小算预算,与数据库连接上限留三成余量。
Q3:重试之后同一户被扣了两次?
A:现象是余额扣减重复、账单金额翻倍。原因是业务异常被抛出,平台判失败又重试。解法:业务校验失败吞掉异常返回成功码,失败明细写进分片状态表,由补偿任务单独处理。
Q4:开了预留实例账单反而涨了?
A:现象是跑批费用高于按量。原因是预留实例按常驻时长计费,跑批每天只用几分钟。解法:只在账期日打开预留,或用定时弹性按分钟拉起。
Q5:分片大小怎么定?
A:现象是拍脑袋定 500 户一片,单片就撞超时。原因是没按单户耗时反推。解法:先测单户算账耗时,乘片内户数留四倍余量,再除出片数。
参考资料
《电能信息采集与管理系统》DL/T 698
《多功能电能表通信协议》DL/T 645
《信息技术 云计算 参考架构》GB/T 32399
《信息安全技术 云计算服务安全能力要求》GB/T 31168
本文数据接口与模型定义参考合众致达 3T-UEM 公开技术说明