一、Agent 是什么:会"思考-行动-观察"的自主工作者
在 LangChain 框架中,Agent(智能体)是一个高级组件:它把大型语言模型(LLM)与一系列外部工具(Tools)结合起来,构建出能够自主推理并执行复杂任务的智能系统。核心思想是拿 LLM 当"推理引擎"(Reasoning Engine),让模型动态决定为解决用户问题需要采取的行动序列——选什么工具、按什么顺序调用、结果怎么用,并迭代处理工具返回的结果,直到任务完成。
换句话说,Agent 不再只是生成文本的模型,而是一个具备"思考-行动-观察"(Reasoning-Acting-Observing)循环的自主工作者。用户提出复杂需求时,它像人类一样:先理解任务、规划步骤、调用工具(搜索网络、查询数据库、执行计算)获取信息,最后综合所有信息给出最终答案。
它和前两篇文章的关系也在这里闭环:bind_tools + 手动循环是 Agent 的底层协议,create_agent 则是把那个 while 循环包装成带状态、带中间件的执行图。
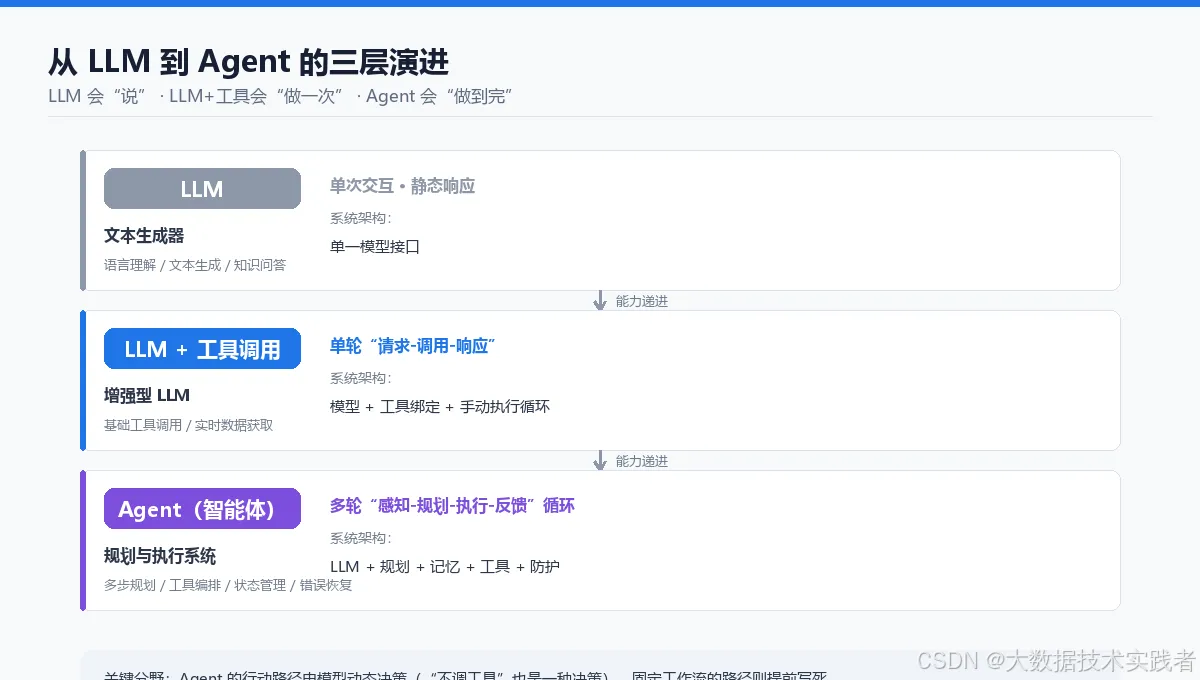
LLM、LLM+工具调用、Agent 的区别
| 对比角度 | LLM | LLM+工具调用 | Agent |
|---|---|---|---|
| 本质定位 | 文本生成器,基于训练数据生成连贯文本 | 增强型 LLM,通过函数调用扩展能力边界 | 具备规划和执行能力的智能系统,以任务闭环为目标 |
| 核心功能 | 语言理解、文本生成、知识问答 | 基础工具调用、实时数据获取、简单操作执行 | 多步规划、工具编排、状态管理、错误恢复 |
| 工作模式 | 单次交互,静态响应 | 单轮"请求-调用-响应" | 多轮"感知-规划-执行-反馈"循环(ReAct 框架) |
| 系统架构 | 单一模型接口 | 模型+工具绑定+手动执行循环 | LLM+规划+记忆+工具使用+防护措施 |
| 状态管理 | 需外部维护状态 | 需外部维护状态 | 内置记忆系统,支持短期/长期状态管理 |
| 错误处理 | 失败即终止,无自动恢复 | 失败即终止,无自动恢复 | 支持重试、回滚等恢复机制 |
一句话记住三者的递进:LLM 会"说",LLM+工具会"做一次",Agent 会"做到完"。
二、ReAct 循环:Agent 的心脏
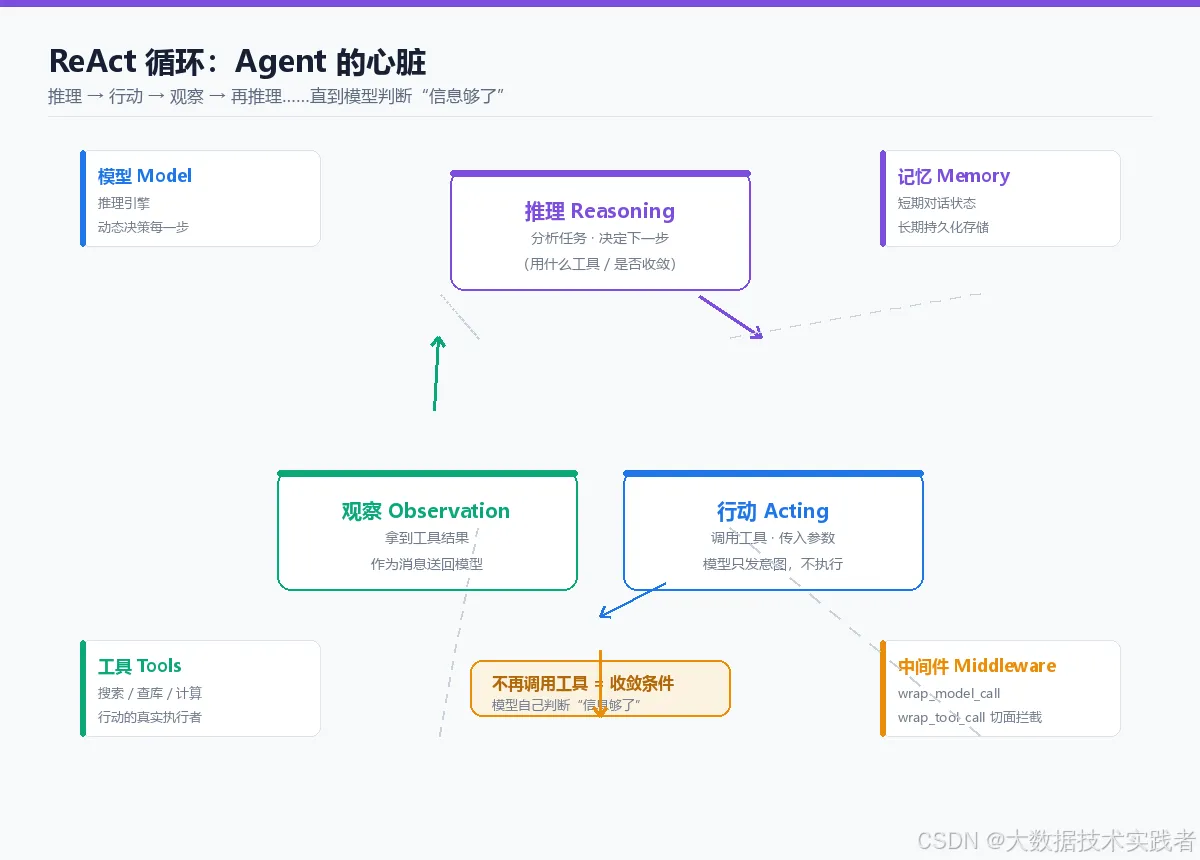
Agent 的核心工作原理遵循 ReAct(Reasoning + Acting,推理+行动)框架:在一个循环中交替进行推理和行动,这个过程涉及模型、工具、记忆、中间件等核心组件。
看一个完整例子——用户任务:"找出当前最流行的无线耳机并检查库存"。
1) 输入解析与初始推理
LLM 分析任务后认为:要找"最流行"的产品,需要最新的市场信息,应该先使用搜索工具。
2) 第一次行动与观察
Agent 调用 search_products 工具,参数为 "wireless headphones"。观察:工具返回"找到 5 款匹配产品,Top 结果:WH-1000XM5……"。
3) 迭代推理
LLM 根据搜索结果分析:WH-1000XM5 是排名第一的型号,现在需要确认其库存状态才能回答用户问题。
4) 第二次行动与观察
Agent 调用 check_inventory 工具,参数为 "WH-1000XM5"。观察:工具返回"产品 WH-1000XM5:库存 10 件。"
5) 最终输出
LLM 综合所有信息后认为:已获得所需信息,可以生成最终答案。行动:模型生成最终答案,不再调用工具——循环收敛。
注意第 5 步:"不调工具"本身就是一种决策。循环的终止条件是模型自己判断"信息够了",不是外部写死的 if。这正是 Agent 与固定工作流(Workflow)的本质分野——前者路径由模型动态决定,后者路径在图里写死。
三、create_agent:一行代码创建智能体
在 LangChain 1.x 中,create_agent 是构建智能体的核心 API。它把模型与工具组合起来,返回一个具备执行能力的实体——内部基于 LangGraph 构建的执行图(类型为 CompiledStateGraph):
from langchain.agents import create_agent
from langchain.chat_models import init_chat_model
from langchain.tools import tool

@tool
def get_weather(city: str) -> str:
    """获取指定城市的天气信息。"""
    return f"{city}的天气为晴朗,25°C。"

deepseek_llm = init_chat_model(
    model="deepseek-chat",
    model_provider="deepseek",
    api_key=DEEPSEEK_API_KEY,
    base_url=DEEPSEEK_BASE_URL,
)

agent = create_agent(deepseek_llm, tools=[get_weather])
print(type(agent))  # CompiledStateGraph
三个要点:
- 1.0+ 版本统一了入口:早期用
create_react_agent,现在统一为create_agent;返回的不是简单的"Agent 对象",而是一个编译好的执行图——这意味着状态管理、检查点、流式输出能力全部来自 LangGraph; - 核心参数只有 model 和 tools,其余(system_prompt、middleware、response_format、checkpointer 等)按需叠加;
- 模型是 Agent 的"大脑",负责决策和推理,LangChain 支持静态与动态两种配置方式。
静态模型与动态模型
静态模型在创建时一次性配置,整个执行过程保持不变,最简单也最常用。动态模型则通过中间件在运行时根据对话状态切换模型——比如简单问题走便宜模型,复杂对话自动升级到强模型:
from langchain.agents.middleware import wrap_model_call, ModelRequest, ModelResponse

@wrap_model_call
def dynamic_model_selection(request: ModelRequest, handler) -> ModelResponse:
    """根据对话消息数动态选择模型"""
    message_count = len(request.state["messages"])
    model = advanced_model if message_count >= 3 else basic_model
    return handler(request.override(model=model))

agent = create_agent(
    model=basic_model,                       # 默认模型
    tools=[get_current_location, get_weather],
    system_prompt="你是一个助手,可以帮助用户回答各种问题。",
    middleware=[dynamic_model_selection],    # 挂载中间件
)
@wrap_model_call 标记的方法是模型选择中间件:request 封装了本次模型调用的全部信息;handler 是后续处理链,通过 request.override(model=...) 修改请求后继续流转。agent.invoke() 启动的推理循环里,每次 LLM 调用前都会触发它——这是成本优化的标准姿势:对话轮数超过阈值再动用贵模型。
四、Agent 的调用:messages 是标准输入
resp = agent.invoke({
   "messages": [{
   "role": "user", "content": "查询北京的天气"}]})
print(resp["messages"][-1].content)
输入格式固定:{"messages": [{"role": "...", "content": "..."}]}。也可以在消息列表开头加入 system 角色的消息来定义 Agent 的行为:
resp = agent.invoke({

    "messages": [
        {
   "role": "system", "content": "你是一个天气查询助手,只回答天气相关的问题。"},
        {
   "role": "user", "content": "100加上50等于多少?"}
    ]
})
返回的 resp 是包含完整消息历史的字典,resp["messages"][-1] 即最终回复。调试时用 msg.pretty_print() 格式化输出所有消息,完整回溯 Agent 的每一步思考与调用。
五、提示词:定义 Agent 的角色与使命
system_prompt 参数定义 Agent 的"角色"和"使命",可以是 str 或 SystemMessage:
from langchain_core.messages import SystemMessage

agent = create_agent(
    model=deepseek_llm,
    tools=[add_numbers],
    system_prompt=SystemMessage(content="你是一个数学助手,可以实现两数相加。"),
)
更高级的是动态提示词——通过 @dynamic_prompt 中间件根据运行时上下文生成不同的系统提示。客服场景:普通用户和 VIP 用户看到的是两套"角色+工作策略":
from langchain.agents.middleware import dynamic_prompt, ModelRequest
from typing import TypedDict

class AgentContext(TypedDict):
    query_type: str  # 'normal' 或 'vip'

@dynamic_prompt
def dynamic_support_prompt(request: ModelRequest) -> str:
    query_type = request.runtime.context.get("query_type", "normal")
    if query_type == "vip":
        return """你是一名电商客服助手。当前角色:高级支持专员。
        工作要求:深度分析、精准分类、方案规划,使用更专业严谨的语言。"""
    return """你是一名电商客服助手。当前角色:一线客服助手。
        工作要求:快速响应、直接解答、简洁友好,保持友好高效的沟通风格。"""

agent = create_agent(
    model=deepseek_llm,
    tools=[query_order_info, search_faq],
    middleware=[dynamic_support_prompt],
    context_schema=AgentContext,
)

# 调用时传入上下文:同一 Agent,两种人格
agent.invoke({
   "messages": [...]}, context={
   "query_type": "vip"})
同一个 Agent,context 一换,人格与策略跟着换——提示词从"创建时写死"变成"运行时决策"。
六、工具与错误处理:让循环稳起来
Agent 的工具定义有三种方式(详见《模型调用工具》篇):@tool 装饰器(参数简单、快速验证)、Pydantic 模型(复杂参数、枚举与自定义校验)、JSON Schema(参数运行时动态生成)。选择逻辑一句话:参数简单用装饰器,参数复杂用 Pydantic,参数动态用 Schema。
比定义更重要的,是错误处理。生产环境里工具一定会失败:API 超时、权限不足、参数越界。LangChain 的答案是 @wrap_tool_call 中间件——把异常捕获下来,转化成有意义的错误信息回传给模型,而不是让未处理的异常直接中断整个流程:
from langchain.agents.middleware import wrap_tool_call
from langchain.messages import ToolMessage

@wrap_tool_call
def handle_tool_errors(request, handler):
    try:
        return handler(request)
    except Exception as e:
        return ToolMessage(
            content=f"调用工具错误:请检查输入参数并重试. ({str(e)})",
            tool_call_id=request.tool_call["id"],
        )

agent = create_agent(model="gpt-4o", tools=[search, get_weather],
                     middleware=[handle_tool_errors])
执行时机:用户提问 → LLM 决定调用工具 → 错误处理中间件介入 → 实际工具执行 → 结果/错误返回。每个中间件都可以选择直接处理,或通过 handler(request) 传递给下一个处理程序,最终到达真正的工具执行层,结果再逆序返回。
关键设计:错误不是终止信号,而是送回模型的一条消息——模型读到"请检查输入参数并重试",会自我修正后重发请求。这就是"错误恢复"在 Agent 里的真实含义:把异常转化为模型可理解、可行动的上下文。
七、结构化输出与异步调用
想让 Agent 给出"标准答案格式",用 response_format 参数(详见《模型结构化输出》篇):
from langchain.agents.structured_output import ToolStrategy

agent = create_agent(
    model="gpt-4o-mini",
    tools=[search_tool],
    response_format=ToolStrategy(ContactInfo),
)
Agent 循环跑完,最终结果按 Pydantic、Dataclass、TypedDict、JSON Schema 四种 Schema 之一输出,下游代码拿到的是结构化对象而非自由文本。
异步场景用 ainvoke,让多个独立查询并发执行:
result = await agent.ainvoke({
   "messages": [{
   "role": "user", "content": "..."}]})
多 Agent 并发、批量任务都建立在异步调用之上——比如同时查三个城市的天气再汇总。
八、流式输出:看见 Agent 的每一步
Agent 的推理循环包含多轮 LLM 调用和工具执行,延迟天然高于单次对话。stream() 配合 stream_mode 把内部过程实时吐出来:
| 模式 | 输出内容 | 使用场景 |
|---|---|---|
| values | 每个步骤执行后输出完整状态 | 每步都要完整状态、状态持久化 |
| updates(默认) | 只增量输出状态中变化的内容 | 监控执行进度:调了哪个工具、结果如何 |
| messages | 流式 Token + 元数据(来源节点 model/tool) | ChatGPT 式打字机效果,交互式应用首选 |
| tasks | 当前 task 的结果和错误信息 | 监控任务生命周期 |
| debug | 比 tasks 多步骤、时间戳、task 类型 | 调试、监控任务生命周期 |
| checkpoints | 检查点创建时输出其中的状态 | 状态持久化、工作流恢复、分布式跟踪 |
| custom | 通过 get_stream_writer 自定义发送的数据 | 业务进度("已处理 10/100 条")、自定义日志 |
for stream_mode, chunk in agent.stream(
    {
   "messages": [{
   "role": "user", "content": "查询客户信息和可用优惠"}]},
    stream_mode=["tasks", "updates"],   # 模式可组合
):
    print(stream_mode, chunk)
选型建议:实时对话交互选 messages;观察 Agent 的思考与执行步骤选 updates;需要每步完整状态选 values;生产监控与调试选 tasks/debug;工具内输出业务日志选 custom。
九、给 Java / 大数据工程师的对照
- ReAct 循环 ≈ Flink 迭代计算:数据流入 → 处理 → 结果回流 → 再触发,直到收敛(没有新工具调用);模型就是迭代算子里的那个"决策函数";
- 中间件 ≈ 责任链 + AOP:
wrap_model_call/wrap_tool_call在调用前后切面拦截,日志、鉴权、降级、错误处理全部可以切进去,不动核心逻辑; - CompiledStateGraph ≈ 编译后的执行计划:
create_agent返回的是"编译态"的图,类似 Spark 的 Physical Plan——先编译,后执行; - checkpoints ≈ 分布式快照:流式输出里的 checkpoint 模式和 Flink Checkpoint 同构,为恢复与容错而生。
十、小结
- Agent = LLM(推理引擎)+ 工具 + ReAct 循环,从"生成文本"进化为"完成任务";
- 与固定工作流的分野:路径由模型动态决定,"不调工具"也是模型的一种决策;
- create_agent 是统一入口,返回基于 LangGraph 的编译图;静态模型简单直接,动态模型靠中间件按需切换、优化成本;
- 提示词可静态可动态:
@dynamic_prompt+context_schema让同一 Agent 拥有多种人格; - 错误处理靠中间件:把异常变成模型可理解的消息,循环才能自我恢复;
- stream_mode 七种模式,按交互、监控、持久化诉求组合使用。
本文基于 LangChain v1.x 官方文档与《Agent 智能体》笔记整理,代码在 Python 3.13 + langchain 1.2.0 环境下验证通过。