
导读:存算分离架构下,计算组间缓存无法共享,容易导致冷查询延迟高、扩缩容后性能抖动等问题。即将发布的 Apache Doris 4.2 引入 Peer Read 机制,实现跨计算组缓存复用。实测主键点查冷查询性能提升约 7.5 倍,有效降低冷读延迟与对象存储访问开销。
作者:邓鑫,SelectDB 存储研发工程师
在 Apache Doris 存算分离架构中,部署多个计算组时,通常会遇到以下三类问题:
读写分离后的首次查询延迟:新导入的数据已缓存在写入组,读取组首次查询时仍需从对象存储回源读取,单条主键点查的延迟可达数秒。
扩缩容后的性能抖动:计算组扩容或 Tablet 重新均衡后,新节点的本地缓存为空,查询性能需要一段时间才能恢复。
缓存淘汰后的重复回源:读取组的缓存容量有限,数据被淘汰后再次被访问,又要重新从对象存储读取。
这些问题的根源在于:存算分离让各计算组共享了数据,却没有共享缓存。
Apache Doris 4.2 新增的 Peer Read 机制,正是为解决这一问题设计:当本地缓存未命中时,优先从可能已缓存该数据的其他节点读取,包括其他计算组的节点;对方没有数据或响应过慢时,再回源对象存储。
在某用户的真实业务场景中,开启 Peer Read 后:
主键点查的冷查询平均耗时从 4.45 秒降至 0.59 秒,查询速度提升约 7.5 倍;
P99 延迟从 7.69 秒降至 1.52 秒,对象存储请求次数减少约 98%。
在 TPC-H 1TB 冷读测试中,22 条查询的总耗时降低约 51%。
一、缓存孤岛:数据共享,缓存不共享
存算分离架构下,一个 Doris 集群可以挂载多个计算组,用于读写分离、在离线隔离和弹性扩缩容。数据和元数据在各计算组之间共享,任一计算组写入后,其他计算组立即可见。
但为了保证查询性能,每个计算组的 BE 都有各自的本地 File Cache,这一层并不共享:写入组已缓存的数据,读取组无法直接使用;读取组 A 已缓存的数据,读取组 B 同样用不上。每个计算组都成了一座“缓存孤岛”。前面提到的三类问题,都源于此。
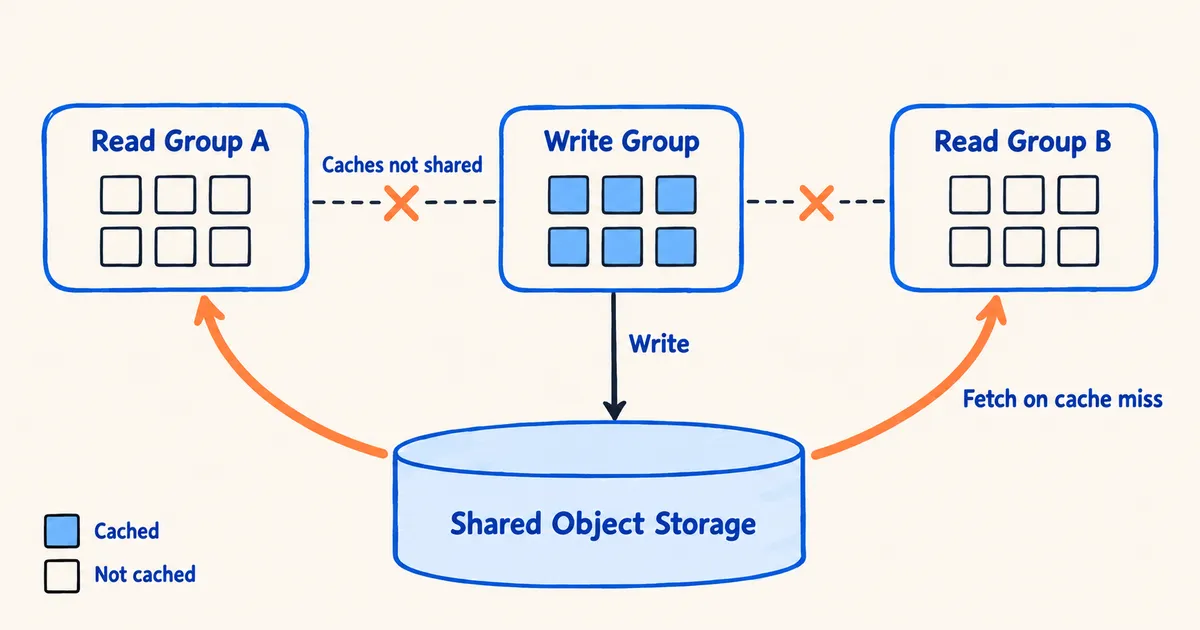
各计算组共享对象存储中的数据,但本地缓存互不共享,读取组未命中时只能各自回源。
1.1 冷读为什么慢
对象存储擅长大块数据的吞吐,但单次请求的延迟远高于本地磁盘和同机房网络。很多查询在读取数据之前,需要先读取一批 Segment Footer 和索引,这些读取单次数据量很小,次数却很多。在第四节的主键点查测试中,每条查询平均发起 200 多次远端 IO,大部分是 Footer 和索引这类小块读取。这类查询的耗时,主要花在逐次等待对象存储的请求延迟上。
1.2 缓存预热与 Peer Read
Doris 在之前版本中,已经提供了缓存预热能力,包括写入后主动通知读取组的增量预热。预热的前提是事先知道哪些数据会被访问,在查询到来之前把数据从对象存储拉取到本地缓存。
对于预热尚未覆盖、只有在查询时才发现缓存未命中的数据,则可以通过 Peer Read 进行补充。
| 对比维度 | 缓存预热 | Peer Read |
|---|---|---|
| 触发时机 | 查询之前,主动将数据从对象存储拉取到本地缓存 | 查询时本地缓存未命中,从其他节点读取 |
| 前提 | 事先知道哪些数据会被访问,并配置预热任务或预热关系 | 无需预判数据冷热 |
| 适用场景 | 已知的热点数据、新导入数据的增量同步 | 预热未覆盖的冷读:扩缩容之后、缓存淘汰之后、预热尚未完成时 |
| 代价 | 每个读取组都需预留缓存空间,预热本身也要读取对象存储 | 读取时占用对端节点的网络和磁盘资源 |
两者可以配合使用:缓存预热提前加载已知热点数据,Peer Read 则在查询时补足未命中的缓存。
二、Peer Read 的工作原理
Peer Read 不引入新的缓存服务,直接复用各个 BE 已有的 File Cache。它只在本地 File Cache 未命中时介入,本地命中时读取路径不变。一次缓存未命中的处理流程如下:
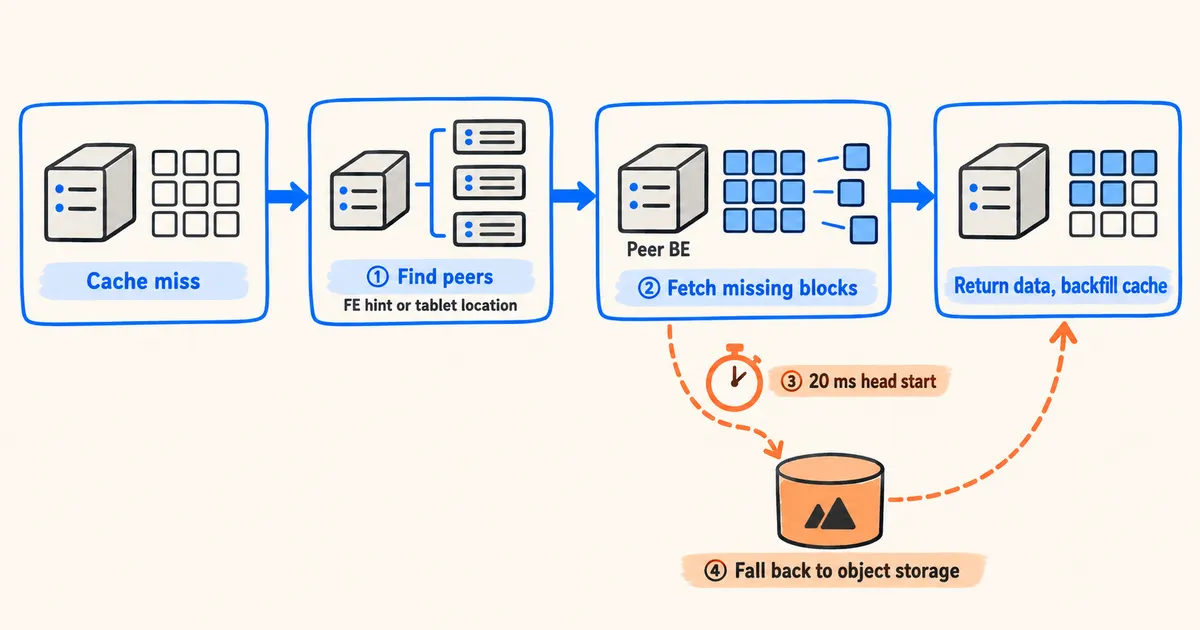
Peer Read 处理一次缓存未命中:找到候选节点,只读取缺失的缓存块,必要时回源对象存储,最后回填本地缓存。
2.1 候选节点的来源
候选节点(下文称 Peer)有两个来源:
扩缩容时由 FE 指定:在同一计算组内,Tablet 从原 BE 迁移到新 BE 时,FE 会将原 BE 告知新 BE,作为最高优先级的候选。新 BE 首次读取即可从原 BE 获取缓存块,无需直接回源。
按需向 FE 查询:本地没有候选时,BE 在后台向 FE 查询该 Tablet 在各计算组的分布,当前读取不等待查询结果,先回源对象存储。一次冷查询内部有大量并发读取,读取第一个 Footer 时就会触发查询,因此同一条查询的后续读取通常已能使用 Peer。
此外,BE 会记录每个 Tablet 上次成功读取的计算组,下次优先向它请求。
2.2 只读取缺失的缓存块,并回填本地缓存
请求方只向 Peer 请求本地缺失的缓存块。数据返回后,一份交给当前查询,一份写入本地 File Cache,下次相同的读取即可命中本地缓存。
2.3 与对象存储竞速:Peer 优先 20 毫秒
Peer Read 默认与对象存储读取竞速。请求先发往 Peer,并给予 Peer 20 毫秒(可配置)的优先时间:Peer 在 20 毫秒内返回,就不再发起对象存储请求;超过 20 毫秒仍未返回,则同时读取对象存储,采用先返回的结果。
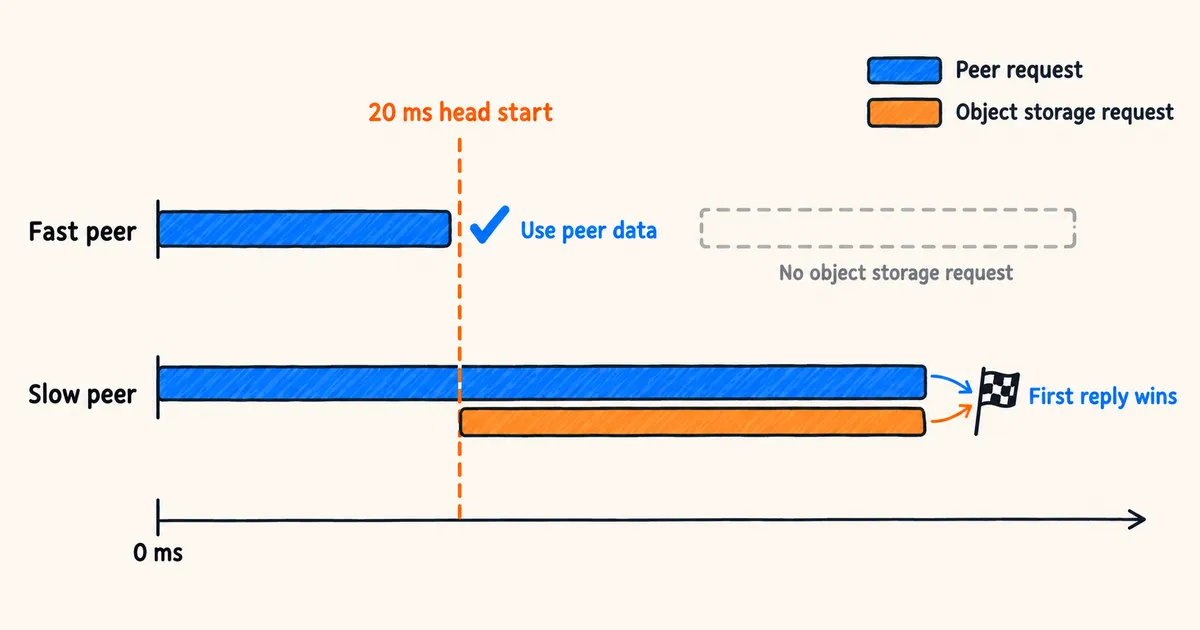
Peer 优先 20 毫秒:Peer 及时返回时不访问对象存储;Peer 较慢时两路同时读取,采用先返回的结果。
这一设计在两种极端之间取得平衡:如果 Peer 与对象存储同时发起请求,每次未命中都会多产生一次对象存储请求;如果一直等待 Peer,一个慢节点就会拖慢整条查询。
2.4 失败时自动回源
Peer 不可达、超时、没有对应数据或正在限流时,查询会自动回源对象存储,不会报错。系统还会持续维护候选列表:没有数据的节点移到列表末尾,连续失败的节点被剔除;某个 Tablet 的所有候选都反复未命中时,暂停一段时间的 Peer 尝试,避免反复请求无效节点。
2.5 由写入组代为回源
在一写多读场景下,可以将写入组指定为读取组的“填充计算组”。读取组向写入组请求数据时,如果写入组 BE 本身也没有缓存,就由它代为回源对象存储,先写入自己的 File Cache,再将数据返回给读取组。
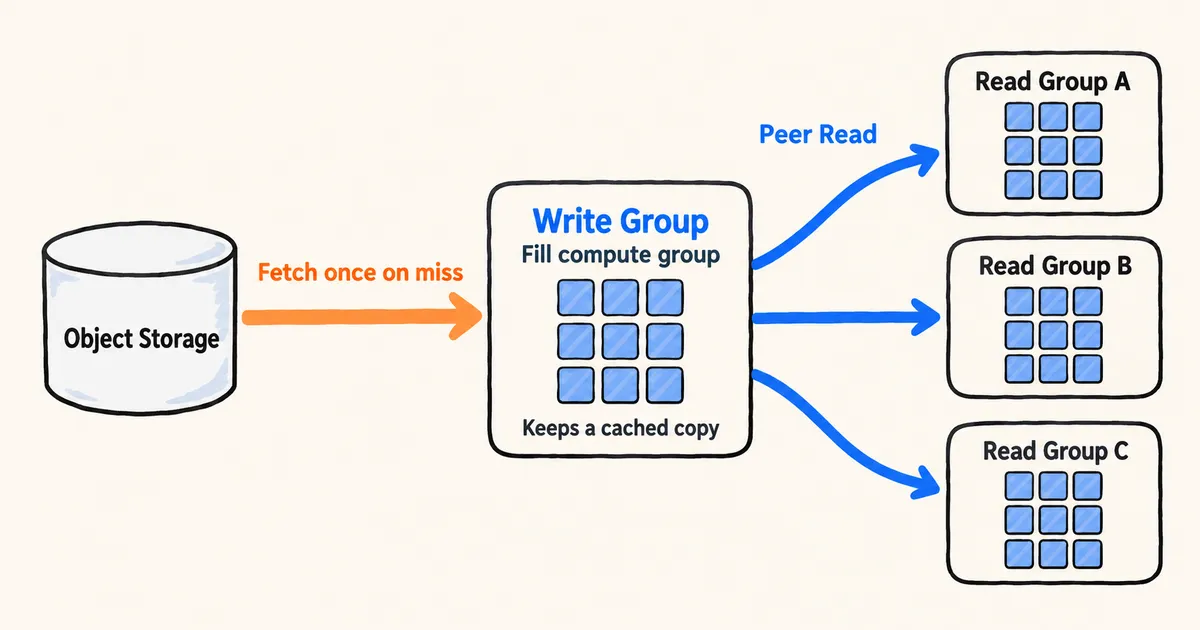
写入组作为填充计算组:冷数据只回源一次,多个读取组共享写入组的缓存。
这样,多个读取组对同一份冷数据只需回源一次,缓存也集中在写入组上,其他读取组后续访问即可直接命中。填充有并发和超时上限,超过上限时由请求方自行回源。
三、TPC-H 1TB:冷读总耗时减少约一半
我们先用 TPC-H 1TB 数据集,在写入组和读取组之间做了冷读对照测试:写入组已缓存数据,读取组在每条查询执行前清空缓存,依次执行 22 条查询。
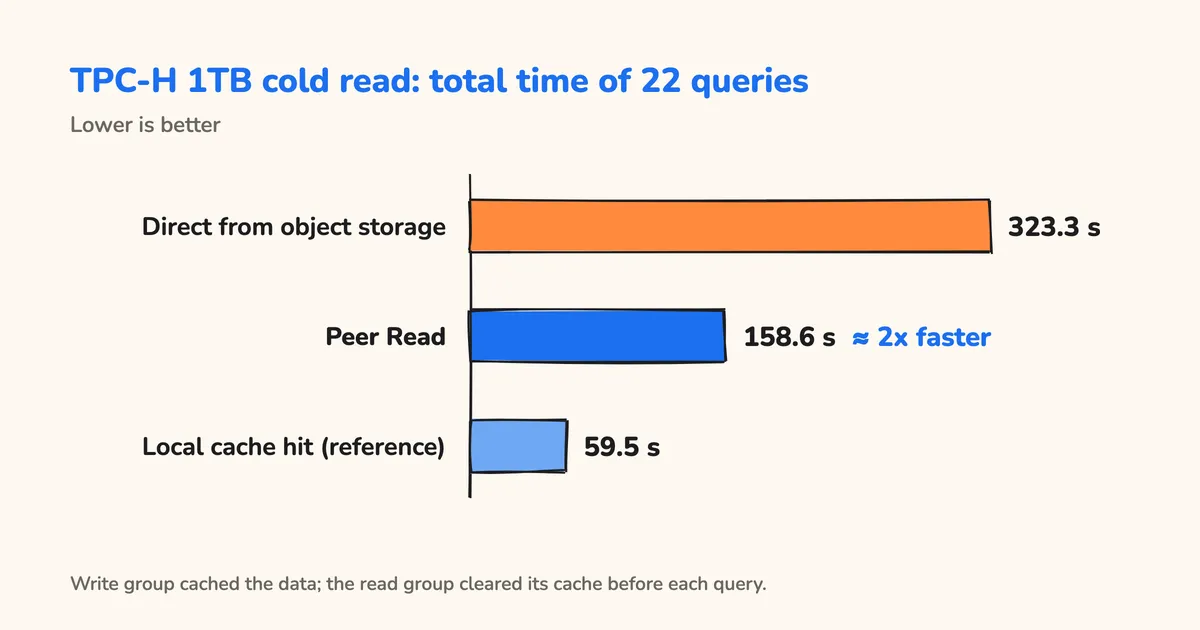
| 读取方式 | 22 条查询总耗时 | 对比直读对象存储 |
|---|---|---|
| 冷读,直读对象存储 | 323.3 秒 | 基准 |
| 冷读,开启 Peer Read | 158.6 秒 | 快约 2 倍,耗时减少 51% |
| 热读,本地缓存命中(参照) | 59.5 秒 | — |
测试条件:TPC-H 1TB;1 个 FE(4 核 16GB),6 个 BE(32 核 128GB,每个 BE 3 块 500GB 云盘),写入组和读取组各 3 个 BE;缓存块 1MB;Peer Read 使用默认的竞速模式。
开启 Peer Read 后,冷读总耗时从 323.3 秒降至 158.6 秒,整体查询速度提升约 2 倍。
进一步改用“先 Peer、失败再回源”的串行模式,总耗时为 155.5 秒,结果相近;在串行模式下逐条对比,22 条查询均快于直读对象存储,单条加速 1.4~3.3 倍。
3.1 写入组也未缓存时:代为回源的额外开销约 3%
上面的测试中,写入组已缓存了数据。如果数据刚刚写入、写入组自身也尚未读取过,读取组向写入组请求时,写入组同样未命中,就会代为回源:从对象存储读取数据,写入自己的缓存,再返回给读取组。
我们也测试了这种最坏情况:写入组和读取组都没有缓存,由写入组代为回源,22 条查询总耗时 332.4 秒,仅比读取组直读对象存储多约 3%。
测试条件同上,这组测试使用串行模式(先 Peer,失败再回源)。
这组数据说明两点:
代为回源几乎不增加开销:多经过一跳转发,总耗时只增加约 3%,开启填充计算组在最坏情况下也不会明显变慢。
收益体现在后续读取:这次读取之后,数据已保留在写入组的缓存中,其他读取组再读同一份数据,就相当于上表中“开启 Peer Read”的情形。多个读取组读同一份冷数据,原本需要各自回源,现在只需回源一次。
四、用户实践:一写多读 API 服务,冷查询提升约 7.5 倍
TPC-H 是标准的分析型负载,下面来看一个真实业务场景。
某用户在 SelectDB(基于 Apache Doris 的云服务)上采用一写多读架构:一个写入组持续导入新数据,多个读取组承载对外的 API 查询,查询以主键点查为主。新数据首次被查询时延迟波动明显;为了抑制波动,每个读取组都需要预留充足的缓存,同一份数据在多个计算组中各存一份。
接入 Peer Read 时,DBA 为该用户将写入组设为读取组的填充计算组:读取组本地未命中时,先从写入组读取;写入组也没有时,由写入组代为回源。
为了量化效果,该用户用业务表(Unique Key 主键模型)实测了 100 条主键点查:写入组先将数据读热;读取组清空缓存并重启后,分别在关闭和开启 Peer Read 时执行同样的 100 条查询,覆盖 100 个不同的 Tablet,串行执行,每条一次。
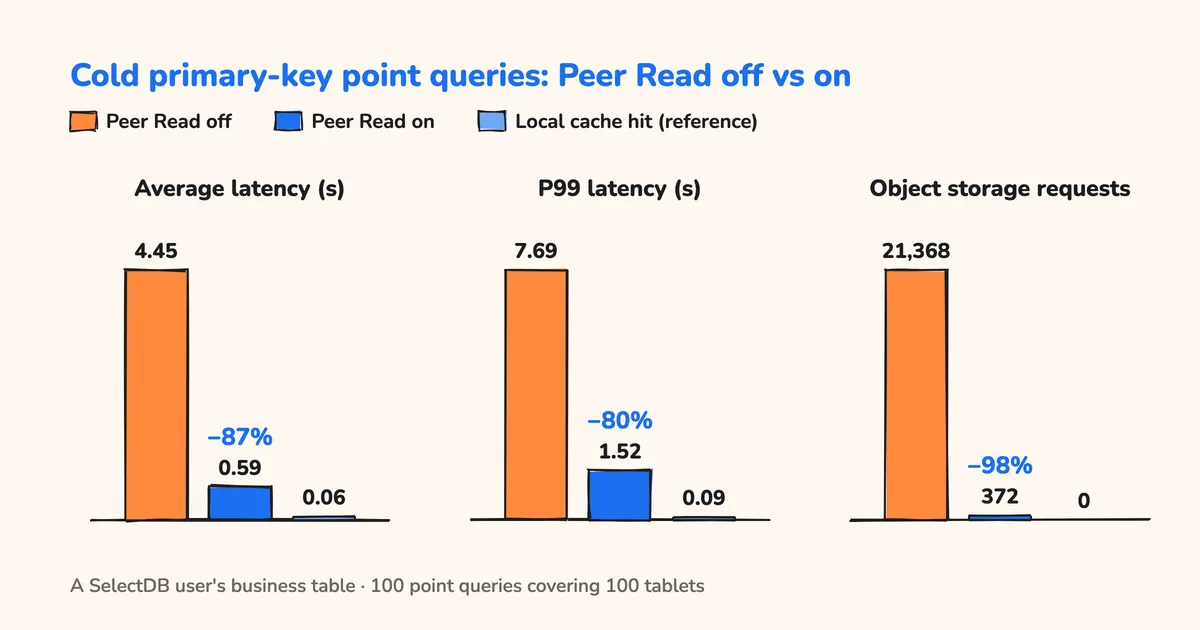
| 指标 | 冷读(关闭 Peer Read) | 冷读(开启 Peer Read) | 本地热读(参照) |
|---|---|---|---|
| 平均耗时 | 4.45 秒 | 0.59 秒 | 0.06 秒 |
| P99 耗时 | 7.69 秒 | 1.52 秒 | 0.09 秒 |
| 对象存储请求数 | 21,368 次 | 372 次 | 0 |
| 对象存储读取量 | 4.24 GiB | 约 186 KiB | 0 |
测试条件:每个计算组 1 个 BE,单轮串行执行。
开启 Peer Read 后,100 条查询都从 Peer 获取到了数据,且每一条都比关闭时快:平均耗时下降约 87%,提升约 7.5 倍;P99 下降约 80%。对象存储请求从 21,368 次降至 372 次,仅为原来的约 1.7%;由于对象存储按请求次数计费,这部分费用也随之下降。
相比如 TPC-H 这类以大块扫描为主的分析场景,点查场景提升更明显,原因在于第一节提到的小 IO:点查返回的数据量很少,耗时主要花在大量 Footer 和索引的小 IO 上,而 Peer Read 正好缩短了每一次小 IO 的等待时间。
注意,Peer Read 并不能替代本地缓存:它仍比本地热读慢一个数量级左右。它的作用是在本地缓存建立之前,先把冷读延迟降到可接受的水平。
五、在 Apache Doris 中启用 Peer Read
注意:Apache Doris 4.2 中,Peer Read 以实验特性提供,默认关闭。
5.1 开启步骤
确认所有 BE 已开启 File Cache(
enable_file_cache = true)。在所有 BE 上设置
enable_cache_read_from_peer = true。该开关同时控制同计算组和跨计算组的 Peer 读取。一写多读场景如需由写入组代为回源,在读取组的所有 BE 上设置
peer_cache_fill_compute_group_id,取值为写入组的计算组 ID(不是名称)。
5.2 验证是否生效
通过查询 Profile 中 SegmentIterator 节点下的以下指标,可以判断 Peer Read 是否生效、是否占优:
NumPeerIOTotal:通过 Peer 读取的次数;CrossCGPeerIOTotal:其中跨计算组读取的次数;PeerRaceWin/S3RaceWin:竞速中 Peer 与对象存储各自胜出的次数。
5.3 使用建议
跨计算组读取会占用对端计算组的网络和磁盘资源;被指定为填充计算组时,还会占用其对象存储带宽和缓存空间。对资源隔离有严格要求的业务,可以关闭 Peer Read。
计算组跨可用区部署时,跨计算组的 Peer 读取会产生跨可用区流量费用。
如果
S3RaceWin明显多于PeerRaceWin,说明当前环境下 Peer 并不比对象存储快:更关注对象存储请求费用时,可以调大优先时间(peer_race_hedge_delay_ms),让更多读取由 Peer 完成;更关注延迟时,可以直接关闭。Peer Read 仅作用于存算分离模式下的内表,Hive、Iceberg 等外表的读取不经过 Peer Read。
完整参数和排障方法请参考 Apache Doris Peer 读文档。
六、结束语
存算分离让数据只需存储一份,Peer Read 则让缓存也能在计算组之间共享:一个计算组已缓存的数据,其他计算组同样可以使用。读取组首次查询的新数据、扩容后的新节点、被淘汰后再次访问的数据,都可以优先从其他节点读取,而不必每次都从对象存储重新读取。
Peer Read 不引入新组件,失败时自动回源。在 TPC-H 1TB 测试中,它将冷读总耗时减少了一半;在用户业务表的主键点查中,它将冷查询平均耗时从 4.45 秒降至 0.59 秒。
Peer Read 将随即将发布的 Apache Doris 4.2 正式推出。阿里云瑶池 SelectDB 已默认开启 Peer Read,欢迎使用。
