9.1 给获取分配统计(allocation stats)的操作加了取消支持。单独看是个很小的改动,但把它和同一版本的另一条(
cache支持)放在一起,能看清一件事:这个接口以前有多慢,以及 ES 是怎么一步步改的。
说明
来源和边界先交代:本文的依据出自 v9.4.2 标签下的官方文件(9.1.0.yml、TransportGetAllocationStatsAction.java、CancellableSingleObjectCache.java),文中引用的原文均来自这些文件。我没有启动集群、也没有跑测试,示例取自官方示例;哪些是文档写明、哪些是我的推断,正文里逐处标注。
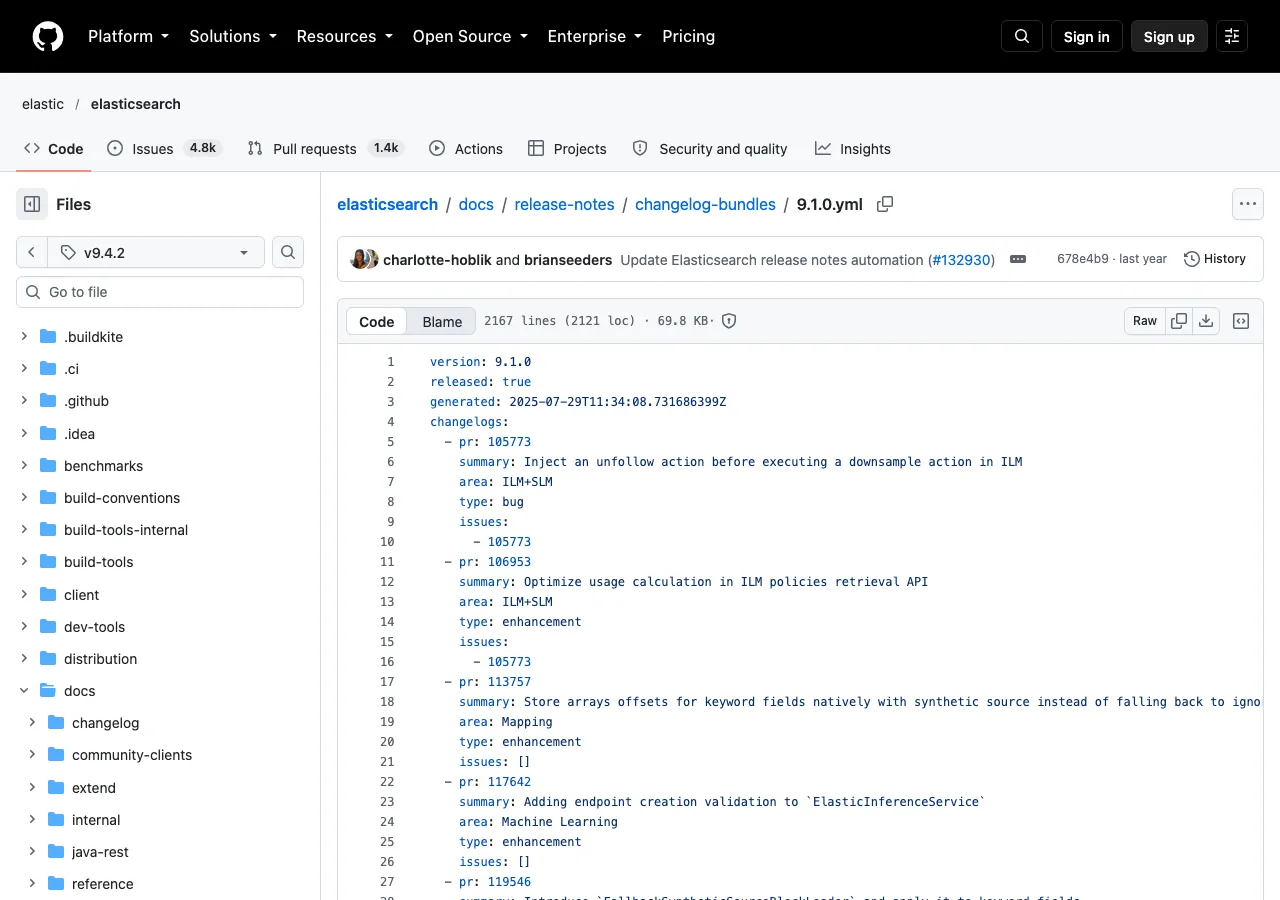
图 1:官方文件 9.1.0.yml(v9.4.2 标签)。来源:GitHub elastic/elasticsearch v9.4.2 9.1.0.yml
官方条目
9.1 的 changelog 里有两条相关条目。
取消支持(9.1.0.yml 第 1355 行 @ v9.4.2):
Add cancellation support in `TransportGetAllocationStatsAction`
缓存支持(9.1.0.yml 第 575 行 @ v9.4.2):
Add cache support in `TransportGetAllocationStatsAction`
两条都只有一行 summary。实质内容来自源码。
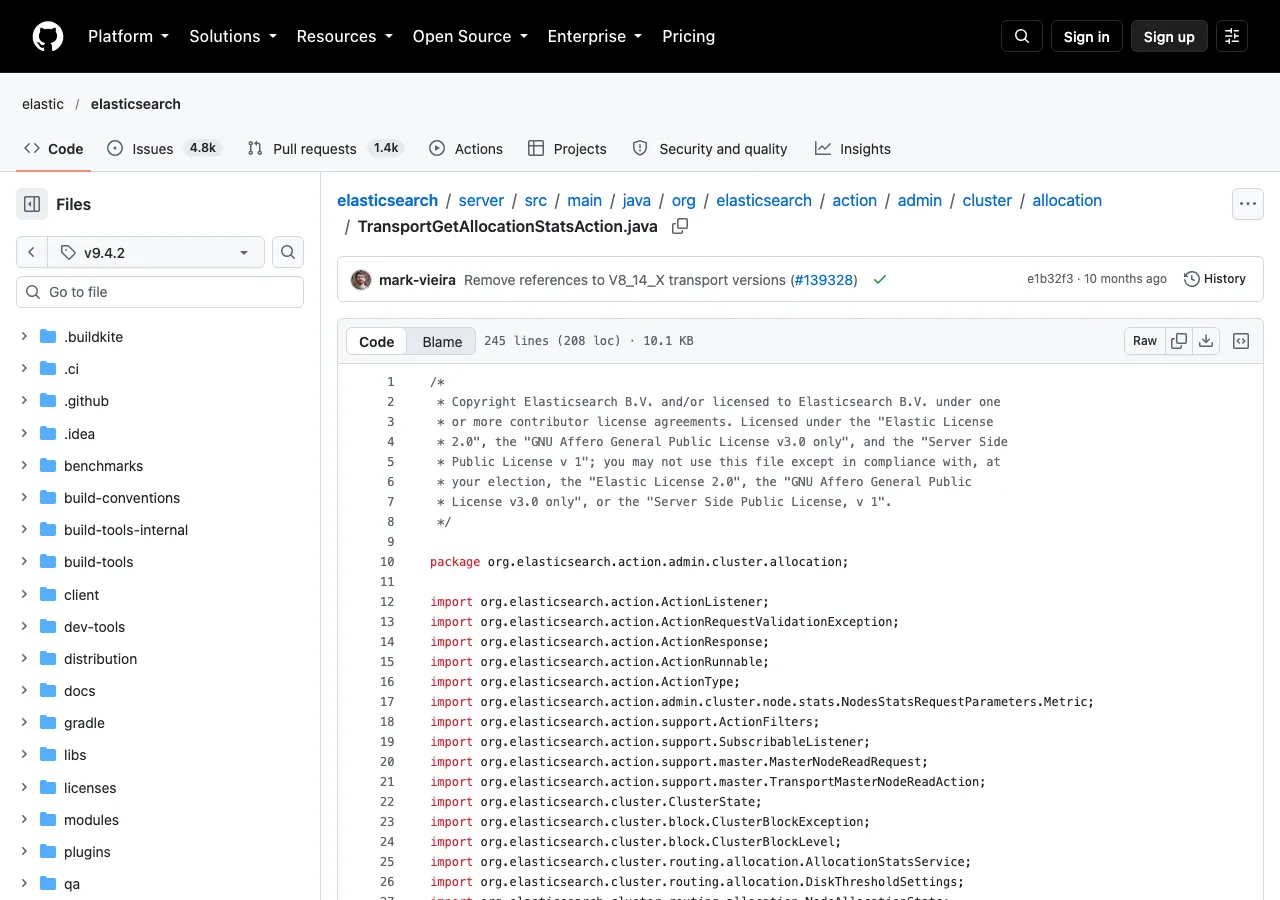
图 2:官方文件 TransportGetAllocationStatsAction.java(v9.4.2 标签)。来源:GitHub elastic/elasticsearch v9.4.2 TransportGetAllocationStatsAction.java
这个接口是干什么的
它对应的是查看集群分片分配情况的 API。用的时候一般是想回答这类问题:
- 各节点当前有多少分片;
- 磁盘水位怎么样;
- 分片分配是否均衡。
监控、巡检、排查磁盘或均衡问题时都会用到。
它慢的原因是:这个统计需要遍历集群状态里的分片信息并汇总。集群状态越大(索引多、分片多),遍历越久。
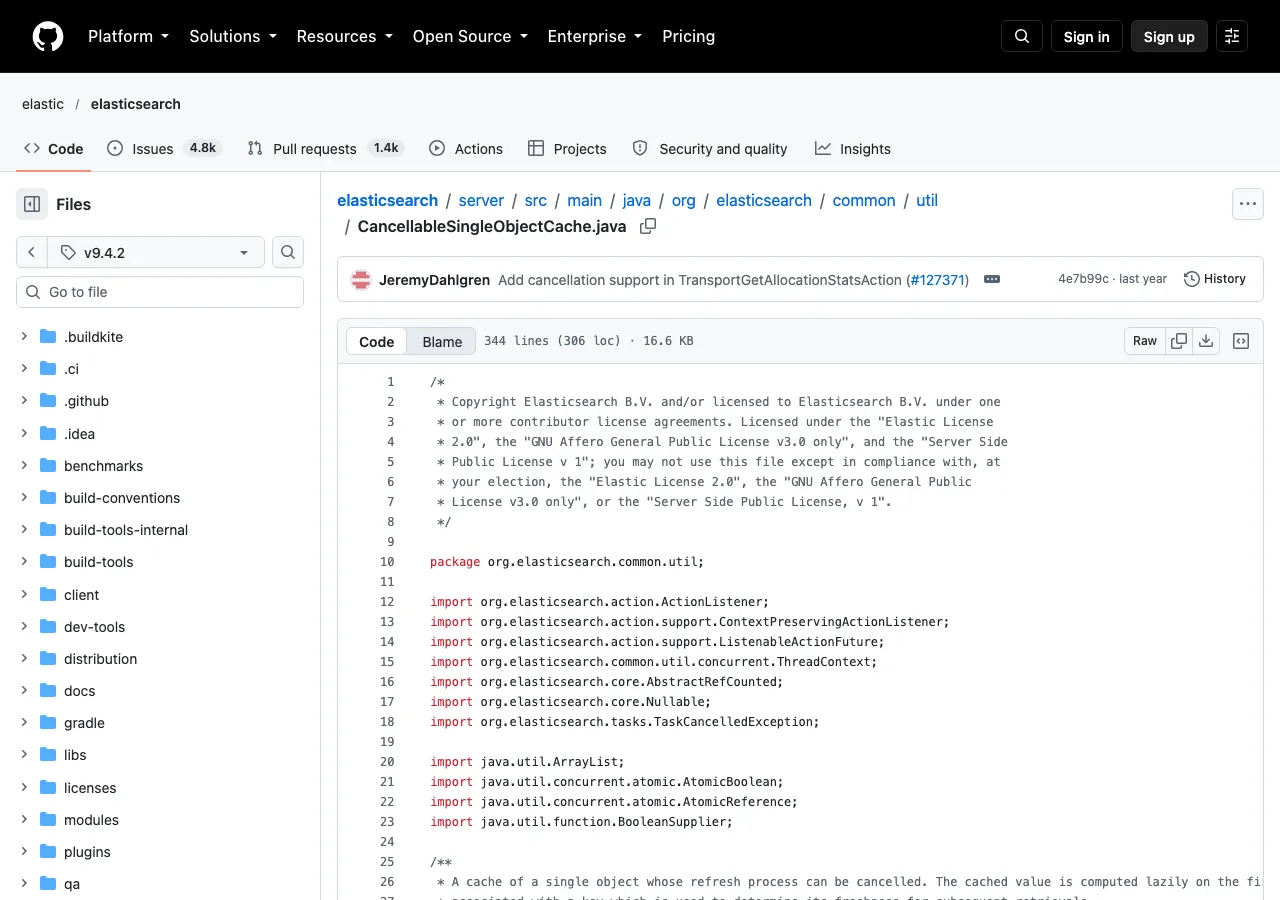
图 3:官方文件 CancellableSingleObjectCache.java(v9.4.2 标签)。来源:GitHub elastic/elasticsearch v9.4.2 CancellableSingleObjectCache.java
两条改动的关系
这里有个先后问题要先看清楚:
先加缓存(575 行),再加取消(1355 行)。
按常理想,有了缓存之后查询应该变快了,为什么还需要取消?
理解是:缓存解决的是重复查询,取消解决的是首次查询。
- 缓存命中 → 快;
- 缓存未命中(首次查询、或缓存失效)→ 还是要完整算一遍。
而完整算一遍在大集群上可能就是几秒甚至更久。这段时间里你想中断它,以前是做不到的。
所以两条改动是互补的:缓存减少需要长时间计算的次数,取消保证偶尔需要的那次不会卡死在那里。
(说明:这个前后关系的判断来自 changelog 里的条目顺序和源码结构,官方没解释过设计顺序,是理解。)
源码里怎么实现的
关键代码在 TransportGetAllocationStatsAction.java 第 99–111 行(源码 @ v9.4.2):
protected void masterOperation(Task task, Request request, ClusterState state, ActionListener<Response> listener) throws Exception {

    // NB we are still on a transport thread here - if adding more functionality here make sure to fork to a different pool

    assert task instanceof CancellableTask;
    final var cancellableTask = (CancellableTask) task;

    final SubscribableListener<Map<String, NodeAllocationStats>> allocationStatsStep = request.metrics().contains(Metric.ALLOCATIONS)
        ? SubscribableListener.newForked(l -> allocationStatsCache.get(cancellableTask::isCancelled, l))
        : SubscribableListener.newSucceeded(Map.of());
几个点值得看:
一,assert task instanceof CancellableTask。 这个任务必须是可取消任务。ES 的任务框架里,只有 CancellableTask 才支持被取消。
二,allocationStatsCache.get(cancellableTask::isCancelled, l)。 这是最关键的一行——把"是否被取消"这个函数直接传给了缓存。
这意味着:计算过程中会反复检查有没有被取消。算到一半发现取消了就停,而不是算完再看。
三,只有 ALLOCATIONS 指标走缓存。 metrics().contains(Metric.ALLOCATIONS) 为假时直接返回空 Map,不计算。所以你只查 FS(磁盘)指标的话,不走这条路径。
注释里的关键信息
// NB we are still on a transport thread here - if adding more functionality here make sure to fork to a different pool
大意是:这里还在 transport 线程上,以后加功能记得 fork 到其他线程池。
这是写给后来维护者的提醒。它透露了一件事:transport 线程是宝贵资源,不该在上面跑耗时计算。
所以代码里用了 SubscribableListener.newForked(...)——forked 就是为了把计算挪出 transport 线程。
提这行注释是因为它解释了为什么代码要这么绕:是有约束,不是设计得复杂。
取消机制是怎么工作的
顺着上面的 cancellableTask::isCancelled 再往上一层。
ES 的取消机制大致是这样:
- 每个可取消请求对应一个
CancellableTask; - 取消操作(
POST _tasks/<task_id>/_cancel)会置上这个任务的取消标记; - 正在执行的代码需要主动检查这个标记,发现被置上就停下来。
关键在最后一点:取消是协作式的。
也就是说:是代码自己定期检查"我被取消了吗",发现是就退出,不是系统强行杀掉线程。
这解释了为什么源码里要把 isCancelled 一路传进缓存的计算逻辑里——没有这层传递,取消标记就没人看,取消也就不会生效。
这对使用者意味着什么
一,你可以中断一个慢的分配统计查询了。 以前发起了就只能等它算完。
二,取消不是瞬时的。 因为是协作式,取消请求发出去之后,要等执行到下一个检查点才会真正停。所以不要期望"点了取消就立刻返回"。
三,取消的粒度取决于检查点密度。 如果检查点稀疏,可能取消前还要多算一会儿。源码层面未逐个确认检查点的具体位置,所以"多久能停下来"这个问题没有准确答案——只能说它会在合理时间内停,不能说会立刻停。
怎么实际用
先看任务列表拿到 task id:
# 发起一个分配统计查询(具体 API 以你版本的文档为准)
curl -s 'localhost:9200/_cat/allocation?v'

# 列出正在执行的任务
curl -s 'localhost:9200/_tasks?detailed=true&actions=*allocation*'
拿到 task id 之后取消:
curl -X POST 'localhost:9200/_tasks/<task_id>/_cancel'
说明:上面 _tasks 的 actions 过滤条件按命名习惯写的,该操作对应的 action 名未核对,实际用的时候可以先不带过滤条件把所有任务列出来再找。
和别的操作对比
ES 里支持取消的操作并不是全部。整理一下常见的几类:
| 操作 | 是否可取消 | 说明 |
|---|---|---|
| 搜索 | 是 | 常见场景,支持得较早 |
| 分配统计 | 9.1 起 | 本篇 |
强制合并(_forcemerge) |
是 | 长操作,早就需要 |
| 快照恢复 | 是 | 长操作 |
| 部分管理类操作 | 否 | 执行快,不需要 |
规律是:耗时越长的操作,越需要支持取消。 反过来说,看到某个操作支持取消了,可以反推它在某些场景下确实不快。
分配统计被加进来,说明它在某些集群上确实慢到需要中断。这本身也是个信号——如果你发现这个查询经常要跑很久,那更该关注的是集群状态为什么这么大(分片数是不是过多了),而不是怎么取消它。
为什么取消这么难做
前面说"取消是协作式的",听起来简单,但实际上给一个已有操作加取消支持往往不轻松。把难处说清楚,因为这能解释为什么 ES 不是所有操作都支持取消。
一,要在合适的位置插入检查点。 检查点太密 → 每次判断都有开销,影响正常路径的性能;太疏 → 取消后要等很久才停。找一个平衡点需要理解计算过程本身。
二,检查点可能在很深的调用栈里。 从源码能看到,取消标记被一路传进了缓存的 get 方法。也就是说,光在最外层检查是不够的——耗时的循环往往在内部,得把"是否被取消"这件事传递到那里去。
三,取消时不能留下半成品状态。 中途停下意味着有些工作做了一半。要保证集群状态、缓存、监听器都处理得当,不能因为一次取消就留下不一致。
第三点是最难的。这也是为什么"能不能取消"不能事后加个开关就完事——它需要整个执行路径配合。
由此能得出一个判断:如果某个操作不支持取消,多半是做起来代价高,不是没想到。遇到时不要指望"加个参数"就能解决。
为什么要单独关注分片数
前面提到"这个查询慢"是个信号,指向分片数。这里说具体一点,因为它是本篇最有实操价值的部分。
分片过多的典型表现:
- 集群状态变大 → master 节点内存压力大、状态发布变慢;
- 分配统计、cat API 这类需要遍历的操作变慢(本篇);
- 索引恢复变慢,节点重启后要等很久;
- 单个分片很小,资源利用率低。
怎么判断自己是不是分片过多:常见的经验值是堆内存每 GB 对应 20 个左右分片,但这个数字随版本和场景变化,不建议当硬性标准。更可靠的做法是看趋势:分片数增长速度是否远超数据量增长。
如果确实多了,能做的事:
- 合并小索引(用
_shrink或重建); - 调整索引生命周期策略,减少单索引的分片数;
- 用数据流 + rollover 控制单个索引的大小。
不要做的事:看到慢就去调超时或依赖取消。那是缓解症状,不是解决原因。
把这节写进来,是因为本篇的改动本质上是"ES 帮你应对一个问题",而那个问题本身才是该解决的。取消功能是安全带,不是方向盘——它能让你从卡住的查询里脱身,但不能让集群变健康。
这条改动的价值不在"能取消"
说实话,能取消一个查询,不是什么重要能力。真正有价值的信息是它的前提——这个操作慢到需要被取消。
顺着这个前提想,排查方向就变了:
- 如果这个查询在你的集群上从来没超过几百毫秒 → 这条改动对你没意义;
- 如果经常要几秒甚至更久 → 该查的是"分片数是不是太多了",而不是依赖取消功能。
分片数是集群健康度的基础指标。 分片过多会带来一系列问题:集群状态膨胀、master 压力大、恢复变慢。分配统计变慢只是其中一个表现。
所以建议是:把这条改动当成一个提示,而不是一个功能。它提示你"这个操作可能很慢",而慢的原因通常值得查——查清楚之后,取消功能就用不上了。
写在最后
很小的改动:一个操作从不可取消变成可取消。
一,取消支持要配合同版本的缓存支持一起看。 缓存管重复查询,取消管首次查询,两条是互补的——少了一条,另一条都补不上那个洞。
二,取消是协作式的。 代码要主动检查取消标记才会停,所以不是瞬时的。源码里 allocationStatsCache.get(cancellableTask::isCancelled, l) 就是在做这层传递——把"是否被取消"一路传进计算内部。
三,只有 ALLOCATIONS 指标走这条路径。 只查磁盘指标时不涉及,也就没有取消的必要——因为它不慢。
另外诚实标注了几处:"先缓存后取消"的关系是推断(依据条目顺序和源码结构,官方没解释);检查点的具体位置和密度未逐个确认,所以无法回答"取消后多久能停";该操作对应的 task action 名未核对,正文里 _tasks 的过滤条件按命名习惯写的。
参考
- changelog 9.1.0:Add cancellation support in
TransportGetAllocationStatsAction(第 1355 行)@ v9.4.2 - changelog 9.1.0:Add cache support in
TransportGetAllocationStatsAction(第 575 行)@ v9.4.2 TransportGetAllocationStatsAction.java:取消标记的传递(第 99–111 行)@ v9.4.2CancellableSingleObjectCache.java:接收取消检查的缓存实现 @ v9.4.2
本文对照 Elasticsearch
v9.4.2标签的 changelog 与源码核对,引文与代码逐字取自原文。"先加缓存后加取消"的前因关系是理解,官方未解释设计顺序;取消检查点的位置与密度未逐个确认,故未给出"取消后多久停止"的结论;该操作对应的 task action 名未核对,正文_tasks的actions过滤条件按命名习惯书写。撰写时未启动集群、未运行测试。