
能力面与平台位置
阿里云百炼的批量推理此前有两个入口:控制台可视化任务页,以及兼容通用 SDK 写法的接口调用。后者需开发者自己构造 JSONL、管理文件上传、实现轮询与结果解析。
命令行工具 2.7.0(2026-10-29 发布)新增的 batch 命令组把这段路径收进六条命令,覆盖本地格式转换、任务创建、进度轮询、任务列表、结果下载与取消。整组只需 API Key、不依赖控制台会话,其中 convert 为 No Auth 纯本地命令,因此批量推理可以作为无界面依赖的一环接入自动化流水线。
| 命令 | 鉴权 | 在流水线中的位置 |
|---|---|---|
| convert | No Auth | 数据准备,本地 CSV 转合规 JSONL,注入共享参数 |
| create | API Key | 任务入队,支持 dry-run 前置校验 |
| get | API Key | 进度观测,--follow 轮询至终态 |
| list | API Key | 多任务治理,返回分页游标 |
| download | API Key | 结果回收,双文件落盘 |
| cancel | API Key | 任务终止申请 |
数据准备环节
convert 是这组命令里生态意义最大的一条。它接受两列 CSV(编号列与内容列,列名可配),输出符合批量推理规范的 JSONL,并支持通过 --body-file 把输出长度上限、思考模式开关等共享参数一次性注入到每一行。这条命令不联网、不消耗任何调用额度,因此可以被反复执行,解决了批量推理长期存在的一个门槛:规范本身不难,难的是每次改提示词都要重新拼一遍文件。
官方规范侧约束需同步了解:单文件上限 50000 个请求与 500 MB,单行 1 MB 且不超模型上下文,同文件内所有请求须同模型同思考模式,custom_id 必填、唯一、上限 256 字符。需回传更长业务标识时用 create 的 --metadata 自定义字段,实测 scene=review-triage 原样回传且不受 256 字符限制。
前置校验:六类错误本地拦下
create 的 --dry-run 不调用任何业务接口、不上传文件,仅输出 records、bytes、model、endpoint、warnings。实测构造八类异常行,六类在本地被拦下并返回退出码 2,报错为中英双语且指名记录序号:消息缺 role 字段、同文件混用模型、custom_id 重复、custom_id 缺失、缺 body、endpoint 不在白名单。JSONL 语法错误同样本地拦下并指名行号。仅两类需服务端判定:content 为空字符串、单行超长。dry-run 应作为入队前的固定环节。
状态机与时间边界
七个状态:validating、in_progress、finalizing、completed、failed、expired、cancelled。实测如下(同账号、同档模型、同日):
| 任务规模 | 提交到完成 |
|---|---|
| 5 行(首次) | 100 秒 |
| 60 行 | 3 秒 |
| 300 行 | 5 秒 |
| 5 行(另一次) | 2 秒 |
同档任务时间跨度从 2 秒到 100 秒,因此完成时间不可写入任何服务等级承诺。命令层暴露的 completion-window 仅 24h 与 7d 两档,官方文档记载控制台可设 1 至 14 天,超窗转 expired。finalizing 表示请求已处理完、正在写结果文件,此时计数已满但 output_file_id 为 null,轮询实现须将其视为未完成态;get --follow 间隔最小 60 秒。
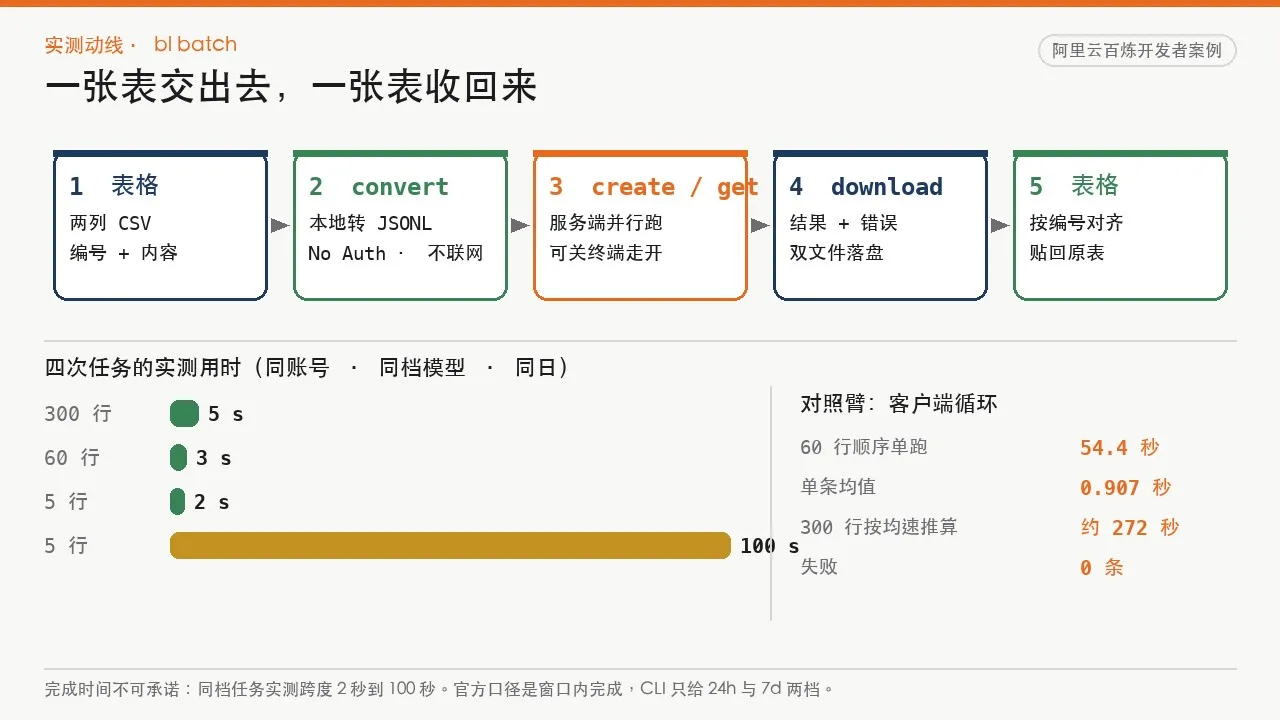
与客户端循环的对照:同样 60 行、同样提示词与输出上限,用 text chat 顺序单跑总耗时 54.4 秒、单条均值 0.907 秒;按均速外推 300 行需约 272 秒,批量实测 5 秒。限流不构成循环的瓶颈,quota list 查得该档模型请求上限为每周期 15000 次、60 行循环零失败,批量相对循环的真实收益是三项:无人值守、服务端并行、结果与错误分文件落盘。
结果契约的三条约束
download 落两份文件。result.jsonl 为完整原始返回,含 response.body 全量、finish_reason、逐条 usage,result.csv 为展示投影,help 标注 lossy。
三条集成约束:顺序不保证,三次任务结果顺序均与输入不一致,回连必须以 custom_id 为键,位置拼接的错位是静默的;CSV 带 UTF-8 BOM(首字节 EF BB BF),对表格软件友好、对脚本不友好,须以 utf-8-sig 解码,否则按列名取值抛 KeyError;编号字面全程保真,实测 007、000123、1e3、20261101、r-001 五个编号在双侧逐字保留,前导零丢失风险在下游表格软件的自动类型识别,导入时须按文本处理。
格式合规与语义正确是两个指标
同一档模型、同样 16 的输出上限,仅改 system 提示词:钉死格式与取值域的 60 行任务合规率 60/60;仅写"三选一,不要解释"的 300 行任务合规率 19/300,其余 281 行标签后跟解释且被截断。
更需要注意的是语义层。60 行任务按人工分桶登记基准后对照,逐桶一致率为正面 15/15、负面 15/15、咨询 13/15、自定义的"混合"类 1/15,总 44/60。模型系统性地把"混合"类拆入正面或负面,而这些错行的格式与正确行完全一致。
工程结论:格式合规率可自动化校验,语义正确率必须依赖基准集。分类类作业应在提交前登记人工基准,回收后按类别而非总数统计一致率。
失败与取消边界
部分结果不可读:8 行文件中 7 行秒级完成,第 8 行为约 20 万字超长内容,任务被拖到 20 分 12 秒才 completed;中途观察时停在 in_progress,两个文件 ID 均为 null,已完成的 7 行无法下载。终态时该行 status_code 200、prompt 200013 token、completion 32768 token(顶到上限),内容为无意义长回答;同文件空内容行同样返回 200 并编造"示例响应"。超长与空行均不产生行级失败,唯一可观测信号为 request_counts 三个数(中途 8/7/0)。
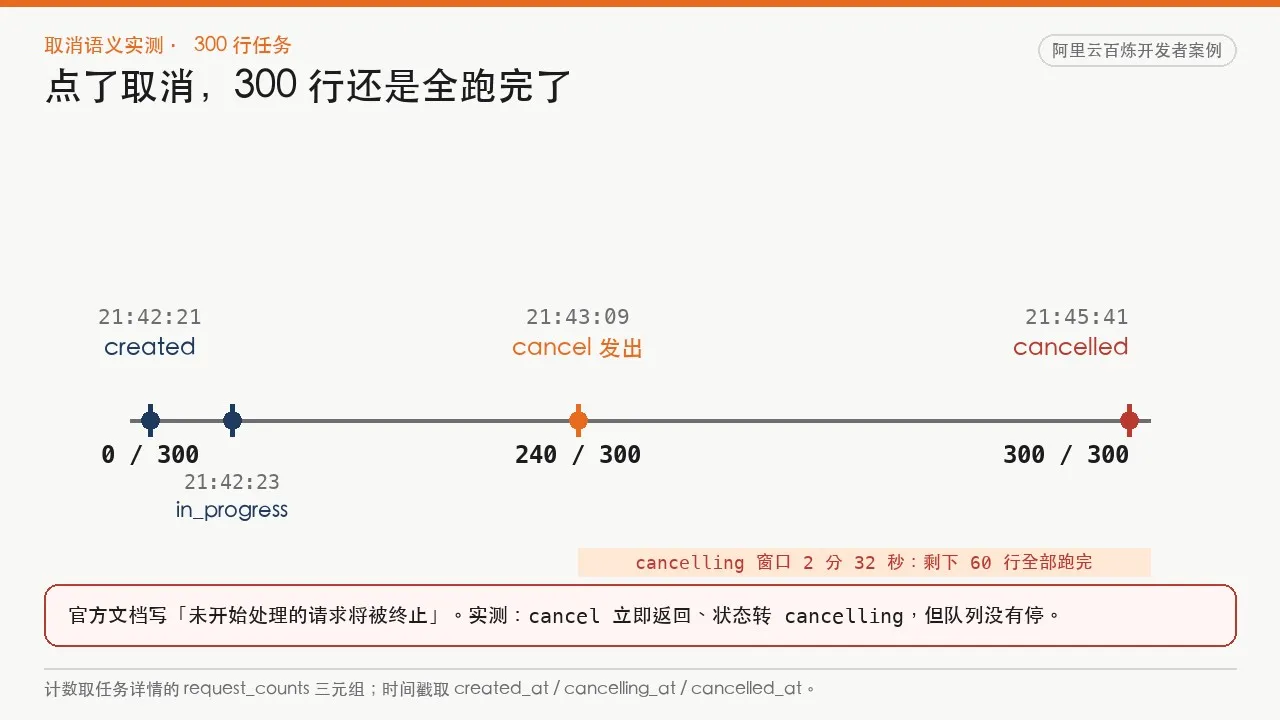
取消为异步申请:官方文档写执行中任务可取消、未开始处理的请求将被终止。实测 300 行任务在进入 in_progress 两秒后发出 cancel,当时计数 240/300,命令立即返回并转 cancelling,2 分 32 秒后转 cancelled,最终计数 300/300、零失败。规模控制的唯一可靠手段是提交前切分文件、分批入队。
接入建议与边界
最小接入组合为一份两列 CSV、一次 convert、一次 dry-run、一次 create、一次 get --follow、一次 download --csv。放量前把三项断言接进流水线:提交前的行长与上下文校验、以 custom_id 为键的结果回连、按类别统计的语义一致率。
不适合的形态:需要即时返回的对话与 Agent 中间步骤;几十行以内的小批量(循环可当场见结果、可即时中断);需逐行切换模型的对照实验;对部分结果可读性有要求的长任务。
命令签名以 2.7.2 的 --help 实输出为准,四次批量任务与一次循环对照共六百多次调用,原始响应与逐行结果已归档。接入入口见CLI 安装页与控制台密钥管理页。
