
导读:flink run 一敲,作业就上去了——正因为提交太顺滑,多数人对「这中间发生了什么」没有概念。等到作业提交卡住、客户端 OOM、并行度不生效,才发现无从下手。这篇把 Flink 2.3 的任务提交链路和架构模型拆开讲:四个角色怎么分工、七步提交各产出什么、两种部署模式差在哪、slot 和并行度怎么配平。
一、为什么值得单独讲一次「提交」
平时开发,我们面对的是 StreamExecutionEnvironment 的链式调用;上了生产,面对的却是另一套东西——Dispatcher、JobMaster、ResourceManager、Slot、Deployment Mode。这两套词汇之间的翻译层,就是「提交」。
不理解提交链路,很多现象无法解释:为什么作业代码里设了并行度 3,线上跑的却是 10?为什么客户端进程会被撑爆?为什么 Application 模式下读不到本地文件?答案全都藏在从 main() 到 Task 的这条路上。
另外,Flink 2.3 这一代有个前提必须先说清:Per-Job 模式已经没了。它从 1.15 起被标记废弃,2.x 彻底移除,部署模式只剩 Application 和 Session 两种。老资料里的 yarn-cluster 单作业模式、run-application 与 run 的旧对比,在 2.3 上不再适用。
二、四个角色:谁在翻译,谁在安排,谁在干活
一个 Flink 集群里,通常有四类角色。
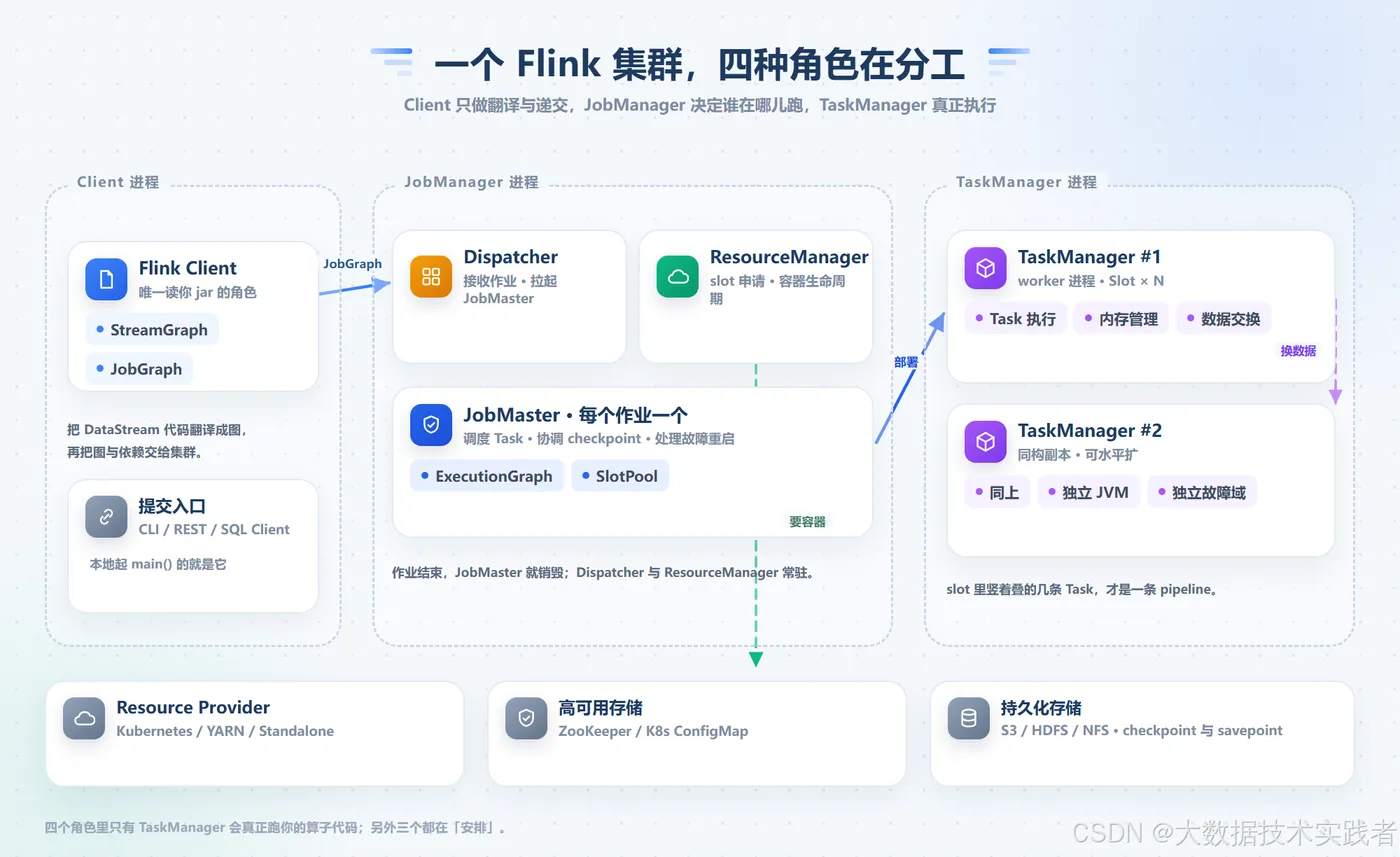
Client 是唯一读你 jar 包的角色。它执行 main(),把 DataStream 链式调用翻译成一张数据流图,连同依赖一起交给集群。注意:Client 不执行任何算子的业务代码,它只做「翻译 + 递交」。
JobManager 是中央协调者,内部再分三个组件,下一节细讲。
TaskManager 是 worker 进程,真正执行算子的地方。每个 TaskManager 进程按 taskmanager.numberOfTaskSlots(默认 1)切出若干 slot,Task 被调度进 slot 里跑,TaskManager 之间互相交换数据。
外部组件有三块:Resource Provider(Kubernetes / YARN / Standalone,决定容器从哪来)、高可用存储(ZooKeeper 或 K8s ConfigMap,JobManager 挂了靠它选主)、持久化存储(S3 / HDFS / NFS,checkpoint 与 savepoint 都写到这)。
一句话记住分工:四个角色里,只有 TaskManager 会真正跑你的算子代码,另外三个都在「安排」。
三、一次提交的七个步骤
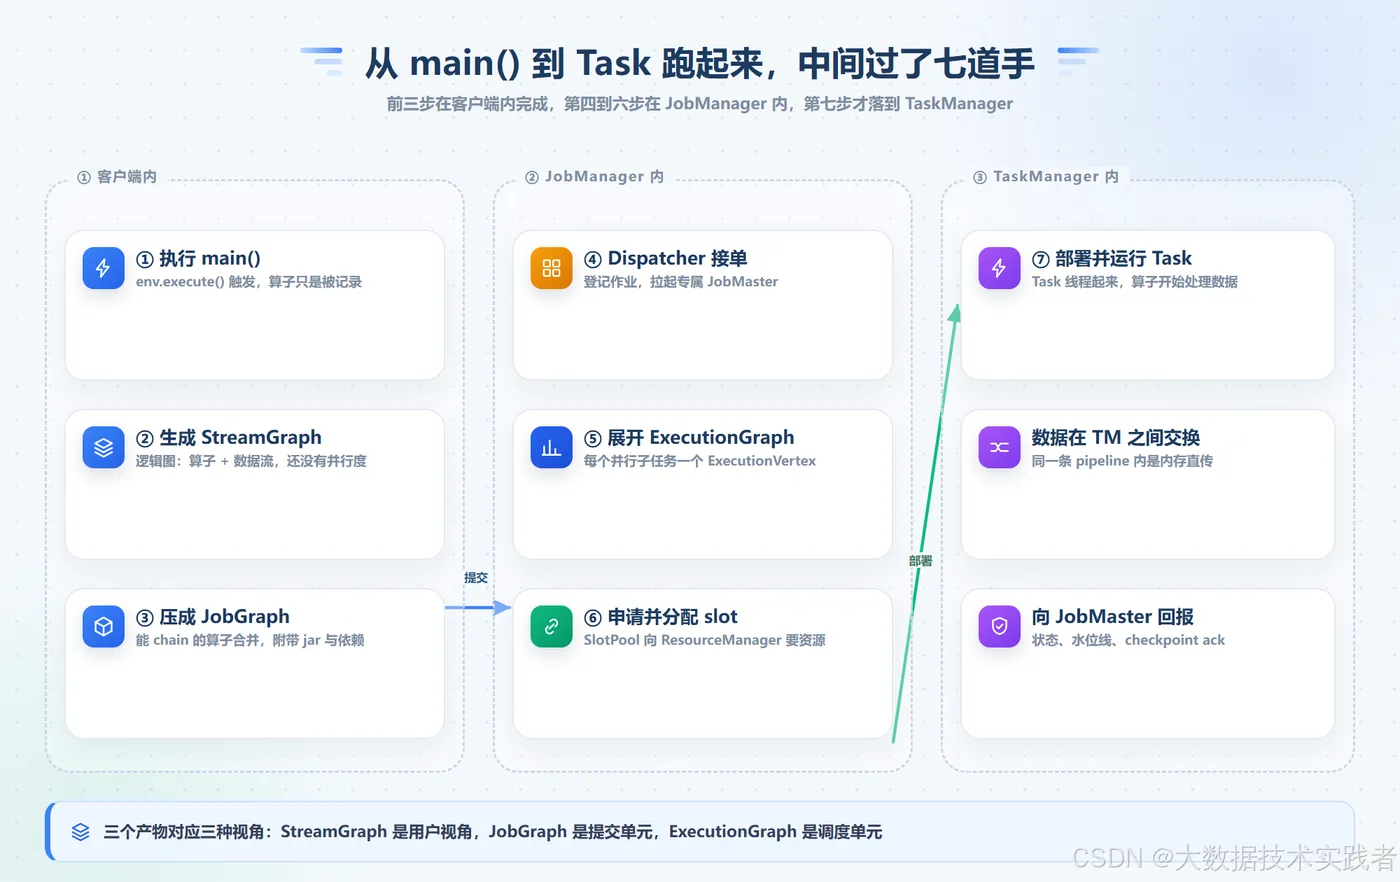
第 1 步,客户端执行 main()。env.execute() 被调用之前,所有算子只是被记录下来,什么都不会跑。
第 2 步,生成 StreamGraph。这是逻辑图:节点是算子,边是数据流,还没有并行度信息。
第 3 步,压缩成 JobGraph。能把数据 1:1 直传的相邻算子会被合并成算子链(Operator Chain),JobGraph 是提交单元——jar 与依赖在这一步一起被上传。
第 4 步,Dispatcher 接单。Dispatcher 收到 JobGraph 后登记作业,并为它拉起一个专属的 JobMaster。
第 5 步,展开 ExecutionGraph。JobMaster 把 JobGraph 按并行度展开:一个并行度 100 的算子,对应 1 个 JobVertex、100 个 ExecutionVertex。这是调度单元。
第 6 步,申请并分配 slot。JobMaster 的 SlotPool 向 ResourceManager 要资源,ResourceManager 从 TaskManager 处确认可用 slot。
第 7 步,部署 Task。TaskManager 收到部署指令,拉起 Task 线程,算子开始处理数据,并向 JobMaster 回报状态、水位线与 checkpoint 确认。
三个产物对应三种视角:StreamGraph 是用户视角,JobGraph 是提交单元,ExecutionGraph 是调度单元。排查问题时,先分清你看到的是哪一层。
四、JobManager 内部的三驾马车
JobManager 是个进程名,里面有三个职责清晰的组件:
- Dispatcher:集群的前台接待。接收提交、提供 REST 接口、Web UI,为每个作业拉起 JobMaster。它在集群生命周期内常驻。
- ResourceManager:管 slot 的账房。收到 JobMaster 的 slot 请求后,向 Resource Provider 要容器、向 TaskManager 要 slot;作业结束,slot 归还,容器释放。
- JobMaster:每个作业一个,作业结束就销毁。它持有这张作业的 ExecutionGraph,负责调度 Task、协调 checkpoint、处理故障重启。
这个设计的巧妙之处在于Dispatcher 和 ResourceManager 常驻,JobMaster 按作业生灭——所以同一个集群能同时跑多个互不干扰的作业,每个作业的故障也只影响自己的 JobMaster。
五、两种部署模式:main() 在哪跑
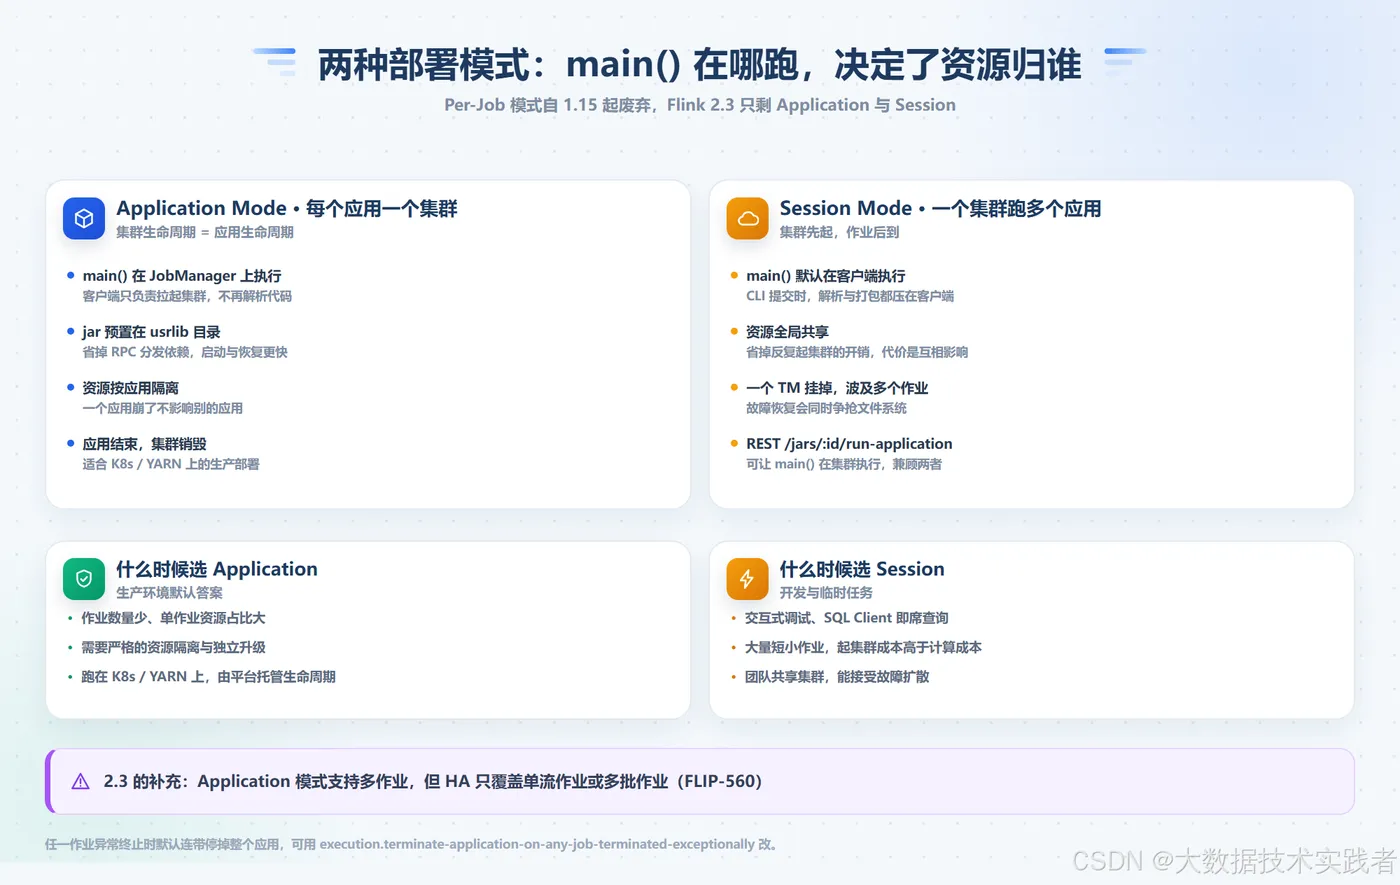
两种模式的差别归结为一个问题:main() 在客户端执行,还是在集群执行。
Application Mode:为每个应用单独起一个集群,main() 直接在 JobManager 上执行。它有个前提——用户 jar 已经预置在 Flink 发行版的 usrlib 目录里,这样启动和恢复时不用通过 RPC 分发依赖,速度更快。资源按应用隔离,应用结束集群就销毁。生产环境跑 K8s 或 YARN,默认选它。
Application 模式支持一个 main() 里提交多个作业:execute() 是阻塞的,作业按顺序跑;executeAsync() 不阻塞,作业并行跑。但要注意 2.3 的一条硬约束(FLIP-560):高可用只覆盖单流作业或多批作业的组合;而且默认情况下任何一个作业异常终止,整个应用连同其他作业都会被停掉——这个行为可以用 execution.terminate-application-on-any-job-terminated-exceptionally 调整。
Session Mode:集群先起、作业后到,多个应用共享同一批 TaskManager。优点是省掉反复起集群的开销,适合开发调试和 SQL 即席查询;代价是故障扩散——一个作业把 TaskManager 搞挂,同 TM 上的所有作业一起遭殃,恢复时还会同时争抢文件系统。CLI 提交时 main() 在客户端执行;通过 REST 的 /jars/:jarid/run-application 提交时,main() 也可以在集群执行,兼顾两者。
六、slot 与并行度:三个数字怎么配平
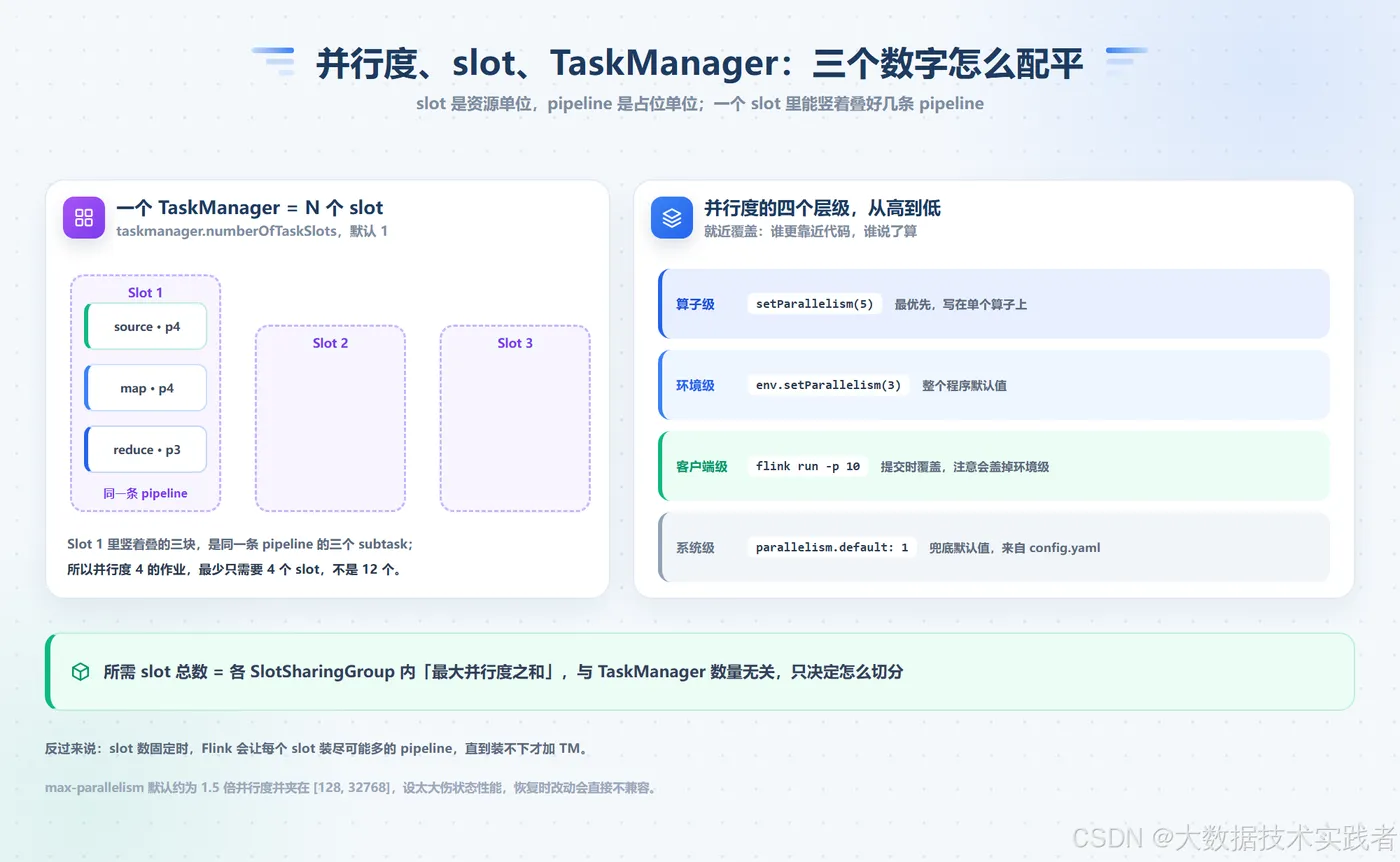
slot 是资源单位,pipeline 是占位单位。一个 slot 里能竖着叠好几条 pipeline:source、map、reduce 三个 subtask 共用同一个 slot,省掉跨线程的序列化开销。所以并行度 4 的作业,最少只需要 4 个 slot,不是 12 个。
正式说法:所需 slot 总数等于各 SlotSharingGroup 内最大并行度之和。TaskManager 的数量不改变这个总数,只决定它怎么被切分。
并行度有四个层级,就近覆盖:
// 算子级:最优先
stream.keyBy(...).sum(1).setParallelism(5);

// 环境级:程序默认
env.setParallelism(3);
# 客户端级:提交时覆盖
./bin/flink run -p 10 ./app.jar

# 系统级:config.yaml 里的 parallelism.default,默认 1
优先级从高到低:算子级 > 环境级 > 客户端级 > 系统级。注意客户端 -p 会覆盖代码里的 env.setParallelism——这解释了开头那个「代码写 3、线上跑 10」的现象。
还有个容易忽视的参数是 max-parallelism:从 savepoint 恢复时可以改并行度,但上限就是它。默认约为算子并行度的 1.5 倍,下限 128、上限 32768。它决定 key-group 的划分数量,设太大会拖累状态性能,恢复时改动则直接不兼容。
七、命令行里的日常操作
# 提交(detached 提交完立即返回)
./bin/flink run --detached ./app.jar

# 指定目标:YARN / K8s 的 application 模式
./bin/flink run --target yarn-application ./app.jar
./bin/flink run --target kubernetes-application ./app.jar

# 动态传参,不用改配置文件
./bin/flink run -Dpipeline.max-parallelism=120 ./app.jar

# 查看、优雅停止、取消
./bin/flink list
./bin/flink stop --savepointPath /tmp/sp $JOB_ID
./bin/flink cancel $JOB_ID
stop 比 cancel 优雅:它让 checkpoint barrier 从 source 流向 sink,走完一次 savepoint 再停。如果打算永久下线作业,加 --drain——它会在最后发出 MAX_WATERMARK,把窗口里攒的数据全部冲出来;但如果以后还要从 savepoint 恢复,不要 drain,否则水位线被推到最大,恢复后的窗口语义就错了。
flink info 值得一用:打印作业的优化后执行图,提交前先看一眼拓扑,很多问题在本地就能发现。
八、五个高频坑
坑一:客户端 OOM。Session 模式下 CLI 提交大 jar,main() 在客户端执行,下载依赖、生成 JobGraph 全在这一个进程里。依赖上 GB 时,给客户端也留够内存。
坑二:-p 静默覆盖。上线脚本里历史遗留的 -p 10,会让你代码里所有 env.setParallelism 失效。排并行度问题时先看提交命令。
坑三:Application 模式下的路径。main() 搬到了集群上执行,registerCachedFile() 注册的本地路径必须在 JobManager 可达,写 ./conf/xxx 这种相对路径会直接找不到。
坑四:slot 不足时提交挂起。Session 集群 slot 被占满,新作业不是失败而是等待。看到提交后一直 SCHEDULED 不 RUNNING,先查 flink list 和 slot 占用。
坑五:作业 suspended 不等于结束。HA 场景下 JobManager 挂掉,作业进入 suspended 态——它只是在这台 JobManager 上终结了,另一个 JobManager 会从 HA 存储把作业捞回来重启。日志里看到 suspended 不用急着人工干预,先看有没有新实例接管。
九、写在最后
Flink 的架构模型一句话能说完:Client 翻译,JobManager 安排,TaskManager 干活。但展开来,三个产物、三个内部组件、两种部署模式、四层并行度,每一层都有自己的一套行为。
下一篇我们沿着这条链路往下钻,讲 JobManager 与 TaskManager 之间的调度细节和 slot 分配策略——那才是资源调优的正面战场。
安排,TaskManager 干活**。但展开来,三个产物、三个内部组件、两种部署模式、四层并行度,每一层都有自己的一套行为。

