
本文是《滚动轴承故障诊断》系列的第 4 篇(数据预处理)。
系列完整目录见文末【专栏导航】。本篇讲解的data_load核心逻辑,配套的完整可运行脚本与报错速查见同名公众号。
一、为什么原始信号不能直接喂给模型
回顾第 3 篇:我们拿到的是一整条很长的振动时间序列。
但分类模型要的是"一条一条的样本",每条有一个明确的标签(属于哪类故障)。所以预处理的核心任务就一句:把一整条信号,切成很多条有标签的小样本。
顺带还要解决两个工程问题:
- 幅值尺度不统一:不同转速、不同工况下,振幅大小差很多,不处理模型会"以大欺小";
- 类别不平衡:不同文件切出的样本数不一样,不均衡会让模型偏科。
这三件事,就是 preprocess.py 干的活。
二、核心函数 data_load 的思路拆解
我们来看这个函数做了哪几件事(这是全系列第一个值得逐行读的代码):
def data_load(path, data_name, cut_num, label):
    # ① 读入 .mat 文件
    data = loadmat(path + str(data_name) + '.mat')

    # ② 取出驱动端 DE 与风扇端 FE 两路信号
    org_DE = data['X' + name + '_DE_time']
    org_FE = data['X' + name + '_FE_time']

    # ③ 各自归一化到 [0,1]
    list_DE_n = MinMaxScaler().fit_transform(org_DE)
    list_FE_n = MinMaxScaler().fit_transform(org_FE)

    # ④ 打包成双通道,再按窗口切分
    signal = [[d, f] for d, f in zip(list_DE, list_FE)]
    for i in range(len(signal) // cut_num):
        data_cut.append(signal[i*cut_num : (i+1)*cut_num])
        label_cut.append(label)
    return data_cut, label_cut
四个动作,对应三件事 + 一个输出。下面逐一拆:
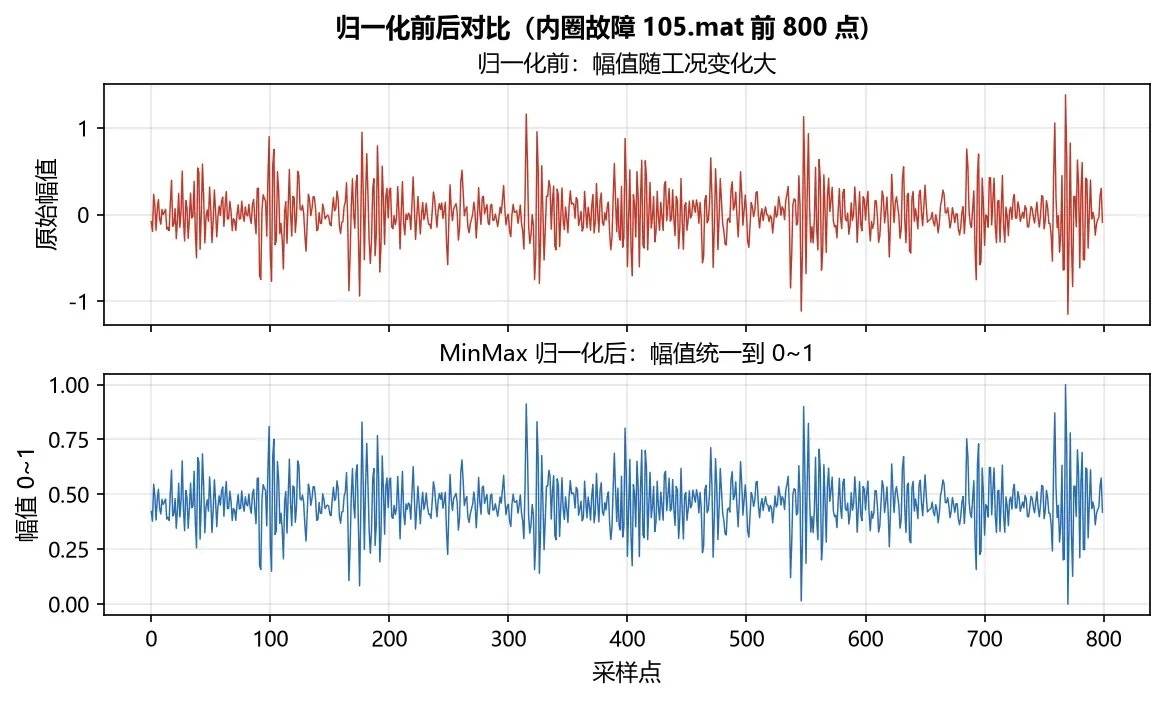
三、归一化:为什么压到 0~1
把 DE、FE 各自做 MinMax 归一化,把所有值压到 0~1。
为什么要做?
- 消除尺度差异:同一台机器不同转速,振幅可能差好几倍。若不归一化,模型会把"振幅大小"当成重要特征,而它其实只是工况,不是故障;
- 利于训练稳定:神经网络里数值过大容易让梯度爆炸/不收敛,压到 0~1 是标准做法;
- 两份信号各归各的:DE、FE 是不同传感器、不同量纲,必须分开归一化,不能混在一起算。
归一化用的是
MinMaxScaler().fit_transform()——它先"学"这段数据的最小/最大,再整体缩放到 0~1。
四、双通道:为什么用 DE + FE 两路
把归一化后的 DE 和 FE,逐点配对成 [DE, FE],一条样本就成了 1000 点 × 2 通道。
- 两个传感器一个装在驱动端、一个装在风扇端,从不同角度"听"同一台轴承;
- 双通道信息互补,比只用一个通道更稳、更能抗干扰;
- 这也解释了第 2 篇为什么强调要装全依赖——
(1000, 2)这个输入形状后面模型都用。
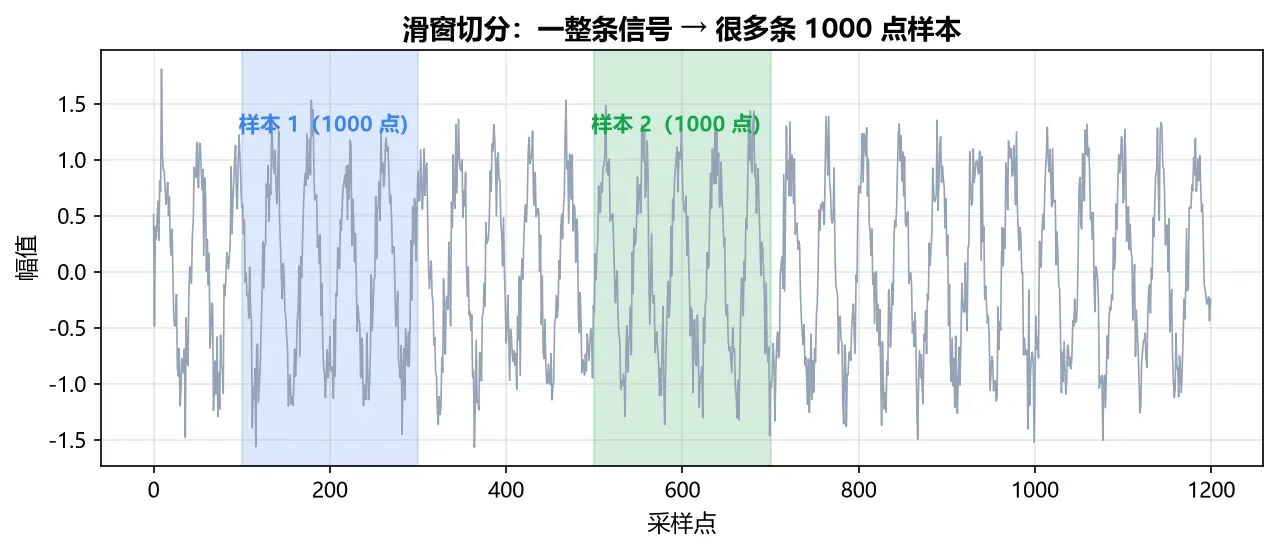
五、滑窗切分:一条信号 → 一堆样本
关键步骤:for i in range(len(signal) // cut_num),每 cut_num(本项目 1000)个点切一段。
- 每 1000 个点是一条样本,一条长长的信号能被切成很多条;
- 这本身就是最简单的数据增广:一条信号"变"出几十上百条样本,数据量一下就上来了;
- 也解释了为什么 CWRU 才 40 个文件,最后却有 5600 条样本——全是切窗切出来的。
六、类别均衡:每类固定 1400 条
切完之后,每个文件产出的样本数不一样(文件长度不同),所以最后要"齐步走":
- 统计每类样本数;
- 每类随机抽取固定数量(本项目 1400 条),把四类配平。
配平的价值:防止模型"偷懒"。如果某类样本特别多,模型可能"反正大多数是这类,全猜这类也高分"——这样整体准确率虚高,但小类几乎全错。均衡后,四类被公平对待,指标才真实可信。
七、产出与交接
预处理跑完,项目目录多出两个文件:
| 文件 | 内容 |
|---|---|
train_data.npy |
5600 条样本,形状 (5600, 1000, 2) |
label.npy |
5600 个标签(0~3) |
预处理一次,三个模型通用——第 5、6、7 篇都从这两个文件读数据。
八、本篇小结
- 预处理 = 归一化 + 双通道 + 滑窗切分 + 类别均衡;
- 归一化消除工况差异、双通道增信息、切窗做增广、均衡防偏头;
- 完整脚本、运行方法、报错速查:关注公众号。
专栏导航
| 篇次 | 主题 | 状态 |
|---|---|---|
| 1 | 项目总览与三模型对比 | ✅ |
| 2 | 环境部署 | ✅ |
| 3 | CWRU 数据集深度解析 | ✅ |
| 4 | 数据预处理源码走读(本文) | ✅ |
| 5 | 随机森林实战 | 排期中 |
| 6 | 一维卷积与残差模块 | 排期中 |
| 7 | 模型训练与评估 | 排期中 |
| 8 | 可视化诊断系统 | 排期中 |
| 9 | 论文报告与答辩话术 | 排期中 |
下一篇预告:《随机森林实战:传统方法为什么也要做》,看这个"不深度学习"的基线方法为什么在论文里必不可少。
版权说明:CWRU 数据集版权归凯斯西储大学所有,仅限学习研究使用。


